

История о том, как мы построили внутренний DWH в ClickHouse
В ClickHouse мы видим свою миссию в том, чтобы предоставить нашим клиентам и пользователям быструю облачную аналитическую базу данных, которая может использоваться как для внутренней аналитики, так и для аналитики, ориентированной на клиентов. ClickHouse Cloud позволяет нашим клиентам хранить и обрабатывать практически неограниченные объемы данных, что помогает им оперативно принимать решения, основанные на данных. Принятие решений, основанных на фактах, а не на предположениях, имеет решающее значение для большинства современных успешных компаний.
Разумеется, мы придерживаемся такого же подхода и внутри команды. Разработка и эксплуатация нашего продукта облачной базы данных генерирует огромное количество данных, которые могут быть использованы для планирования мощностей, ценообразования, лучшего понимания потребностей наших клиентов и финансовой отчетности. Десятки источников данных, сотни терабайт, около сотни BI специалистов и миллионы пользователей по всему миру... И знаете что - для работы с ними мы используем ClickHouse Cloud :)
В этом посте я расскажу Вам о том, на чем построено наше внутреннее хранилище данных (DWH), какой стек мы используем и как будет развиваться наш DWH в ближайшее время.
Требования и источники данных
Мы запустили наш проект ClickHouse Cloud in в мае 2022 года и сразу же осознали, что хотим лучше понимать наших клиентов: как они используют наш сервис, какие проблемы у них возникают, как мы можем им помочь и как сделать наши цены более доступными. Для этого нам нужно было собрать и обработать данные из нескольких внутренних источников: Data Plane, который отвечает за работу подсистем баз данных клиентов, Control Plane, который отвечает за пользовательский интерфейс и работу с базами данных, а также AWS Billing, который предоставляет нам точные данные о стоимости выполнения рабочих нагрузок клиентов.
Был период, когда наш вице-президент по продуктам Таня Брагин ежедневно вручную анализировала рабочие нагрузки наших клиентов в Excel с помощью lookups. Мне, как бывшему архитектору DWH, было обидно, что ей приходится так много работать, и в результате родилась наша первая концепция внутренней DWH.
При разработке системы мы ставили перед собой ряд важнейших задач:
|
Внутренняя команда |
Задачи |
|---|---|
|
Команда продукта |
Отслеживание коэффициентов конверсии и удержания, использования функций, размера сервисов, их использования и выявление наиболее распространенных проблем. Проведение всестороннего специального анализа. |
|
Операционная команда |
Отслеживание приблизительного дохода и предоставление доступа к некоторым данным Salesforce в режиме «только для чтения» для большей части компании |
|
Команда продаж |
Просмотр настроек и использования конкретного клиента: количество услуг, объем данных, самые распространенные проблемы и т. д. |
|
Инжиниринговая команда |
Настройка нашего автоскалера, отслеживание частоты ошибок запросов и использования функций БД |
|
Обслуживающая команда |
Просмотр настроек конкретного клиента: услуги, использование, объем используемых данных и т. д. |
|
Маркетинговая команда |
Отслеживание коэффициентов конверсии по верхней границе воронки продаж, стоимости привлечения клиентов и других важных маркетинговых показателей |
|
Команда по затратам |
Анализ наших затрат на ЦТП и активная оптимизация наших обязательств по ЦТП |
|
Команда CI-CD |
Отслеживание затрат , связанных с CI-CD |
Примечание: в нашем внутреннем хранилище данных мы не собираем, не храним и не обрабатываем данные наших клиентов (большинство из которых зашифрованы). Для анализа запросов мы собираем только список использованных функций, время выполнения запроса, используемую память и некоторую другую метаинформацию. Мы никогда не собираем данные запроса или его текст.

Для выполнения поставленных задач мы разработали план по сбору данных из десятков источников, включая следующие:
|
Источник данных |
Тип и размер |
Данные |
|---|---|---|
|
Control Plane |
Document DB ~5 коллекций ~500 Мб в час |
Метаинформация о сервисах базы данных: тип, размер, регион CSP, штат, финансовый план, настройки масштабирования и т.д. |
|
Data Plane |
ClickHouse Cloud ~таблиц ~15 Гб в час |
Информация о системе базы данных: статистика метрик, статистика запросов, статистика таблиц и т. д. |
|
AWS CUR |
Бакет S3 1 таблица ~1 Гб в час |
Наши расходы и использование инфраструктуры AWS, на которой работает наш сервис |
|
GCP Billing |
BigQuery 1 таблица ~500 Мб в час |
Наши расходы и использование инфраструктуры GCP, на которой работает наш сервис |
|
Salesforce (CRM) |
Custom ~30 таблиц ~1 Гб в час |
Информация об учетных записях клиентов, планах использования, подписках, скидках, регионах, запросах и вопросах к службе поддержки |
|
M3ter (измерительное программное обеспечение) |
Custom API 2 API ~500 Мб в час |
Точная информация об использовании приложений и счетах |
|
Galaxy |
ClickHouse Cloud 1 таблица |
Galaxy - это наша собственная система наблюдения и мониторинга на основе событий, предназначенная для слоя управления / слоя пользовательского интерфейса. |
|
Segment |
Бакет S3 1 таблица |
Дополнительные маркетинговые данные |
|
Marketo |
Custom |
Рассылка метаинформации по e-mail |
|
AWS Public prices |
Custom API 3 таблицы |
Цены на каждый AWS SKU в каждом регионе |
|
GCP Prices |
Файлы CSV |
Цены на каждый SKU GCP в каждом регионе |
Учитывая наши основные цели, мы сделали несколько основных предположений:
На текущем этапе нам вполне достаточно часовой детализации данных. То есть мы можем собирать и хранить агрегированные данные за каждый час.
На данный момент нам не нужно использовать подход CDC (или «захват данных об изменениях»), поскольку он значительно повышает стоимость инфраструктуры DWH. Традиционная прямая загрузка / ETL должна удовлетворить наши потребности. Если эти источники данных будут обновляться, мы можем выполнить полную перезагрузку данных.
Поскольку у нас есть отличная масштабируемая и быстрая база данных, нам не нужно выполнять ETL-преобразования вне базы данных. Вместо этого мы используем ClickHouse непосредственно для выполнения преобразований с помощью SQL. Такой способ работает на ура!
В ClickHouse мы работаем с открытым исходным кодом, поэтому мы хотим, чтобы во всем нашем стеке были только open-source компоненты.
Поскольку мы работаем с разными типами источников данных, нам потребуется множество инструментов и подходов для извлечения данных из этих источников. В то же время нам необходимо стандартизированное промежуточное хранилище.
Однако одно из наших первоначальных предположений оказалось неверным. Мы полагали, что, поскольку наша структура данных не так уж и сложна, нам будет достаточно иметь только два логических слоя в DWH - сырьевой слой и слой «витрины данных». Но мы ошибались. В действительности нам требовался третий промежуточный слой, хранящий внутренние бизнес-сущности. Почему - объясним чуть позже.
Архитектура
В результате мы пришли к следующей архитектуре:
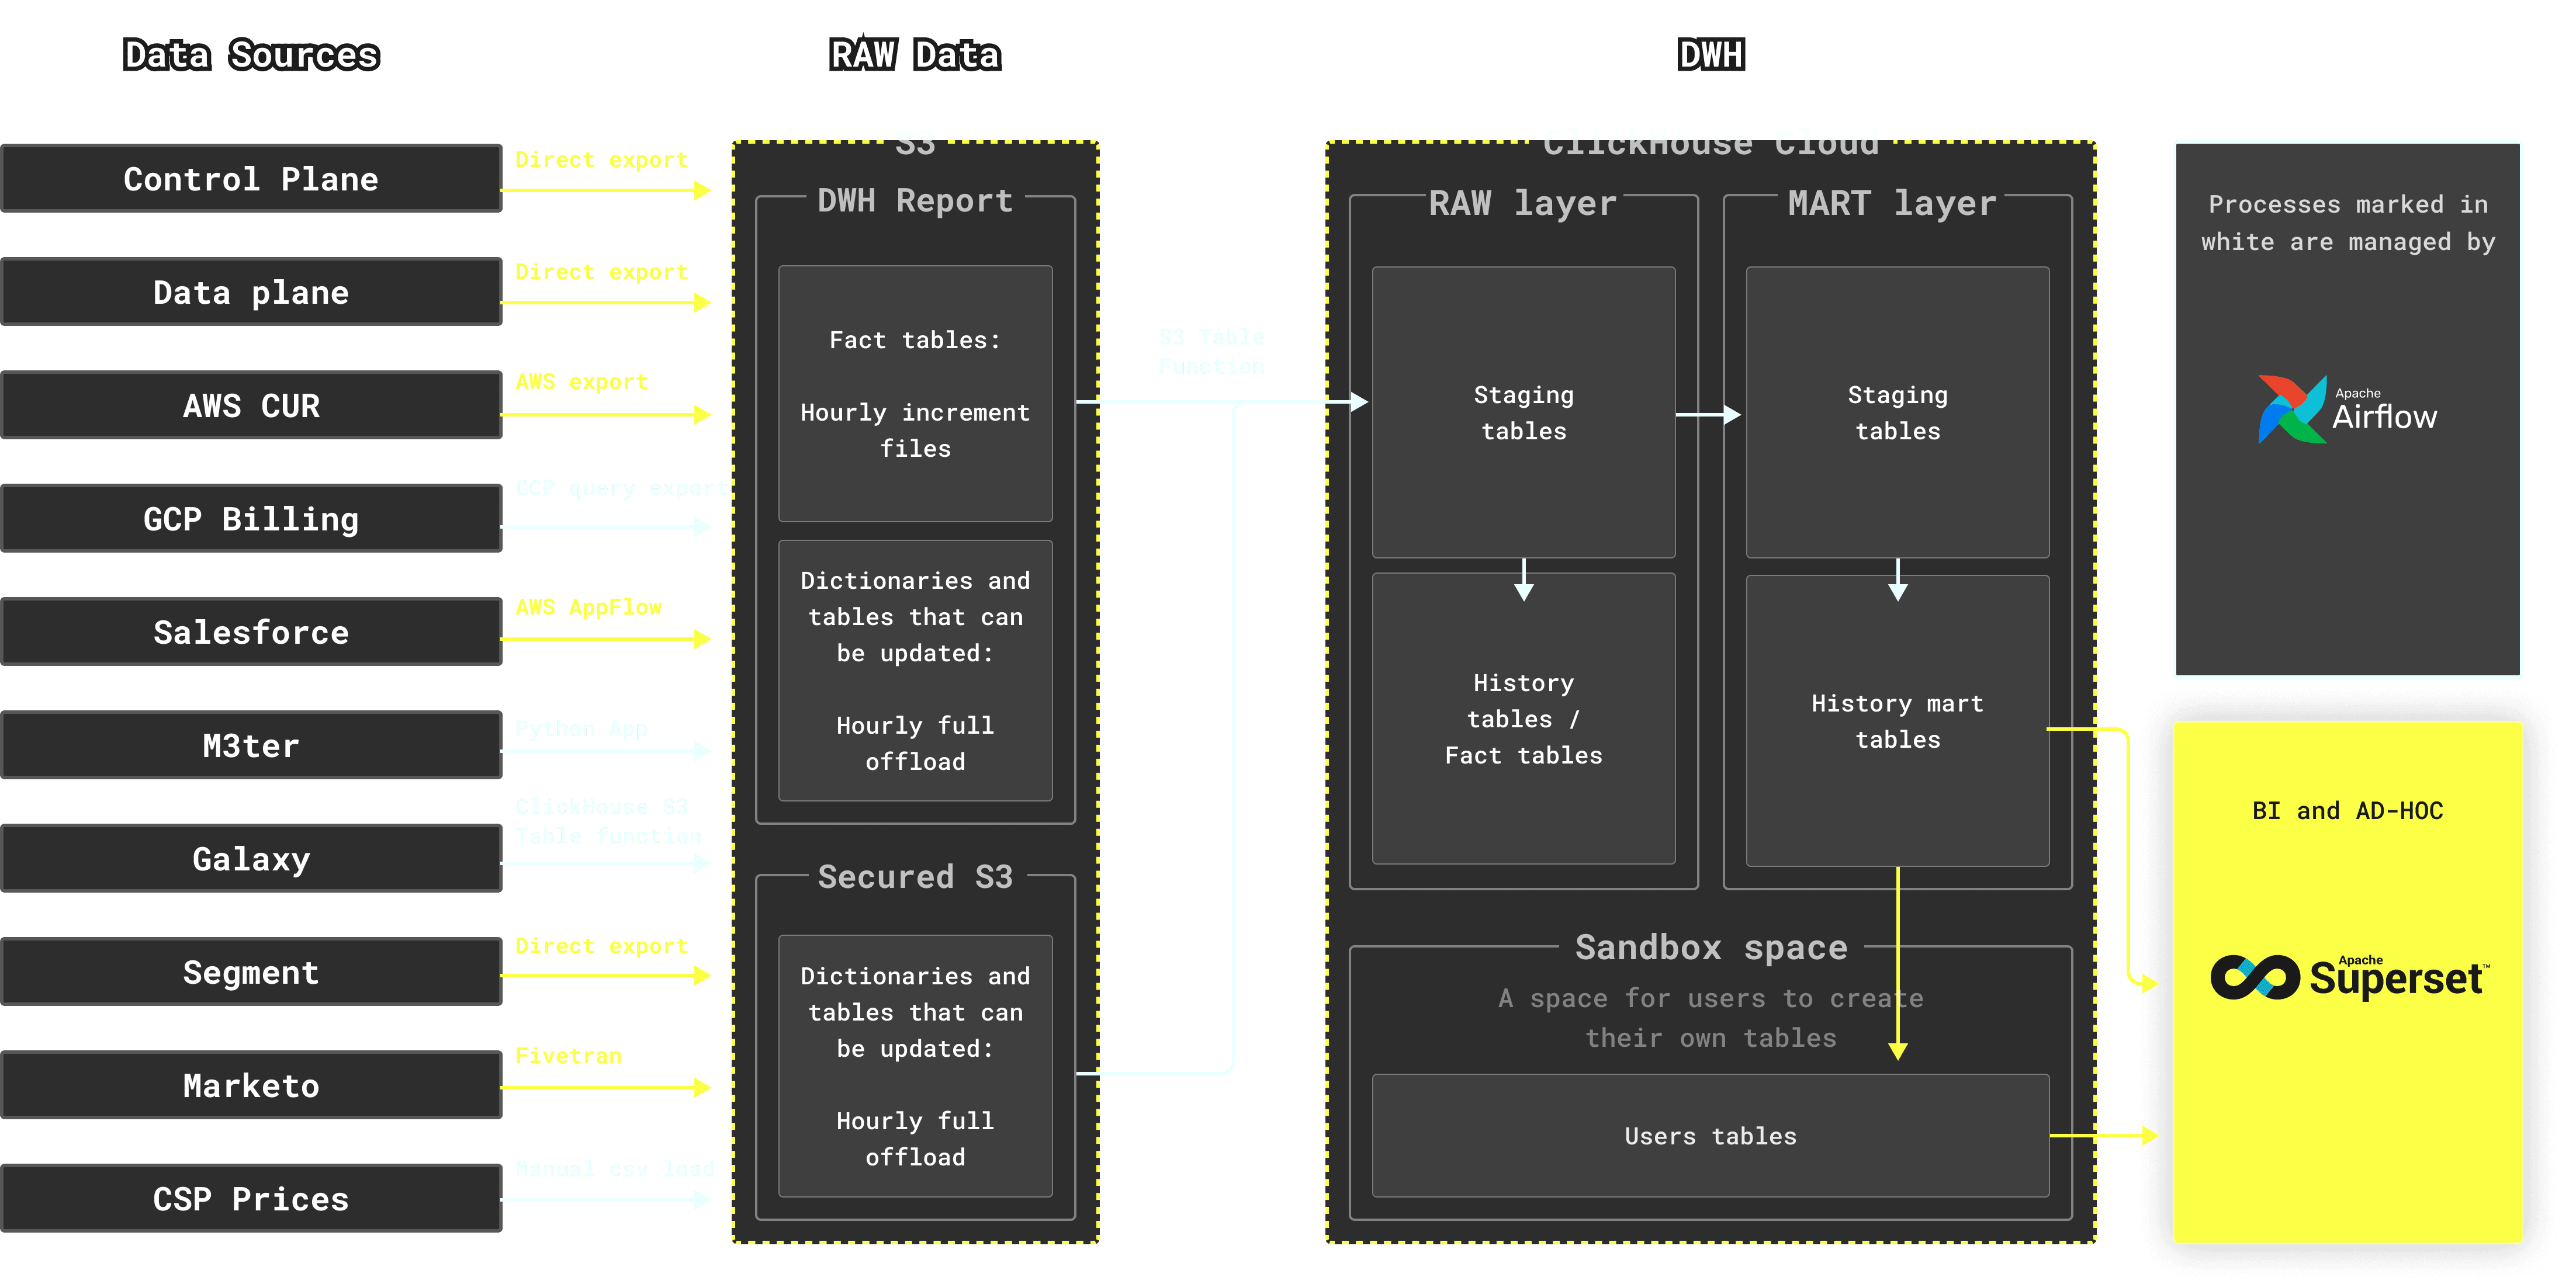
В целом получившийся стек можно описать следующим образом:
- ClickHouse Cloud – основная БД;
- Airflow –планировщик задач (open-source инструмент)
- AWS S3 –промежуточное хранилище сырых данных
- Superset –внутренний BI & AD-HOC инструмент
Мы используем различные инструменты и подходы для сбора данных из источников данных в несколько бакетов S3:
- Для Control Plane, Data Plane, Segment и AWS CUR мы используем встроенную функциональность источника данных для экспорта данных;
- Для биллинга GCP мы используем экспортные запросы BigQuery; для экспорта данных в GCS, откуда они могут быть получены с помощью функции таблиц ClickHouse S3For Salesforce, мы используем AWS AppFlow;
- Для сбора данных с M3ter мы написали свое собственное приложение. Первоначально оно было написано на Kotlin, чуть позже мы перевели его на Python;
- Для Galaxy (которая представлена кластером ClickHouse Cloud) мы используем функцию ClickHouse S3 table для экспорта данных в S3;
- Для Marketo мы используем Fivetran
Наконец, поскольку цены на AWS и GCP меняются очень редко, мы решили не автоматизировать их загрузку, а создали несколько скриптов, которые помогают нам вручную обновлять цены CSP, если это необходимо.
Для больших таблиц фактов мы собираем почасовые приращения. Для словарей и таблиц, которые могут получать не только новые строки, но и обновления, мы используем подход «замены» (т. е. загружаем всю таблицу каждый час).
После того как почасовые данные собраны в бакет S3, для импорта данных в базу данных ClickHouse мы используем функцию ClickHouse s3 table. Функция таблицы S3 масштабируется по репликам и отлично работает с большими объемами данных.
Из бакета S3 данные вставляются в слой RAW в базе данных. Этот слой имеет ту же структуру таблиц, что и источники данных.
После ряда преобразований, выполняемых Airflow (включая join), данные из необработанных таблиц вставляются в таблицы MART - эти таблицы представляют бизнес-сущности и удовлетворяют потребности наших внутренних заинтересованных сторон.
При выполнении преобразований используется множество временных таблиц. Фактически, большинство преобразованных результатов сначала записываются в промежуточную таблицу, и только потом вставляются в целевую таблицу. Хотя такой подход вносит некоторую сложность, он также дает нам необходимую гибкость, позволяя повторно использовать данные приращения. Это позволяет использовать одну часть инкремента несколько раз, не пересчитывая ее и не пересканируя целевую таблицу. Таблицы Staging имеют уникальные имена для каждого Airflow DAG (Directed acyclic graphs).
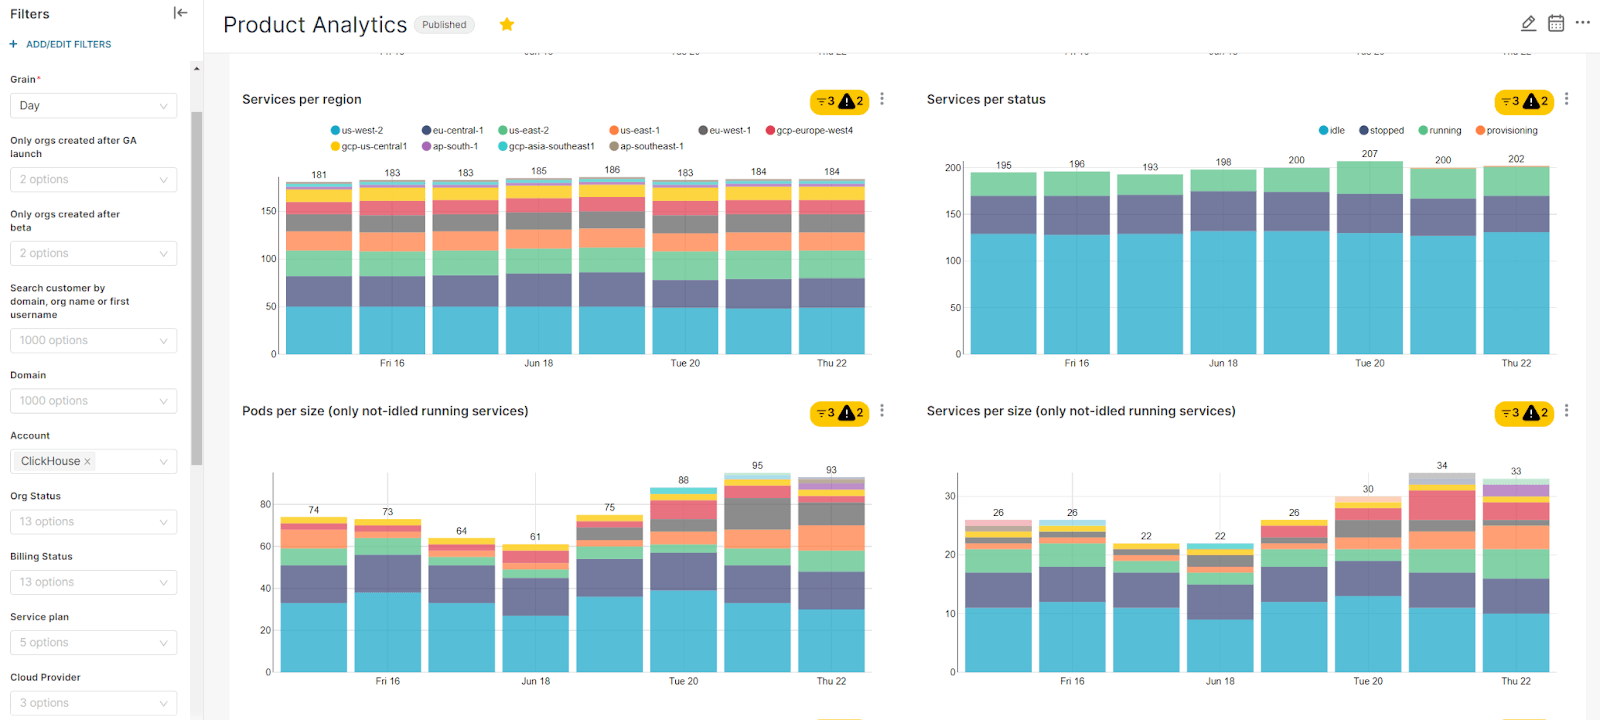
Наконец, инструмент Superset BI позволяет нашим внутренним пользователям запрашивать таблицы MART, а также строить графики и lfi,jhls:
Идемпотентность
Большинство таблиц, которые мы используем в ClickHouse, используют движки ReplicatedReplacingMergeTree. Этот механизм позволяет нам не заботиться о дубликатах в таблицах - записи с одинаковым ключом будут удалены, сохранится только последняя запись. Это также означает, что мы можем вставлять данные за один конкретный час столько раз, сколько потребуется - сохранится только последняя версия каждой строки. Мы также используем функцию ClickHouse «FINAL», когда таблица используется в дальнейших преобразованиях для достижения согласованности, чтобы, например, функция sum() не вычисляла одну и ту же строку дважды.
В сочетании с заданиями/группами Airflow, устойчивыми к многократному выполнению в течение одного и того же периода времени, наш конвейер полностью идемпотентен и может быть безопасно повторно запущен без возникновения дубликатов. Более подробная информация о внутреннем дизайне Airflow будет представлена ниже.
Согласованность данных
По умолчанию ClickHouse обеспечивает финальную согласованность данных. Это означает то, что если Вы успешно выполните запрос на вставку, это не гарантирует того, что новые данные появятся во всех репликах ClickHouse. Этого достаточно для аналитики в реальном времени, но неприемлемо для сценария DWH. Представьте, например, что Вы вставляете данные в таблицу staging. Вставка успешно завершается, и Ваш ELT-процесс начинает выполнять следующий запрос, который считывает данные из таблицы staging... и Вы получаете только частичные данные.
ClickHouse предлагает другой режим для случаев, когда согласованность важнее, чем мгновенная доступность вставленных данных на первом узле. Чтобы гарантировать, что запрос на вставку не вернет «успех», пока все реплики не получат данные, мы запускаем все запросы на вставку с параметром insert_quorum=3 (у нас - три узла в кластере). Мы не используем настройку «auto», потому что, когда один узел выходит из строя (например, при обновлении ClickHouse), два оставшихся узла все равно смогут принимать вставки. Как только перезапущенный узел станет доступен, в течение некоторого времени в нем могут отсутствовать вставленные данные. Поэтому для нас лучше получить ошибку (Number of alive replicas (2) is less than requested quorum (3/3)... (TOO_FEW_LIVE_REPLICAS) при вставке данных менее чем в три реплики. Поскольку перезапуск в связи с обновлением происходит довольно быстро, запросы обычно выполняются успешно даже тогда, когда Airflow повторяет попытку после ошибки.
Конечно, такой подход не гарантирует, что незафиксированные части предыдущих неудачных вставок не будут видны для запроса, но это не проблема, поскольку мы поддерживаем idempotency, как описано в предыдущей части. Другим решением было бы запустить все процессы ELT, используя только одну реплику, но это может ограничить производительность.
Структура внутренней инфраструктуры
Учитывая наш масштаб системы, инфраструктура DWH должна быть простой, удобной в эксплуатации и легко масштабируемой. После проведения внутреннего PoC непосредственно на AWS EC2 мы перевели все компоненты нашей инфраструктуры на Docker.
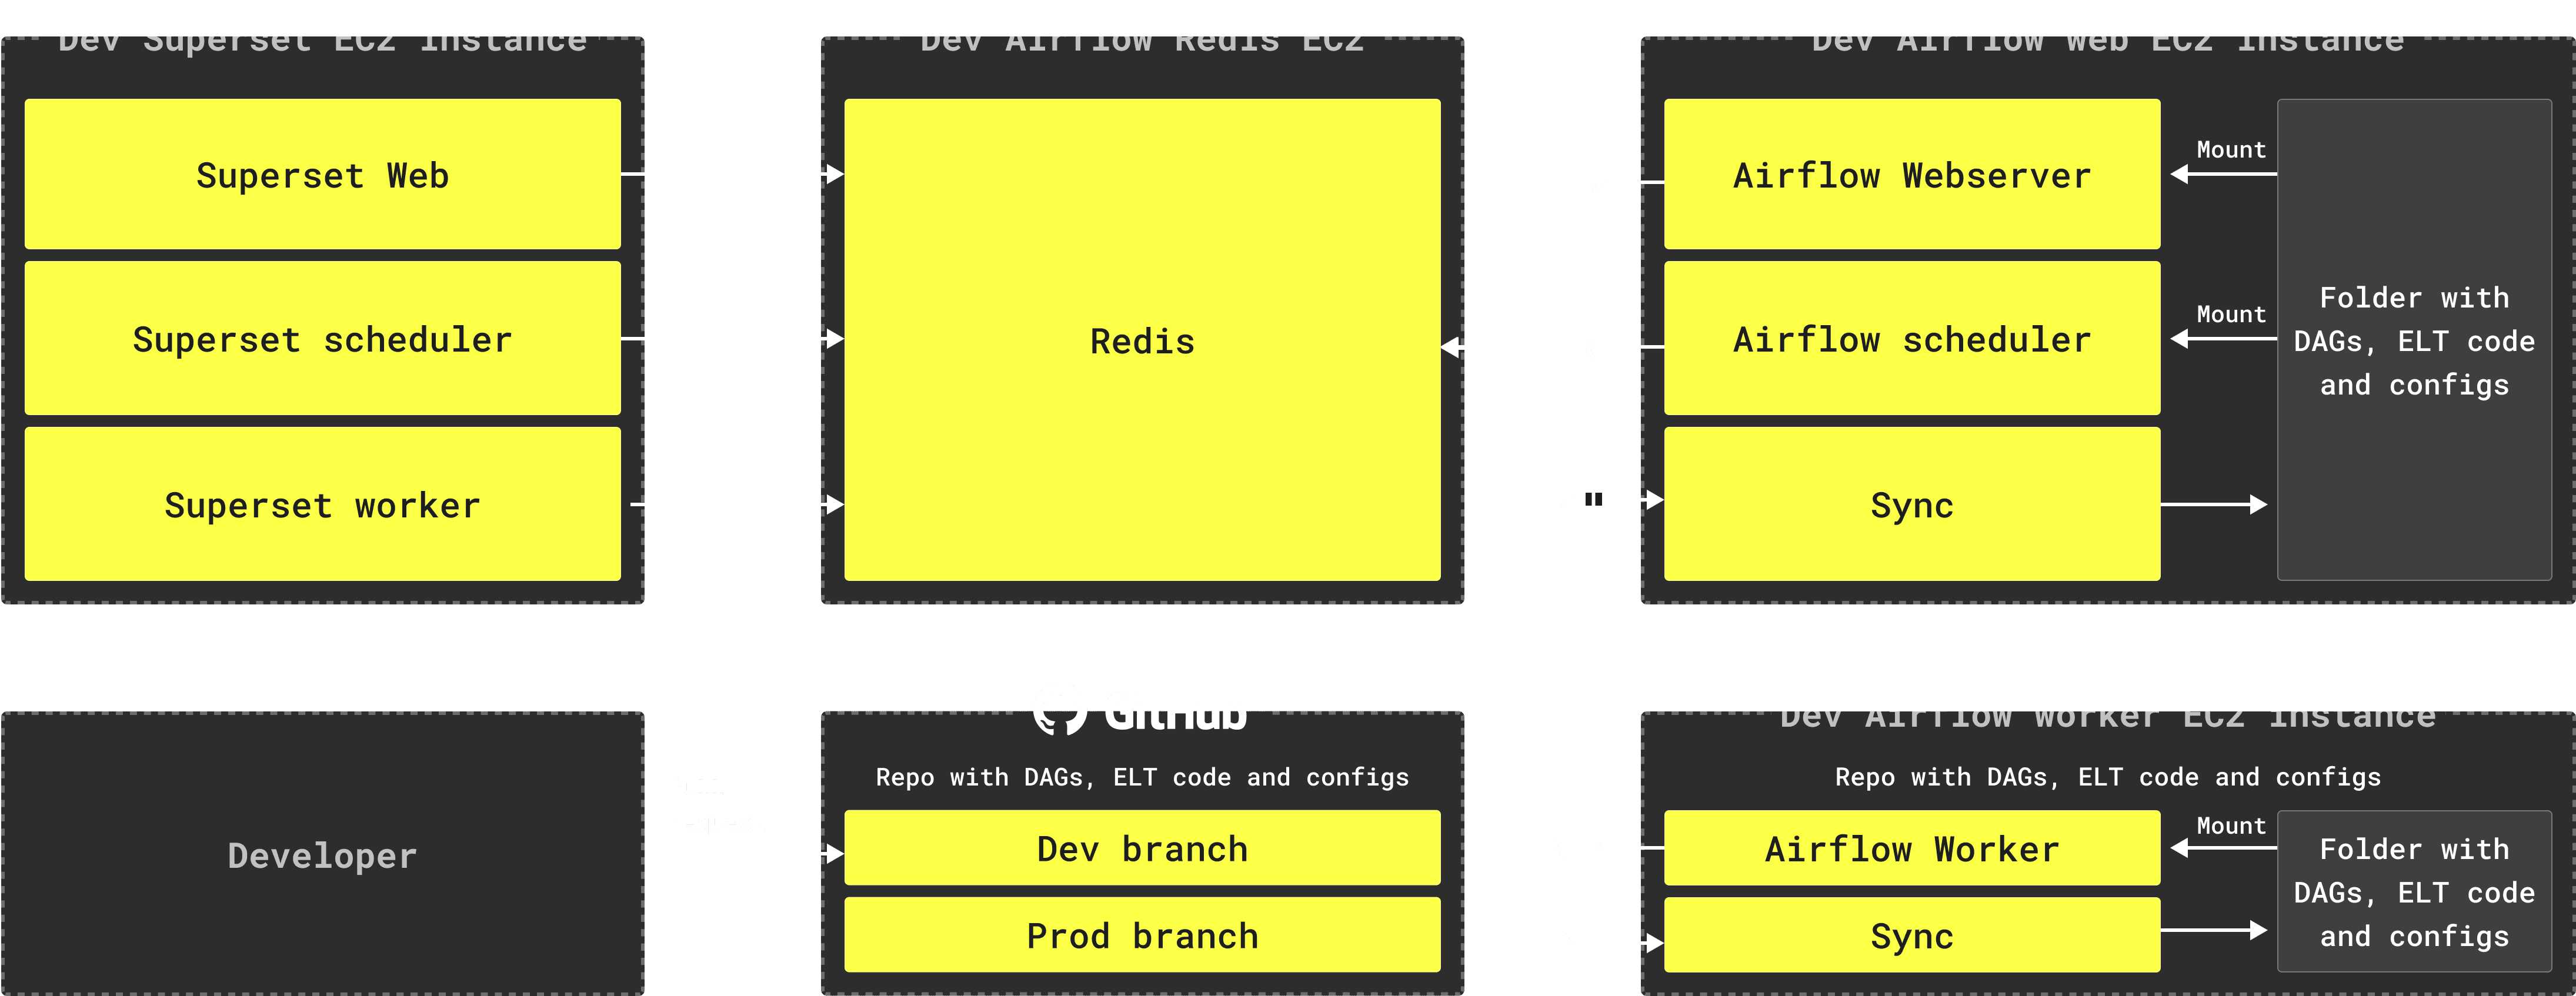
- У нас есть отдельные машины для веб-сервера Airflow, рабочего Airflow и Superset. Все компоненты упакованы в контейнеры Docker.
- На машинах Airflow мы дополнительно запускаем контейнер каждые 5 секунд, который синхронизирует репозиторий, содержащий код наших DAGs, запросы ELT и некоторые конфигурационные файлы, с папкой, расположенной на машинах.
- Мы используем функции дашбордов и оповещений Superset, поэтому у нас есть планировщик и рабочие контейнеры Superset.
- Все компоненты Airflow и Superset синхронизируются через экземпляр Redis, который работает на отдельной машине. Redis хранит состояние выполнения заданий и рабочий код для Airflow, кэшированные результаты запросов для Superset и некоторую другую служебную информацию.
- В качестве внутренней базы данных для Airflow и Superset мы используем AWS RDS для PostgreSQL.
- У нас также есть две среды, работающие независимо друг от друга с собственными экземплярами ClickHouse Cloud, установками Airflow и Superset в разных регионах.
- Одна среда называется Preprod, а другая – Prod. Мы сохраняем Preprod неизменной для того, чтобы иметь возможность переключиться на нее в случае, если Prod вдруг будет недоступна.
Такая настройка позволяет нам безопасно и легко выпускать релизы:
- Разработчик создает ответвление от ветки dev или production
- Разработчик вносит изменения
- Разработчик создает PR для ветки Preprod
- После рассмотрения и утверждения PR изменения попадают в экземпляр Preprod Airflow, где они тестируются.
- Когда изменения готовы к выпуску в prod, выполняется PR из ветки Preprod в Prod
Внутренняя структура Airflow
Изначально мы думали о создании сложной DAG-системы с большим количеством зависимостей. К сожалению, ни один из существующих вариантов механики зависимостей DAG не может работать с желаемой архитектурой (что является довольно распространенной проблемой в Airflow):
- Airflow не позволяет менять имена наборов данных во время выполнения. Поэтому вновь вводимые наборы данных не могут использовать временные имена. Если мы используем статическое имя набора данных, нисходящая группа DAG будет запущена только один раз для последнего инкремента;
- Триггеры могут нам подойти, но их использование слишком усложнит нашу настройку. Наличие 10-20 групп DAG с триггерами – настоящий кошмар с точки зрения эксплуатации.
В результате мы пришли к следующей структуре:
- Отдельные группы DAG для загрузки данных из источника данных в S3 (например, M3ter -> S3)
- Одна огромная основная группа DAG, которая выполняет все преобразования при доставке данных в S3
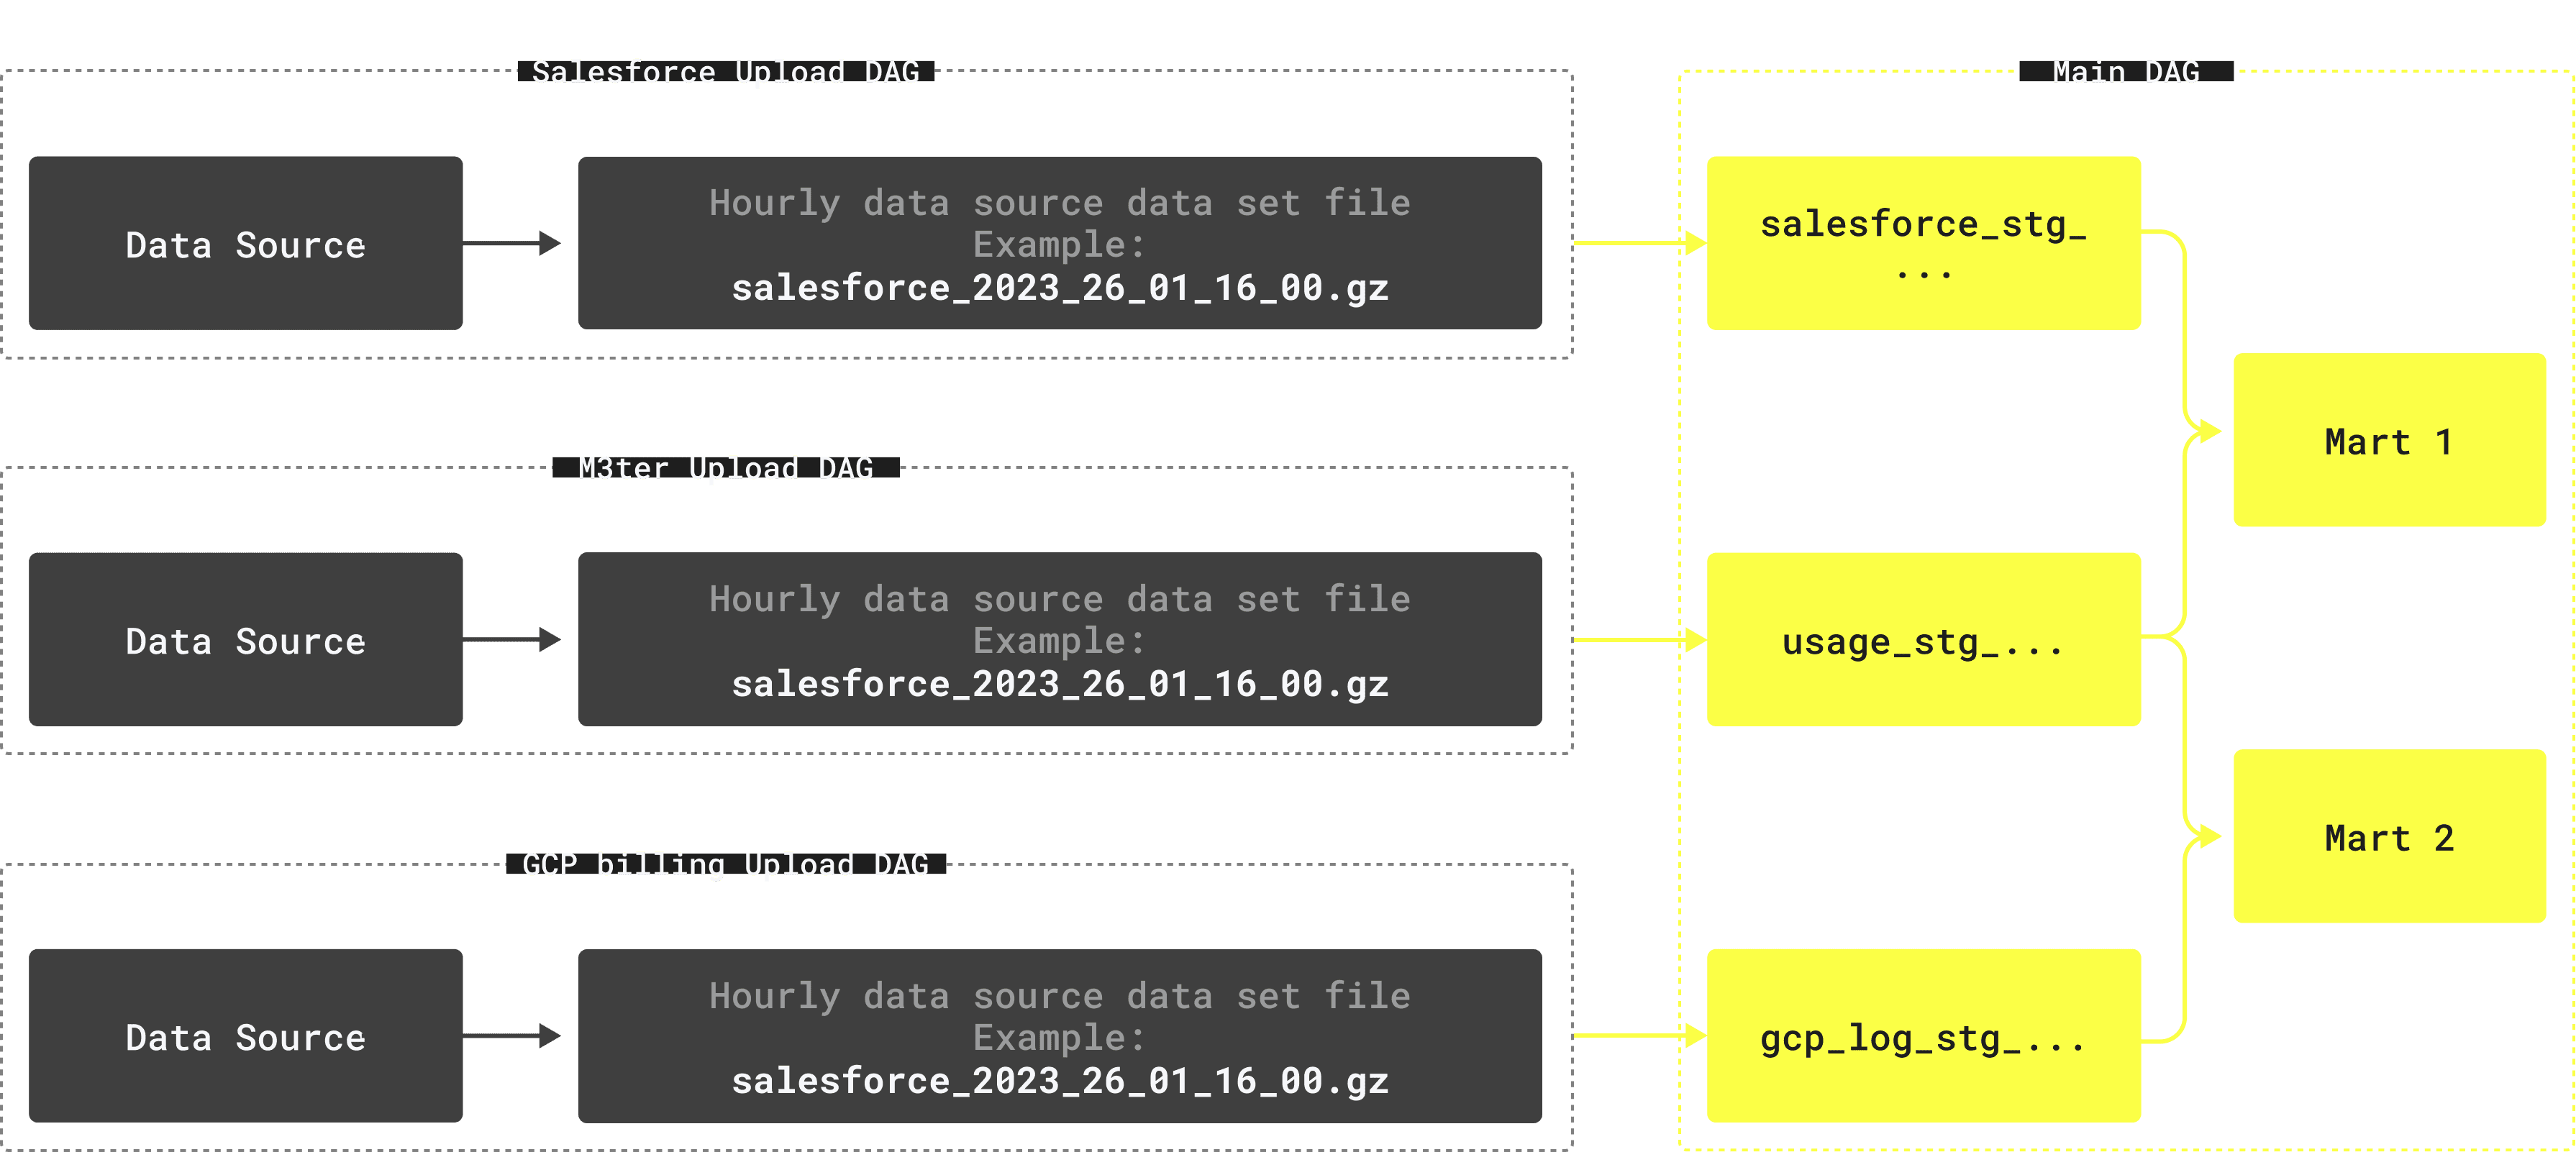
Основное преимущество такого подхода заключается в том, что он сочетает в себе как наличие всех необходимых зависимостей, четко перечисленных в задачах основной DAG, так и возможность построения сущностей, не связанных с неудачным набором данных.
Безопасность
Поскольку в нашей внутренней системе DWH хранятся конфиденциальные данные, включая PII и финансовую информацию, безопасность должна быть основой нашей архитектуры. Для этого мы внедрили несколько основных правил для работы с DWH.
Основные правила
- Различные данные должны быть доступны разным пользователям в соответствии с ролевой моделью компании, это должно происходить автоматически;
- Разделение прав доступа должно осуществляться на уровне базы данных (не на стороне BI!);
- Ограничения сетевого доступа должны быть представлены на всех уровнях (от использования Okta для BI-инструмента до фильтрации IP-адресов)
Реализация правил
Для управления правами доступа внутренних пользователей мы используем группы Google. Это позволяет нам использовать все существующие внутренние группы компании, а также дает возможность владельцам групп (которые могут быть представлены нетехническими специалистами, не разбирающимися в SQL) контролировать доступ к различным данным. Группы могут быть вложенными. Например:
Для сопоставления групп Google с точными разрешениями мы используем системную таблицу, которая соединяет:
- Название группы Google
- Название БД
- Название таблицы
- Массив столбцов
- фильтер (например, “where organization=’clickhouse’”)
- тип доступа (SELECT, INSERT)
У нас также есть тип, который делает следующее:
- Получает рекурсивный список групп и пользователей
- Создает (фактически, заменяет) этих пользователей в базе данных с уникальным паролем
- Создает роли, соответствующие группам Google
Присвоение ролей пользователям
Предоставляет разрешения ролям в соответствии с таблицей разрешений с пунктом «WITH REPLACE OPTION» - при этом все другие разрешения, которые по каким-то причинам могли быть сделаны вручную, удаляются.
На стороне Superset для замены имени пользователя базы данных на пользователя Superset при отправке запроса к базе данных мы используем функцию DB_CONNECTION_MUTATOR. У нас также включен Google Oauth. Это означает, что в DB_CONNECTION_MUTATOR есть все необходимое для того, чтобы Superset подключался с нужным именем пользователя и паролем:
Def DB_CONNECTION_MUTATOR(uri, params, username, security_manager, source):# Only enable mutator on clickhouse cloud endpoints if noturi.host.lower().endswith("clickhouse.cloud"):returnuri, paramsuser = security_manager.find_user(username=username)generated_username =str(user.email).split('@')[0] +'--'+str(user.username)uri.username = generated_username# Password generation logic - hidden in this exampleuri.password = ...returnuri, params
Все вышесказанное означает, что Superset использует уникальное имя пользователя базы данных для каждого пользователя, с уникальным набором разрешений, которые контролируются группами Google.
Соблюдение требований GDPR
Пользователи ClickHouse Cloud могут попросить нас удалить все их личные данные, включая имя, электронную почту и другую информацию. Разумеется, в этом случае мы удаляем эту информацию и из DWH. Самое интересное здесь то, что нам не нужно выполнять никаких обновлений или удалений в таблицах ClickHouse. Поскольку наш движок оставляет только одну последнюю запись для каждого ключевого значения, все, что нам нужно сделать, - это вставить новую версию строки с удаленными данными пользователей. Для того чтобы старые строки исчезли, потребуется несколько часов; стандарты GDPR дают от 3 до 30 дней на удаление данных в зависимости от сценария. Итак, полный алгоритм действий выглядит так:
- Найдите в одной из исходных систем специальный флаг, указывающий на то, что этот идентификатор должен быть замаскирован/удален;
- Выберите все записи из таблицы с этим идентификатором;
- Замаскируйте обязательные поля;
- Вставьте данные обратно в таблицу;
- Выполните команду « optimize table... final» для того, чтобы убедиться, что старые записи удалены с диска.
- Мы выполняем присоединение к списку удаленных идентификаторов на регулярной основе. Это означает, что если по какой-то причине PII-информация пользователя еще не была полностью удалена, мы автоматически замаскируем эти данные.
Оптимизации и планы на будущее
Хотя в целом мы довольны нашим DWH, есть некоторые вещи, которые мы планируем изменить в ближайшие месяцы:
Третий логический уровень
Идея иметь только два логических слоя, к сожалению, оказалась не совсем работоспособной. Мы обнаружили, что для расчета действительно сложных метрик, которые могут быть заполнены и для которых нужны данные из 5+ источников данных, приходится создавать зависимости между различными картами. Иногда это даже включает рекурсивные зависимости. Чтобы решить эту проблему, нам необходимо внедрить промежуточный слой, называемый Detail Data Store, или DDS. В нем будут храниться некоторые внутренние бизнес-сущности, такие как счет, организация, услуга и т. д. Этот слой не будет доступен конечным пользователям, но он поможет нам устранить зависимости между витринами данных.
DBT
Airflow - хороший планировщик, но нам нужен инструмент, который будет заботиться и о многих других вещах: полной перезагрузке карт данных, QA, описании данных и документировании, и других. Для этого мы планируем интегрировать Airflow с DBT. Поскольку мы используем всю нашу инфраструктуру данных в контейнерах Docker, довольно просто создать отдельный контейнер DBT для наших нужд, который будет запускаться DAGами Airflow.
Соглашения об именовании
Хотя с самого начала мы знали, что должны следовать некоторым правилам в наименовании таблиц, полей и диаграмм, мы не вкладывали в это слишком много ресурсов. В результате у нас получились довольно запутанные названия, которые не позволяют пользователям понять назначение той или иной таблицы или поля сразу. Мы должны сделать их более понятными и однозначными.
Ресурсы
ClickHouse - относительно молодая компания, поэтому наша команда DWH относительно невелика и состоит всего из 3 человек:
- Инженер по данным – строит и обслуживает инфраструктуру;
- Аналитик продукта - помогает пользователям получать нужную им информацию, строить графики и понимать данные;
- Руководитель группы – на задачи, связанные с DWH, у него уходит ~30% рабочего времени.
Что касается инфраструктуры, то мы используем две среды с отдельными облачными сервисами ClickHouse Cloud. Каждый сервис имеет 3 узла (они же реплики, но все реплики принимают запросы). Объем памяти для наших сервисов ClickHouse составляет ~200 Гб. Хотя мы не платим за эти услуги, так как являемся частью команды ClickHouse Cloud, мы изучили цены и производительность конкурентов и считаем, что в нашем случае другая облачная аналитическая база данных была бы намного дороже.
Кроме того, наша инфраструктура включает 8 машин EC2 и бакет S3 с необработанными данными. В общей сложности эти услуги стоят около ~$1 500 в месяц.
Итоги
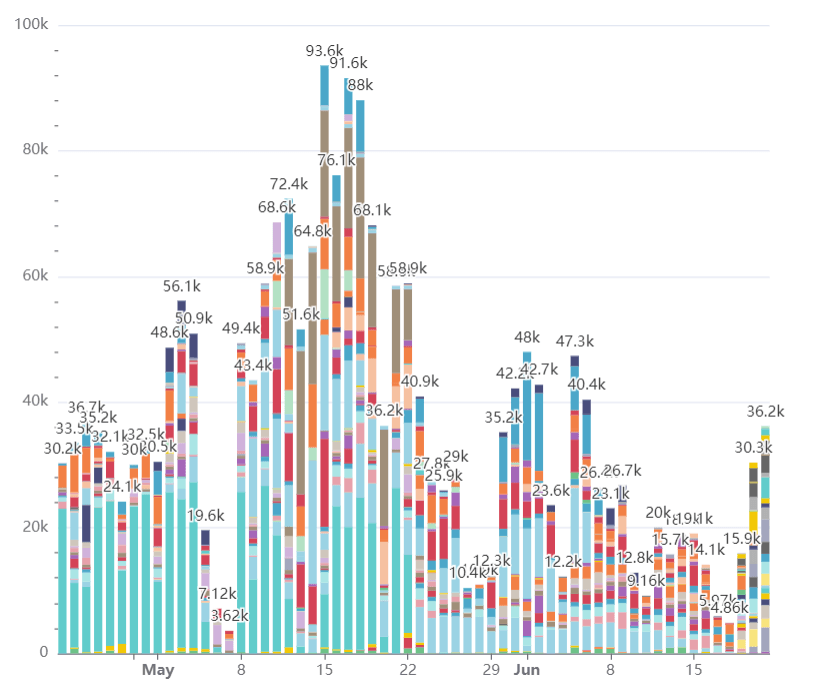
Наш DWH работает уже более одного года. У нас >70 ежемесячных активных пользователей, сотни дашбордов и тысячи графиков. В общей сложности пользователи выполняют ~40 000 запросов в день. На этом графике показано количество запросов в день с разбивкой по пользователям. Пользователи системы и ELT исключены:
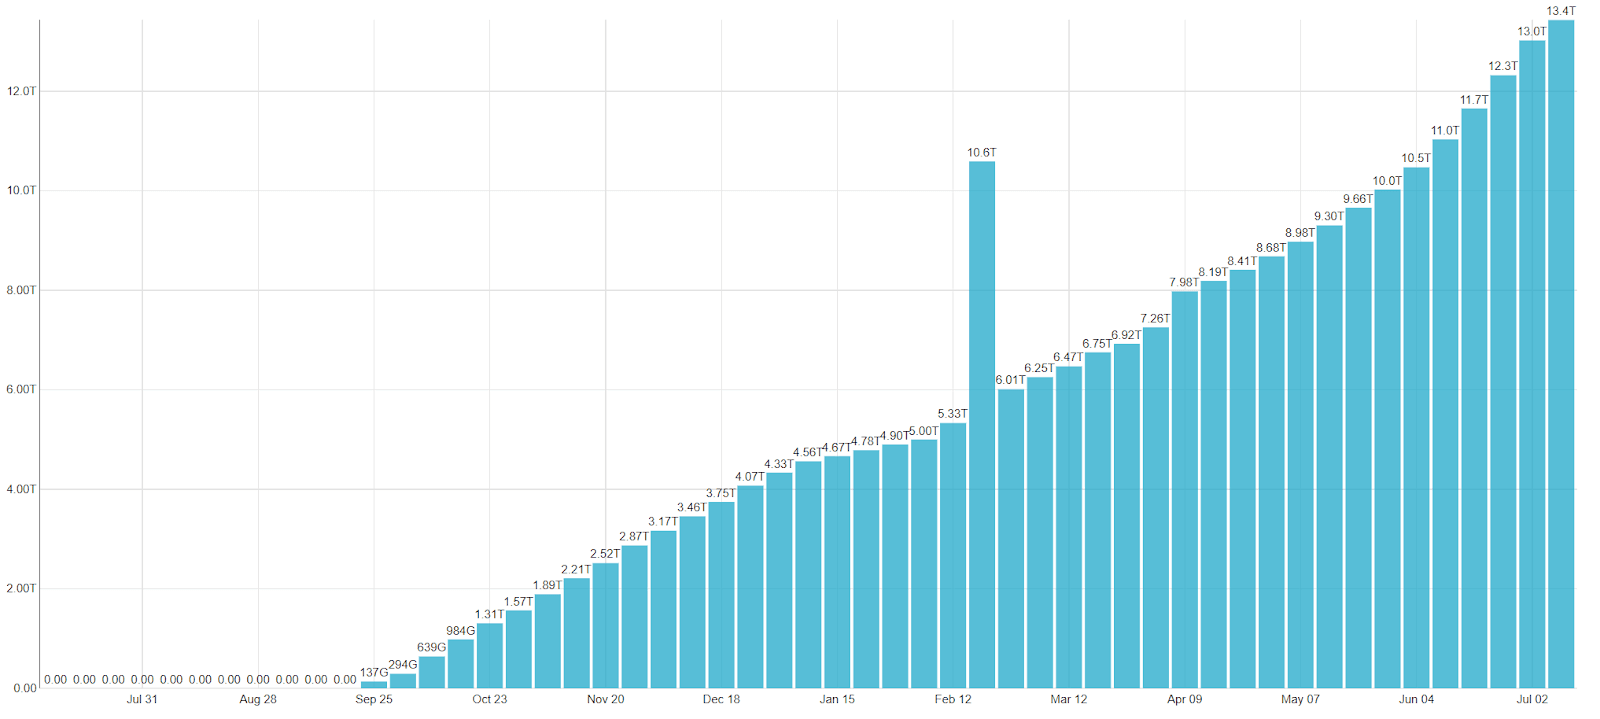
Мы храним ~115 Тб несжатых данных в ~150 таблицах, благодаря эффективному сжатию ClickHouse фактический объем хранимых данных составляет всего ~13 Тб.
Заключение
За один год мы развернули DWH на основе технологии с открытым исходным кодом, которая очень нравится нашим пользователям. Хотя наша DWH позволяет вполне легко работать с данными, мы все же видим и панируем реализовать несколько оптимизаций, которые нужны для того, чтобы двигаться дальше. Мы считаем, что ClickHouse Cloud можно и нужно использовать для создания надежной DWH.


