

Выбор правильного JOIN
В этой статье мы подведем итоги всего того, что было обсуждено ранее, сравним временя выполнения запросов и поговорим о некоторых нюансах алгоритмов объединения. На основе этого мы предоставим Вашему вниманию несколько деревьев решений, а также обзор основных типов JOIN и примеры их использования.
Обзор алгоритмов JOIN, доступных в ClickHouse
На данный момент специально для ClickHouse разработаны следующие 6 алгоритмов JOIN:
- Direct join
- Hash join
- Parallel hash join
- Grace hash join
- Full sorting merge join
- Partial merge join
Все эти алгоритмы определяют способ планирования и выполнения запроса на объединение. По умолчанию ClickHouse использует direct join или hash join (в зависимости от используемого типа объединения, а также движка объединяемых таблиц). Кроме того, ClickHouse можно настроить на выбор и динамическое изменение алгоритмов JOIN (в зависимости от доступности и наличия ресурсов). Если для параметра join_algorithm установлено значение auto, то ClickHouse в первую очередь пробует использовать hash-join. Если лимит памяти этого алгоритма нарушен, то Clichouse автоматически переключается на partial merge join. Понять, какой именно алгоритм был выбран, можно через Trace Logging. Вы также же можете указать желаемый алгоритм объединения самостоятельно. На диаграмме, представленной ниже, Вы найдете обзор алгоритмов JOIN, принимающий во внимание особенности потребления памяти и время выполнения запросов:

Direct join - это самый быстрый алгоритм соединения ClickHouse, который применяется в тех случаях, когда базовое хранилище для таблицы правой стороны поддерживает запросы ключей-значений с низкой задержкой или когда семантика LEFT ANY JOIN является полной и достаточной. Direct join особенно хорош при работе с очень большими таблицами.
Три алгоритма соединения ClickHouse основаны на хэш-таблицах in-memory:
Hash join работает быстро, занимает мало памяти, и при всем при этом является наиболее универсальным алгоритмом соединения, поддерживающим все типы JOIN и настройки строгости. Данный алгоритм может быть ограничен объемом памяти (как правило, речь идет о достаточно большом объеме). Кроме того, создание хэш-таблицы из таблицы правой стороны является однопоточным и может представлять собой трудную задачу с точки зрения времени выполнения запроса (особенно если таблица правой стороны слишком велика).
Parallel hash join может быть гораздо быстрее при работе с большими таблицами. Это происходит за счет одновременного построения сразу нескольких хэш-таблиц, что требует достаточно большого объема памяти.
Grace hash join - non-memory версия, которая выгружает данные прямо на диск, не требуя их сортировки. Это позволяет решить наиболее распространенные проблемы производительности алгоритмов JOIN, не связанных с памятью (которые передают данные на диск и требуют предварительную сортировку данных).
ClickHouse предлагает своим пользователям два дополнительных non-memory алгоритма объединения без ограничения памяти, основанных на внешней сортировке:
- Full sorting merge join основан на сортировке в памяти (или внешней сортировке), может использовать физический порядок строк в объединенных таблицах и пропускать фазу сортировки. В таких случаях производительность объединения может быть такой же высокой, как и при hash join (при этом, как правило, требуется значительно меньше оперативной памяти);
- Partial merge join оптимизирован для минимизации памяти, используемой для объединении больших таблиц, и всегда полностью сортирует сначала правую таблицу с помощью внешней сортировки. Левая таблица также сортируется в памяти. Процесс согласования JOIN выполняется более эффективно, если физический порядок строк левой таблицы совпадает с порядком сортировки ключей соединения.

Выбор оператора JOIN
Выбор алгоритма объединения зависит от трех факторов:
- Производительность;
- Память;
- Поддерживаемый тип Join
В следующих трех разделах данные факторы рассмотрены более подробно.
Производительность
Для выбора подходящего алгоритма объединений, когда главным критерием является скорость выполнение запроса, рекомендуем пользоваться следующим деревом решений:
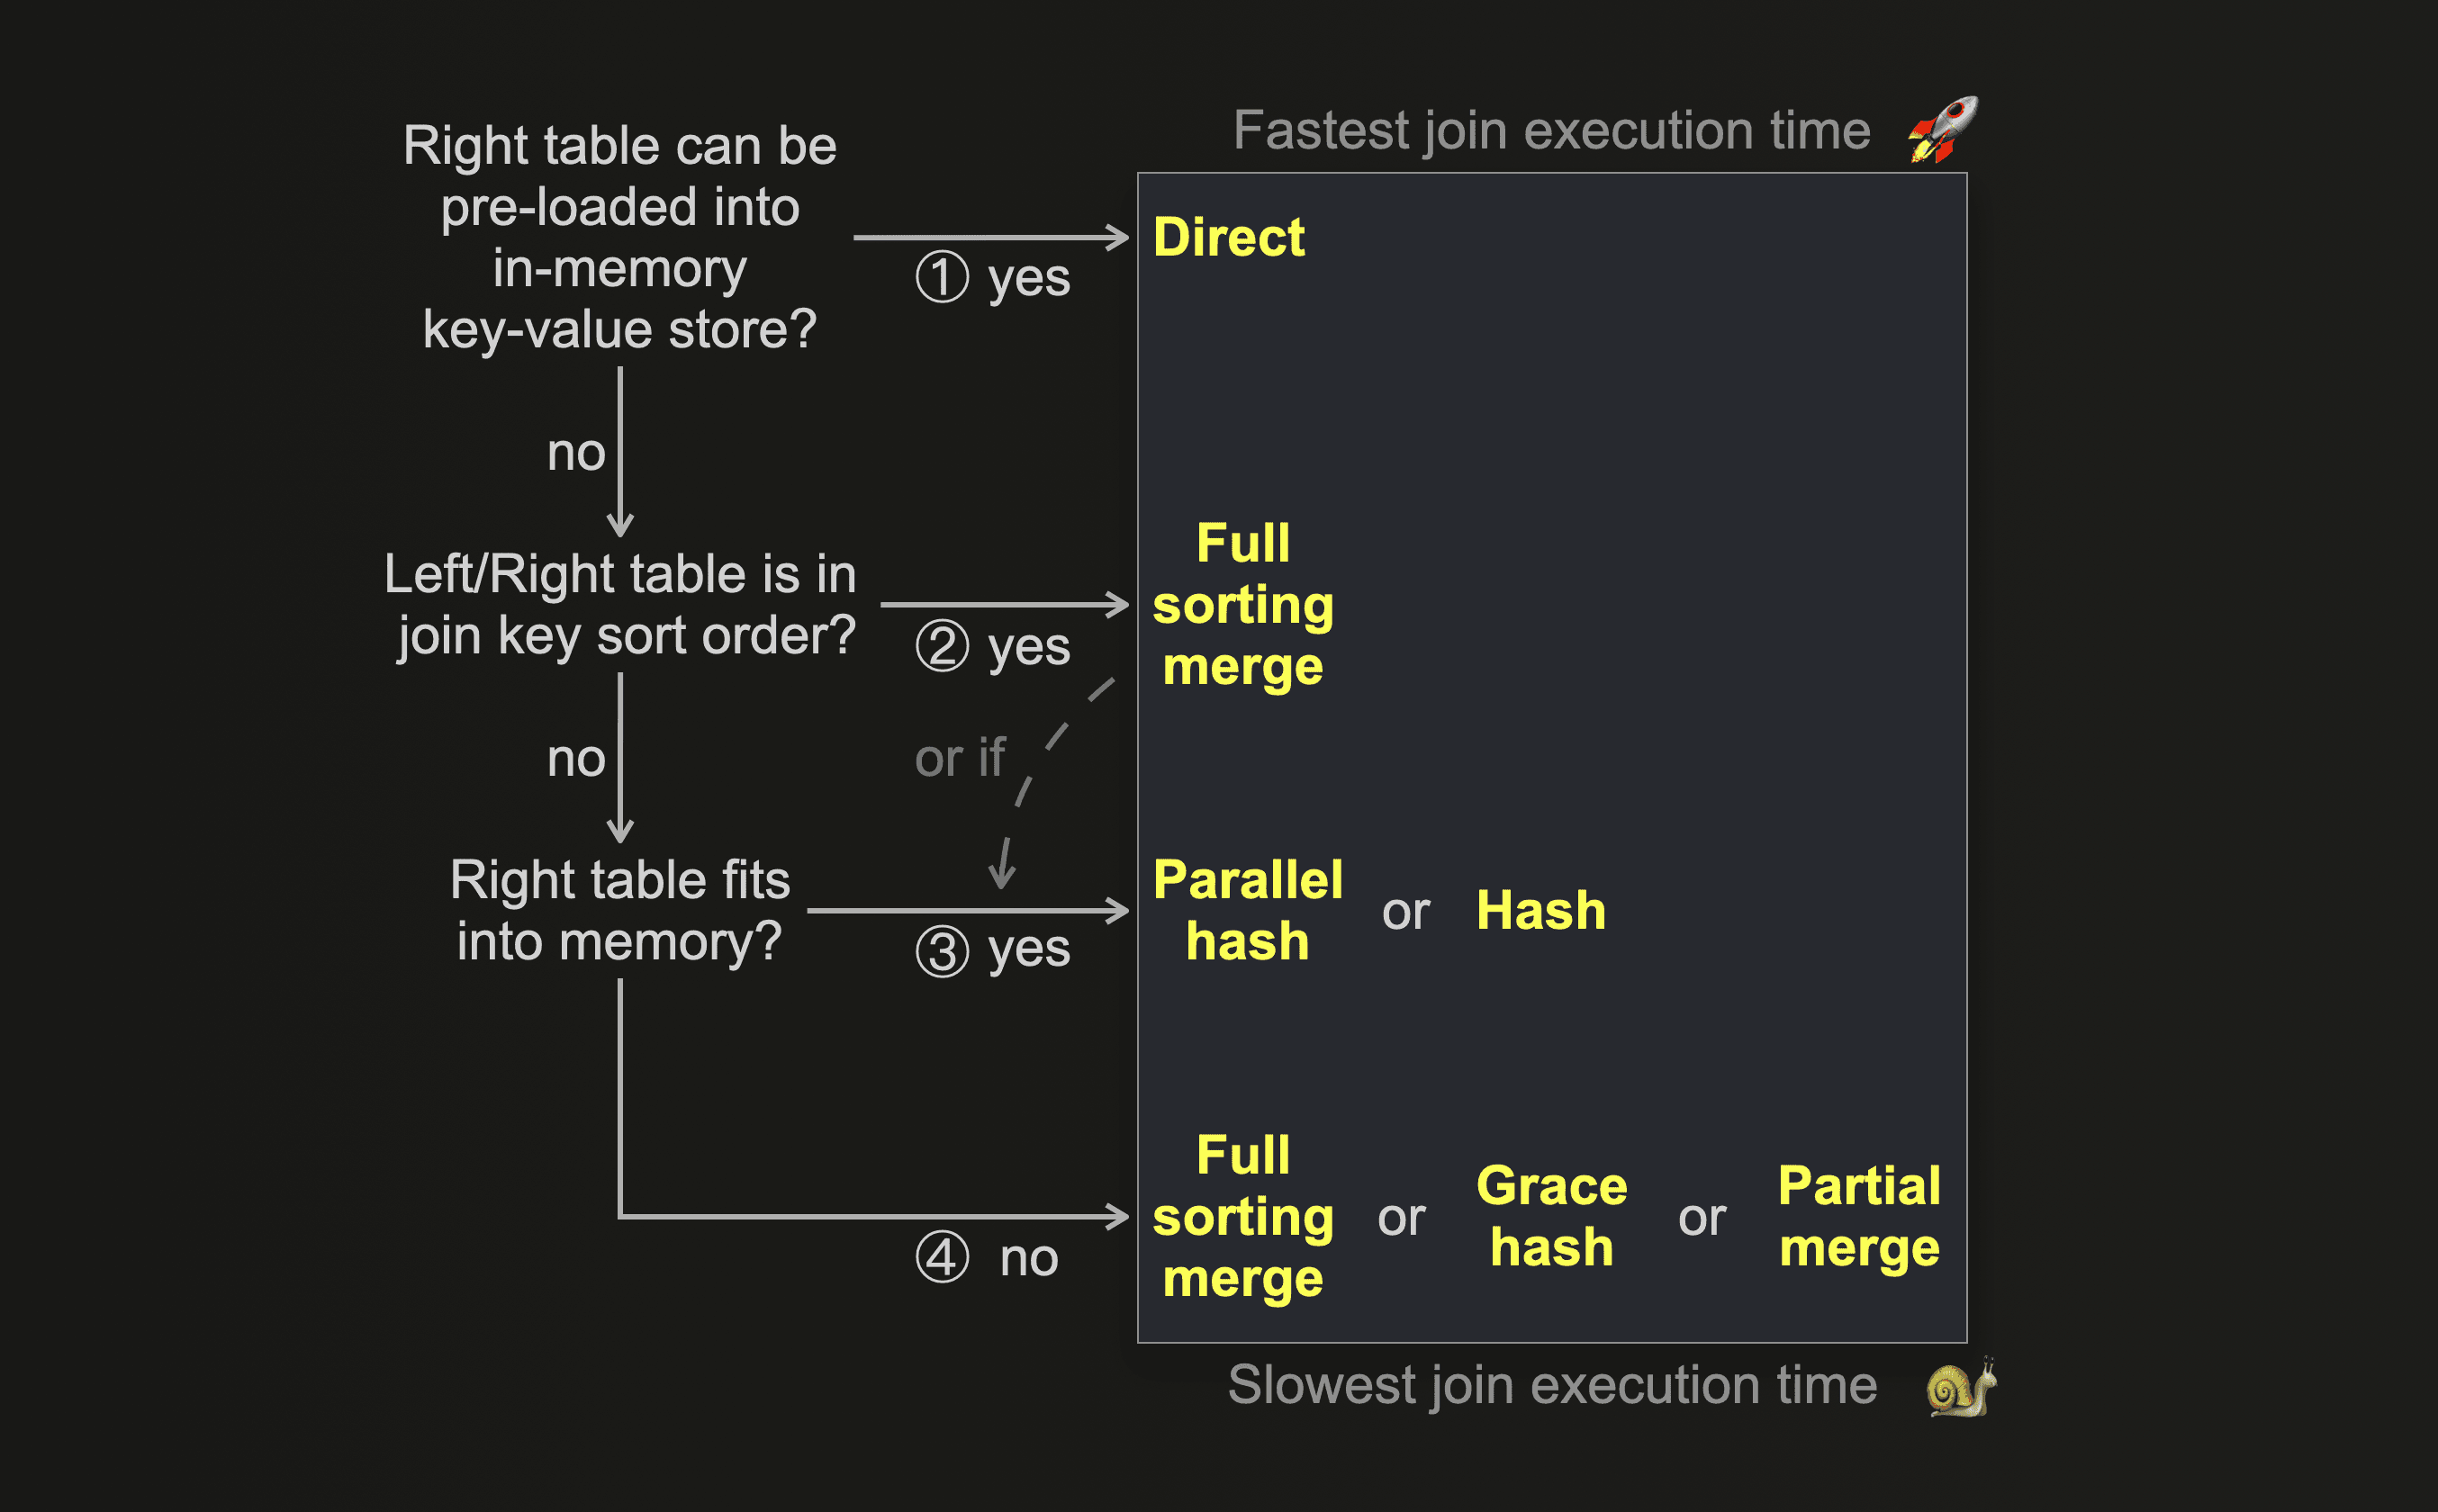
- Если данные из таблицы правой стороны можно предварительно загрузить в структуру ключевых значений с низкой задержкой (например, в словарь), и если ключ соединения совпадает с атрибутом ключа базового хранилища ключевых значений (и если семантика LEFT ANY JOIN понятна и достаточна), больше всего подходит direct join;
- Если физический порядок строк в таблице совпадает с порядком сортировки по ключу объединения, возможны разные варианты. Full sorting merge join пропускает фазу сортировки, что приводит к значительному сокращению использованной памяти и, в зависимости от размера данных и распределения значений ключей объединения, к более быстрому выполнению запроса;
- Однако если нужная таблица помещается в выделенной памяти, то даже с учетом дополнительных расходов памяти на параллельное хэш-соединение более всего подходит hash join. Все зависит от размера данных, типов данных и распределения значений ключевых столбцов объединения;
- Если нужная Вам таблица не помещается в памяти, стоит обратить свое внимание на алгоритмы объединения без ограничения памяти. Все три алгоритма временно выгружают данные на диск. Full sorting merge join и partial merge join требуют предварительной сортировки данных. Grace hash join строит хэш-таблицы из имеющихся данных. В зависимости от объема данных, типов данных и распределения значений столбцов ключа объединения могут возникнуть случае, когда построение хэш-таблиц из данных будет быстрее, чем их сортировка. И наоборот.
Partial join оптимизирован для минимизации использования памяти при объединении больших таблиц (за счет низкой скорости объединения). Это особенно полезно в том случае, когда физический порядок строк левой таблицы не совпадает с порядком сортировки ключей соединения.
Grace hash join, наверное, наиболее гибкий из всех трех алгоритмов объединения без ограничения памяти, который обеспечивает достаточно хороший контроль над использованием памяти в зависимости от скорости объединения с помощью настройки grace_hash_join_initial_buckets. В зависимости от объема данных grace hash может быть быстрее или медленнее алгоритма partial merge, если количество бакетов выбрано таким образом, чтобы использование памяти обоими алгоритмами было примерно одинаковым. Когда использование памяти для grace hash join настроено таким образом, что оно примерно соответствует использованию памяти для full sorting merge, последний всегда оказывается быстрее.
Какой из трех алгоритмов без ограничения памяти окажется самым быстрым, зависит от объема данных, типов данных и распределения значений ключевых столбцов объединения. Чтобы определить, какой алгоритм самый быстрый, лучше провести несколько бенчмарков с реальными объемами данных.
Память
Если Вы хотите оптимизировать join исходя из объема используемой памяти (а не времени выполнения запроса), то обязательно воспользуйтесь следующим деревом решений:
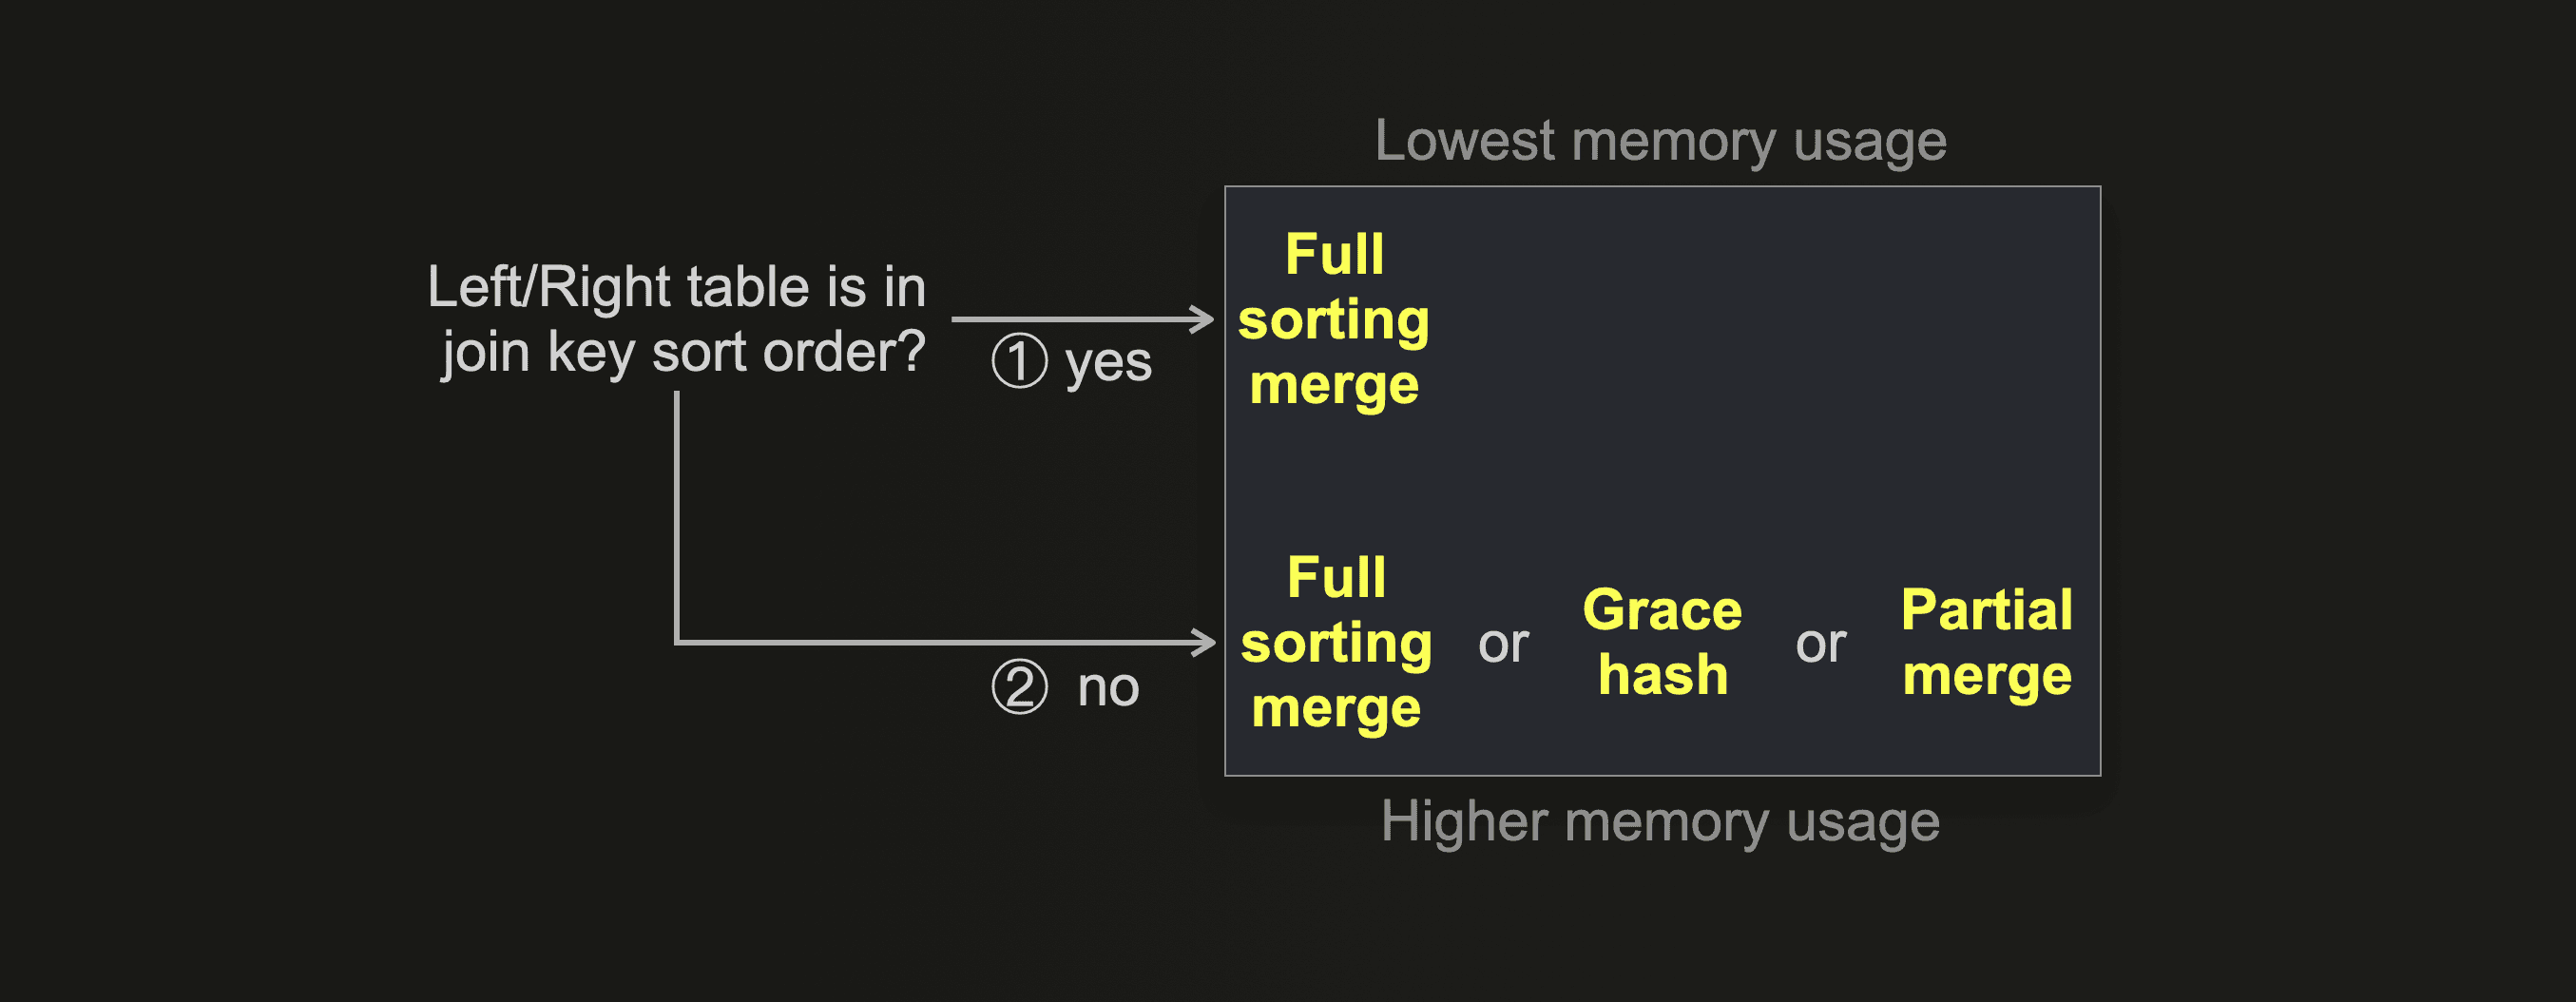
Если физический порядок строк в таблице совпадает с порядком сортировки по ключу соединения, то использование памяти при объединении с полной сортировкой будет минимальным. Дополнительным преимуществом такого подхода является высокая скорость соединения (ввиду того, что фаза сортировки отключена).
Grace hash join можно настроить на минимальное потребление памяти, задав большое количество бакетов за счет снижения скорости соединения. Partial merge join, как правило, использует сравнительно небольшой объем оперативной памяти. Full sorting merge join обычно требуется больше памяти, чем partial merge join (при условии, что порядок строк не совпадает с порядком сортировки по ключу), при этом скорость выполнения запроса значительно выше.
Поддерживаемые типы JOIN
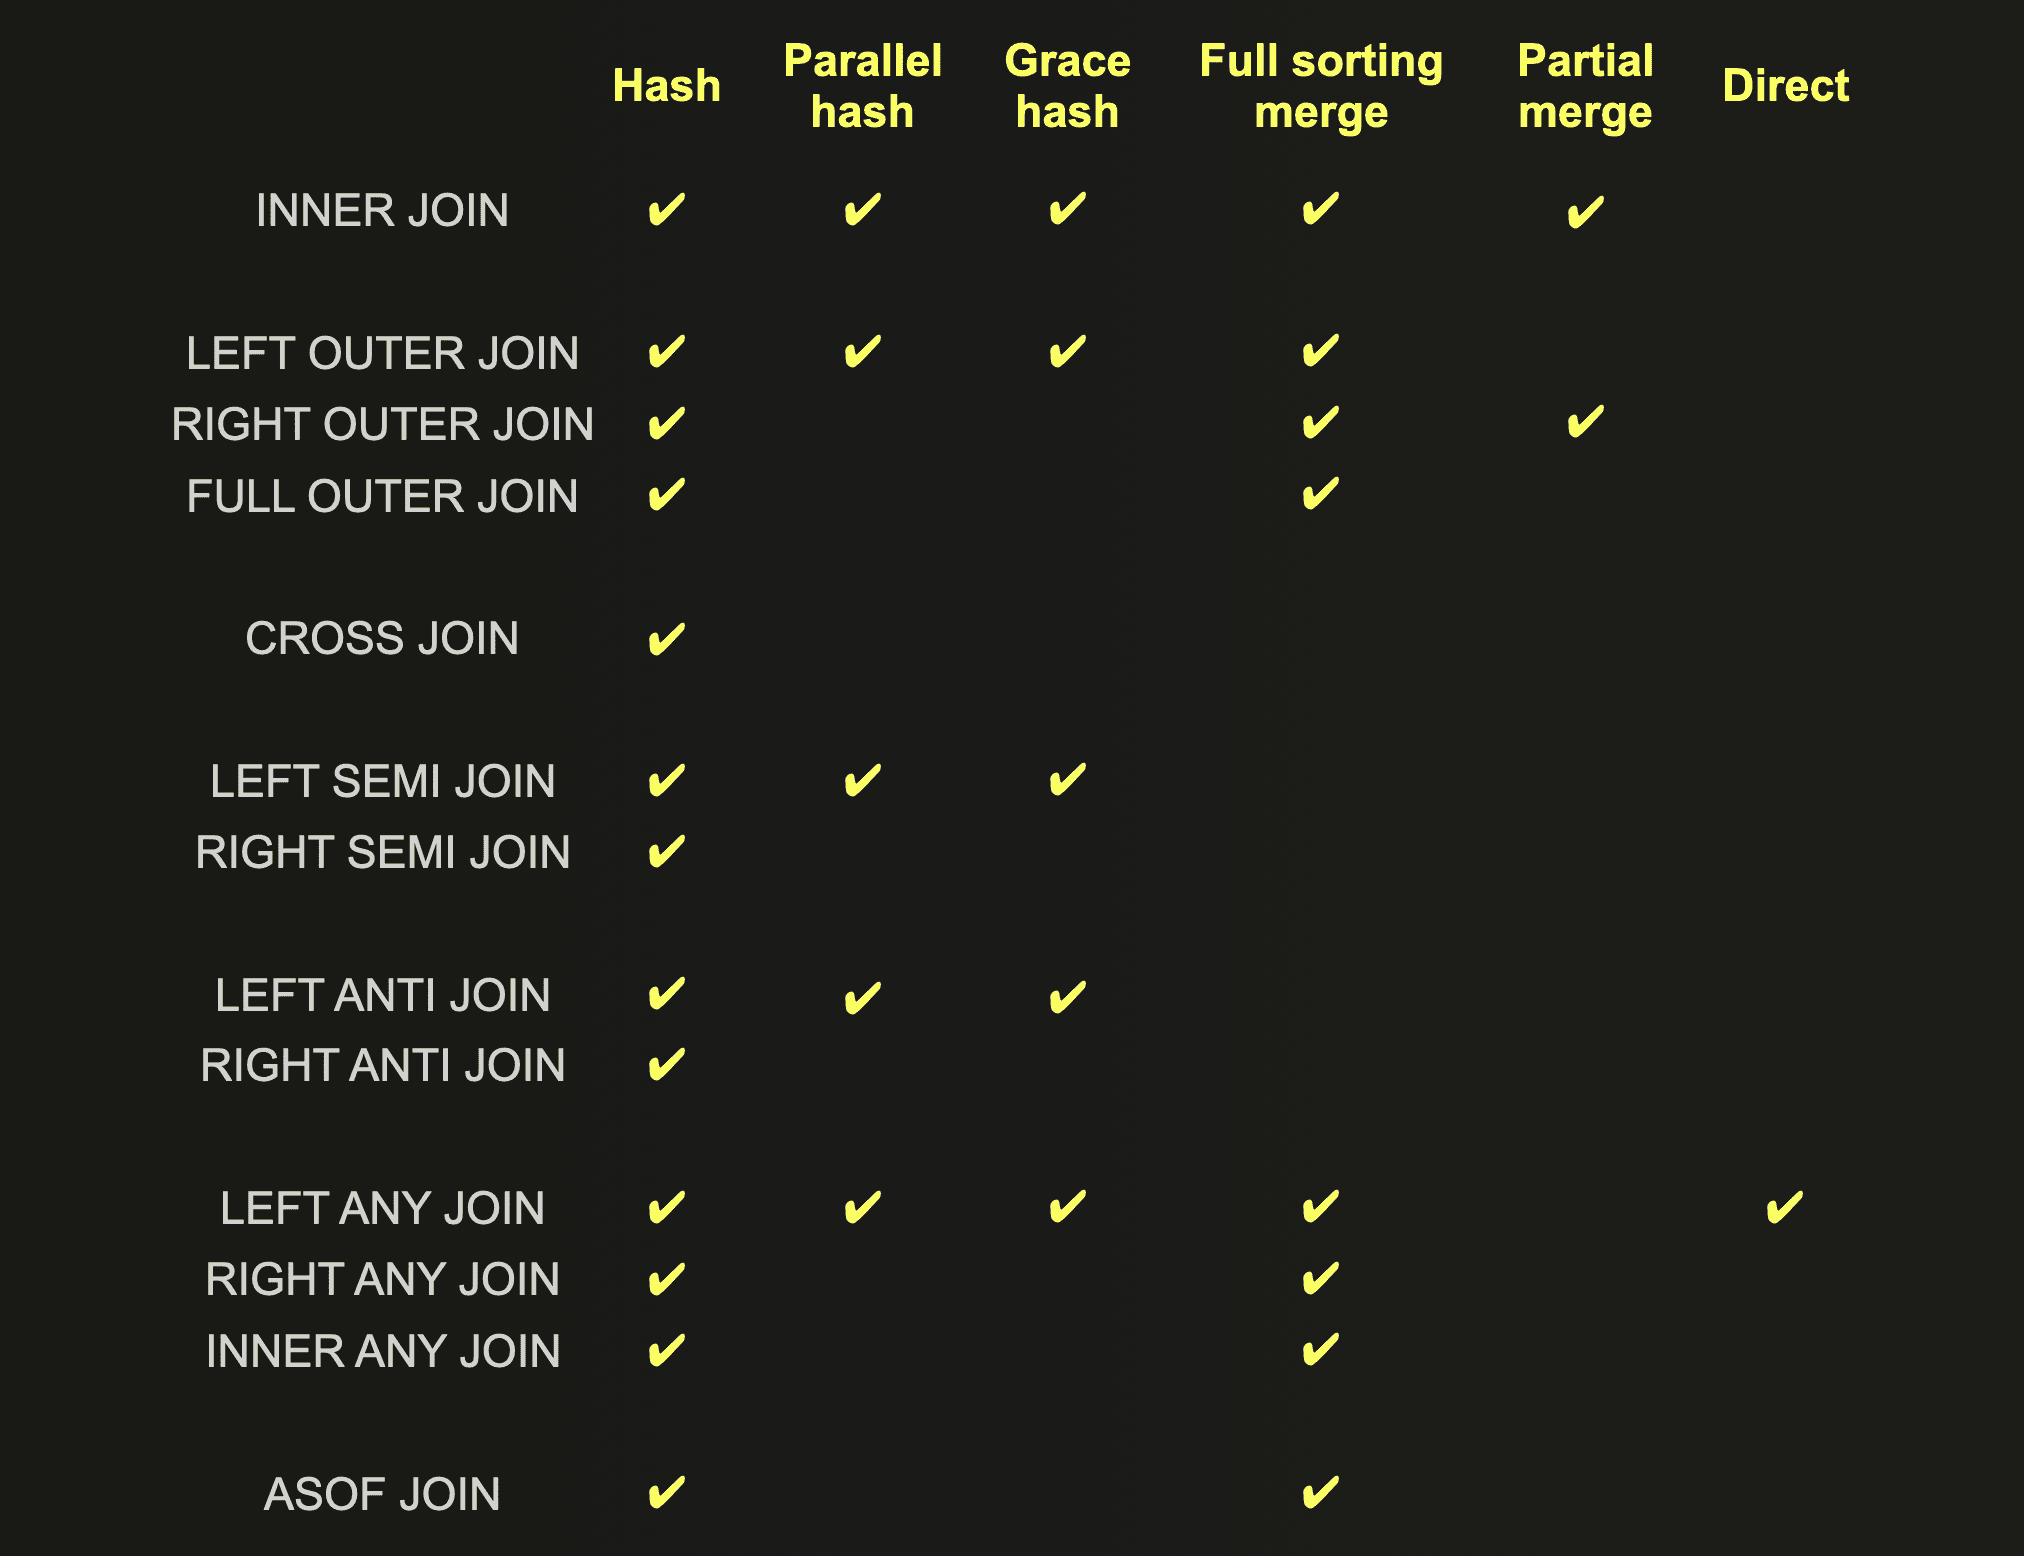
Выбор подходящего алгоритма объединения зависит не только от скорости выполнения и объема потребляемой памяти, но и от того, поддерживается ли данным алгоритмом интересующий Вас тип соединения:
Сравнение
Сейчас предлагаю перейти к сравнению времени выполнения и пикового объема потребления памяти для всех алгоритмов JOIN в ClickHouse.
Тестирование
Для всех запросов join мы будем использовать значение max_threads, установленное по умолчанию. Поскольку узел ClickHouse Cloud, на котором выполняются все наши запросы, имеет 30 ядер процессора (и 120 ГБ оперативной памяти), значение max_threads по умолчанию равняется 30. Версия ClickHouse, которую мы используем в данном случае, - 23.5.1.
JOIN
Мы выполнили один и тот же запрос JOIN по отношению к большей таблицей на правой стороне, воспользовавшись разными алгоритмами объединения:
SELECT *
FROM actors AS a
JOIN roles AS r ON a.id = r.actor_id
FORMAT `Null`
SETTINGS join_algorithm = ...;
Напомним, что в предыдущих постах мы использовали таблицу «Актеры и роли» из базы данных imdb_large. В запросе, представленном ниже, указано количество строк и объем данных, содержащихся в каждой таблице:
SELECT
    table,
    formatReadableQuantity(sum(rows)) AS rows,
    formatReadableSize(sum(data_uncompressed_bytes)) AS data_uncompressed
FROM system.parts
WHERE (database = 'imdb_large') AND active
GROUP BY table
ORDER BY table ASC;

┌─table──┬─rows───────────┬─data_uncompressed─┐
│ actors │ 1.00 million   │ 21.81 MiB         │
│ roles  │ 100.00 million │ 2.63 GiB          │
└────────┴────────────────┴───────────────────┘
Для дальнейшего сравнения алгоритмов JOIN мы сгенерировали еще более масштабную базу данных imdb_xlarge:
SELECT
    table,
    formatReadableQuantity(sum(rows)) AS rows,
    formatReadableSize(sum(data_uncompressed_bytes)) AS data_uncompressed
FROM system.parts
WHERE (database = 'imdb_xlarge') AND active
GROUP BY table
ORDER BY table ASC;

┌─table──┬─rows───────────┬─data_uncompressed─┐
│ actors │ 100.00 million │ 2.13 GiB          │
│ roles  │ 1.00 billion   │ 26.33 GiB         │
└────────┴────────────────┴───────────────────┘
В следующем разделе мы введем графики, сравнивающие выполнение каждого алгоритма объединения по отношению к таблицам из обеих баз данных.
Direct join в каком-то смысле немного особенный
Обратите внимание на то, для алгоритма direct join мы используем отдельные диаграммы, потому что в данном случае целесообразнее всего сравнивать этот алгоритм с аналогичными несортирующими алгоритмами без ограничения памяти, такими как hash или parallel hash. Как уже упоминалось ранее, direct join с таблицей правой можно сравнить с LEFT ANY JOIN:
SELECT *
FROM actors AS a
LEFT ANY JOIN roles AS r ON a.id = r.actor_id
FORMAT `Null`
SETTINGS join_algorithm = ...;
Большие запросы JOIN для таблиц IMDB
На диаграмме, представленной ниже, приведены пиковые значения использования памяти и времени выполнения одного и того же запроса join с использованием таблиц imdb_large:
- большая таблица на правой стороне соединения;
- различные настройки алгоритма JOIN;
- узел с 30 ядрами процессора и max_threads = 30 (по умолчанию).
Обратите внимание на то, что 10 запросов упорядочены по времени выполнения, начиная с самого быстрого запроса:
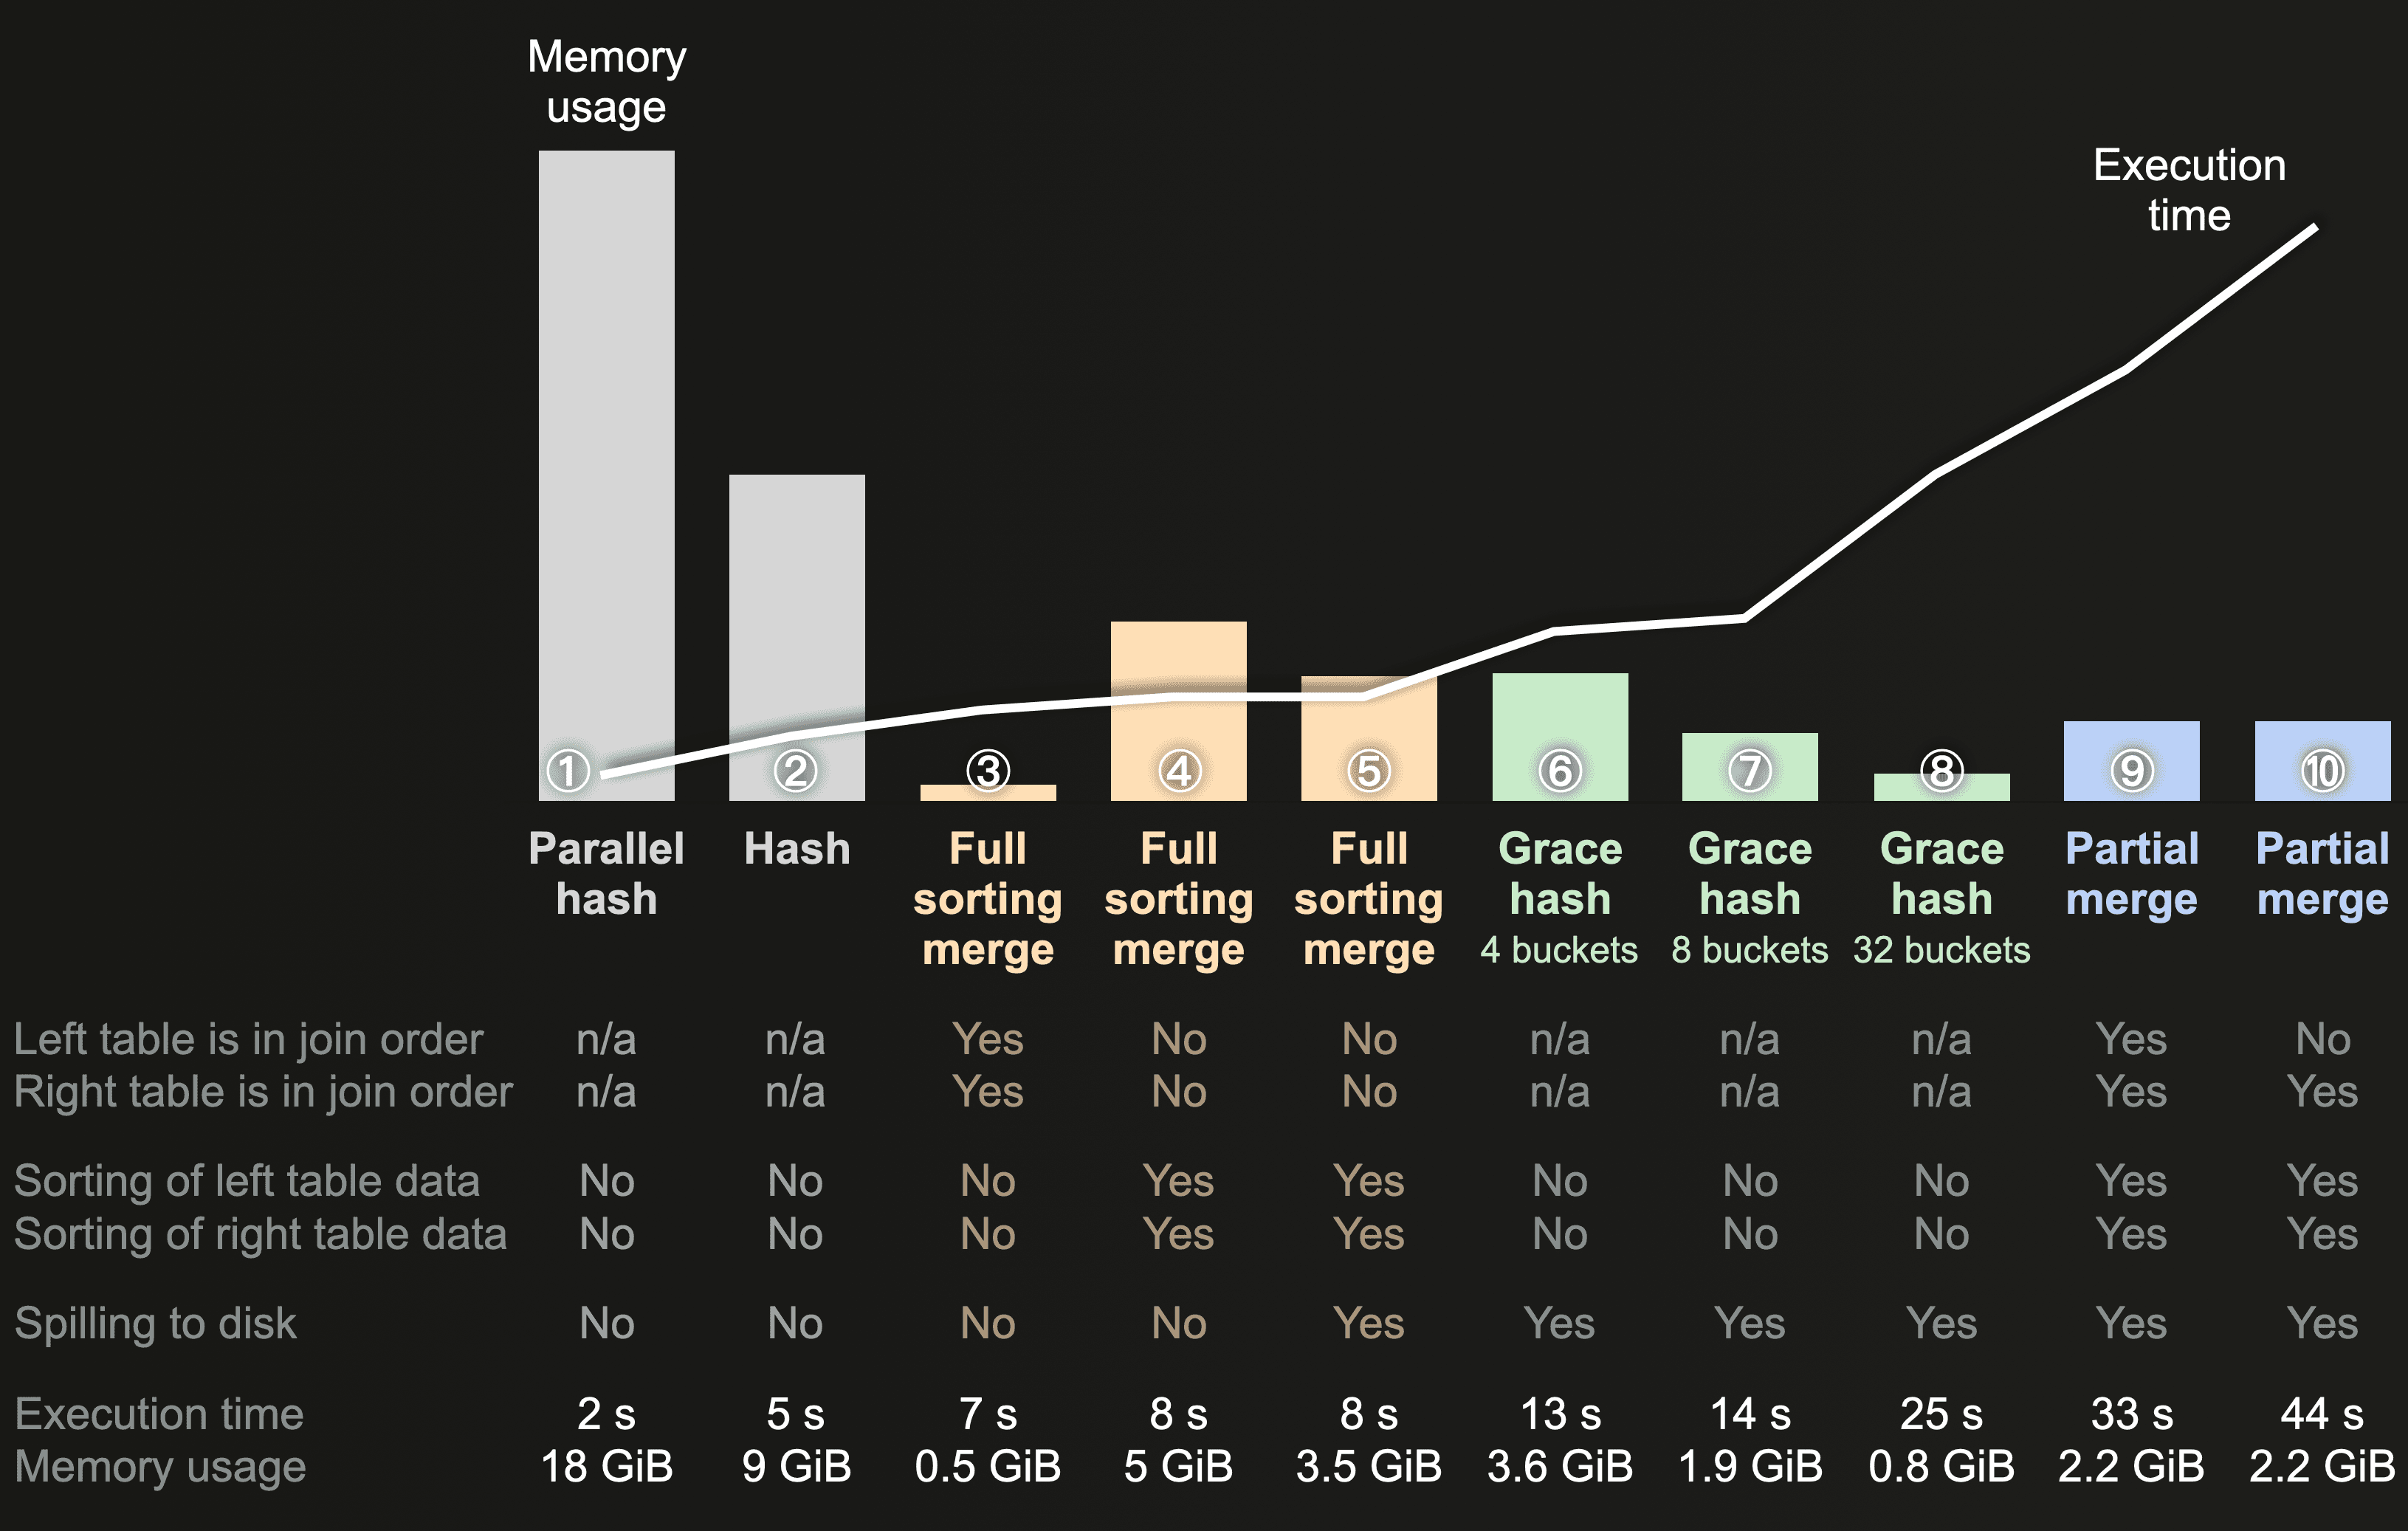
Для наших таблиц, которые мы используем в качестве образцов, самые быстрые алгоритмы JOIN используют наибольший объем памяти. За большим исключением ③full sorting merge. Если ввиду того, что физический порядок строк таблицы на диске в точности соответствует порядку сортировки по ключу соединения, можно пропустить фазу сортировки, то время выполнения full sorting merge можно сравнить с hash join (при этом объем потребляемой памяти будет гораздо меньше). В этом случае в памяти одновременно находится всего несколько блоков данных для JOIN (поскольку данные из обеих таблиц проходят через механизм запросов блочно или по порядку).
При сортировке в памяти обеих объединенных таблиц full sorting merge join занимает гораздо больше памяти. При использовании внешней сортировки (отсортированные данные выгружаются на диск вместо сортировки в памяти) потребление памяти снижается за счет высокой скорости выполнения запроса.
Grace hash - один из трех алгоритмов JOIN, не связанных с памятью, который для того чтобы уменьшить потребление памяти временно выгружает данные на диск. В отличие от двух других алгоритмов - full sorting merge и partial merge - grace hash позволяет контролировать использование памяти на основе заданного количества бакетов. Нас интересовало сравнение скорости объединения, когда grace hash использует примерно такой же и меньший объем памяти, как и два других алгоритма без ограничения памяти. Для этого мы запустили grace hash с тремя разными объемами бакетов. В запуске с 4 бакетами мы выровняли использование памяти за счет использования full sorting merge. В этом случае grace hashоказался медленнее, чем full sorting merge. При выполнении с 8 бакетами мы выровняли использование памяти с partial merge. В этом случае grace hash оказался в два раза быстрее. Дополнительный прогон с 32 бакетами снизил использование памяти до уровня partial merge, но при этом сработал гораздо быстрее.
Для объединения таблиц в нашем случаеоказался самым медленным. Помните, что при partial join происходит полная сортировка правой таблицы. Кроме того, в этом случае на диск временно сохраняются отсортированные блоки вместе с файлами минимальных индексов. Затем он сортирует и сравнивает каждый блок из левой таблицы с отсортированными блоками из правой таблицы на диске, используя при этом min-max индексы для пропуска несовпадающих блоков. В нашем случае это очень эффективно с точки зрения памяти, но с точки зрения скорости это далеко не самый лучший вариант. Особенно при выполнении когда физический порядок строк в левой таблице не совпадает с порядком сортировки по ключу соединения.
В целом мы видим, что явная сортировка таблиц перед определением совпадений соединений требует больших затрат времени, чем простое построение хэш-таблиц из одной из таблиц.
Однако не забывайте о том, что мы проводили сравнительный анализ соединений только для одного конкретного набора данных imdb. В зависимости от объема данных, типов данных и распределения значений столбцов ключа соединения могут возникнуть случаи, когда сортировка блоков данных будет гораздо быстрее, чем построение хэш-таблиц. В качестве примера см. график, приведенный ниже.
Экстрабольшие JOIN для IMDB
На следующей диаграмме представлены результаты выполнения запросов, когда объединенные таблицы взяты из базы данных imdb_xlarge:
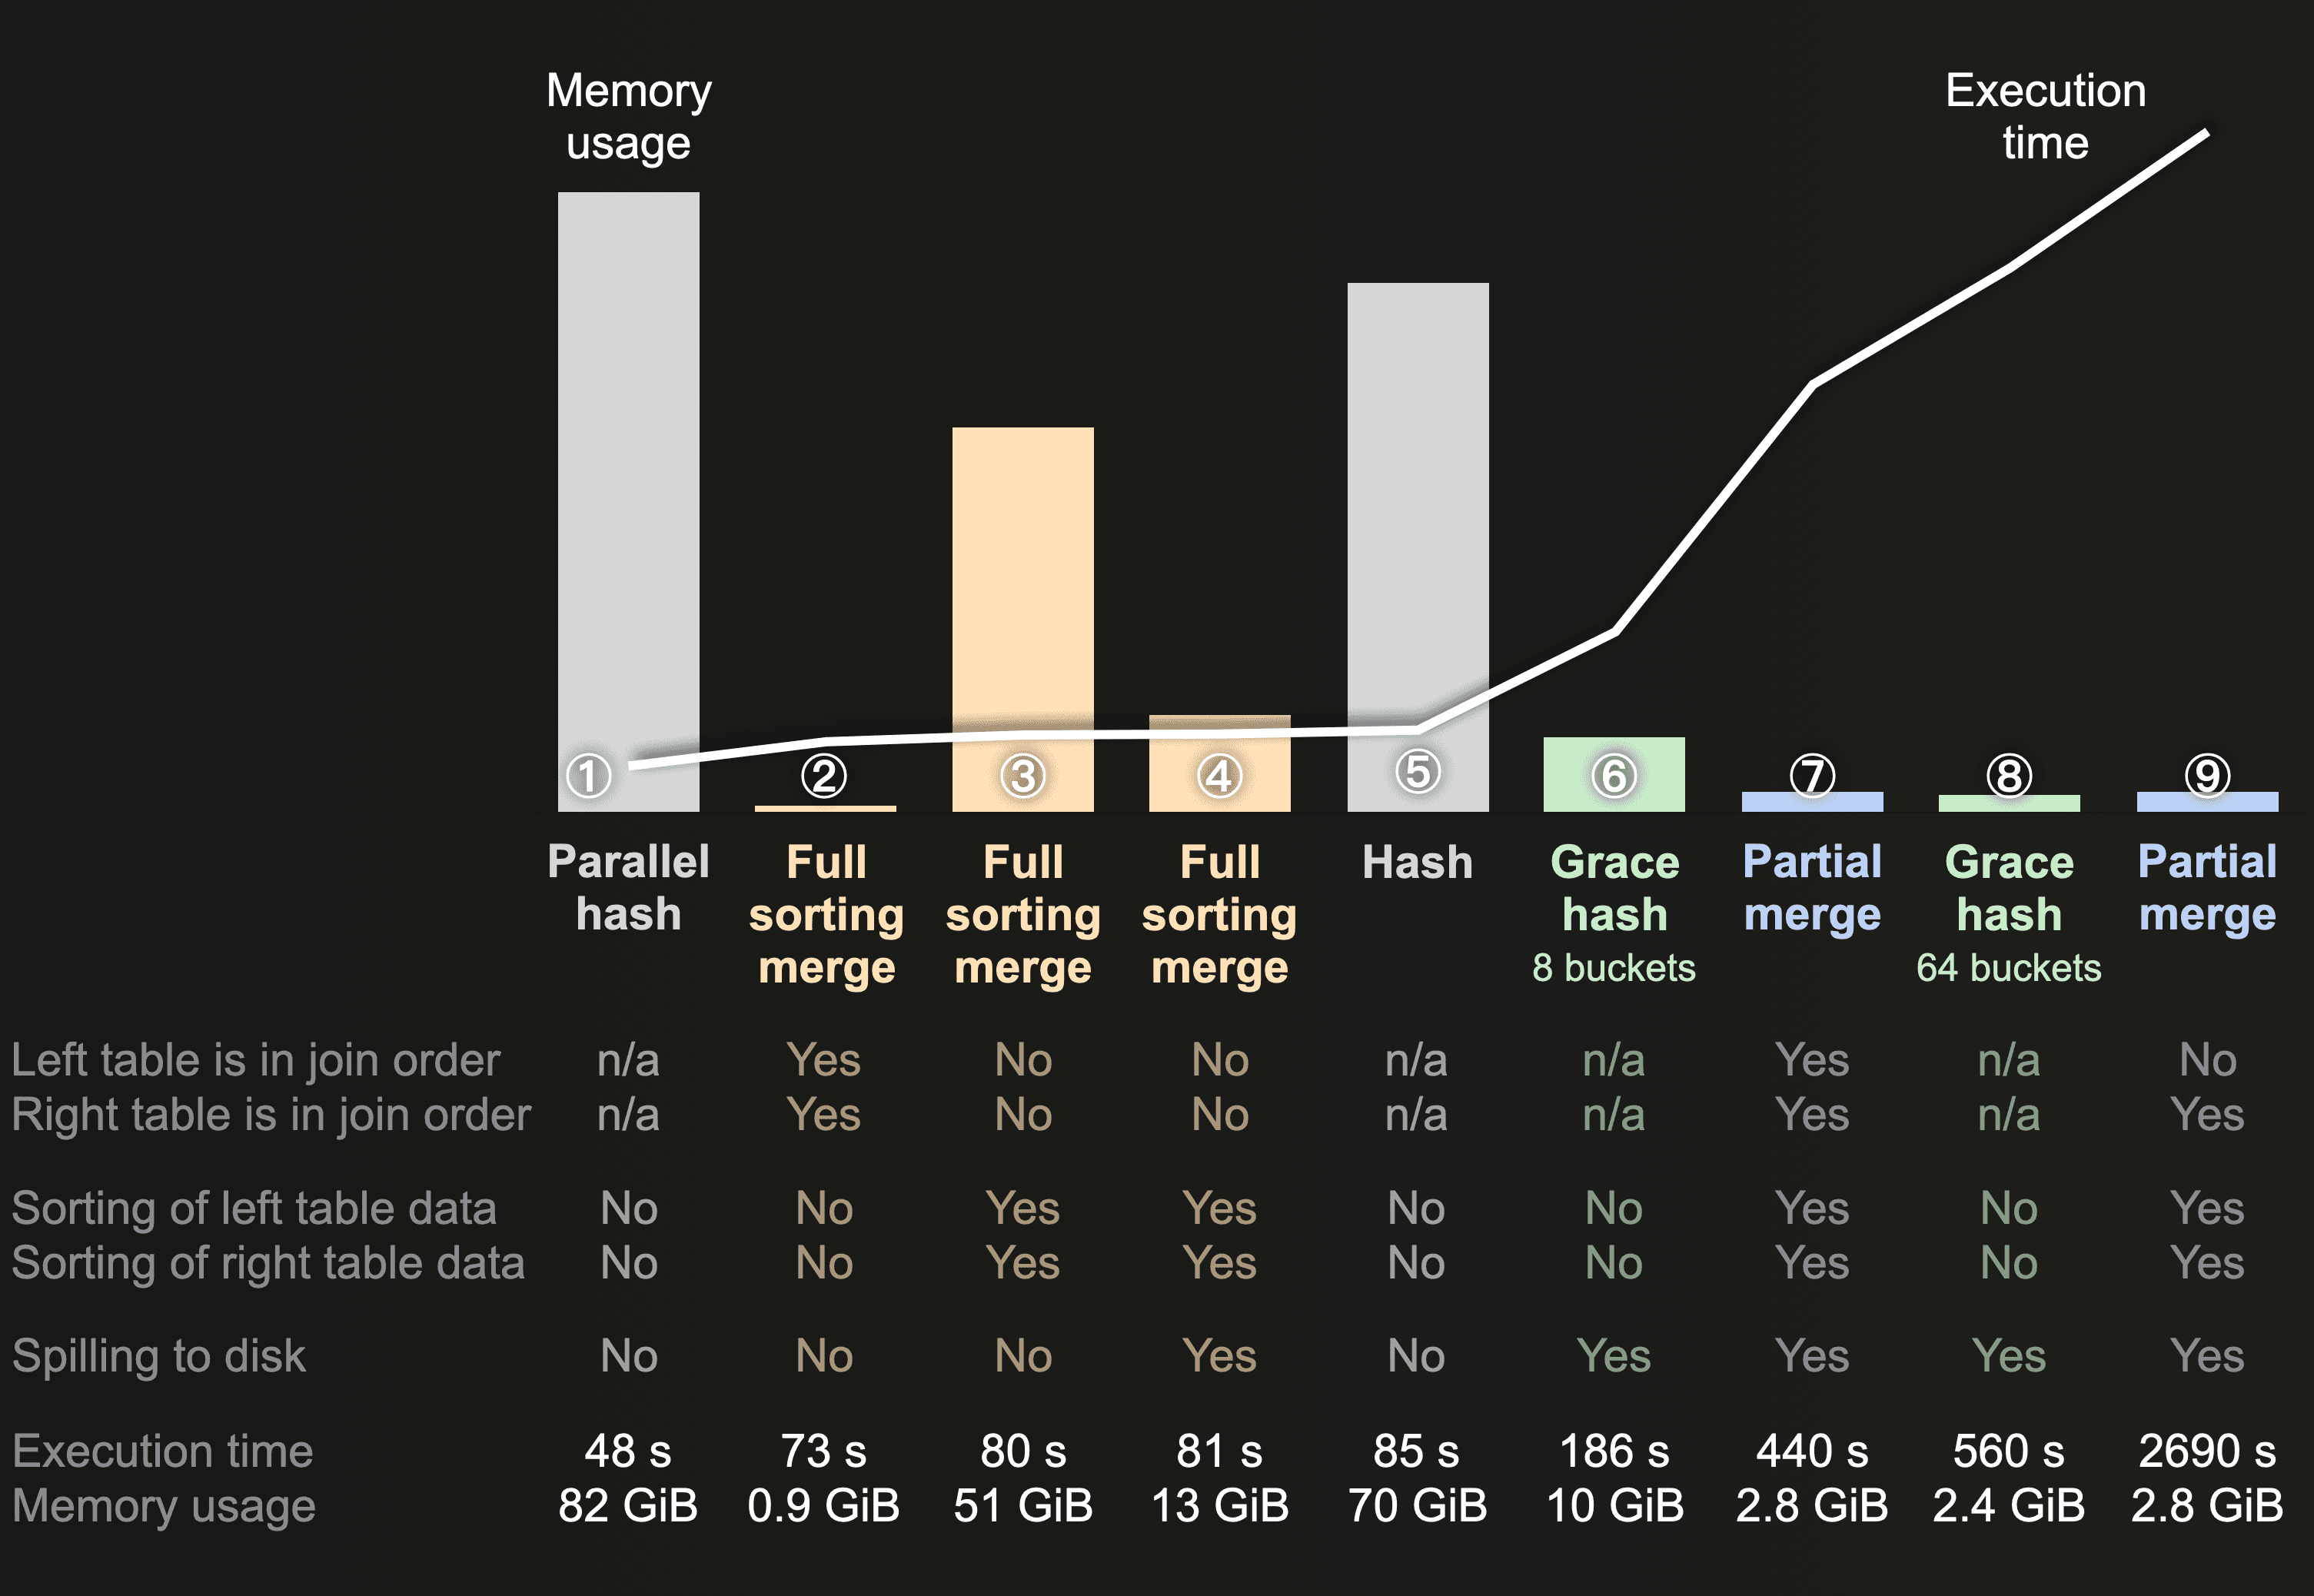
Как и на предыдущей диаграмме, parallel hash join выполняется быстрее всех, но при этом использует и больше всего памяти. В отличие от предыдущей диаграммы, при объединении двух больших таблиц из базы данных imdb_xlarge запуск full sorting merge выполняются быстрее, чем hash join⑤ (при этом используя гораздо меньше основной памяти). Как уже упоминалось ранее, создание хэш-таблицы в памяти из правой таблицы хэш-соединения является однопоточным и может привести к не очень приятным последствиям в том случае, если правая боковая таблица будет слишком велика.
Когда использование памяти при выполнении хэша с 8 бакетами примерно соответствовало использованию памяти при выполнении full sorting merge с внешней сортировкой, то, как и на предыдущем графике, grace hash оказался гораздо медленнее full sorting merge. Поскольку при выполнении с 64 бакетами использование памяти примерно соответствует использованию памяти при partial join, то в этот раз, в отличие от предыдущего графика, partial merge join оказалось гораздо быстрее, чем grace hash join. При наличии правосторонней таблицы с 1 млрд строк и распределение отсортированных блоков и сканирование на основе min-max индекса (partial_merge) происходит гораздо быстрее, чем создание, распределение и сканирование 64 хэш-таблиц (grace_hash с 64 бакетами). Partial merge оказался гораздо эффективнее и за счет того, что левая таблица отсортирована по объединяющему ключу, что позволяет сканировать отсортированные блоки нашей очень большой правой таблицы по min-max индексу.
Однако если физический порядок строк в левой таблице не совпадает с порядком сортировки по ключу join в запуске, то min-max индексы отсортированных блоков из правой таблицы будут не такими уже и эффективными. В худшем случае они даже могут спровоцировать создание кросс-соединения 2 блоков обеих таблиц: для каждого блока левой таблицы из правой таблицы с диска загружается большой набор отсортированных блоков. Очевидно, что это приведет к бОльшим временным затратам, особенно в случае работы с экстрабольшими таблицами.
Direct JOIN
На следующей диаграмме приведены пиковые значения использованной памяти и времени выполнения одного и того же запроса LEFT ANY JOIN для базы данных imdb_large, с:
- большой таблице на правой стороне
- различными настройками алгоритма JOIN
- узлом с 30 ядрами процессора и max_threads = 30 по умолчанию
Все четыре запроса упорядочены по времени выполнения, начиная с самого быстрого (в левой части графика):
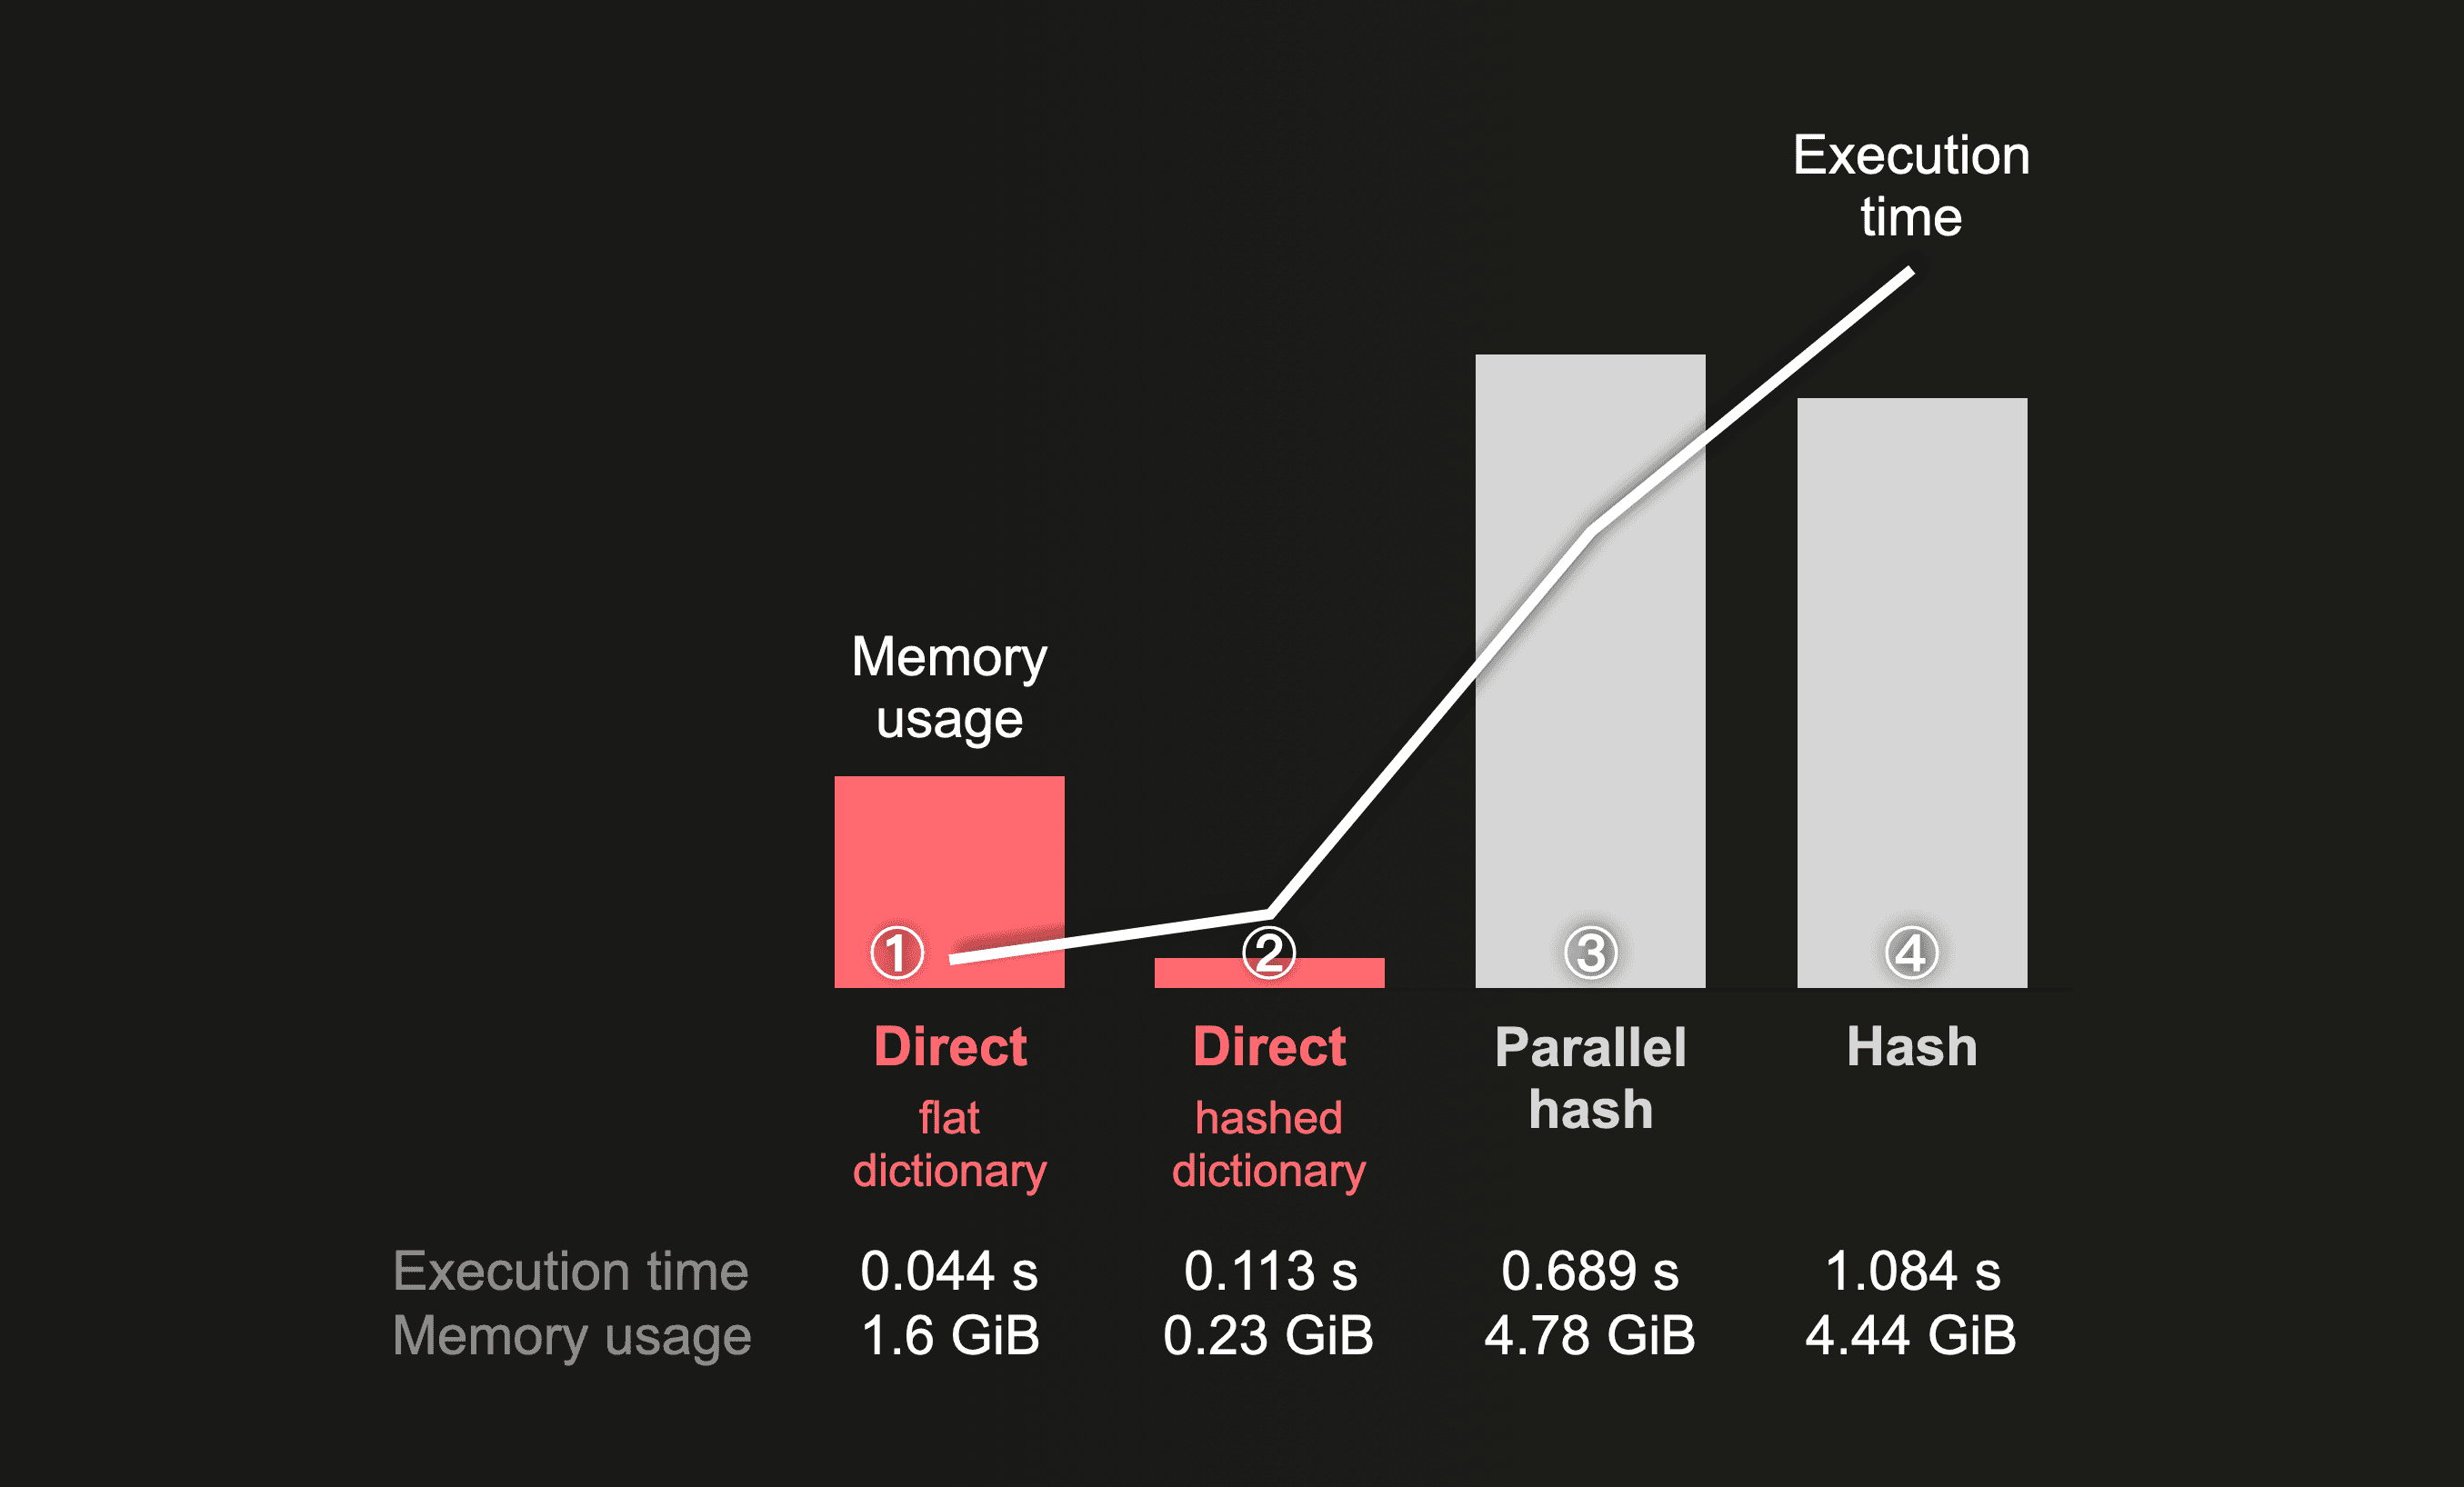
Direct join работает максимально быстро. При использовании таблицы с правой стороны с плоской памятью данный алгоритм ~ в 25 раз быстрее, чем hash join; ~ в 15 раз быстрее, чем parallel hash, и ~ в 2,5 раза быстрее, чем direct join с таблицей с правой стороны с хэшированной памятью. Независимо от типа компоновки, общий объем потребляемой памяти гораздо ниже по сравнению с работой хэш-алгоритма.
Экстрабольшие JOIN для IMDB
На диаграмме, расположенной ниже, представлены результаты сравнения алгоритмов прямого direct join, когда все соединяемые таблицы взяты из одной базы данных imdb_xlarge:
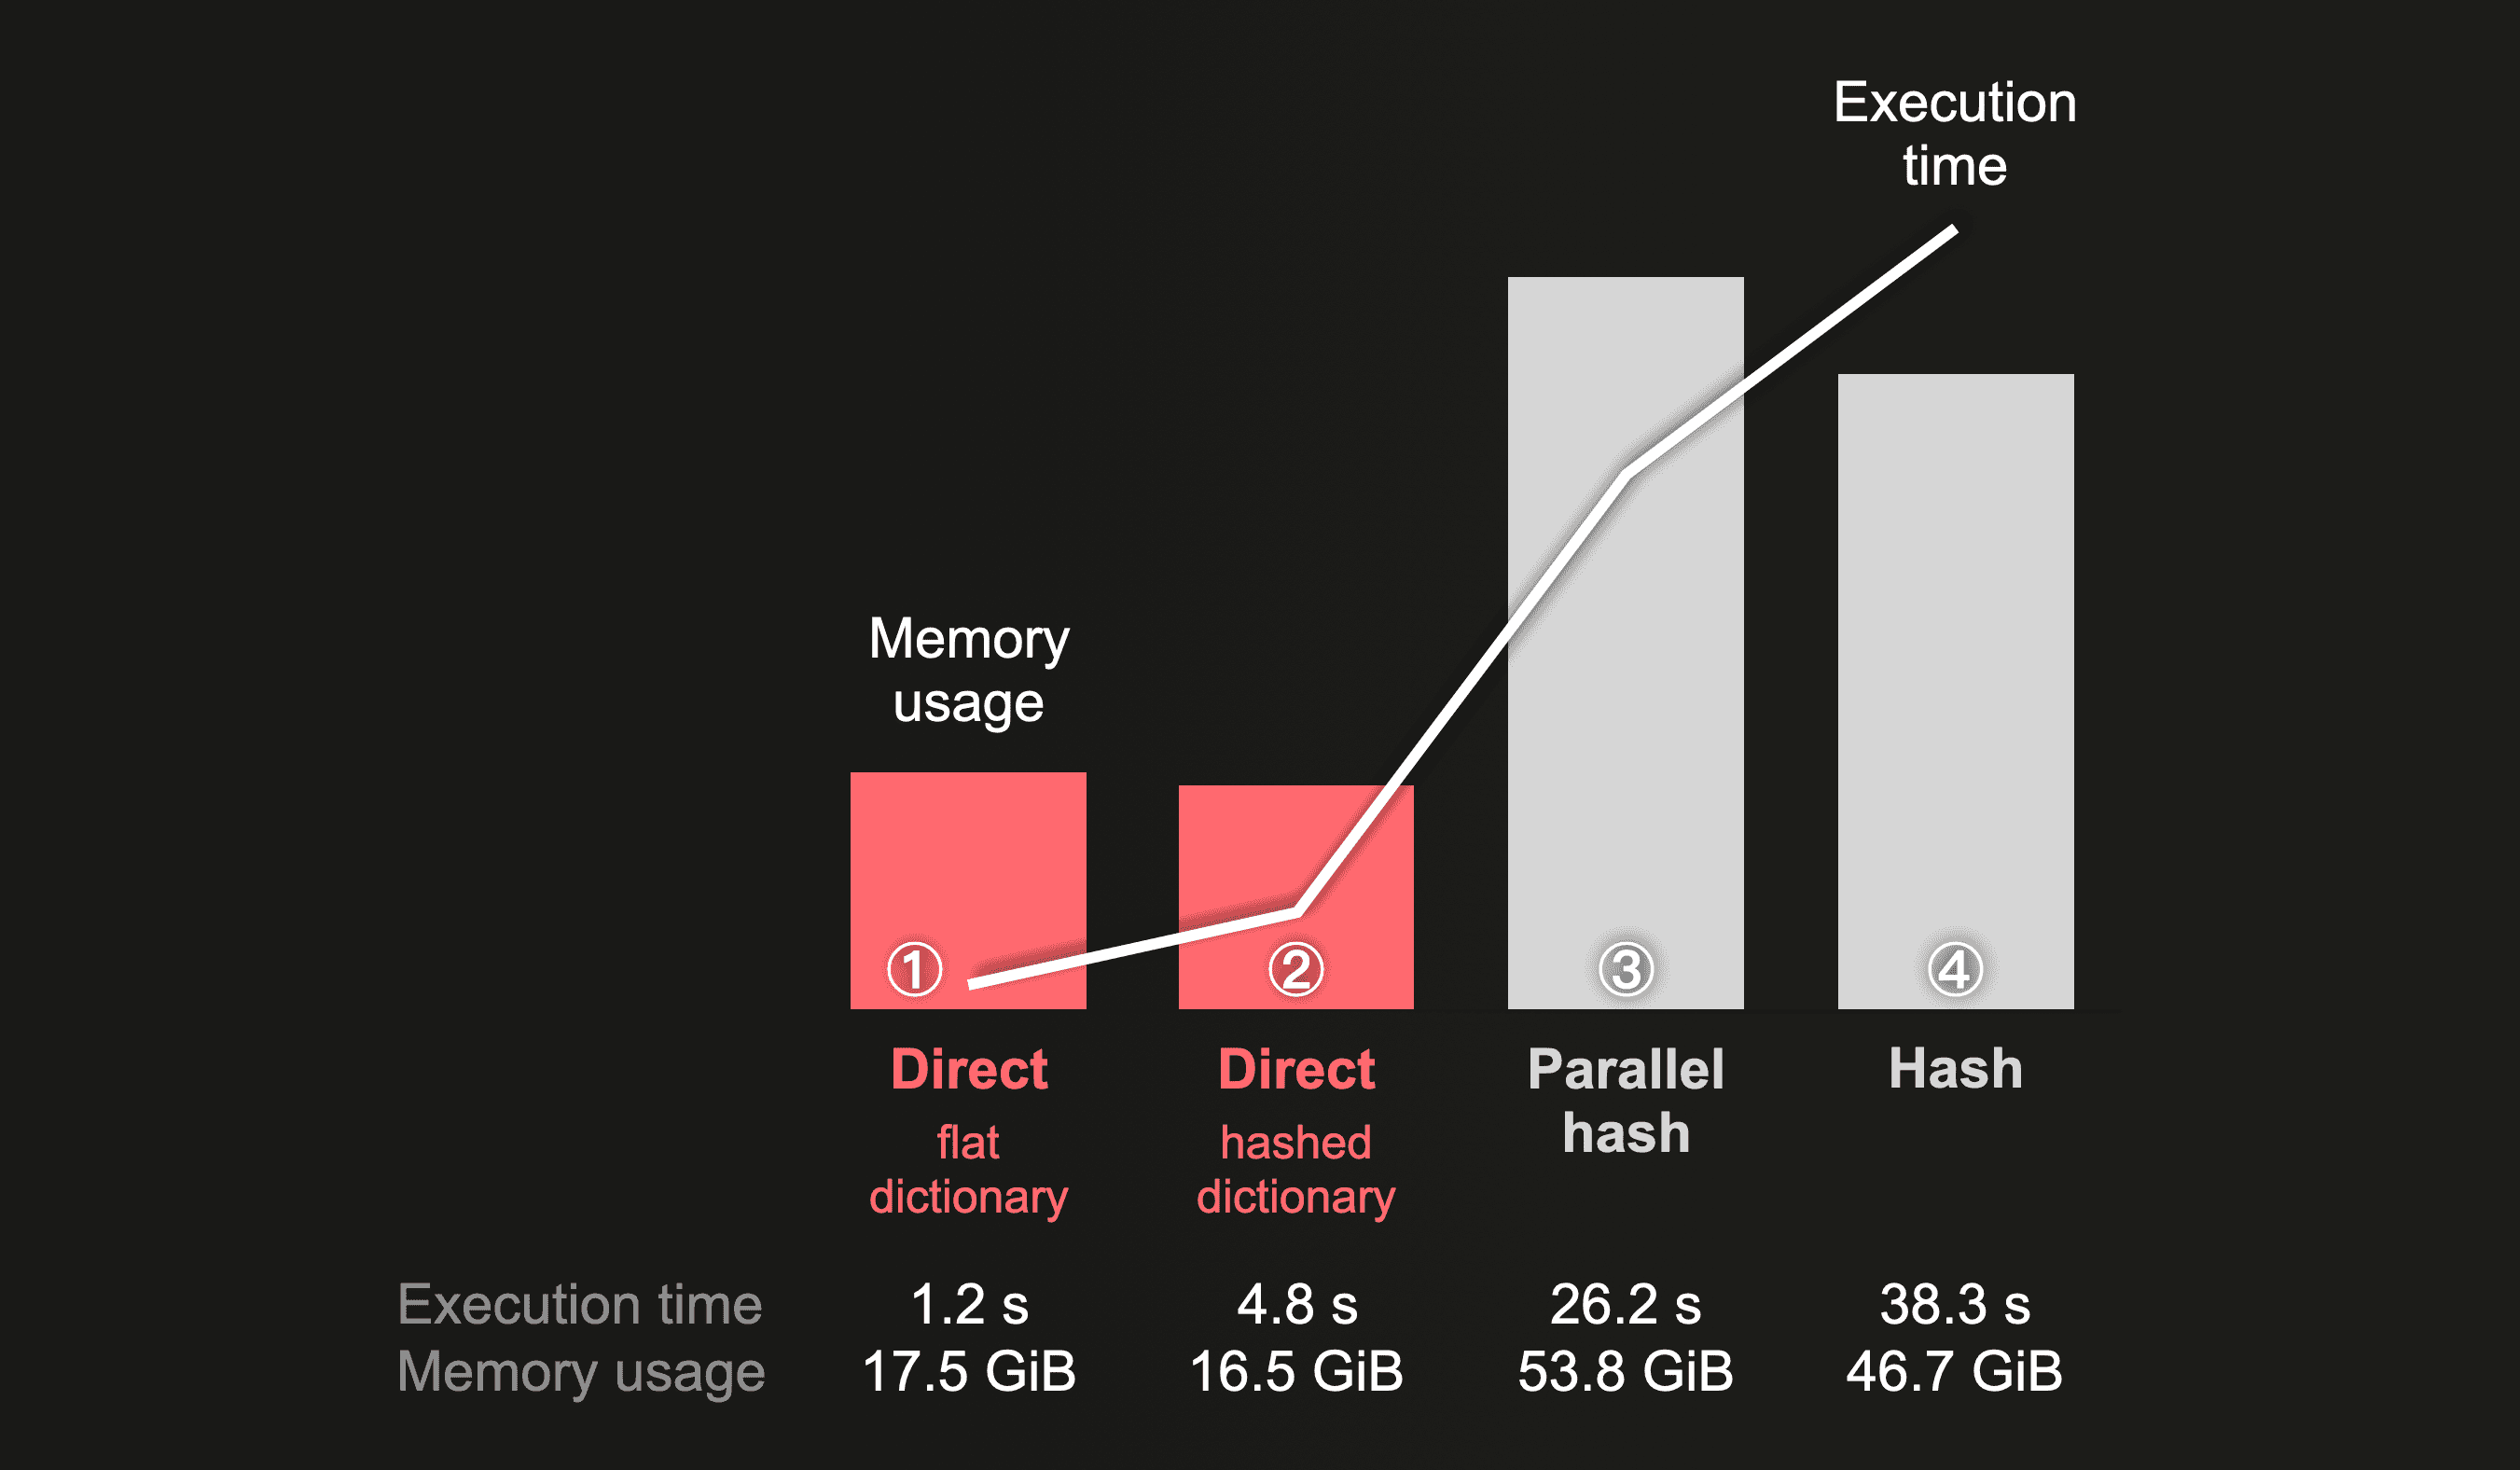
Алгоритм direct join с правой таблицей с плоской памятью объединяет 100 миллионов строк из левой таблицы за 1 с. Это просто вау! Это ~ в 32 раза быстрее, чем алгоритм ; ~ в 22 раза быстрее, чем parallel hash и в 4 раза быстрее, чем direct join с таблицей с хэшированной схемой памяти. Как и на предыдущем графике, объем общего потребления памяти при выполнении direct join гораздо ниже, чем при выполнении хэш-алгоритма.


