

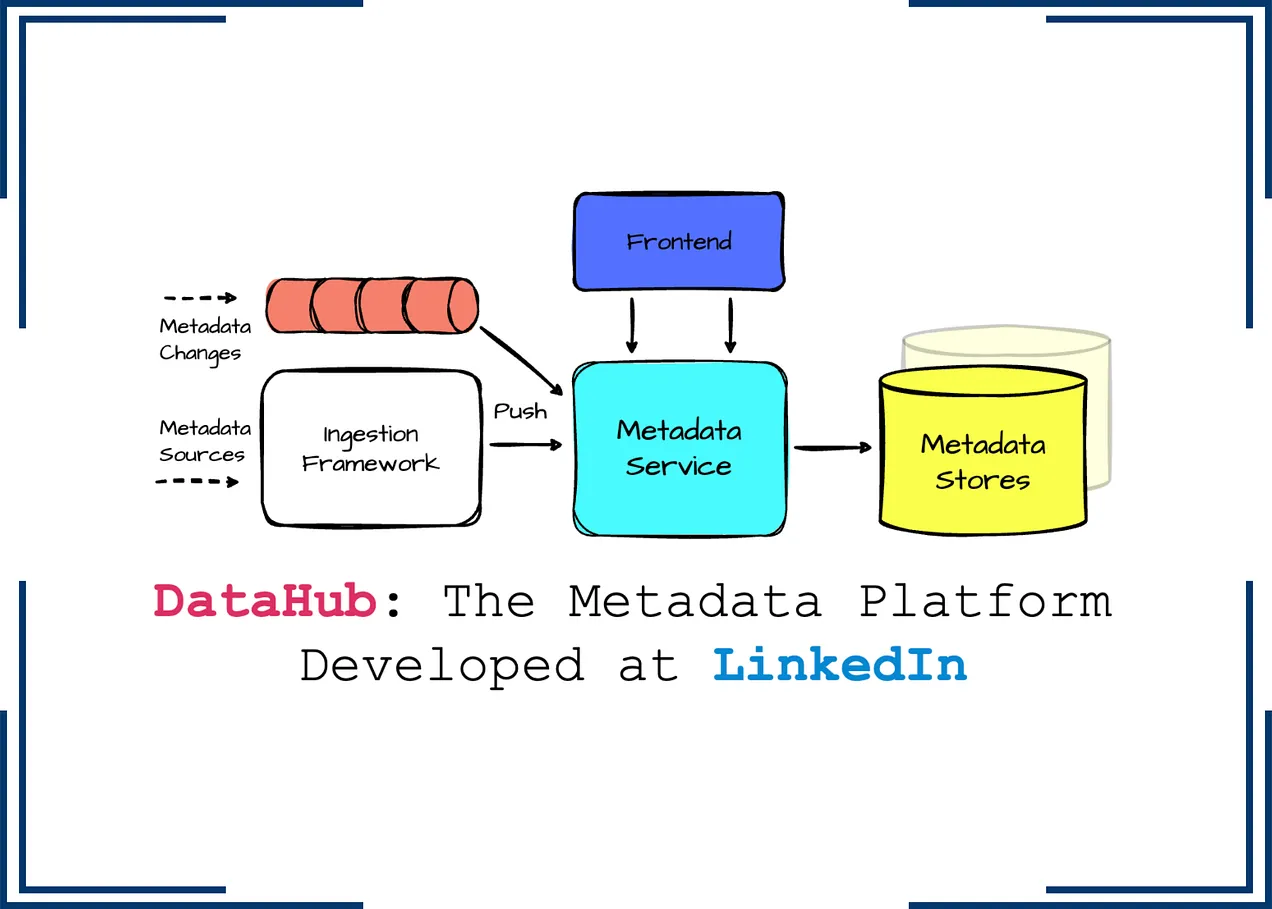
DataHub: платформа метаданных, разработанная в LinkedIn
Как LinkedIn управляет большим каталогом данных?
Что такое каталог данных? Я погуглил и на сайте IBM нашел следующее определение:
«Каталог данных - это подробный перечень всех активов данных организации, призванный помочь специалистам по работе с данными быстро найти наиболее подходящие данные для решения любой аналитической или деловой задачи.”
Если Вы только начали работать в компании и Вам нужно найти набор данных, Вы начинаете спрашивать о нем у коллег … и сразу же понимаете, зачем вообще нам всем нужен каталог данных ;)
Из этой статьи Вы узнаете, как LinkedIn создала решение для каталога данных -DataHub, а позже, в 2019 году, выложила его в открытый доступ.
Сначала мы рассмотрим итерации каталога данных LinkedIn, как они улучшали и развивали свой каталог на протяжении трех поколений, что в итоге привело к созданию Datahub. Затем мы изучим архитектуру и основные компоненты DataHub.
Первое поколение
Сначала каталог данных LinkedIn был разработан как классический монолитный фронтенд (например, приложение на Flask) с подключением к базе данных для поиска (например, MySQL/Postgres) и поисковым индексом для обслуживания поисковых запросов (например, Elasticsearch). Позже в архитектуру был добавлен графовый индекс для обработки графовых запросов (например, Neo4j).
В 2016 году LinkedIn выпустила первую версию Datahub под названием WhereHows, которая использовала эту же самую архитектуру.
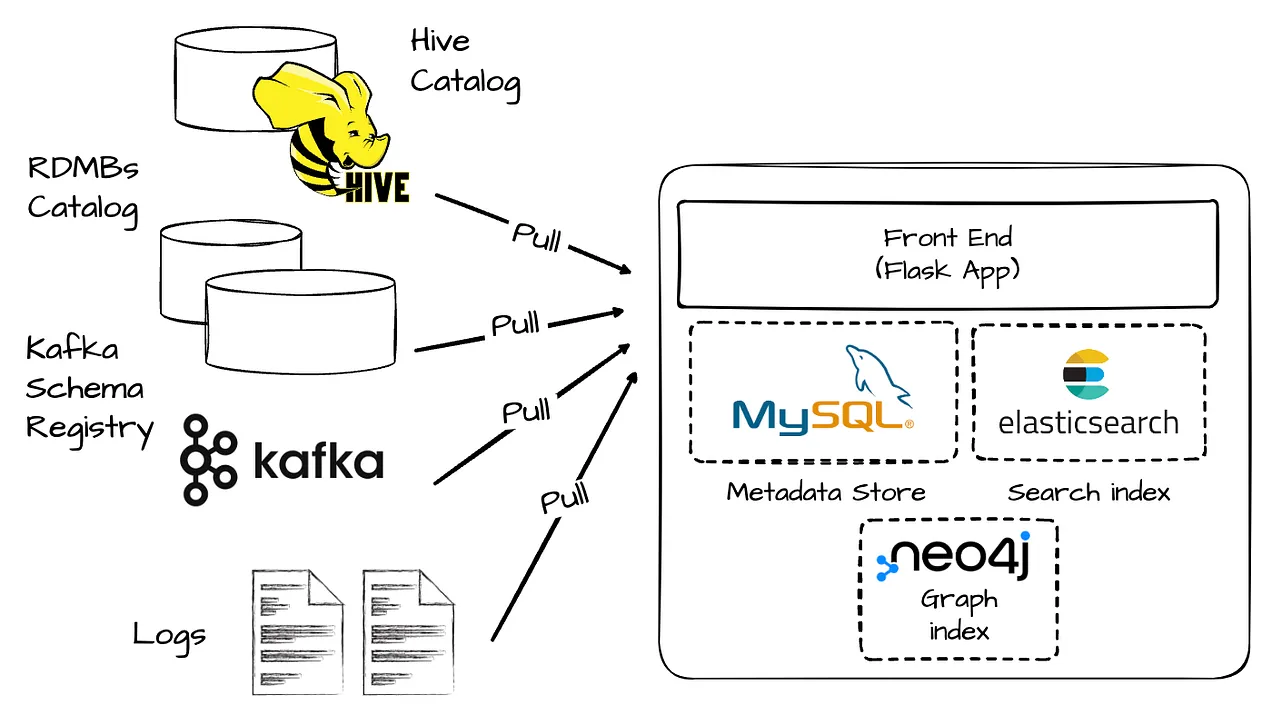
Система получала и просматривала метаданные из источников, подключалась к каталогу базы данных, каталогу Hive или реестру схем Kafka и записывала метаданные в базу данных. Затем данные индексировались с помощью поискового и графового индекса.
Этот процесс выполнялся как отдельный процесс, запускаемый по расписанию (например, раз в день). Необработанные метаданные часто преобразовывались в нужную модель метаданных. Эти преобразования встраивались непосредственно в задание ввода. Если для масштабной обработки метаданных требовалась большая вычислительная мощность, LinkedIn определяла задания Spark.
За:
- Небольшое количество компонентов
- Помощь команды, которая может получить доступ к источникам метаданных и быстро создать нужное приложение.
Против:
- Подход, основанный на извлечении, означает, что метаданные не всегда свежие; их приходится ждать для того, чтобы извлечь через установленные промежутки времени.
- Поскольку краулер работает в среде, отличной от источника данных, управление конфигурациями возлагается на центральную команду, что может привести к таким проблемам, как сетевые проблемы и трудности управления учетными данными.
- Ввод данных на основе краулинга часто приводит к пакетной и неинкрементной рабочей нагрузке. Как часто система запрашивает источник? Сколько записей нужно извлекать каждый раз? Эти решения влияют на стабильность и производительность работы источника данных.

Второе поколение
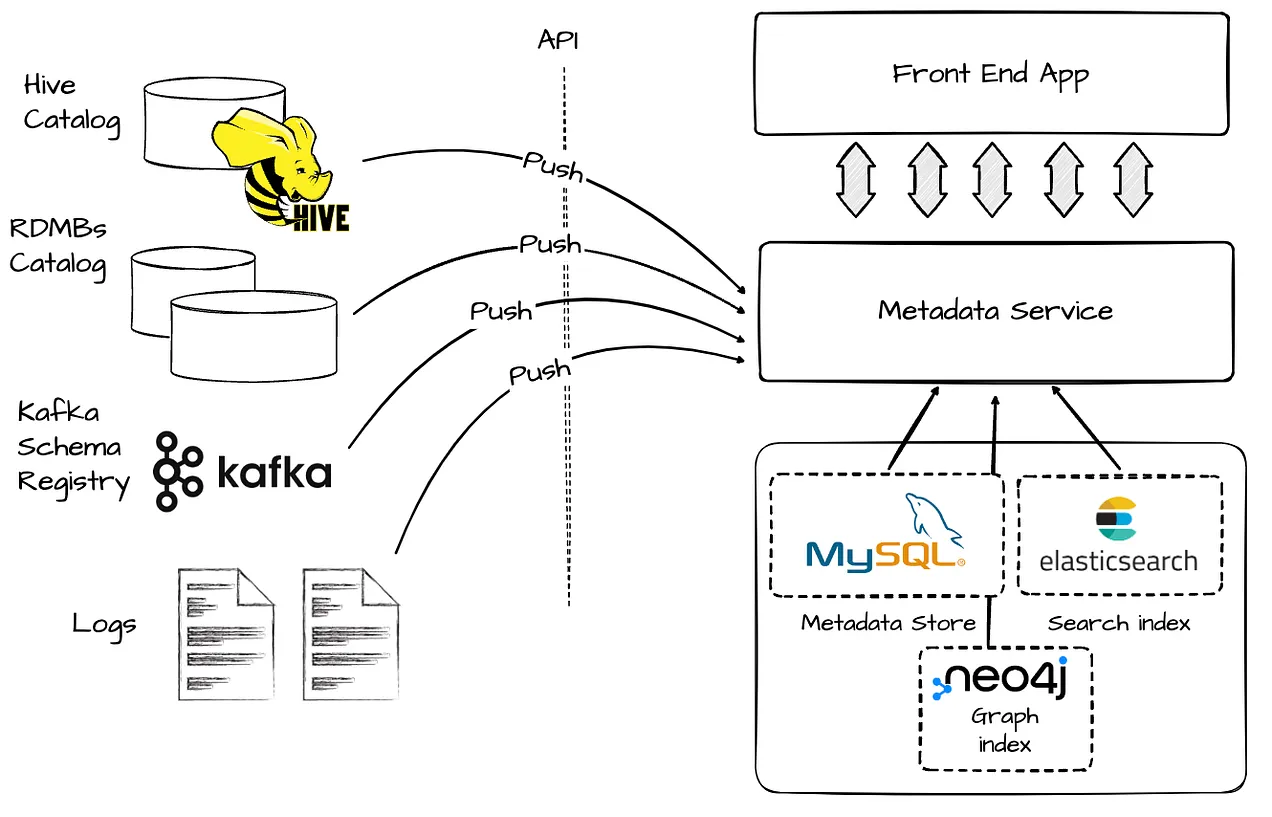
Монолитное приложение первого поколения было разделено на службу метаданных, стоящую перед базой данных хранилища. Сервис предоставлял API, который позволял источнику передавать метаданные в систему, а другие программы, которым нужно было потреблять метаданные, также могли использовать этот API. Все метаданные по-прежнему хранились в едином хранилище метаданных; это могла быть реляционная база данных или хранилище ключевых значений.
За:
- Реализация push-интерфейса, определяемого схемой, устанавливает четкие контракты между производителями метаданных и центральной командой метаданных.
- С помощью сервисного API центральная команда может обеспечить программные сценарии использования метаданных.
Против:
- Отсутствие встроенной поддержки приема изменений метаданных из внешних систем затрудняет надежное воссоздание поискового и графового индекса при возникновении проблем.
- Каталог не позволяет подписываться на изменения метаданных. Это затрудняет создание реактивных систем, таких как триггеры данных или обнаружение нарушений контроля доступа, на основе каталога данных. Другие приложения вынуждены получать доступ к метаданным с помощью опроса или полного сканирования, либо им приходится ждать запланированного ETL базы метаданных для обработки снимка.
- По-прежнему слишком много аспектов зависит от централизованной команды: управление моделью метаданных, эксплуатация службы метаданных и поддержка хранилища метаданных.
Третье поколение
Основываясь на уроках двух предыдущих поколений, критическое понимание, ведущее к появлению третьего поколения, заключается в том, что централизованное решение для метаданных не успевает за требованиями предприятия. Чтобы решить эту проблему, необходимо удовлетворить две потребности.
Во-первых, метаданные должны свободно распространятся, они должны быть основаны на событиях. В третьем поколении производитель метаданных может передавать их в API на основе потоков или выполнять CRUD-операции с API службы каталога. Мутации метаданных будут генерировать журнал изменений метаданных. Этот журнал метаданных может быть материализован в различных хранилищах (например, в поисковом индексе, озере данных или OLAP-системе). Теперь, когда журнал становится источником истины для метаданных, в случае несоответствия пользователь может воссоздать граф-индекс или поисковый индекс по своему усмотрению.
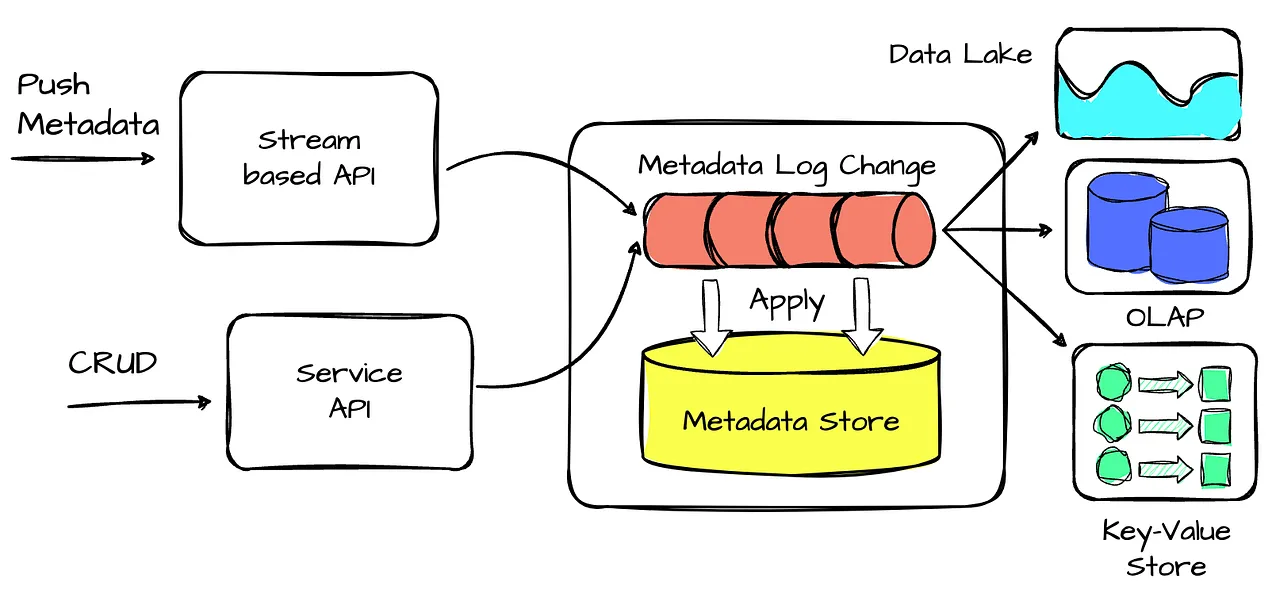
- Второе - модель метаданных должна поддерживать эволюцию, не блокируемую центральной командой. Третье поколение обеспечивает расширяемые, сильно типизированные модели метаданных и отношения. Такое моделирование позволяет командам развивать глобальную модель метаданных, добавляя специфические для конкретной области расширения, не испытывая при этом затруднений со стороны центральной команды.
За:
- Интеграция: клиенты могут гибко взаимодействовать с базой метаданных в зависимости от своих потребностей. Они могут подключаться к потоковому журналу метаданных для получения и отслеживания изменений, выполнять поиск метаданных с низкой задержкой, проводить полнотекстовый поиск по атрибутам метаданных или выполнять графовые запросы по взаимосвязям метаданных. Также поддерживается полное сканирование и аналитические возможности, что позволяет использовать их в различных случаях.
- Надежность: С введением журнала изменений метаданных метаданные теперь эффективно и надежно передаются, а не берутся из источника. Внутренние пользователи LinkedIn теперь всегда читают и принимают меры в отношении самых свежих метаданных без потери согласованности. При переходе от Gen 2 (WhereHows) к Gen 3 (Datahub) они обнаружили, что доверие к каталогу данных значительно возросло, и система стала центром предприятия.
Против:
- По сравнению с 2 предыдущими поколениями эта система более сложная.
Архитектура DataHub
Изучив контекст, лежащий в основе DataHub, давайте рассмотрим его архитектуру.
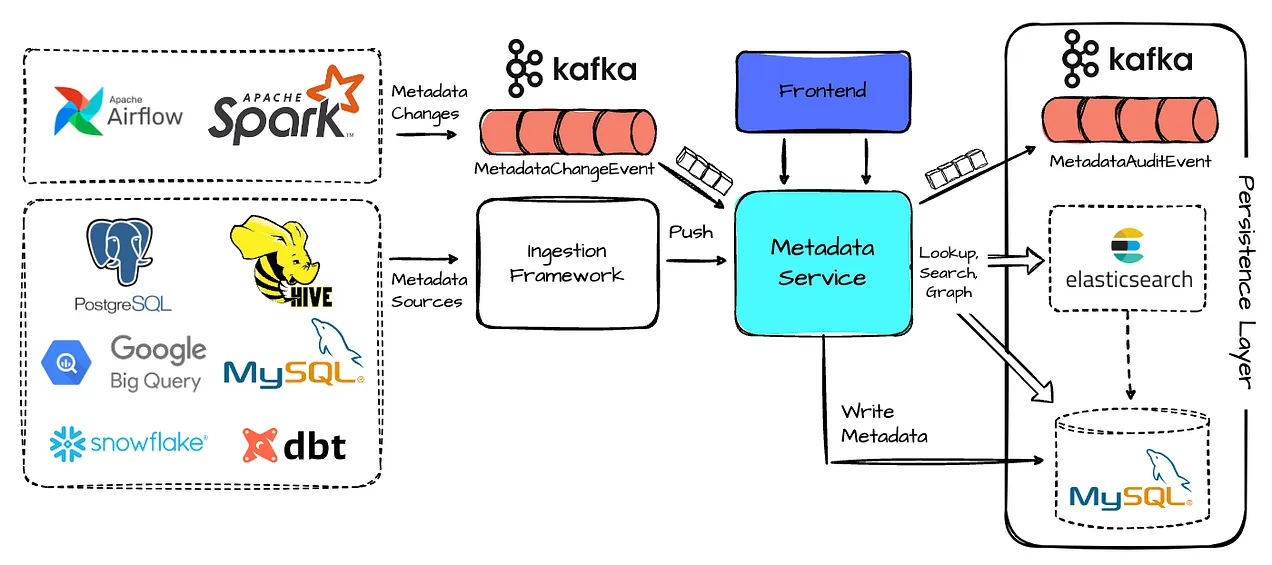
Из официальной документации можно выделить три основные особенности архитектуры DataHub:
- Schema-first подход к моделированию метаданных: Модель метаданных описывается с помощью языка, не зависящего от сериализации. Он поддерживает как REST, так и GraphQL API. Кроме того, DataHub поддерживает API на основе AVRO через Kafka для передачи изменений метаданных и подписки на них.
- Потоковая платформа управления метаданными в режиме реального времени: Инфраструктура DataHub позволяет отражать изменения метаданных в платформе в течение нескольких секунд. Пользователи также могут подписаться на изменения в метаданных DataHub, что позволяет им создавать системы, управляемые метаданными в режиме реального времени.
- Федеративное обслуживание метаданных: DataHub имеет единый сервис метаданных. Однако он поддерживает объединенные службы метаданных, управляемые разными командами. Объединенные сервисы взаимодействуют с центральным поисковым индексом и графом с помощью Kafka для поддержки глобального поиска и обнаружения, обеспечивая при этом раздельное владение метаданными. Такая архитектура очень подходит для компаний, внедряющих сетку данных.
Компоненты
Модели метаданных
Метаданные DataHub моделируются с помощью следующих абстракций:
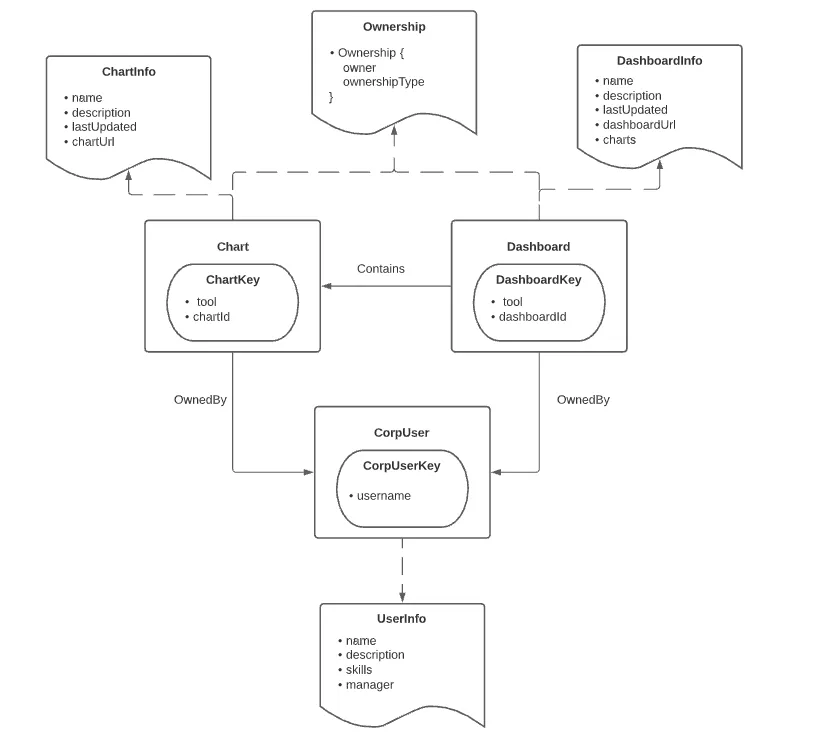
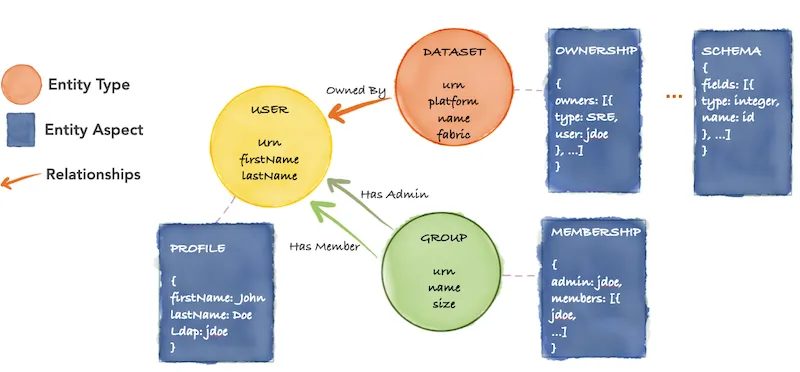
- Сущности представляют определенный класс активов метаданных, таких как набор данных или конвейер данных. Каждый экземпляр сущности идентифицируется уникальным идентификатором, называемым урной. Сущности являются первичными узлами в графе метаданных.
- Аспект определяет набор атрибутов, принадлежащих экземпляру сущности. В DataHub аспекты являются атомарными единицами записи; несколько аспектов экземпляра могут обновляться независимо друг от друга. Кроме того, аспекты могут быть общими для всех экземпляров сущности. Можно перечислить примеры аспектов, например, владельцы экземпляра или тег экземпляра.
- Отношения определяют именованную границу между двумя сущностями.
- Идентификаторы (ключи и урлы): Ключ - это специальный аспект, содержащий поля, которые однозначно идентифицируют экземпляр. Ключ может быть сериализован в урны, представляющие собой строковую форму полей, используемых для поиска по первичному ключу.
Metadata Store
Хранилище отвечает за хранение сущностей и аспектов DataHub, составляющих граф метаданных. Эти хранилища также предоставляют API для получения метаданных, извлечения метаданных по первичному ключу, поиска сущностей или извлечения отношений между сущностями. Хранилище состоит из:
- Spring Java Service, размещающего набор компонентов API.
- MySQL, Elasticsearch и Kafka используются для хранения данных и их индексирования.
Фреймворк для сбора информации
Этот компонент представляет собой модульную расширяемую библиотеку на языке Python для извлечения метаданных из исходных систем, таких как Snowflake, BigQuery или Kafka. Метаданные преобразуются в модель метаданных DataHub и записываются в DataHub либо через Kafka, либо напрямую, используя интерфейсы Metadata Store.
GraphQL API
GraphQL API предоставляет сильно типизированный, ориентированный на сущности API, который упрощает взаимодействие с сущностями. Он включает в себя API для добавления и удаления тегов, владельцев, ссылок и т. д.
UI
У DataHub - пользовательский интерфейс React, включающий функции для обнаружения, управления и отладки сущностей.
-
Arenadata Catalog — это централизованное решение для управления метаданными, которое обеспечивает единое хранилище описаний данных, их lineage (происхождение), бизнес-глоссариев и технических атрибутов, позволяя организациям выстраивать эффективную Data Governance-стратегию. Благодаря удобному веб-интерфейсу и развитой роли модели доступа, пользователи могут находить, анализировать и контролировать использование данных, повышая прозрачность и доверие к информации в компании.


