

Осваиваем дата-инжиниринг: 7 реальных проектов
Научитесь создавать, запускать и управлять конвейерами инженерии данных как локально, так и в облаке с помощью самых популярных инструментов.
Инженерия данных – важнейшая и интереснейшая область, которая занимается созданием и обслуживанием систем для сбора, хранения и анализа данных. Высоко ценится в ИТ-индустрии. Инженеры по обработке данных сотрудничают с различными отделами для удовлетворения конкретных потребностей в данных, используя новейшие инструменты и платформы для создания конвейеров данных для таких задач, как извлечение, преобразование, загрузка данных (ETL).
В этой статье мы рассмотрим семь проектов по разработке данных, которые дадут Вам представление о возможностях управления данными в режиме реального времени. Вы будете работать с такими технологиями, как Python, SQL, Kafka, Spark Streaming, dbt, Docker, Airflow, Terraform, а также облачными сервисами.
1. ZoomCamp
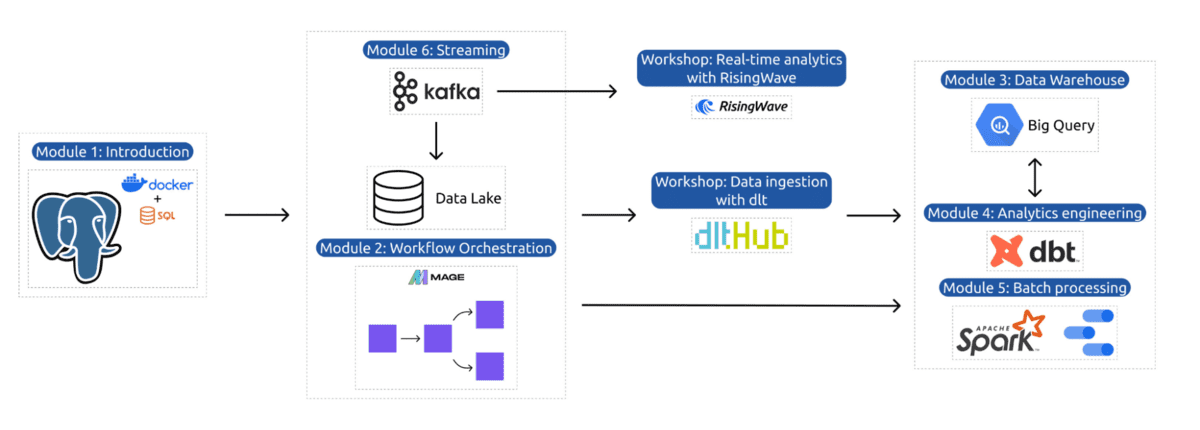
data-engineering-zoomcamp/projects
ZoomCamp по инженерии данных - это комплексный и бесплатный курс от DataTalks.Club, рассчитанный на девять недель. Охватывает основы инженерии данных, что особенно актуально для специалистов, владеющих навыками кодирования, которые хотят изучить тонкости создания систем данных.
В конце курса Вы примените полученные знания на практике, выполнив комплексный проект по проектированию данных. Этот проект включает в себя создание конвейера для обработки данных, перемещение данных из озера данных в хранилище данных, преобразование данных и создание дашборда.
2. Потоковые события, генерируемые сервисом потоковой передачи музыки
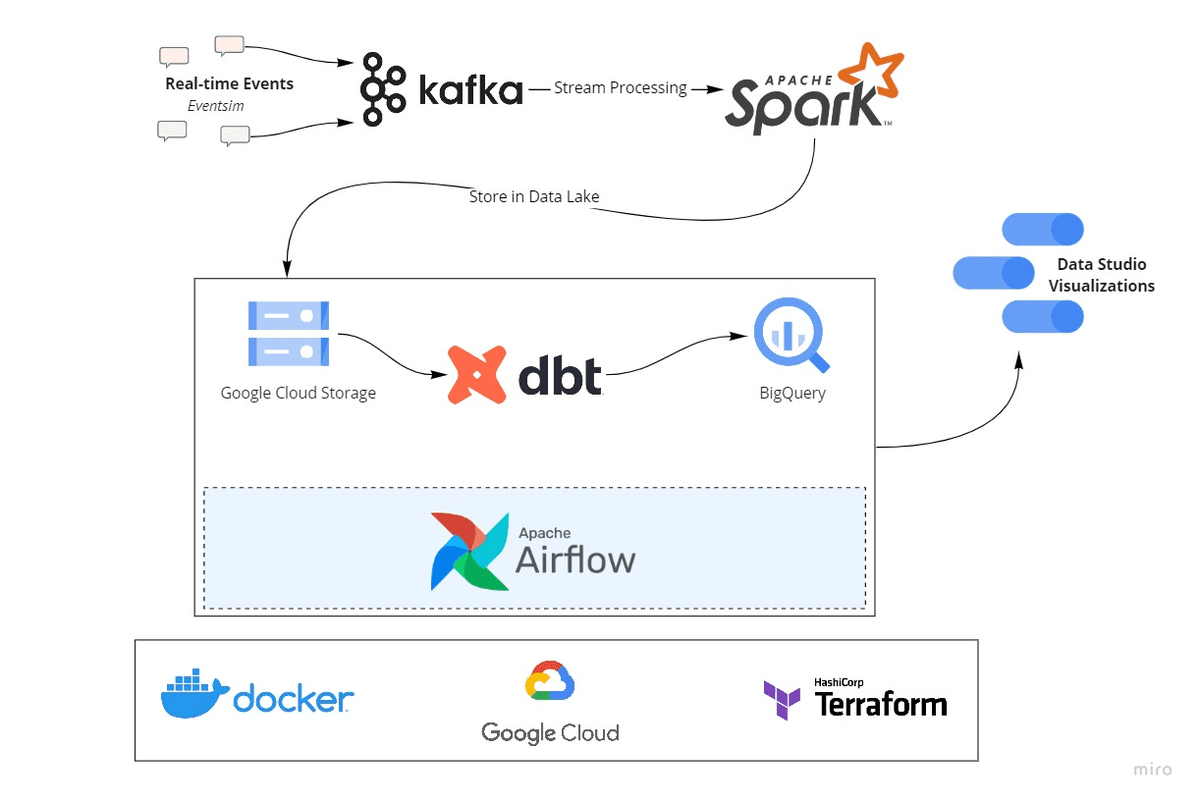
В этом проекте Вы создадите инженерный конвейер данных, используя такие инструменты, как Kafka, Spark Streaming, dbt, Docker, Airflow, Terraform и GCP. Проект streamify, имитирующий музыкальный стриминговый сервис, позволит Вам работать с потоками данных в режиме реального, эффективно обрабатывая и анализируя их. Этот проект идеально подходит для отображения всех сложностей потоковых данных и технологий.

3. Разработка конвейера данных Reddit
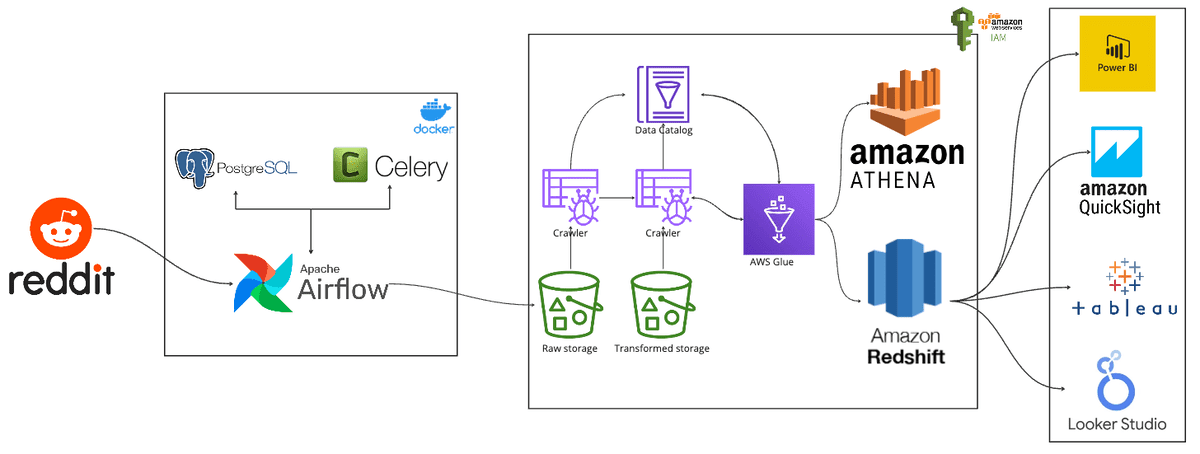
airscholar/RedditDataEngineering
Проект представляет собой комплексное решение для извлечения, преобразования и загрузки (ETL) данных Reddit. В нем для извлечения, преобразования и загрузки данных в хранилище данных Redshift используются Apache Airflow, Celery, PostgreSQL, Amazon S3, AWS Glue, Amazon Athena и Amazon Redshift. Этот проект отлично подходит для изучения того, как создавать масштабируемые конвейеры данных и управлять большими массивами данных в облачной среде.
4. Конвейер данных GoodReads
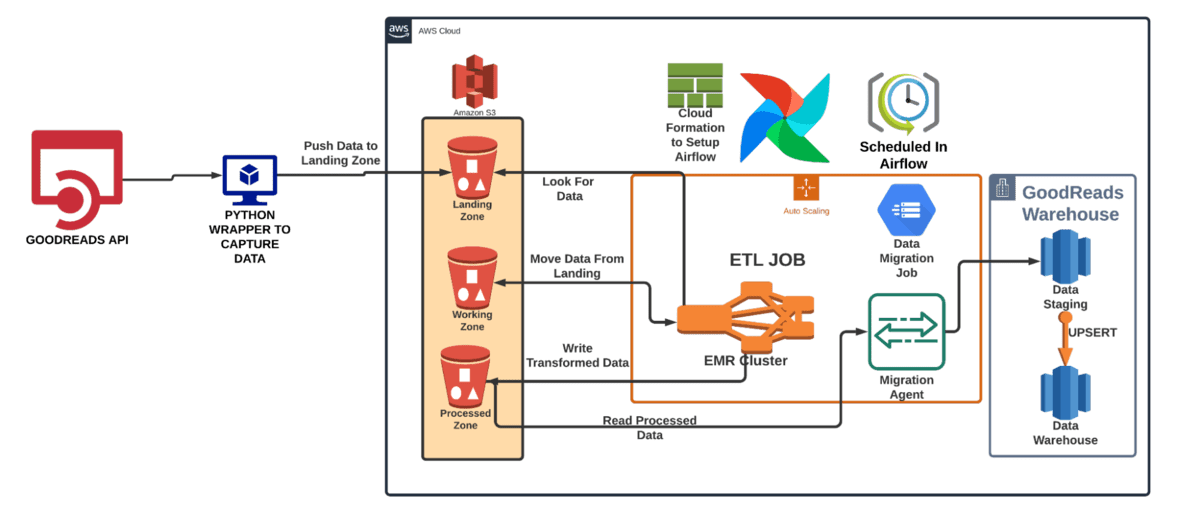
Этот проект направлен на создание конвейера данных для GoodReads. Он включает в себя создание озера данных, хранилища данных и аналитической платформы. Данные собираются в режиме реального времени из API GoodReads с помощью Python-обертки Goodreads. Мы получаем данные в режиме реального времени из GoodReads API, данные сначала хранятся на локальном диске, а затем оперативно передаются в S3 Bucket на AWS. Задания ETL, написанные на Spark, оркеструются с помощью Airflow и выполняются через каждые десять минут.
Работая над этим проектом, Вы приобретете опыт работы с различными источниками данных и их преобразования в ценные сведения, что является важнейшим навыком для любого инженера по данным.
5. Инжиниринговый проект компании UBER, задействовавший BigQuery
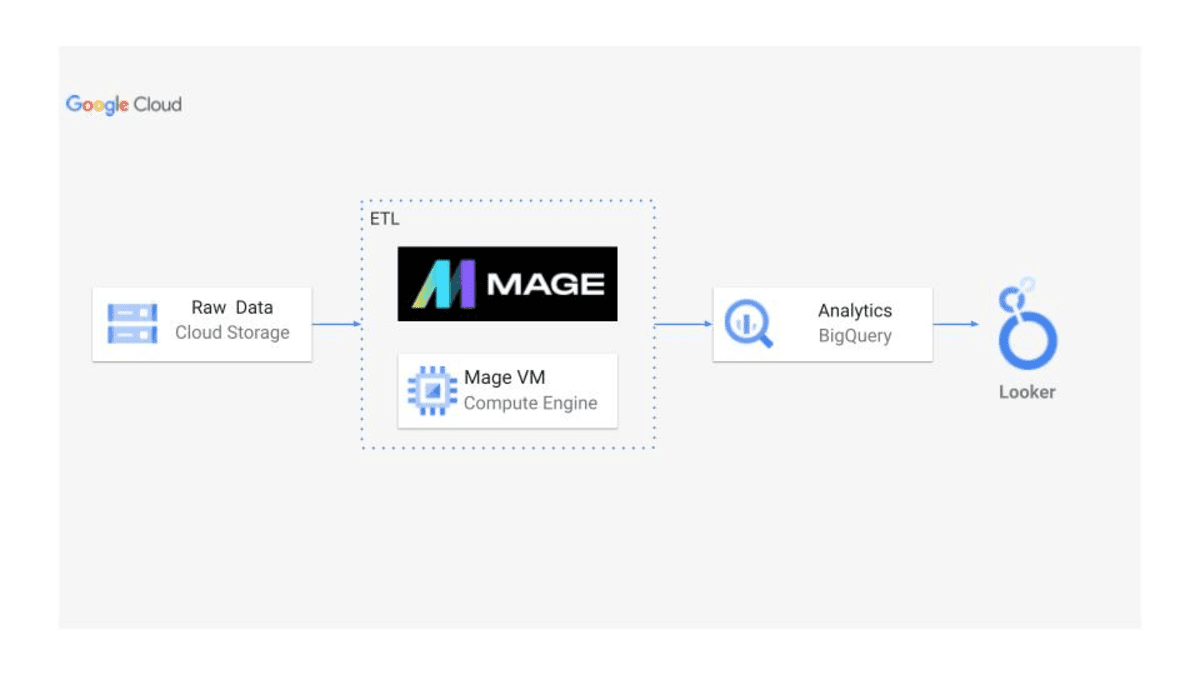
darshilparmar/uber-etl-pipeline-data-engineering-project
В этом проекте Вы будете работать над разработкой комплексного решения по проектированию данных для Uber с использованием BigQuery. Проект включает в себя разработку и реализацию конвейера данных, который обрабатывает и анализирует большие объемы данных. Этот проект идеально подходит для изучения облачных решений по хранению данных и оптимизации обработки данных для повышения производительности и масштабируемости системы.
6. Конвейер данных для RSS Feed
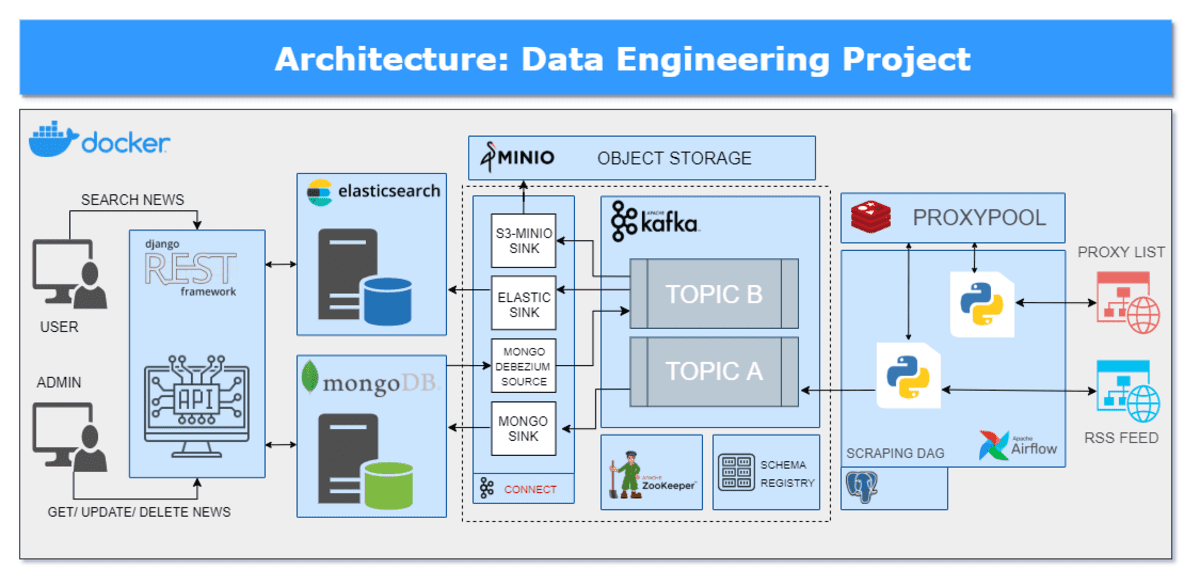
damklis/DataEngineeringProject
Этот проект представляет собой пример комплексного решения для обработки RSS-каналов. Он охватывает весь процесс конвейерной обработки данных, от извлечения данных до их преобразования и загрузки. Вы научитесь использовать Airflow, Kafka, MongoDB и elasticsearch. Этот проект - отличный способ разобраться в тонкостях работы с полуструктурированными данными и автоматизации рабочих процессов с данными.
7. YouTube Analysis
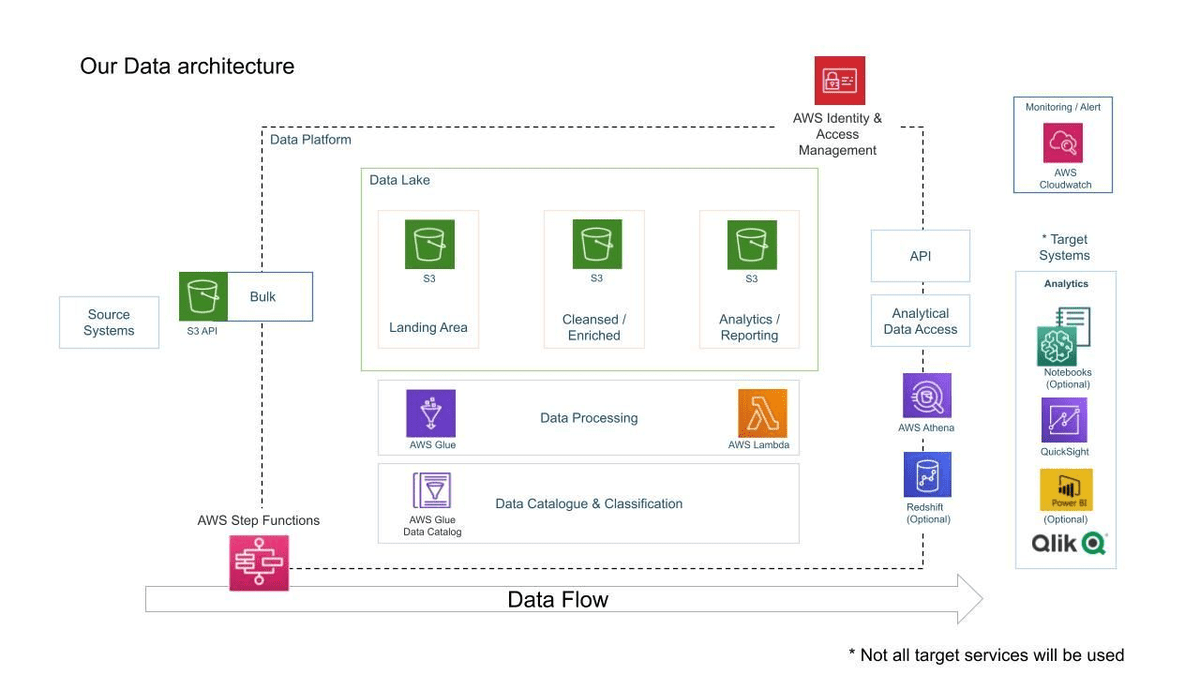
darshilparmar/dataengineering-youtube-analysis-project
Проект YouTube Analysis нацелен на создание конвейера, который будет безопасно управлять, упорядочивать и анализировать структурированные и полуструктурированные данные из видеороликов YouTube, уделяя особое внимание категориям видео и трендовым метрикам.
Этот проект поможет Вам научиться работать с большими массивами данных, выполнять преобразования данных и извлекать выводы из видеоаналитики. Это отличная возможность изучить пересечение инженерии данных и медиааналитики.
Заключение
Эти проекты представляют собой разнообразные задачи и возможности для обучения, что делает их идеальными для тех, кто стремится освоить инженерию данных. Выполнив эти проекты, Вы получите опыт работы с инструментами и методами, используемыми инженерами по данным в современной индустрии. Кроме того, Вы создадите сильное портфолио, которое поможет Вам найти работу своей мечты.


