

Потоковая передача данных из PostgreSQL в Kafka с помощью Debezium
Использование функции захвата данных об изменениях (CDC) в наши дни обязательно для любого приложения. Никто не хочет слышать, что внесенные им изменения не отразились в аналитике, потому что ночная синхронизация не подтянула новые данные. Проблема заключается в том, что существует огромное количество веб-приложений, которые работают в режиме OLTP и могут сосуществовать с реляционными базами данных, такими как Oracle, PostgreSQL, MySQL и т. д.
Выполнение аналитических задач в реальном времени в этих системах баз данных требует использования больших объединений и агрегаций, что приводит к блокировкам, поскольку эти системы баз данных имеют ACID-характеристики и обеспечивают надежные уровни изоляции. Эти блокировки могут удерживаться в течение длительного времени, что может повлиять на производительность приложения для реальных пользователей.
Таким образом, имеет смысл передавать данные другим командам Вашей организации, которые могут выполнять аналитику с помощью заданий Spark, запросов Hive или любого другого предпочитаемого Вами фреймворка для работы с большими данными.
Для выполнения CDC будут использоваться следующие технологии:
-
Apache Kafka — будет использоваться для создания темы обмена сообщениями, в которой будут храниться изменения данных, происходящие в базе данных.
https://kafka.apache.org/ - Kafka Connect - инструмент, используемый для масштабируемой и надежной передачи потоковых данных между Apache Kafka и другими системами. Используется для определения коннекторов, способных передавать данные из целых баз данных в Kafka и обратно. Список доступных коннекторов доступен по ссылкe.
- Debezium — инструмент, использующий лучший базовый механизм, предоставляемый системой базы данных, для преобразования WAL в поток данных. Затем данные из базы данных передаются в Kafka с помощью Kafka Connect API. https://github.com/debezium/debezium
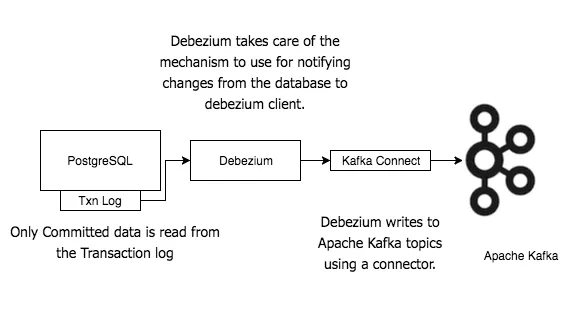
Debezium использует функцию логического декодирования, доступную в PostgreSQL, для извлечения всех постоянных изменений в базе данных в понятном формате, который можно интерпретировать без детального знания внутреннего состояния базы данных. Подробнее о логическом декодировании можно узнать здесь.
Как только измененные данные становятся доступны Debezium в понятном формате, он использует Kafka Connect API для регистрации себя в качестве одного из коннекторов источника данных. Debezium выполняет контрольные точки и читает только зафиксированные данные из журнала транзакций.
Пример
Для дальнейшей работы нам понадобится Docker.
Запуск PostgreSQL :
docker run — name postgres -p 5000:5432 debezium/postgres
Запуск Zookeeper:
docker run -it — name zookeeper -p 2181:2181 -p 2888:2888 -p 3888:3888 debezium/zookeeper
Запуск Kafka:
docker run -it — name kafka -p 9092:9092 — link zookeeper:zookeeper debezium/kafka
Запуск Debezium:
docker run -it — name connect -p 8083:8083 -e GROUP_ID=1 -e CONFIG_STORAGE_TOPIC=my-connect-configs -e OFFSET_STORAGE_TOPIC=my-connect-offsets -e ADVERTISED_HOST_NAME=$(echo $DOCKER_HOST | cut -f3 -d’/’ | cut -f1 -d’:’) — link zookeeper:zookeeper — link postgres:postgres — link kafka:kafka debezium/connect
Подключение к PostgreSQL и создание дашборда:
psql -h localhost -p 5000 -U postgres
 CREATE DATABASE inventory; CREATE TABLE dumb_table(id SERIAL PRIMARY KEY, name VARCHAR);

Что мы только что сделали?
Мы запустили базу данных PostgreSQL и привязали ее порт к 5000 для нашей системы. Мы также запустили zookeeper, который используется Apache Kafka для хранения смещений потребителей. Наконец, мы запустили экземпляр debezium, в котором связали наши существующие контейнеры, то есть postgres, kafka и zookeeper. Это поможет в обмене данными между контейнерами.
Наша настройка готова, осталось только зарегистрировать коннектор для Kafka Connect.
Создание коннектора с помощью Kafka Connect
curl -X POST -H “Accept:application/json” -H “Content-Type:application/json” localhost:8083/connectors/ -d ‘ { “name”: “inventory-connector”, “config”: { “connector.class”: “io.debezium.connector.postgresql.PostgresConnector”, “tasks.max”: “1”, “database.hostname”: “postgres”, “database.port”: “5432”, “database.user”: “postgres”, “database.password”: “postgres”, “database.dbname” : “inventory”, “database.server.name”: “dbserver1”, “database.whitelist”: “inventory”, “database.history.kafka.bootstrap.servers”: “kafka:9092”, “database.history.kafka.topic”: “schema-changes.inventory” } }’
Проверяем, получилось ли у нас создать коннектор
curl -X GET -H “Accept:application/json” localhost:8083/connectors/inventory-connector
Запуск Kafka Console consumer , который будет мониторить изменения данных
docker run -it — name watcher — rm — link zookeeper:zookeeper debezium/kafka watch-topic -a -k dbserver1.public.dumb_table
Этот код используется для нашего примера. Для своих производственных систем Вы должны написать свой собственный код.
Результат
Теперь выполните несколько SQL-вставок, обновлений и удалений из PSQL CLI. В результате Вы увидите вывод, похожий на JSON.
На самом деле данный результат является форматом Apache Avro, который представляет собой фреймворк RPC и сериализации данных, разработанный в рамках проекта Apache Hadoop. Он использует JSON для определения типов данных и протоколов. Основная особенность формата Avro - эволюция схемы.
Если Вы используете инструмент JSON pretty на выходе, то в JSON обнаружите два основных ключа – schema и payload.
Ключ schema содержит схему для строки, записи txn, источника и т. д. Ключ payload содержит изменение данных. Последний ключ также содержит данные «до» и «после» для строки в случае, если строка была обновлена или удалена. Кроме того, он отражает тип операции, который полезен для определения типа события, которое было вставлено, обновлено или удалено.
Также обратите внимание на то, что если Вы измените структуру таблицы, а затем выполните несколько вставок, обновлений или удалений, то схема, выведенная консоль потребителя, также изменится и будет соответствовать данным.


