

Раскройте возможности CDC с помощью Debezium
От традиционных конвейеров синхронизации данных к потоковой передаче данных в режиме реального времени и интеграции для современных приложений
В современном мире, основанном на данных, информация - это не просто актив, это жизненная сила, которая питает инженерную деятельность, аналитику и моделирование данных во всех отраслях. Чтобы использовать истинную силу данных, они должны быть собраны оперативно и максимально аккуратно. Именно здесь захват данных об изменениях (CDC) становится решающим фактором.
Среди различных доступных инструментов CDC Debezium выделяется как решение с открытым исходным кодом, которое эффективно захватывает изменения данных из исходных баз данных, что делает его незаменимым для современных архитектур данных.
Ключевые концепты
Прежде чем мы приступим к настройке Debezium, давайте рассмотрим некоторые ключевые понятия, которые помогут Вам лучше понять принцип его работы:
Коннектор Debezium: Мы используем проект Debezium для критически важной части нашей разработки. Это широко распространенное решение с открытым исходным кодом, используемое многими технологическими гигантами, эффективно обнаруживает изменения строк в Postgres и генерирует событие для каждой модификации - процесс, известный как Change Data Capture (CDC). В нашем случае мы используем именно коннектор Debezium Postgres, хотя он поддерживает и другие базы данных, такие как MySQL и MongoDB.
Коннектор Postgres использует концепцию, называемую логическим декодированием, для чтения из журнала записи Postgres (WAL), также известного как журнал транзакций, и генерирует события для каждого изменения строки. Записи, создаваемые коннектором, могут быть довольно длинными, поэтому мы используем преобразование одиночных сообщений, чтобы упростить событие до новых значений в строке. Чтобы обеспечить правильное упорядочивание событий, мы поддерживаем один раздел для каждой темы Kafka и включаем порядковый номер журнала Postgres (LSN) в каждое событие. LSN служит смещением в журнале Postgres с опережающей записью.
Я хочу обратить Ваше внимание на критический момент, который может привести к серьезным проблемам, если не управлять им должным образом: хотя логическое декодирование Postgres и предлагает достаточно эффективный способ передачи изменений базы данных внешним потребителям, у него есть свои недостатки. Наиболее важным является то, что Postgres не будет удалять какую-либо часть журнала с опережающей записью до тех пор, пока все существующие слоты логической репликации не используют эти данные. Это означает, что если Ваш консюмер (в данном случае коннектор Debezium) по какой-либо причине прекратит потребление, Postgres будет продолжать добавлять данные в журнал до тех пор, пока диск не будет заполнен, что может привести к невосприимчивости базы данных. Использование логического декодирования требует достаточного дискового пространства для буферизации на случай временных перебоев и эффективного мониторинга для раннего предупреждения о любых проблемах.

Pgoutput: При создании слота логического декодирования в Postgres необходимо указать плагин вывода для этого слота. Плагины вывода логического декодирования декодируют и преобразуют содержимое журнала с опережением записи в формат, пригодный для использования. Мы также используем плагин pgoutput, который является встроенным плагином вывода, предоставляемым Postgres. Он предназначен для логической репликации и предлагает эффективные возможности потоковой передачи данных. В отличие от wal2json, который производит вывод в формате JSON, pgoutput оптимизирован для совместимости с различными сценариями репликации, что делает его универсальным выбором для многих приложений.
Apache Kafka: Центральным элементом нашей новой системы ELT является кластер Kafka, который поддерживает один топик для каждой таблицы Postgres, которую мы реплицируем. Этот кластер предназначен исключительно для событий ELT, что обеспечивает беспрепятственную интеграцию изменений данных, фиксируемых Debezium. По мере того как Debezium передает изменения из базы данных Postgres, он публикует их в соответствующих темах Kafka, обеспечивая эффективную обработку каждого события и его доступность для последующих приложений. Используя распределенную архитектуру Kafka, мы получаем масштабируемость и надежность, позволяющие обрабатывать большие объемы данных с минимальными задержками.
Kafka Connect: Kafka Connect - это фреймворк с открытым исходным кодом, который облегчает интеграцию Kafka с различными существующими системами, такими как базы данных и файловые системы, с помощью предварительно созданных компонентов, называемых коннекторами. В контексте Debezium мы используем Kafka Connect для потоковой передачи данных об изменениях из наших баз данных в Kafka. Debezium предоставляет коннекторы Source, специально разработанные для этой цели, что позволяет нам эффективно перехватывать и передавать изменения баз данных в режиме реального времени. Такая интеграция обеспечивает беспрепятственное перемещение данных из базы данных в Kafka, где они могут быть обработаны и использованы другими приложениями в нашей экосистеме.

Установка Debezium с помощью Kafka
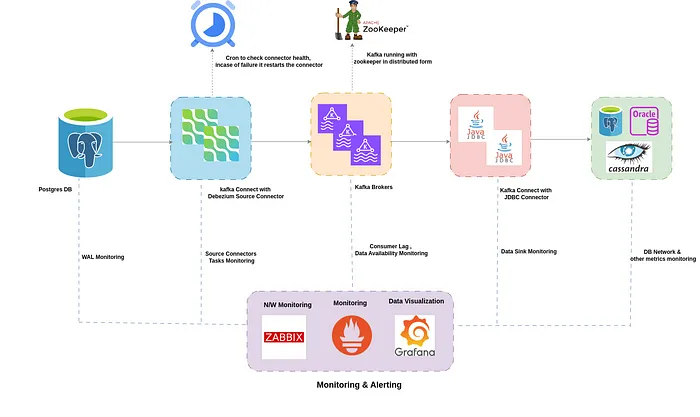
Чтобы обеспечить постоянную доступность конвейера данных, мы настроили Debezium как плагин Kafka Connect, работающий в распределенном режиме. Настройка включает в себя использование двух виртуальных машин (ВМ) с установленными Java и Kafka.
1. Установка Kafka: Сначала загрузите и установите Kafka.
2. Установка Debezium PostgreSQL: Следуйте руководству по установке Debezium.
Установка Debezium
Создайте каталог /opt: Начните с создания каталога `/opt` на Вашем сервере.
Поместите плагин Debezium: Переместите плагин Debezium в папку `/opt`.
Настройка Kafka
Обновите файл connect-distributed.properties в папке конфигурации Kafka для работы в распределенном режиме:
bootstrap.servers=<list_of_kafka_cluster_IPs>
plugin.path=/opt/debezium
group.id=<your_kafka_connect_cluster_group_id> # одинаково для всех узлов в распределенном режиме
Для обеспечения высокой доступности мы запускаем Kafka вместе с Zookeeper в распределенном режиме с тремя брокерами Kafka.
Синхронизация данных во вторичных базах данных
Чтобы перенести данные в целевую базу данных, Вам понадобится соответствующий коннектор. Для передачи данных в целевую базу данных PostgreSQL, которая также имеет открытый исходный код, мы используем коннектор JDBC.
Конфигурация на уровне базы данных
Для получения данных требуется дополнительная настройка на уровне базы данных. В руководстве Debezium PostgreSQL Connector Guide содержатся подробные инструкции о том, как это сделать.
Мониторинг и оповещение
Чтобы обеспечить бесперебойную работу, мы контролируем весь конвейер с помощью Prometheus и Kafka. Метрики экспортируются в Prometheus и визуализируются в Grafana для мониторинга и оповещения. Такая настройка позволяет отслеживать состояние и производительность нашего конвейера CDC в режиме реального времени. Кроме того, Вы можете настроить Grafana на отправку оповещений о критических состояниях.
Debezium в IndiaMart
В компании IndiaMart мы используем Debezium для потоковой передачи данных в реальном времени во вторичные базы данных. Вот два основных случая использования:
Основными требованиями, которыми мы руководствовались при разработке, были:
- Обновление БД с нулевым временем простоя
- Единая ответственность за запись
- Простое внедрение
Обновление версии БД: Процесс обновления или переноса базы данных без прерывания доступности приложений, которые от нее зависят. Такой подход важен для компаний, которым требуется постоянный доступ к своим услугам и которые не могут позволить себе простои во время обслуживания или обновления.
Мы использовали Debezium для обновления наших баз данных PostgreSQL с нулевым временем простоя, гарантируя, что данные останутся актуальными на протяжении всего процесса. На сегодняшний день мы успешно обновили пять баз данных, включая критически важную базу данных Auth PG, используемую для входа в систему в IndiaMart, которая ежедневно обрабатывает около 3 крор записей.
Ответственность за одну запись в контексте API и баз данных относится к принципу, согласно которому каждый фрагмент данных должен иметь единственный источник истины для его создания или изменения. Вот как он применяется:
- API: В архитектуре микросервисов каждый сервис должен отвечать за запись данных в свое хранилище. Это предотвращает конфликты и обеспечивает централизацию изменений в данных в рамках одного сервиса, что упрощает управление целостностью и непротиворечивостью данных.
- Базы данных: Каждая база данных должна быть единственным авторитетом для содержащихся в ней данных. Это означает, что обновления, вставки и удаления должны происходить через определенный интерфейс (например, API), что обеспечивает контроль и проверку всех изменений данных. Такой подход помогает предотвратить такие проблемы, как дублирование и несогласованность данных, поскольку не существует нескольких точек входа для записи данных.
Придерживаясь принципа единой ответственности за запись, организации могут оптимизировать управление данными, повысить производительность и снизить риск ошибок, которые могут возникнуть в результате одновременной записи в несколько баз данных или служб.
Компания IndiaMart управляет большими объемами данных в нескольких базах данных. Для обеспечения высокого потока и доступности данных репликация имеет решающее значение. Внедрив Debezium в нашу основную базу данных, мы в настоящее время синхронизируем данные с 15 целевыми базами данных. Такая установка позволила свести к минимуму потребность в дополнительных экземплярах потребителей и RabbitMQ, эффективно сократив расходы на инфраструктуру. В настоящее время в нашем производственном конвейере обрабатывается 56 таблиц, а общий объем данных составляет около 1 крор записей в день.
Проблемы, с которыми пришлось столкнуться при запуске Debezium
Даже при хорошо настроенной системе могут возникнуть проблемы. Вот некоторые из проблем, с которыми столкнулись мы, и способы их решения:
- Остановка потоковой передачи из-за массовой генерации WAL: При генерации большого количества записей в журнале Write-Ahead Logging (WAL) буфер может переполниться, что приведет к временной остановке потоковой передачи Debezium. Эту проблему можно решить, избегая процессов массового создания WAL в исходной базе данных.
- Задержка между исходной и конечной базами данных: В периоды высокого трафика мы сталкивались с задержкой в 1-2 минуты между исходной и целевой базами данных. Настройка интервала опроса коннектора источника помогла уменьшить эту задержку.
- Настройка времени опроса:
Property Name:`poll.interval.ms`
Default Value: 500ms
Более низкое время опроса уменьшает задержку, но увеличивает частоту обработки. Настройте этот параметр в соответствии с Вашими потребностями для того, чтобы сбалансировать скорость передачи данных и общую нагрузку на систему.
Точная настройка этих параметров позволит Вам создать надежный и отзывчивый конвейер данных, который будет предоставлять данные для Ваших приложений практически в режиме реального времени.
Ключевые соображения касательно производственной среды:
Имя консюмера: Имя консюмера, связанное с группой консюмеров Kafka, сохраняет порядковый номер журнала (LSN), с которого данные были зафиксированы в Kafka. Изменение имени потребителя в работающем конвейере может повлиять на поток данных и потенциально привести к их потере.
Настройка моментальных снимков: При создании инкрементальных снимков скорость публикации в Kafka ниже, чем при обычных снимках. Это можно регулировать с помощью свойства `incremental.chunk.size`. Однако после достижения определенного порога вам потребуется настройка других параметров, таких как `producer.override.batch.size` и `producer.override.buffer.memory`, чтобы оптимизировать пропускную способность.


