

Лучшие практики DWH
Как моделировать данные в DWH
Если Вы - новичок в области DWH и моделирования данных, то эта статья, вдохновленная проектом A - лучшие практики моделирования данных, поможет Вам начать работу в области инженерии данных.
Методология
Первое, что Вам как инженеру по данным нужно сделать, - это научиться извлекать аналитические сущности из бизнес-вопросов. Таким образом, Вы будете оценивать следующие аспекты:
- Достаточно ли имеющихся у меня данных для ответа на поставленный бизнес-вопрос?
- Как я могу расширить модели данных, чтобы ответить на бизнес-вопрос?
Часто руководство просит Вас создать дашборд. У Вас будет возможность сделать это быстро и «грязно» или медленно и правильно.
Быстрый способ (без моделирования данных)
Вариант 1: Инструмент для создания отчетов непосредственно на основе источников данных
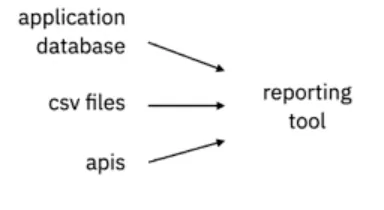
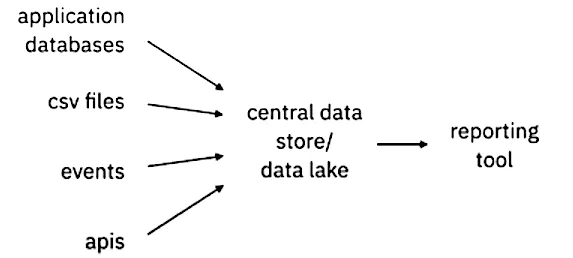
Вариант 2: Перенос данных в базу данных, а затем их анализ с помощью инструмента отчетности
Вариант 3: Создание специальных представлений и таблиц для конкретных графиков/дашбордов
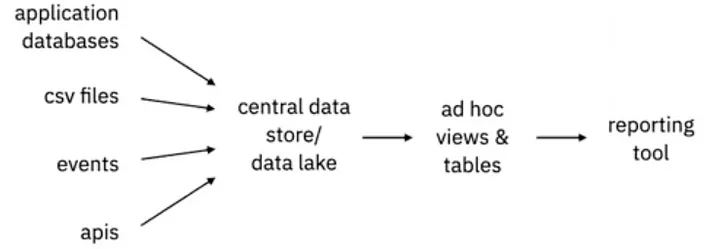
У этого метода есть свои недостатки:
- Единый источник истины трудно поддерживать, например, различная бизнес-логика или определения метрик на разных панелях и в разных командах, а также низкая прозрачность данных.
- Сложно масштабироваться в зависимости от сложности бизнеса, например, сложно обновлять бизнес-логику на разных панелях. При необходимости объединения данных из разных источников может возникнуть путаница.
- Данные разрознены в различным инструментах отчетности

Моделирование данных по Кимбаллу
Этот подход заключается в создании единой аналитической модели и активизации данных по всей компании.
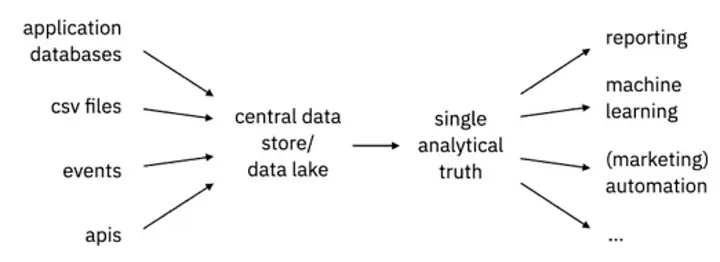
- Моделирование данных в виде схемы Звезда или Снежинка
- Нормализованные данные (3NF)
- Целостность ссылок
- Последовательное присвоение имени
Давайте рассмотрим практический пример. Ваш начальник спрашивает: Я хочу знать выручку!
Ваша задача:
- Определите бизнес-процессы/субъекты, которые создают доход
- Предвидеть вопросы, которые возникнут у пользователей в связи с выручкой
- Согласовать хорошие ярлыки, такие как «клиент» или «выручка»
- Найти общее представление (размерная модель = таблицы фактов + таблицы измерений) для ответа на все бизнес-вопросы сразу.
Правила игры:
1. Если сущность фундаментальна, лучше предварительно вычислить ее в базе данных, а не делать это в инструменте отчетности, что будет происходить по памяти.
2. Ментальная модель для перевода бизнес-вопросов в размерную модель:
- каждая таблица имеет фиксированный набор полей
- простые агрегации по одному полю (AVG, COUNT, SUM и т. д.)
- фильтрация (фильтрация по дате, сезону, местоположению и т. д.)
- группировка (группировка по продукту, способу оплаты и т. д.)
3. При разработке методологии моделирования данных следует также учитывать следующие моменты:
- перспективы времени: большинство бизнес-процессов происходят во времени, как события, например, размещение заказов, отгрузка и т. д.
- изменения сущностей во времени: последнего/текущего состояния недостаточно, например, статус заказа (размещен, оплачен, отправлен), изменение воронки клиентов (новый, квалифицированный маркетолог и т. д.).
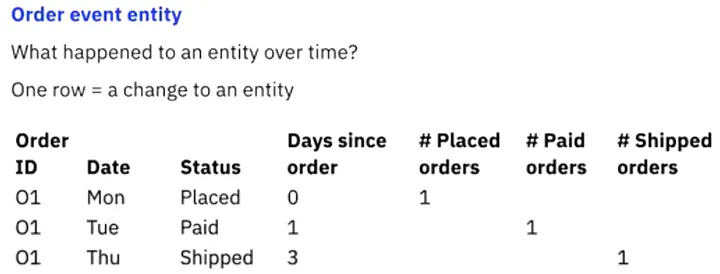
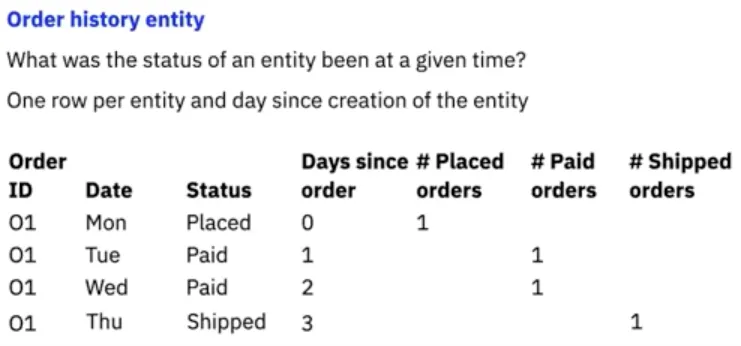
- Изменения метрик с течением времени: например, отмена заказа
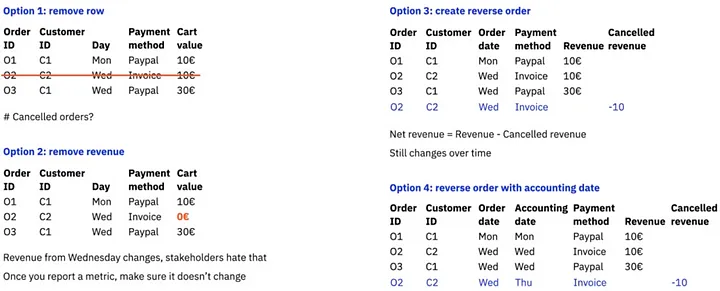
Предыдущая фаза относится к сбору требований, прежде чем начнется собственно моделирование. Теперь мы перейдем к моделированию данных.
Размерное моделирование = отношения между сущностями
Часто данные в DWH моделируются иначе, чем в источниках данных, что обычно связано с переходом от OLTP к OLAP. При проектировании хранилища данных инженер по данным выполняет нормализацию данных, которая заключается в создании сущностей на основе аналитических потребностей. Сущности должны быть обусловлены тем, о чем вы хотите составлять отчеты, например, если команда аналитиков просит сегментировать клиентов по категориям продуктов, то категория продукта должна быть отдельной сущностью.
Конвейеры данных как код
Мейнстримом в инженерии данных стало использование конвейеров данных в качестве кода, особенно с помощью таких инструментов, как dbt - open-source transform workflow tool. Правило заключается в том, что конвейеры данных должны быть воспроизводимыми, идемпотентными и неизменяемыми. Это означает, что запуск конвейера на одних и тех же входных данных приведет к одному и тому же результату на этих входных данных.
Оставьте данные в базе данных: SQL vs Pandas
Если Вам приходится выбирать между анализом данных с помощью Pandas и SQL, то используйте в качестве языка обработки данных SQL. Это связано с тем, что базы данных обеспечивают более быстрые вычисления и менее требовательны к памяти.


