

Hudi: Создайте свои JAR с помощью патчей - Rocky Linux в Docker
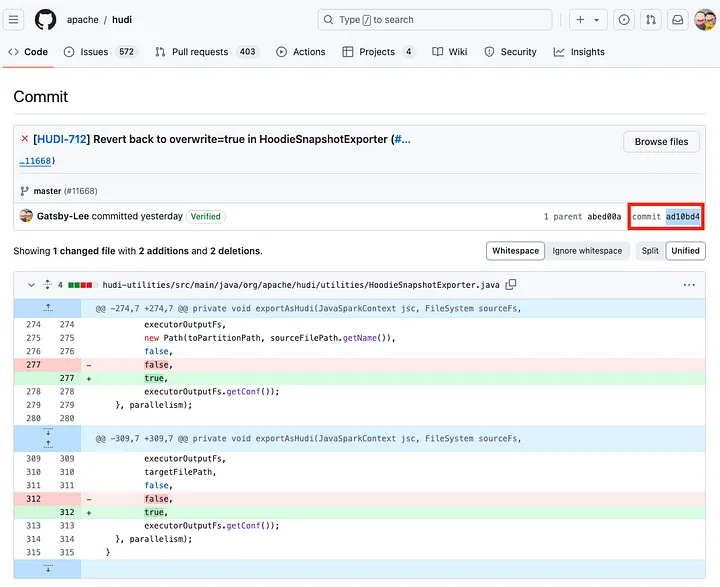
Я покажу Вам, как я создал Hudi 0.14.1 с помощью публичного PR, который я сделал в Hudi.

Введение
Недавно я обновился с версии Hudi 0.12.2 до 0.14.1. Процесс включал в себя множество экспериментов, тестирование и миграцию, что заняло некоторое время, но в целом переход прошел достаточно гладко.
Нестабильность в экспорте моментальных снимков Hudi
После обновления всех ETL до Hudi версии 0.14.1 я обновил и ежедневное раисписание резервного копирования Hudi, чтобы использовать Hudi Snapshot Export в новой версией. К сожалению, это внесло нестабильность в процесс экспорта моментальных снимков. После отладки и экспериментов я определил, что проблема связана с недавним PR в файле HoodieSnapshotExporter.java. В этот PR было случайно внесено одно небольшое изменение, которое вызывало случайную нестабильность в процессе экспорта при использовании EKS on EMR с Spot Instances.
at org.apache.spark.scheduler.DAGScheduler.failJobAndIndependentStages(DAGScheduler.scala:3067)
 at org.apache.spark.scheduler.DAGScheduler.$anonfun$abortStage$2(DAGScheduler.scala:3003)
 at org.apache.spark.scheduler.DAGScheduler.$anonfun$abortStage$2$adapted(DAGScheduler.scala:3002)
 at scala.collection.mutable.ResizableArray.foreach(ResizableArray.scala:62)
 at scala.collection.mutable.ResizableArray.foreach$(ResizableArray.scala:55)
 at scala.collection.mutable.ArrayBuffer.foreach(ArrayBuffer.scala:49)
 at org.apache.spark.scheduler.DAGScheduler.abortStage(DAGScheduler.scala:3002)
 at org.apache.spark.scheduler.DAGScheduler.$anonfun$handleTaskSetFailed$1(DAGScheduler.scala:1318)
 at org.apache.spark.scheduler.DAGScheduler.$anonfun$handleTaskSetFailed$1$adapted(DAGScheduler.scala:1318)
 at scala.Option.foreach(Option.scala:407)
 at org.apache.spark.scheduler.DAGScheduler.handleTaskSetFailed(DAGScheduler.scala:1318)
 at org.apache.spark.scheduler.DAGSchedulerEventProcessLoop.doOnReceive(DAGScheduler.scala:3271)
 at org.apache.spark.scheduler.DAGSchedulerEventProcessLoop.onReceive(DAGScheduler.scala:3205)
 at org.apache.spark.scheduler.DAGSchedulerEventProcessLoop.onReceive(DAGScheduler.scala:3194)
 at org.apache.spark.util.EventLoop$$anon$1.run(EventLoop.scala:49)
 at org.apache.spark.scheduler.DAGScheduler.runJob(DAGScheduler.scala:1041)
 at org.apache.spark.SparkContext.runJob(SparkContext.scala:2406)
 at org.apache.spark.SparkContext.runJob(SparkContext.scala:2427)
 at org.apache.spark.SparkContext.runJob(SparkContext.scala:2446)
 at org.apache.spark.SparkContext.runJob(SparkContext.scala:2471)
 at org.apache.spark.rdd.RDD.$anonfun$foreach$1(RDD.scala:1028)
 at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:151)
 at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:112)
 at org.apache.spark.rdd.RDD.withScope(RDD.scala:407)
 at org.apache.spark.rdd.RDD.foreach(RDD.scala:1026)
 at org.apache.spark.api.java.JavaRDDLike.foreach(JavaRDDLike.scala:352)
 at org.apache.spark.api.java.JavaRDDLike.foreach$(JavaRDDLike.scala:351)
 at org.apache.spark.api.java.AbstractJavaRDDLike.foreach(JavaRDDLike.scala:45)
 at org.apache.hudi.client.common.HoodieSparkEngineContext.foreach(HoodieSparkEngineContext.java:155)
 at org.apache.hudi.utilities.HoodieSnapshotExporter.exportAsHudi(HoodieSnapshotExporter.java:222)
 at org.apache.hudi.utilities.HoodieSnapshotExporter.export(HoodieSnapshotExporter.java:143)
 at org.apache.hudi.utilities.HoodieSnapshotExporter.main(HoodieSnapshotExporter.java:292)
 at java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke0(Native Method)  at java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:77)
 at java.base/jdk.internal.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
 at java.base/java.lang.reflect.Method.invoke(Method.java:568)
 at org.apache.spark.deploy.JavaMainApplication.start(SparkApplication.scala:52)
 at org.apache.spark.deploy.SparkSubmit.org$apache$spark$deploy$SparkSubmit$$runMain(SparkSubmit.scala:1075)
 at org.apache.spark.deploy.SparkSubmit.doRunMain$1(SparkSubmit.scala:194)
 at org.apache.spark.deploy.SparkSubmit.submit(SparkSubmit.scala:217)
 at org.apache.spark.deploy.SparkSubmit.doSubmit(SparkSubmit.scala:91)
 at org.apache.spark.deploy.SparkSubmit$$anon$2.doSubmit(SparkSubmit.scala:1167)
 at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:1176)
 at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala) Caused by: org.apache.hadoop.fs.PathExistsException: `s3://hell-world/20240717/dummy-db/dummy-dataset/span_source_service=model_serving/event_created_yearmonth=202307/ca48e606-9303-4157-bb95-6db62ad41193-0_0-132824-903108_20230729020005820.parquet': Target s3://hell-world/20240717/dummy-db/dummy-dataset/span_source_service=model_serving/event_created_yearmonth=202307/ca48e606-9303-4157-bb95-6db62ad41193-0_0-132824-903108_20230729020005820.parquet already exists
 at org.apache.hadoop.fs.FileUtil.checkDest(FileUtil.java:623)
 at org.apache.hadoop.fs.FileUtil.copy(FileUtil.java:466)
 at org.apache.hadoop.fs.FileUtil.copy(FileUtil.java:430)
 at org.apache.hudi.utilities.HoodieSnapshotExporter.lambda$exportAsHudi$43b4457d$1(HoodieSnapshotExporter.java:232)
 at org.apache.spark.api.java.JavaRDDLike.$anonfun$foreach$1(JavaRDDLike.scala:352)
 at org.apache.spark.api.java.JavaRDDLike.$anonfun$foreach$1$adapted(JavaRDDLike.scala:352)
 at scala.collection.Iterator.foreach(Iterator.scala:943)
 at scala.collection.Iterator.foreach$(Iterator.scala:943)
 at org.apache.spark.InterruptibleIterator.foreach(InterruptibleIterator.scala:28)
 at org.apache.spark.rdd.RDD.$anonfun$foreach$2(RDD.scala:1028)
 at org.apache.spark.rdd.RDD.$anonfun$foreach$2$adapted(RDD.scala:1028)
 at org.apache.spark.SparkContext.$anonfun$runJob$5(SparkContext.scala:2446)
 at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:93)
 at org.apache.spark.TaskContext.runTaskWithListeners(TaskContext.scala:161)
 at org.apache.spark.scheduler.Task.run(Task.scala:143)
 at org.apache.spark.executor.Executor$TaskRunner.$anonfun$run$4(Executor.scala:629)
 at org.apache.spark.util.SparkErrorUtils.tryWithSafeFinally(SparkErrorUtils.scala:64)
 at org.apache.spark.util.SparkErrorUtils.tryWithSafeFinally$(SparkErrorUtils.scala:61)
 at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:95)
 at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:632)
 at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1136)
 at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:635)
 at java.base/java.lang.Thread.run(Thread.java:840)

PR в Hudi OSS
Выявив проблему, я связался с коммиттером, внесшим предыдущие изменения. В ходе обсуждения мы рассмотрели проблемный код и договорились о возможном решении. Затем я создал pull request (PR) в проекте Hudi с открытым исходным кодом. PR был рассмотрен, одобрен и объединен с основной веткой. Исправление будет включено в следующий релиз Hudi, потенциально в версию 0.15.1. Поскольку в ближайшее время я не планирую переходить на серию 0.15.x, я решил собрать JAR-файлы Hudi версии 0.14.1 вручную.
Настройка среды сборки с Rocky Linux в Docker
Я попытался привязать каталог с исходным кодом Hudi на хост-машине, но он все равно работал нестабильно. Поэтому я подготовил исходный код в контейнере.
Установите пакеты
# Install packanges
dnf install -y java-1.8.0-openjdk java-1.8.0-openjdk-devel maven git ncurses
Подготовьте исходный код Hudi
После клонирования репозитория Hudi на Github была проверена ветка release-0.14.1. Поверх ветки я применил следующий код:
# clone Hudi repo / apply the patches
cd /home
git clone https://github.com/apache/hudi.git && cd hudi
git checkout release-0.14.1 git cherry-pick ad10bd4
2. Построение Hudi
Для среды разработки Hudi подходит Java 11. Для сборки Hudi требуется Java 8.
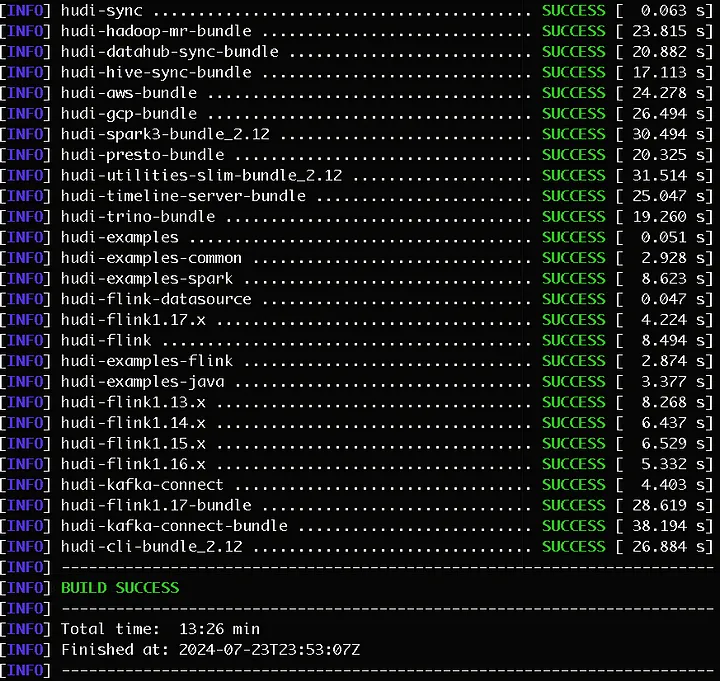
Спустя несколько минут сборка была завершена.
# Build
export JAVA_HOME=/usr/lib/jvm/java-1.8.0
export PATH=$JAVA_HOME/bin:$PATH
mvn clean package -DskipTests -Dspark3
Где находятся созданные артефакты?
Собранные пакеты были найдены в каталогах hudi/packaging.

Копирование файлов артефактов сборки из контейнера Docker на хост
Чтобы скопировать файлы собранных артефактов из контейнера Docker на хост, выполните следующие действия:
1. Определите ID контейнера
docker ps

2. Скопируйте файлы
С помощью команды docker cp скопируйте необходимые файлы из контейнера на хост:
# docker cp <containerId>:/file/path/within/container /host/path/target
docker cp 19d06bf4d13c:/home/hudi/packaging/hudi-utilities-bundle/target/hudi-utilities-bundle_2.12-0.14.1.jar .
docker cp 19d06bf4d13c:/home/hudi/packaging/hudi-aws-bundle/target/hudi-aws-bundle-0.14.1.jar .
docker cp 19d06bf4d13c:/home/hudi/packaging/hudi-spark-bundle/target/hudi-spark3-bundle_2.12-0.14.1.jar .


