

Использование таблиц Apache Hudi и Iceberg в Databricks с помощью Apache XTable

Такие форматы таблиц метаданных, как Apache Hudi, Delta Lake и Apache Iceberg, позволили создать архитектуру открытых озер, обеспечив основу для открытого хранения данных и гибкость в плане использования вычислений для различных рабочих нагрузок. Эти форматы облегчают хранение данных в облачных хранилищах данных, таких как Amazon S3, Microsoft Azure Blob Storage и Google Cloud Storage. При этом они позволяют организациям сохранять контроль над своими данными в безопасной среде.
Хотя эта парадигма обладает серьезными преимуществами, мы видим, что по мере того, как все больше организаций создают «озера», возникает проблема взаимодействия между этими тремя форматами таблиц в их экосистеме. Организациям приходится часто переносить или копировать данные для обеспечения их совместимости в разных форматах, что является дорогостоящим и крайне неэффективным процессом.
Запущенный в прошлом году проект Apache XTable (incubating) - это проект с открытым исходным кодом, направленный на обеспечение совместимости между различными форматами таблиц Lakehouse. XTable не является новым форматом таблиц, он функционирует как слой трансляции, который облегчает преобразование метаданных между различными открытыми форматами таблиц. Его функциональность основана на том, что три основных формата таблиц - Apache Hudi, Delta Lake и Apache Iceberg - используют Parquet для хранения данных и имеют общие черты в структуре метаданных, которые включают сведения о разделах, схеме, статистике на уровне столбцов, количестве строк и размерах файлов.
XTable считывает метаданные исходного формата таблицы, фиксируя всю эту информацию, и переводит ее в целевой формат таблицы. Таким образом, пользователи получают доступ к своим данным в предпочтительном формате и вычислительном механизме, независимо от исходного формата таблицы, в котором были записаны данные. Это избавляет от необходимости переписывать или дублировать данные.
В этом блоге мы рассмотрим простой пример, демонстрирующий, как можно использовать XTable для обеспечения взаимодействия между открытыми форматами таблиц в среде Databricks. Для демонстрации мы будем использовать блокноты Databricks, доступные в составе версии для сообщества. Их можно загрузить отсюда.

Сценарий
Рассмотрим команду специалистов по обработке данных, использующих блокноты Databricks для разработки рабочих процессов машинного обучения. Эти блокноты позволяют легко начать работу с Apache Spark (основным вычислительным движком) и поддерживают соавторство в режиме реального времени, автоматическое версионирование и возможности визуализации данных. Кроме того, в блокноты интегрирован MLFlow, что расширяет возможности отслеживания и проведения экспериментов по машинному обучению. Как правило, эта команда полагается на централизованную инженерную группу платформы данных для предоставления данных в формате таблиц Delta Lake, что достаточно выгодно для экспериментов по машинному обучению благодаря таким функциям, как эволюция схемы, перемещение во времени и версионирование данных. MLFlow автоматически регистрирует результаты каждого эксперимента, привязанного к блокноту, что позволяет специалистам по исследованию данных эффективно отслеживать различные эксперименты и управлять связанными с ними артефактами.
Хотя эта команда в основном работает с таблицами Delta Lake, в некоторых экспериментах для построения надежных ML-моделей ей требуется доступ к наборам данных, хранящимся в других форматах, таких как Apache Hudi или Apache Iceberg . Исторически сложилось так, что команда платформы данных либо дублировала эти наборы данных, чтобы переписать их в Delta Lake, либо проводила разовые миграции. Однако эти методы оказались дорогостоящими и трудоемкими, что часто приводило к застойности данных и неуправляемым копиям.
В чем именно заключается помощь Apache XTable?
Для решения проблемы совместимости форматов таблиц команда платформы данных планирует использовать Apache XTable. Их конечная цель проста - пользователи, в данном случае специалисты по исследованию данных, не должны быть ограничены только доступом к наборам данных Delta, они должны иметь простой способ читать данные любого табличного формата и иметь эту абстракцию без необходимости настройки других форматов или каких-либо других зависимостей.
Таким образом, независимо от того, является ли исходная таблица Hudi, Delta Lake или Iceberg, пользователи могут просто читать набор данных, как если бы это была таблица Delta Lake, используя:
spark.read.format(“delta”).load(“/mnt/mydata/<table_name>”)

Пример из практики
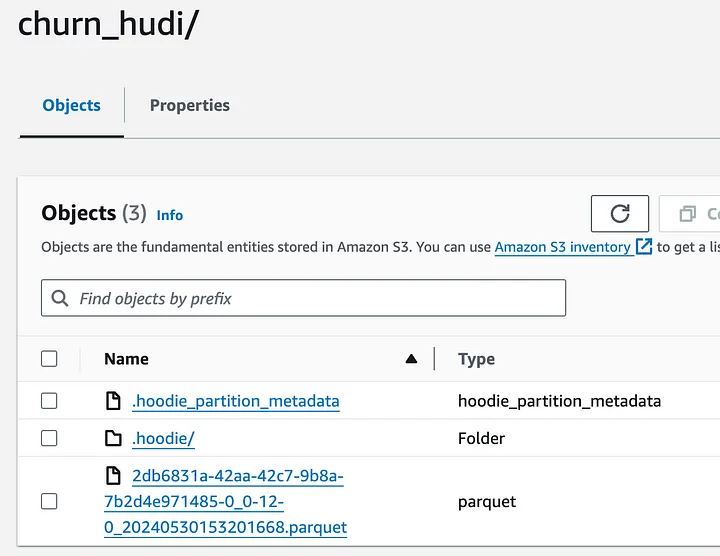
Допустим, команда использует Apache Hudi в качестве формата таблиц Lakehouse. Hudi отлично подходит для сценариев с низкой задержкой, например, для потоковых рабочих нагрузок. Его главным преимуществом является поддержка инкрементной обработки данных и индексирования, что позволяет быстрее вводить и удалять данные в озерах данных. Таблица хранится в озере данных S3 под именем churn_data в папке churn_hudi/, как показано на рисунке ниже.
Теперь другая команда специалистов по науке о данных хочет построить бинарную классификационную модель на основе этого набора данных для анализа поведения клиентов при оттоке. Они также планируют провести серию экспериментов для выявления характеристик, повышающих устойчивость модели, чтобы развернуть ее в производстве. Как упоминалось ранее, этот набор данных, который в настоящее время представлен в формате таблиц Hudi, недоступен для них, поскольку они работают исключительно с таблицами Delta Lake в ноутбуках Databricks. Чтобы устранить этот пробел, мы используем XTable для перевода метаданных из Hudi в Delta Lake.
Чтобы приступить к использованию Apache XTable, начните с клонирования репозитория GitHub в локальное окружение и скомпилируйте все необходимые файлы jar с помощью Maven. Выполните следующую команду, чтобы начать сборку:
mvn clean package
Более подробная информация доступна в официальной документации.
После успешной сборки мы воспользуемся файлом utilities-0.1.0-SNAPSHOT-bundled.jar, чтобы запустить процесс трансляции метаданных.
Далее создайте конфигурационный файл с именем my_config.yaml в клонированном каталоге XTable. Этот файл должен определять детали перевода, структурированные следующим образом:
sourceFormat: HUDI
 targetFormats:
   - DELTA
 datasets:
   - tableBasePath: s3://diplakehouse/churn_hudi/
     tableName: churn_data
В этой конфигурации указывается исходный формат (Hudi), целевой формат (Delta Lake), а также сведения о наборе данных, такие как путь к базе и имя таблицы на S3.
Чтобы запустить процесс перевода, выполните следующую команду:
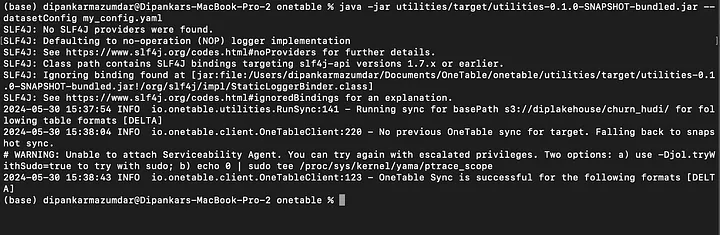
java -jar utilities/target/utilities-0.1.0-SNAPSHOT-bundled.jar --datasetConfig my_config.yaml
После успешного завершения процесса синхронизации мы можем увидеть результат, как показано ниже.
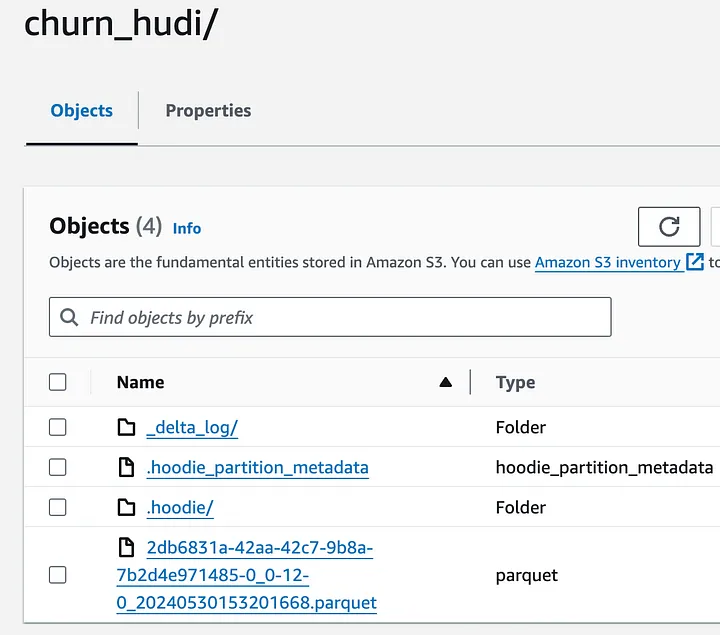
Давайте быстро проверим озеро данных S3.
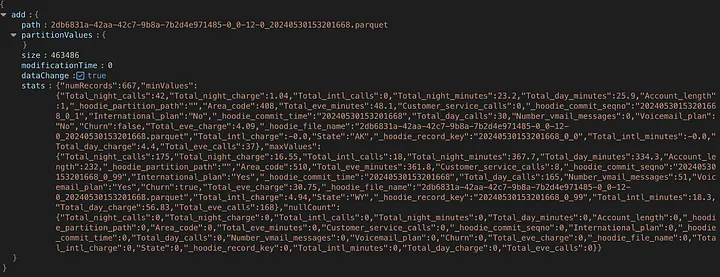
Теперь у нас есть файл метаданных Delta, также называемый журналом транзакций в папке _delta_log/. Эти файлы содержат важную информацию, включая определения схем, историю фиксации, детали партиционирования и статистику столбцов.
Вот фрагмент того, что мы видим в журнале транзакций относительно статистики на уровне файлов.
Теперь, когда метаданные исходных таблиц Hudi переведены в Delta Lake, мы можем перейти в среду Databricks Notebook и начать работу над моделью.
Во-первых, давайте смонтируем озеро данных S3 в DBGS (Databricks File System). Это позволит пользователям взаимодействовать с файлами, хранящимися удаленно, как если бы они были локальными в среде Databricks, что особенно полезно для доступа к большим наборам данных, хранящимся в облачном хранилище, без необходимости дублировать данные в среде Databricks.
dbutils.fs.mount(
   source = "s3a://diplakehouse",
   mount_point = "/mnt/mydatanew",
   extra_configs = {"fs.s3a.access.key": "<access-key>", "fs.s3a.secret.key": "<secret-key>"}
 )
Если мы проверим содержимое нашего озера данных, то вот что мы получим.
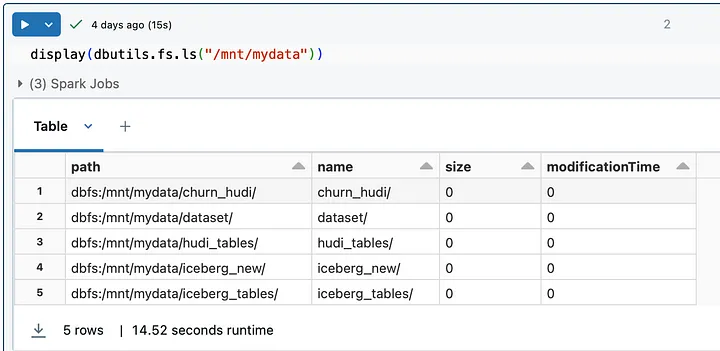
Таблица, которая нас интересует, - это таблица Hudi в каталоге churn_hudi. Поскольку эта таблица теперь транслируется XTable, мы можем читать ее как обычную таблицу Delta.
delta_table = spark.read.format("delta").load("/mnt/mydata/churn_hudi")
Чтобы сделать эту таблицу доступной для метахранилища, давайте зарегистрируем таблицу. Databricks предоставляет встроенное метахранилище Hive, интегрированное со Spark.
spark.sql("""
 CREATE TABLE churn_hudi USING DELTA LOCATION '/mnt/mydata/churn_hudi' """)
Если мы теперь запросим таблицу, то увидим метаполя Hudi вместе с записями набора данных.
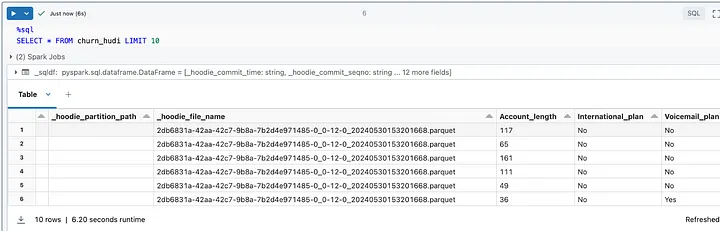
Теперь, в рамках данного эксперимента, мы опустим некоторые характеристики и обучим нашу модель, чтобы посмотреть, как повысится ее точность. В ходе анализа данных и отбора признаков мы определили, что некоторые признаки сильно коррелируют между собой, а другие не являются существенными.
ALTER TABLE churn_hudi DROP COLUMN State, Area_code, Total_day_calls, Total_day_minutes, Total_day_charge, Total_eve_calls, Total_eve_minutes, Total_eve_charge, Total_night_calls, Total_night_minutes, Total_night_charge
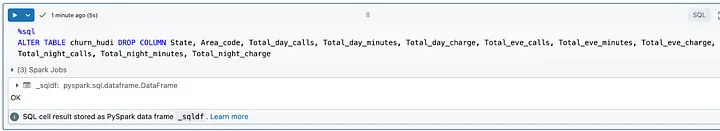
Чтобы посмотреть историю таблицы Delta, мы можем запросить ее с помощью команды DESCRIBE HISTORY. В результате будут представлены все изменения, произошедшие с этой таблицей.
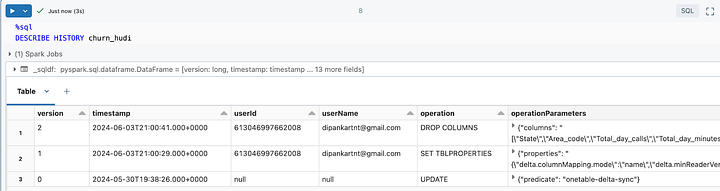
Это может быть очень полезно для выполнения операций с перемещением во времени и обучения ML-моделей на определенных версиях набора данных. Например, обучение новой модели на исходном наборе данных.
Теперь давайте обучим модель классификации на новом наборе данных (только с важными признаками).
df_telco_new = spark.read.table("default.churn_hudi").toPandas()
 # dummy categorical data
 df_telco_new['International_plan']=df_telco_new['International_plan'].replace(['No','Yes'],[0,1])
 df_telco_new['Voicemail_plan']=df_telco_new['Voicemail_plan'].replace(['No','Yes'],[0,1])
 df_telco_new['Churn']=df_telco_new['Churn'].replace(['FALSE', 'TRUE'],[0,1])
 #prepare data
 target = df_telco_new.iloc[: , -1].values
 features = df_telco_new.iloc[: , : -1].values
 target.reshape(-1,1)
 X_train, X_test, y_train, y_test = train_test_split(features, target, test_size=0.20,random_state=101)
 import mlflow.sklearn
 mlflow.sklearn.autolog() with mlflow.start_run():
     # Set the model parameters.
   n_estimators = 600
     # Create and train model.
   rfc = RandomForestClassifier(n_estimators=600)
   rfc.fit(X_train,y_train)   predictions = rfc.predict(X_test) acc                 = accuracy_score(y_test, predictions) classReport         = classification_report(y_test, predictions) confMatrix          = confusion_matrix(y_test, predictions)  print(); print('Evaluation of the trained model: ')
 print(); print('Accuracy : ', acc)
 print(); print('Confusion Matrix :\n', confMatrix)
 print(); print('Classification Report :\n',classReport)
Поскольку у нас уже включен MLFlow, все артефакты и информацию о модели можно просмотреть на вкладке «Experiments».
Вот краткий обзор эксперимента.
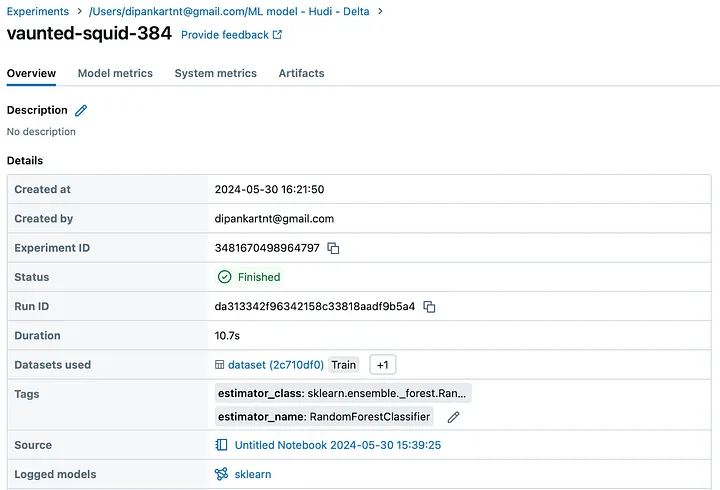
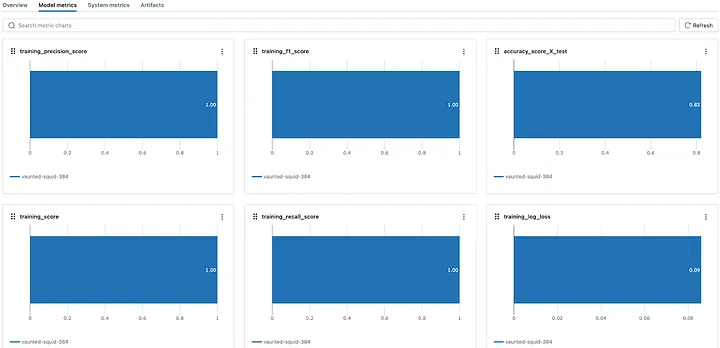
Мы также можем проанализировать важные метрики модели, такие как точность на тестовом наборе, отзыв, потеря журнала и т.д. в представлении «Model Metrics».
В этой статье мы наглядно продемонстрировали Вам практический пример того, как пользователи Databricks могут использовать XTable для обеспечения взаимодействия между форматами Apache Hudi, Iceberg и Delta Lake и построения рабочих процессов ML. Теперь специалисты по науке о данных могут быстро переключаться между тремя форматами таблиц в своей среде Databricks. Такая совместимость не только упрощает аналитические рабочие процессы за счет централизации управления метаданными в едином озере данных S3, но и снижает затраты и обеспечивает доступность данных в разных форматах.


