

Использование GX совместно с dbt
Эта инструкция позволит Вам планировать и запускать пайплайны локально, используя только PostgreSQL (в качестве базы данных), dbt (для преобразования данных), Great Expectations (для качества данных) и Airflow (для оркестровки рабочих процессов). И все это внутри всего лишь одного контейнера с помощью Docker Compose! Предполагается, что Вы уже обладаете базовыми знаниями Python, SQL, Docker и умеете пользоваться CLI. В статье Вы найдете пошаговую инструкцию, касающуюся работы с GX, а также подробные объяснения более сложных процессов.
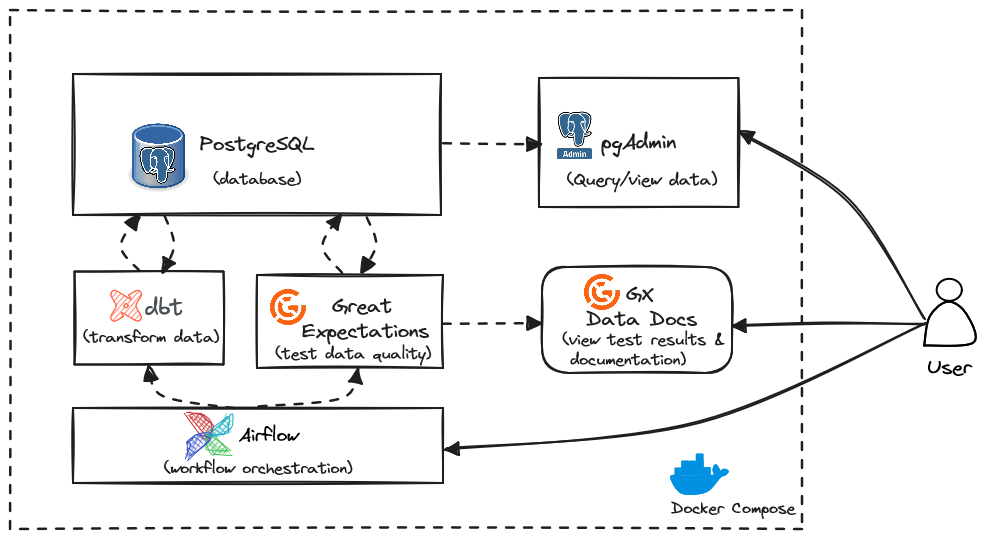
Прежде чем приступить к работе, ознакомьтесь с обзором того, как эти инструменты будут работать вместе. Во-первых, обратите внимание на то, что Вы будете использовать Docker Compose, который позволяет запускать каждый из описанных ниже инструментов/сервисов в отдельных контейнерах Docker, которые, в свою очередь, могут взаимодействовать между собой. Контейнеризация сервисов - это одна из самых лучших и популярных практик, позволяющих настраивать среду для каждого сервиса и реплицировать ее на любой другой машине.
Как уже упоминалось ранее, для хранения данных у Вас будет PostgreSQL, для их преобразования - dbt, для проведения тестов качества данных - Great Expectations, а для организации всего этого процесса - Airflow. Все эти решения являются популярными open source инструментами, которые Вы можете встретить в реальной жизни.
Наконец, для взаимодействия с нашими данными мы будем использовать pgAdmin (для запросов/просмотра, хотя при желании можно использовать и другой инструмент для запросов к базам данных), для просмотра результатов качества данных - документацию по данным Great Expectations, для запуска конвейера – Airflow, а для взаимодействия с несколькими сервисами - CLI.
Необходимые условия
NB: В дополнение к условиям, перечисленным ниже, для организации проекта рекомендуем использовать IDE, например VSCode.
- Владение основами Python, SQL и Docker;
- Умение работать с CLI;
- Docker Desktop;
- ssh-keygen;
- Bash или Zsh

1 Клонирования репозитория GitHub
Откройте окно терминала и перейдите в папку, которую хотите использовать для этого урока. Клонируйте пример репозитория GitHub для этого проекта, применив код, приведенный ниже:
git clone https://github.com/greatexpectationslabs/dbt-tutorial.git
cd dbt-tutorial/tutorial-dbt-gx-airflow
mkdir data
mkdir great-expectations
mkdir ssh-keys
После выполнения действий, описанных выше, структура папок будет следующей:
dbt-tutorial
└── tutorial-dbt-gx-airflow/
├── airflow/
└── .env
├── data/
├── great-expectations/
├── pgadmin-data/
├── ssh-keys/
├── airflow.Dockerfile
Проект содержит следующие файлы:
Файл конфигурации Airflow (airflow/.env)
- Первые 3 переменные в разделе # Meta-Database задают учетные данные PostgreSQL для хранения метаданных Airflow. Обратите внимание, что эта база данных предназначена исключительно для хранения метаданных Airflow. Это не та база данных PostgreSQL, которую Вы будете использовать для хранения фактических данных. Вы должны изменить все имена пользователей и пароли по умолчанию так, как это сделано в производственной среде;
- AIRFLOW__CORE__EXECUTOR : Поскольку Вы будете запускать эту систему локально, она будет настроена на использование LocalExecutor. В производстве обычно используется удаленный исполнитель, например Celery Executor или Kubernetes Executor;
- AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: Это строка подключения к базе метаданных Airflow, о которой говорилось выше. Как и в первом пункте, последние две переменные задают учетные данные, которые понадобятся для входа на веб-сервер Airflow
Докер файл Airflow
- Здесь Вы будете использовать официальное изображение воздушного потока в качестве базового.
Шаблон проекта dbt
- Шаблонный проект jaffle shop был включен с GitHub, который содержит все конфигурационные файлы, необходимые для начала работы, но некоторые настройки были изменены по сравнению с примером проекта.
- Файл .env был добавлен для хранения учетных данных, необходимых для подключения к PostgreSQL.
- Проект dbt был настроен на использование профиля по умолчанию, содержащего учетные данные, необходимые для подключения к нашей базе данных PostgreSQL. Здесь используется синтаксис dbt Jinja для передачи конфиденциальных учетных данных из файла .env.
Докер файл dbt
- Файл dbt.Dockerfile содержит код, который копирует папку dbt в контейнер Docker и устанавливает все необходимые зависимости dbt, включая dbt-postgres. Этот пакет необходим для использования dbt с базой данных PostgreSQL;
- В строке 11 содержатся учетные данные, которые были экспортированы из файла учетных данных при подключении к контейнеру Docker;
- Установлен пакет ssh, который позволит Вам запускать ssh-сервер внутри этого контейнера, чтобы Вы могли подключаться к нему по ssh из других контейнеров. Порт 22 открыт, потому что это порт по умолчанию. Наконец, выполняется команда, сообщающая ssh, что ssh-ключ авторизован, так что Вам не придется иметь дело с запросами на проверку.
Докер файл Great Expectations
Docker получает инструкции по установке нескольких библиотек, необходимых для работы с GX и PostgreSQL.
Compose - файл
В этой статье нет полного объяснения файла Docker Compose. И все же обращаем Ваше внимание на следующее:
- Airflow представляет собой набор из 4 различных сервисов: сервис инициализации (происходит при первом запуске сервиса), веб-сервер, планировщик и бэкенд PostgreSQL, который хранит метаданные о конвейере;
- Для каждого сервиса определяется образ Docker, который нужно использовать, переменные окружения, которые нужно передать в контейнер, и то, какие сервисы зависят друг от друга. Например, служба airflow-postgres должна быть запущена до запуска служб веб-сервера и планировщика;
- В строке 159 для всех служб в этом конвейере задается сеть по умолчанию. В этом разделе имена служб определяются как имя хоста в учетных данных (вместо использования IP-адреса);
- В строке 165 показано, как можно с помощью секретов Docker безопасно передавать ssh-ключи контейнерам в конвейере (мы рекомендуем использовать именно этот шаблон).
2 Генерация ключей SSH
Вам нужно будет сгенерировать пару ключей, которую Вы будете использовать в сервисах Docker для безопасной аутентификации.
В окне терминала в директории tutorial-dbt-gx-airflow выполните следующую команду:
ssh-keygen -t rsa -b 4096 -f ./ssh-keys/id_rsa -N ""
Убедитесь в том, что на данный момент структура Вашего проекта выглядит следующим образом:
dbt-tutorial/
└── tutorial-dbt-gx-airflow/
├── airflow/
└── .env
├── data/
├── dbt/
└── …
├── great expectations/
├── pgadmin-data/
├── ssh-keys/
└── …
├── airflow.Dockerfile
├── dbt.Dockerfile
├── docker-compose.yaml
└── gx.Dockerfile
3 Запуск сервисов в Docker
Убедитесь в том, что запущен рабочий стол Docker, подключите каждый из сервисов с помощью команд, приведенных ниже.
Используя командную строку в каталоге tutorial-dbt-gx-airflow, выполните:
docker compose up -d –build
При первом запуске для загрузки и установки всех необходимых библиотек может потребоваться несколько минут.
NB: Вы увидите, что одна из служб airflow-init завершается сразу после запуска. Это совершенно нормально, поскольку она используется только для инициализации службы Airflow.
Как только все будет готово, Вы увидите следующее:
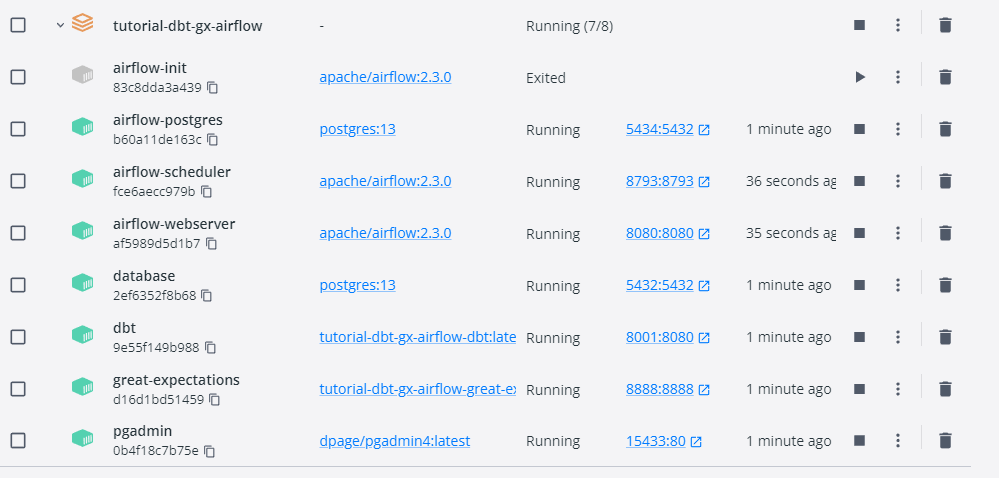
4 Подключение к БД
В этом руководстве для взаимодействия с базой данных PostgreSQL используется pgAdmin, но Вы можете использовать SQL-редактор по своему усмотрению.
Войдите в систему pgAdmin
Откройте pgAdmin, щелкнув на порту службы pgAdmin в Docker Desktop или перейдя на http://localhost:15433 в браузере.

Войдите в систему, используя учетные данные, указанные в Docker Compose для pgAdmin:
- Имя пользователя: example@email.com
- Пароль: postgres
Создайте соединение с PostgreSQL
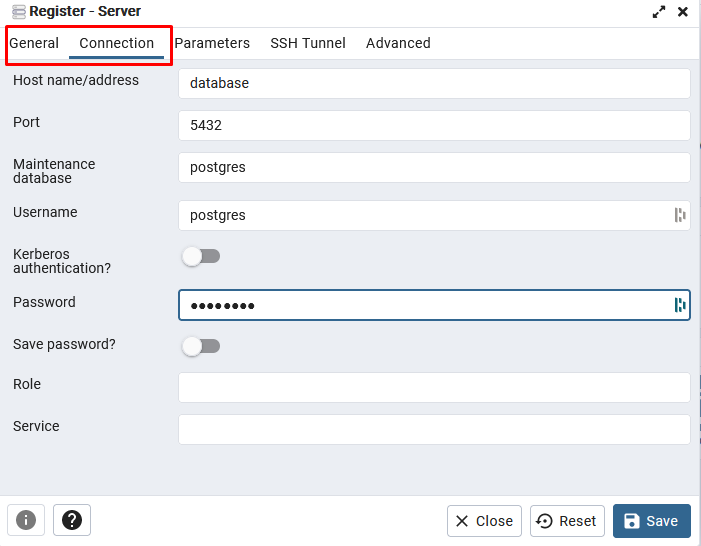
- Щелкните правой кнопкой мыши на Servers в левом верхнем углу и выберите Register > Server.
- Назовите его postgres
-
Перейдите на вкладку Соединение:
- Адрес: БД (refers to the database docker service)
- Логин и пароль: postgres (defined in Docker Compose under database service)
- Сохраните соединение
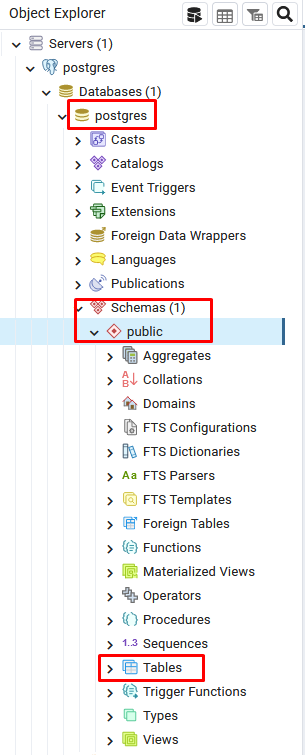
Теперь, если Вы заглянете в раздел public schema > tables, то увидите пустую базу данных.
5 Наполнение базы данных
Проект dbt, включенный в GitHub, содержит некоторые начальные наборы данных в виде seed-файлов. Вы будете импортировать эти seed-файлы в базу данных в виде таблиц, а затем использовать эти таблицы в качестве источника данных для остальных моделей dbt.
Откройте терминал Docker-контейнера dbt, выполнив следующую команду в терминале Вашего проекта:
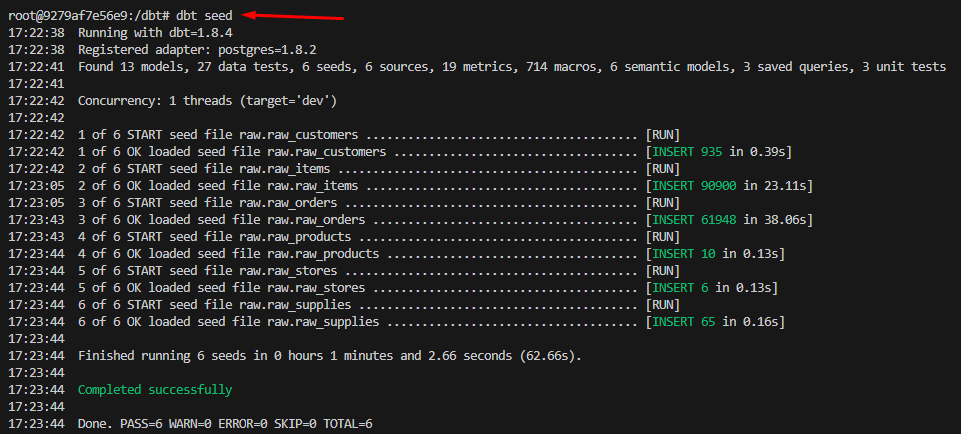
docker exec -it dbt bash –l
NB: Здесь Вы используете команду docker exec, чтобы открыть интерактивный терминал внутри контейнера, используя bash в качестве оболочки. Флаг -l важен, поскольку он указывает оболочке быть оболочкой входа в систему, что автоматически приводит к созданию файла .bashrc в контейнере, который, в свою очередь, экспортирует переменные окружения dbt. Дополнительную информацию см. в файле dbt.Dockerfile.
Затем выполните команду dbt deps для установки зависимостей. Затем скопируйте посевные данные в папку seeds, выполнив команду cp jaffle-data/*.csv, и запустите команду dbt seed для импорта данных в базу данных PostgreSQL. По умолчанию данные будут импортированы в новую схему под названием jaffle_shop_raw. Выполнение этого шага может занять несколько минут.
dbt deps
cp jaffle-data/*.csv seeds
dbt seed
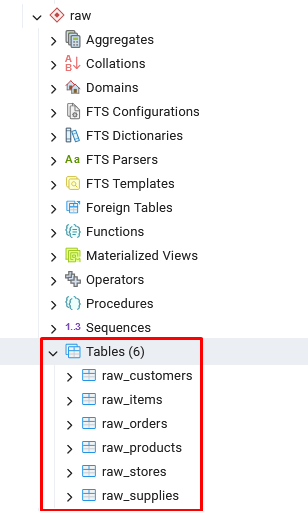
Теперь в pgAdmin Вы можете увидеть вновь созданные таблицы в новой схеме.
Запустите остальные модели dbt, выполнив следующую команду в командной строке службы dbt:
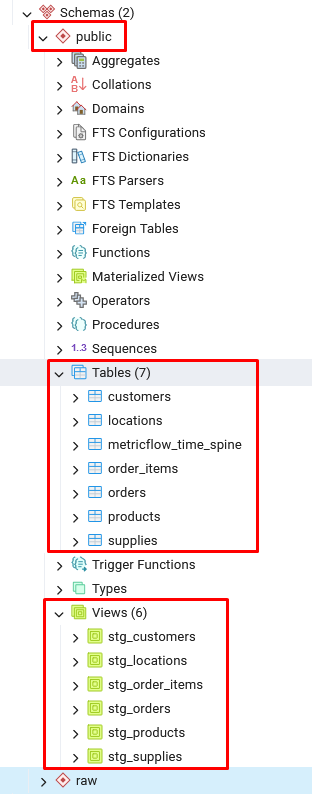
dbt run
Вы увидите, что модели были успешно созданы как таблицы и представления в публичной схеме:
Чтобы выйти из терминала Docker-контейнера dbt, выполните следующую команду:
Exit
6 Используйте Great Expectations для создания тестов качества данных
В следующем разделе Вы, следуя руководству по началу работы, запустите GX с SQL в контейнере Docker. Здесь описан процесс с использованием Jupyter Notebook, хотя Вы можете использовать любой другой инструмент разработки на Python, который Вам больше нравится.
Инициализация сервера Jupyter Notebook
Выполните следующую команду в каталоге проекта, чтобы запустить сервер Jupyter Notebook:
docker exec great-expectations jupyter notebook --allow-root --no-browser --ip=0.0.0.0
Как только он будет запущен, Вы увидите сообщение, похожее на приведенное ниже, и сможете скопировать или щелкнуть на URL-адресе, начинающемся с 127.0.0.1. Токен в конце URL-адреса является уникальным и необходим для доступа к серверу Jupyter Notebook:
Создайте новый блокнот. В левом верхнем углу выберите Файл > Новый > Блокнот. Затем выберите ядро Python 3, если появится запрос.
Создание конфигурации GX
В этом разделе руководства мы покажем, как настроить GX и создать ожидание. Сначала Вы создадите контекст данных для хранения конфигурации GX и создадите новый источник данных (подключение к PostgreSQL). Затем Вы создадите Data Asset, определив таблицу для тестирования: таблица customers в PostgreSQL, ExpectColumnValuesToNotBeNull и ExpectColumnValuesToBeBetween. Наконец, Вы запустите Validations для данных. Скопируйте код в новый блокнот, выполняя каждый фрагмент в отдельной ячейке.
Назовите блокнот customer_expectations.ipynb или любым другим именем по Вашему выбору. Следующие строки кода импортируют модули, необходимые для использования GX, и создают контекст данных. В этом примере конфигурация GX сохраняется в файловой системе.
import great_expectations as gx
import great_expectations.expectations as gxe
from great_expectations.checkpoint import UpdateDataDocsAction

context = gx.get_context(mode="file")
NB: Вы можете нажать кнопку b на клавиатуре или кнопку «Вставить ячейку ниже» в любой ячейке, чтобы создать новую ячейку.
Источник данных - это GX-представление хранилища данных. В этом руководстве используется источник данных PostgreSQL, но Вы можете подключаться и к другим, включая Pandas, Snowflake и Databricks. Актив данных - это GX-представление коллекции записей в источнике данных, которые обычно группируются на основе базовой системы данных. В этом руководстве Вы создаете пакетное определение для всей таблицы customers, но Вы также можете создавать пакеты на основе столбца даты в таблице.
## Connect to your data

PG_CONNECTION_STRING = "postgresql+psycopg2://postgres:postgres@database/postgres"
pg_datasource = context.data_sources.add_postgres(name="pg_datasource", connection_string=PG_CONNECTION_STRING)
asset = pg_datasource.add_table_asset(name="customer_data", table_name="customers")
bd = asset.add_batch_definition_whole_table("BD")
Набор ожиданий - это группа ожиданий, которые описывают, как следует тестировать данные. Определение проверки связывает набор ожиданий с данными, которые он описывает, через определение пакета, которое Вы создали на предыдущем шаге. Затем Вы можете добавить Ожидания в набор ожиданий. В этом примере Вы создаете ожидание для проверки того, что значения столбца customer_id никогда не бывают null. Отдельно создается ожидание, проверяющее, что значения столбца lifetime_spend находятся в диапазоне от 0 до 100000. Просмотрите галерею ожиданий, чтобы узнать обо всех доступных ожиданиях, которые Вы можете использовать для получения информации о Ваших данных.
## Create Expectations
suite = context.suites.add(gx.ExpectationSuite("Suite"))
vd = gx.ValidationDefinition(
name="Validation Definition",
data=bd,
suite=suite
)

context.validation_definitions.add(vd)
suite.add_expectation(gxe.ExpectColumnValuesToNotBeNull(column="customer_id"))
suite.add_expectation(gxe.ExpectColumnValuesToBeBetween(column="lifetime_spend", min_value=0, max_value=100000))
Контрольная точка - это объект, который группирует определения проверки и запускает их с общими параметрами и автоматическими действиями. Контрольные точки являются основным средством проверки данных в производственном развертывании Great Expectations. В этом руководстве Вы обновите Data Docs - статический веб-сайт, созданный на основе метаданных Great Expectations с подробным описанием ожиданий, результатов проверки и т. д.
## Validate your data
checkpoint = context.checkpoints.add(gx.Checkpoint(
name="Checkpoint",
validation_definitions=[vd],
actions=[
UpdateDataDocsAction(name="update_data_docs")
]
))

checkpoint_result = checkpoint.run()
Просмотреть результаты ожиданий в Data Docs
Просмотрите результаты проверки, перейдя по URL-адресу здесь: http://127.0.0.1:8888/edit/gx/uncommitted/data_docs/local_site/index.html
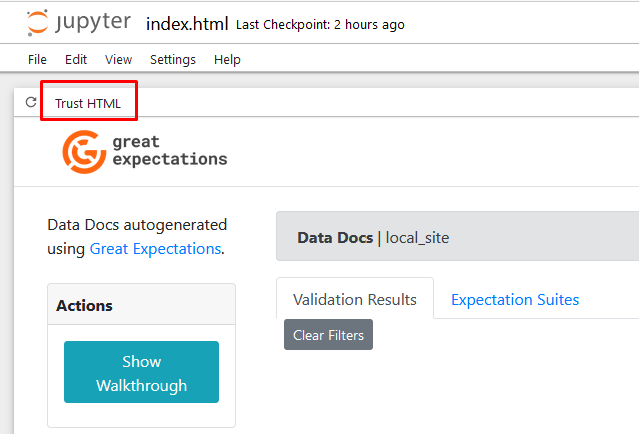
Вы можете увидеть, что два созданных Вами Ожидания прошли. Просмотрите Ожидания в столбце состояния. В столбце «Наблюдаемое значение» отображаются все значения, которые вышли за пределы ожидаемого диапазона.
7 Создайте пайплайн и автоматизируйте его с помощью Airflow
В заключительной части этого урока Вы автоматизируете описанный выше процесс с помощью конвейера или группы DAG в инструменте оркестровки рабочих процессов Airflow. Вы создадите простой пайплайн, используя общий шаблон write-audit-publish.
Попробуйте использовать Great Expectations Airflow Provider.
Войдите в систему Airflow
Откройте в своем браузере http://localhost:8080. Вы можете использовать имя пользователя и пароль, созданные ранее на этапе настройки. Имя пользователя = airflow; пароль = airflow
И Вы увидите пустую панель DAG:
Создайте группу DAG и добавьте соединение
Создайте новую группу Airflow DAG с помощью команды в корне каталога Вашего проекта:
touch airflow/dags/customers_dag.py
Скопируйте приведенное ниже содержимое в новый файл DAG:
from datetime import datetime
from airflow import DAG
from airflow.providers.ssh.operators.ssh import SSHOperator
from airflow.providers.ssh.hooks.ssh import SSHHook
from airflow.operators.python import PythonOperator
import great_expectations as gx

sshHook = SSHHook(ssh_conn_id="dbt-ssh", cmd_timeout=None)

def run_gx_checkpoint():
context = gx.get_context(mode="file", project_root_dir="../../great-expectations/")
context.checkpoints.get("Checkpoint").run()

with DAG(
dag_id='customers_dag',
start_date=datetime(2023, 11, 10),
schedule_interval=None
) as dag:

write_data = SSHOperator(
task_id='write_data',
command="dbt seed",
ssh_hook=sshHook,
)

gx_run_audit = PythonOperator(
task_id="gx_run_audit",
python_callable=run_gx_checkpoint
)

dbt_publish_model = SSHOperator(
task_id='dbt_publish_model',
command="dbt run",
ssh_hook=sshHook,
)

write_data >> gx_run_audit >> dbt_publish_model
Этот файл DAG содержит описанный выше процесс, однако выполнение контрольной точки GX - это просто загрузка ранее созданного контекста данных и запуск сохраненной контрольной точки.
Через несколько минут в Airflow появится новый пайплайн. Затем Вы получите следующую ошибку:
Broken DAG: [/opt/airflow/dags/customers_dag.py] Traceback (most recent call last):
File "home/airflow/.local/lib/python3.11/site-packages/airflow/hooks/base.py", line 67, in get_connection
conn = Connection.get_connection_from_secrets(conn_id)
File "/home/airflow/.local/lib/python3.11/site-packages/airflow/models/connection.py", line 430, in get_connect_from_secrets
raise AirflowNotFoundException(f"The conn_id `{conn_id}` isn't defined")
airflow.exceptions.AirflowNotFoundException: The conn id `dbt-ssd` isn't defined
Следующие шаги - создание нового dbt-соединения и добавление учетных данных для базы данных PostgreSQL.
Добавление учетных данных dbt-ssh:
- В Airflow нажмите
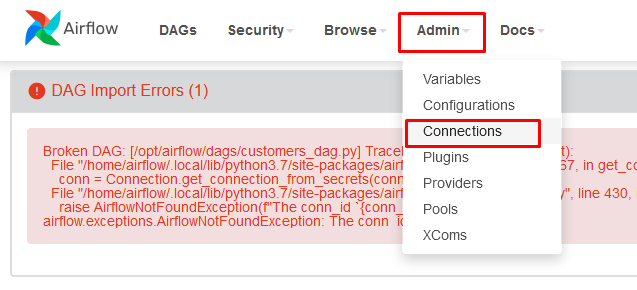
- Нажмите на +, чтобы добавить новую запись
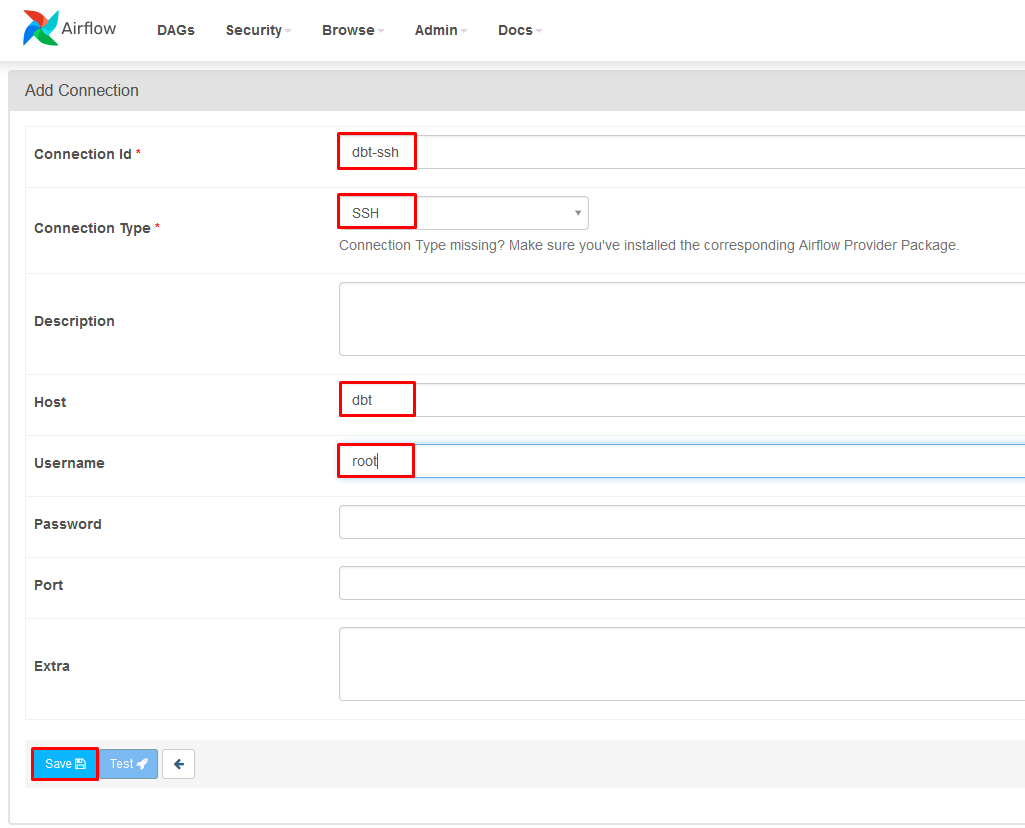
- Заполните соединение, используя следующее:
- Идентификатор соединения: dbt-ssh
- Тип соединения: SSH
- Хост: dbt
- Имя пользователя: root
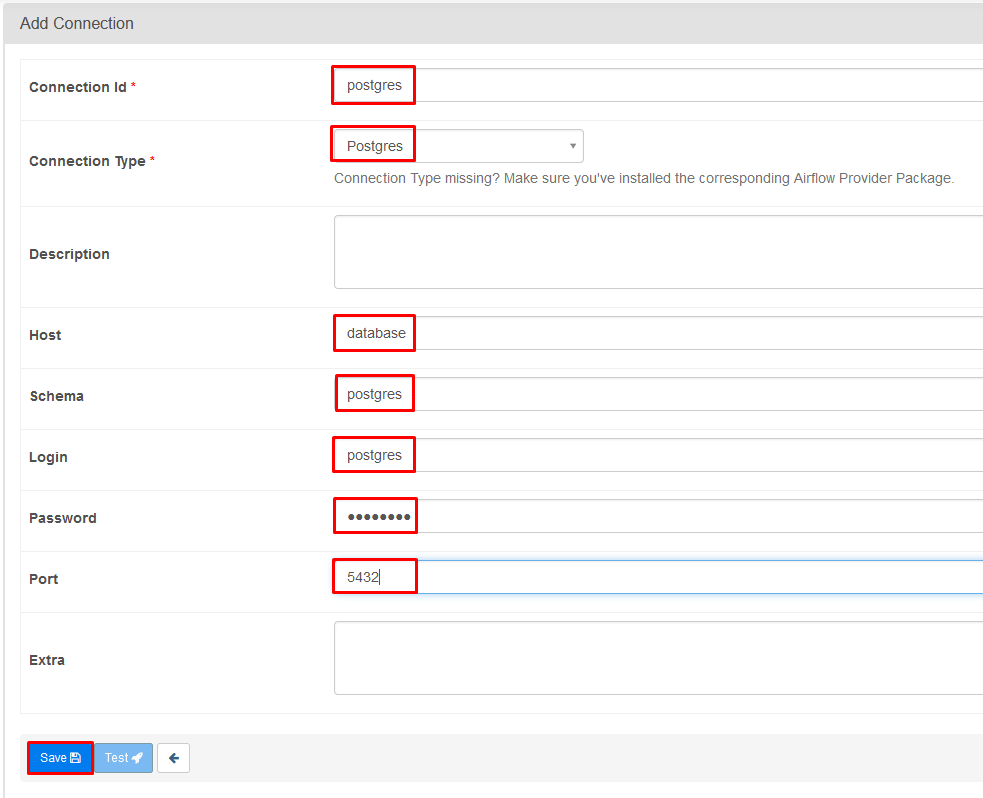
Добавьте учетные данные Postgres:
- В разделе Admin > Connections нажмите +, чтобы добавить новую запись.
- Заполните соединение следующим образом:
- Идентификатор соединения: postgres
- Тип соединения: Postgres
- Хост: база данных
- База данных: postgres
- Логин: postgres
- Пароль: postgres
- Порт: 5432
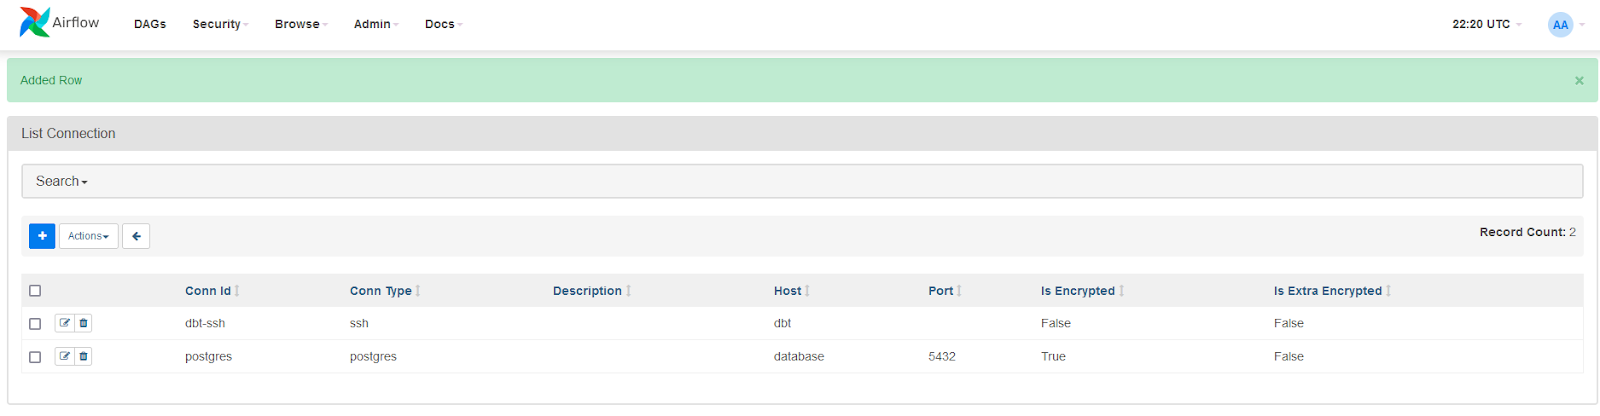
Теперь Ваша страница соединений будет выглядеть следующим образом:
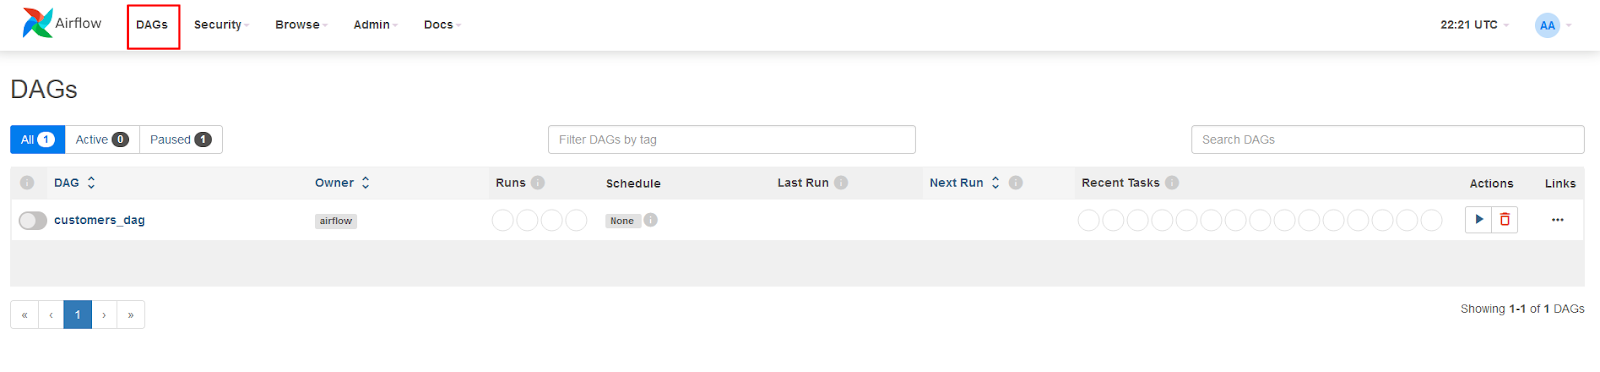
Теперь на странице групп DAGs Вы увидите список customers_dag:
Запустите DAG
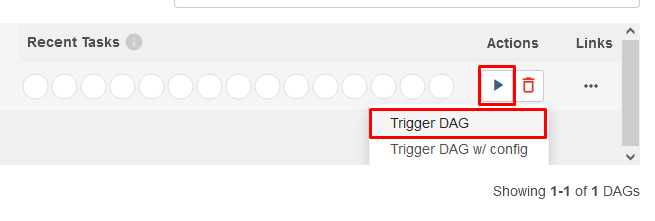
Запустите группу DAG, перейдя в раздел Actions и нажав кнопку воспроизведения. Затем выберите Trigger DAG.
NB: Если Вы видите ошибку «Задача завершилась с кодом возврата Negsignal.SIGKILL», это обычно означает, что Airflow не хватает ресурсов для запуска. Airflow рекомендует использовать 4 ГБ памяти. Убедитесь, что ресурсы Docker настроены соответствующим образом (Docker Desktop > Settings > Resources).
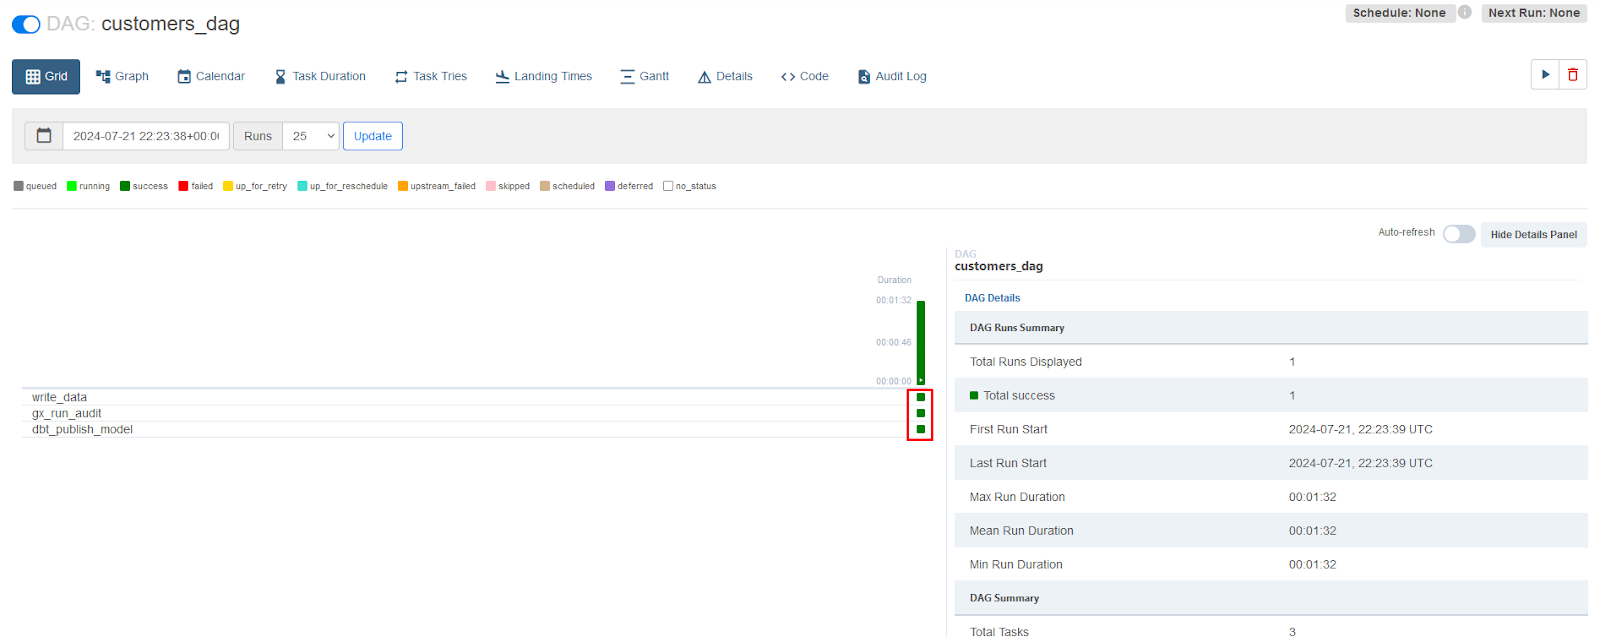
Вы можете щелкнуть на имени группы DAG, чтобы проследить за ее работой и дождаться ее завершения:
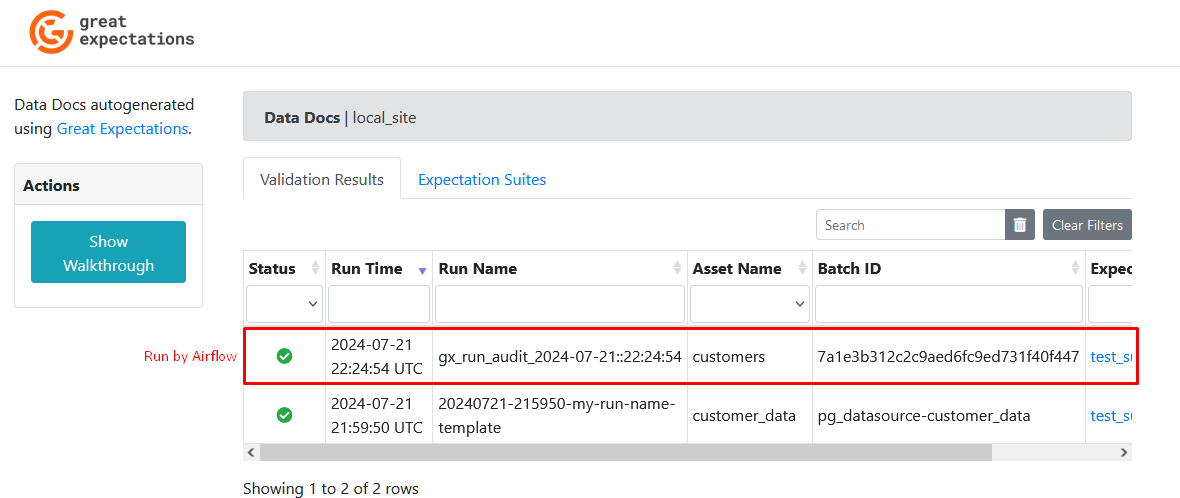
Обновите страницу Data Docs, чтобы увидеть новые результаты работы группы DAG:
Заключение
Итак, теперь Вы умеете создавать пайплайны с помощью PostgreSQL, dbt, GX и Airflow. В этой статье мы поговорили о таких темах, как базовая реализация планирования и запуск конвейера данных с помощью open-source инструментов. Вы можете изучить и другие возможности GX, подключившись к собственным источникам данных или рассмотрев другие примеры, приведенные в данной статье. Ознакомьтесь со всем спектром ожиданий, чтобы знать обо всех ожиданиях, которые Вы можете запустить на своих данных.


