

Обработка данных. Архитектурные шаблоны
Рассмотрим обработку данных - фундаментальный процесс, который объединяет операционный и аналитический миры. Прием данных имеет решающее значение для передачи данных из множества источников в их первоначальной операционной среде, которую часто называют "операционной плоскостью", в сферу анализа, или "аналитическую плоскость". Этот переход необходим для раскрытия всего потенциала аналитических возможностей.
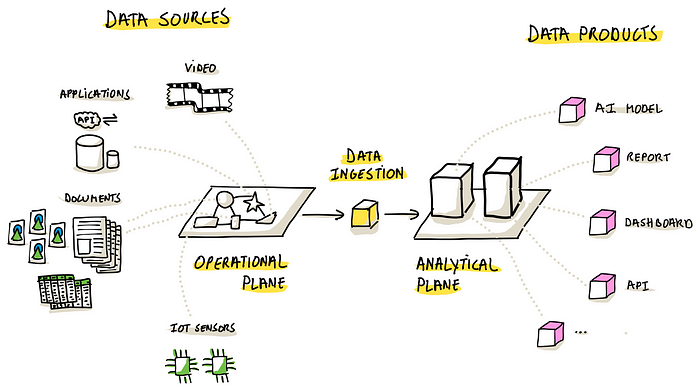
Обработка данных служит важнейшим связующим звеном между операционным уровнем, откуда берутся данные, и аналитическим уровнем, где данные преобразуются в аналитические продукты, такие как модели искусственного интеллекта, информационные панели и API (изображение предоставлено: Автор).
Суть этого расширения прав и возможностей заключается в способности генерировать аналитические данные на основе данных и внедрять модели искусственного интеллекта, опираясь на широкий спектр источников данных. Аналитический потенциал организации часто напрямую зависит от количества источников данных, которые она может эффективно анализировать. Поэтому выбор правильных стратегий обработки данных имеет решающее значение. Эти стратегии должны быть достаточно надежными, чтобы работать с широким спектром релевантных источников данных, от стандартных операционных приложений, таких как CRM, ERP и финансовые системы, до более нетрадиционных, таких как датчики Интернета вещей, API, и различных форматов, таких как документы, изображения и видео.
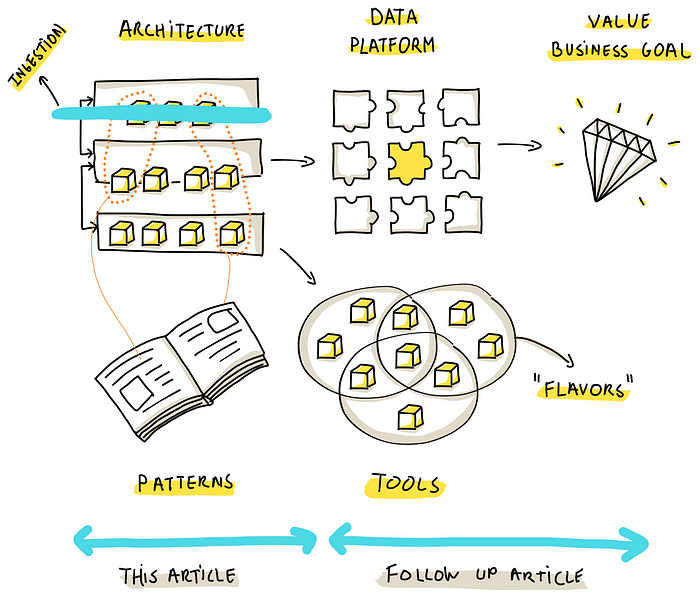
Обработка данных является ключевым элементом более широкой платформы обработки данных. Выбор стратегий обработки зависит от базовых архитектурных решений и может быть реализован с помощью различных инструментов. (Изображение: Автор).
Если взглянуть на ситуацию шире, становится ясно, что использование данных, хотя и является лишь одним из элементов, является важнейшим компонентом общей платформы данных в организации. Эта платформа данных обычно служит краеугольным камнем в инициативах по цифровой трансформации, помогая организациям в достижении их бизнес-целей. По своей сути платформа обработки данных включает в себя различные архитектурные модели и множество инструментов, каждый из которых играет важную роль в ее функциональности и эффективности.

В первой из двух статей, посвященных обработке данных, рассматриваются архитектурные парадигмы, которые определяют выбор подходящей технологии обработки данных. Моя цель - раскрыть суть каждого шаблона, пролив свет на стратегические последствия, которые они имеют для процесса обработки данных. Цель, стоящая за представлением этих моделей, состоит в том, чтобы выявить и преодолеть препятствия, которые часто усложняют то, что теоретически должно быть самой простой, но абсолютно необходимой задачей: интеграцию данных в вашу аналитическую систему. Понимание стратегической важности получения данных необходимо для обеспечения плавного перехода и эффективного использования данных в обширной информационной экосистеме организации.
Схема 1: Единое хранилище данных
Первый архитектурный подход, который мы рассмотрим, - это модель унифицированного хранилища данных, при которой единая система хранения данных удовлетворяет как потребности операционных приложений, так и аналитическую обработку. Как правило, такая система представляет собой систему управления реляционными базами данных (СУБД). При такой настройке одна и та же база данных используется как для повседневных операций, так и для анализа данных, что устраняет необходимость в передаче данных между различными решениями для хранения.
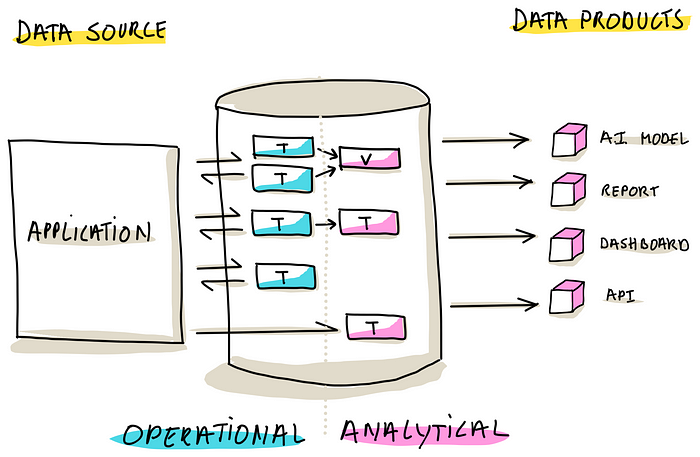
Единое хранилище данных удовлетворяет требованиям операционных приложений и поддерживает аналитическую обработку. Аналитические данные генерируются с помощью виртуализации, использования представлений или путем дублирования и преобразования данных (использование изображений: Автор).
В рамках этого подхода существуют две распространенные подсистемы:
- Виртуализация — это создание виртуальных уровней базы данных, или представлений, которые обеспечивают аналитическую перспективу поверх операционных таблиц в базе данных. Это способ ‘увидеть" данные через аналитическую призму без физического изменения или дублирования данных.
- Дублирование и преобразование — здесь оперативные данные реплицируются в формате, более удобном для анализа. Это может быть реализовано с помощью хранимых процедур, материализованных представлений или непосредственно на уровне хранилища операционного приложения, что позволяет эффективно создавать параллельную версию данных, оптимизированную для аналитических запросов.
Хотя эта модель обеспечивает простоту управления данными и доступность необработанных данных, у нее есть существенные ограничения:
- Проблемы интеграции данных — Модель по своей сути сталкивается с трудностями при интеграции данных из разрозненных физических баз данных, поскольку она опирается на единую систему хранения. Чтобы преодолеть это, можно было бы прибегнуть к таким методам, как связанные серверы или запросы к разным базам данных, которые, однако, как правило, создают дополнительную сложность и, как правило, нежелательны.
- Возможность системного взаимодействия — Одновременная работа операционных и аналитических процессов с одной и той же базой данных может вызвать взаимные помехи, что приведет к увеличению нагрузки и потенциальному снижению производительности как операционных приложений, так и аналитической обработки.
- Компромиссы в отношении производительности — Различные потребности в оптимизации систем онлайн-обработки транзакций (OLTP), которые отдают приоритет эффективной обработке больших объемов транзакций, и систем онлайн-аналитической обработки (OLAP), которые оптимизированы для обработки сложных запросов, означают, что система, которая пытается выполнять обе задачи, скорее всего, будет неоптимальной для каждой задачи.
- Тесная взаимосвязь — модель единого хранилища данных обеспечивает тесную взаимосвязь между операционной и аналитической областями, что приводит к ограниченной гибкости или ее отсутствию в любой из этих областей.
Учитывая эти ограничения, подход к единому хранилищу данных, как правило, не рекомендуется для работы с большими наборами данных или при работе с несколькими физическими источниками данных. Это может подойти для приложений меньшего масштаба, работающих с надежной базой данных, где масштаб не зависит от сложности.
Схема 2: Виртуализация данных
Подход к виртуализации данных, основанный на первоначальной схеме, использует специализированное программное обеспечение для создания виртуализированного уровня данных над несколькими базовыми источниками данных. Этот промежуточный уровень позволяет выполнять запросы, которые частично обрабатываются исходными источниками данных, интегрируя результаты в единый набор данных для анализа.
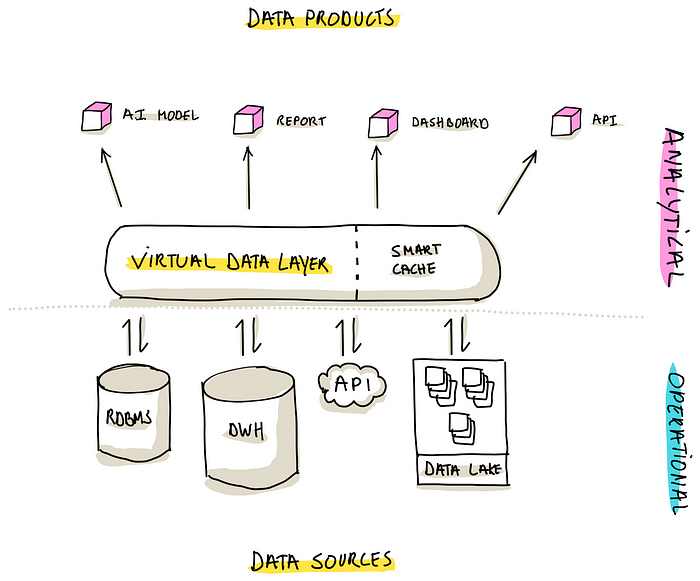
Виртуализированный уровень обработки данных управляет выполнением запросов в режиме реального времени по целому ряду базовых источников данных (изображение предоставлено: Автор).
Основные преимущества этого подхода включают:
- Интеллектуальное кэширование — системы виртуализации данных, как правило, разрабатываются с расширенными возможностями кэширования, что позволяет минимизировать нагрузку на исходные системы и оптимизировать производительность.
- Доступ к данным практически в режиме реального времени — Поскольку данные физически не перемещаются в аналитическую базу данных, а запрашиваются непосредственно у источника, эта схема обеспечивает быструю доступность данных, максимально приближенную к реальному времени.
Однако такой подход также вызывает ряд проблем:
- Ограничения исходной системы — если исходные базы данных не оптимизированы для определенных типов запросов, их производительность может быть снижена до виртуального уровня, особенно если выполнение запросов зависит от ответов источника.
- Сетевые издержки — уровень виртуализации, который взаимодействует с источниками данных, распределенными по различным сетевым зонам, может испытывать задержки, что влияет на общую производительность.
- Отслеживание исторических данных — поскольку виртуальный уровень по своей сути не предназначен для хранения данных, он создает проблемы для анализа исторических данных, обычно называемого “путешествием во времени”, на временной шкале получения данных.
Важно отметить, что конкретные решения для виртуализации данных могут предлагать уникальные механизмы для решения этих проблем. Моя главная рекомендация для любого важного архитектурного решения, включая это, заключается в тщательном тестировании решения для виртуализации данных в вашей конкретной инфраструктуре. Это поможет понять его возможности и ограничения, что позволит оптимизировать масштабирование и тонкую настройку для оптимизации процессов интеграции и анализа.
Схема 3: ETL
ETL, что означает "Извлекать, преобразовывать, загружать", представляет собой хорошо зарекомендовавшую себя парадигму в обработке данных. Первоначально данные извлекаются из источника (Extract), затем обрабатываются на сервере ETL (Transform), и, в конечном счете, обработанный результат помещается в базу данных, ориентированную на аналитику (Load).
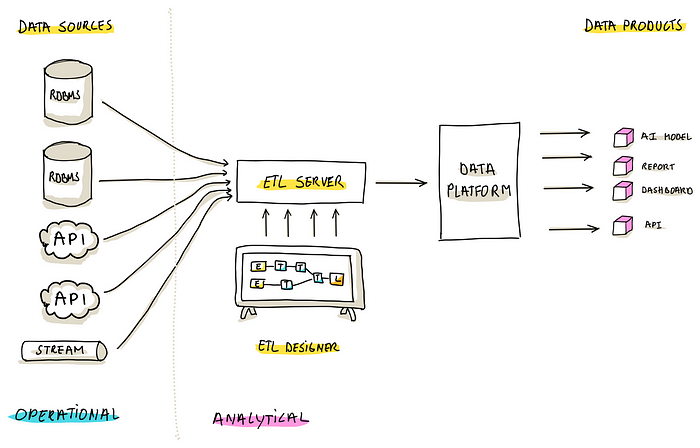
Серверы ETL выполняют процессы ETL, настроенные в интерфейсе проектирования. Эти конвейеры управляют извлечением данных из источников, их преобразованием в формат, подходящий для анализа, и их последующей загрузкой в платформу данных, такую как хранилище данных или оперативное хранилище данных. Информационные продукты, как правило, получают доступ к информации, хранящейся на этих платформах, и используют ее (ссылка на изображение: Автор).
На протяжении многих лет множество поставщиков инструментов ETL поддерживали этот метод, предлагая различные специализированные методы преобразования и стили дизайна. Преобладающий стиль предполагает использование графического интерфейса, в котором пользователи могут связывать операции извлечения, преобразования и загрузки в рамках интуитивно понятного визуального рабочего процесса. Эти процессы часто дополнительно настраиваются с помощью сценариев или прямых SQL-запросов.
К основным преимуществам ETL относятся:
- Централизованная логика — процессы ETL позволяют объединить всю логику преобразования в единой управляемой среде, тем самым не только облегчая прием данных, но и формируя их в соответствии с аналитическими требованиями.
- Удобный дизайн — визуальный характер инструментов ETL упрощает процесс преобразования данных, позволяя пользователям разных уровней квалификации участвовать в создании конвейера данных.
Однако ETL не лишен недостатков, которые привели к появлению альтернативных моделей:
- Зависимость от конкретных поставщиков — зависимость от инструментов ETL может привести к определенной форме привязки к поставщикам, что делает переход на другие платформы дорогостоящим и сложным, особенно если в текущем инструменте изменяются цены или прекращаются функции.
- Ограничения по производительности — преобразования ETL выполняются назначенными серверами, которые могут не соответствовать масштабируемости высокопроизводительных вычислительных ресурсов, доступных в современных хранилищах данных, и, таким образом, становятся потенциальными узкими местами. Этот сценарий представляет собой парадокс: несмотря на наличие высокоэффективного механизма хранилища данных для выполнения запросов, пропускная способность всего конвейера регулируется сервером ETL, который обрабатывает преобразования значительно медленнее.
- Непрозрачная структура данных — упрощение с помощью визуальных компонентов часто скрывает сложность преобразования данных, затрудняя понимание и аудит процесса передачи данных (data lineage) для тех, кто не использует среду инструментов ETL.
- Ограниченная масштабируемость — хотя инструменты ETL предназначены для обеспечения широкого доступа, им может не хватать надежных возможностей для масштабирования и индустриализации (как, например, описано в DataOps frameworks), которые имеют решающее значение по мере роста платформ обработки данных.
- Жесткость — Негибкость возникает, когда инструменты ETL не могут удовлетворить уникальные требования к обработке данных, что приводит к поиску обходных решений, которые приводят к увеличению технической задолженности.
Эти общие ограничения модели ETL часто могут быть устранены конкретными поставщиками ETL. В частности, когда инструменты ETL интегрированы в комплексные пакеты, разработанные для конкретного облачного хранилища данных, проблемы, связанные со скоростью и производительностью, могут быть устранены. Тем не менее, важно быть на шаг впереди в понимании траектории развития инструмента ETL, следя за тем, чтобы он соответствовал меняющимся требованиям к обработке данных, таким как растущие объемы данных или новые типы источников данных.
Схема 4: ELT
ELT, использующий основные этапы ETL, отличается реструктуризацией и переосмыслением этих процессов. В ELT:
- Сначала выполняются операции извлечения и загрузки EL —данных, которые передают необработанные данные непосредственно на платформу данных без немедленного преобразования.
- Затем происходит Т— преобразование, преобразующее необработанные данные в полезную информацию. Важно отметить, что задачи преобразования могут выполняться независимо и по разным графикам, начиная с извлечения и загрузки.
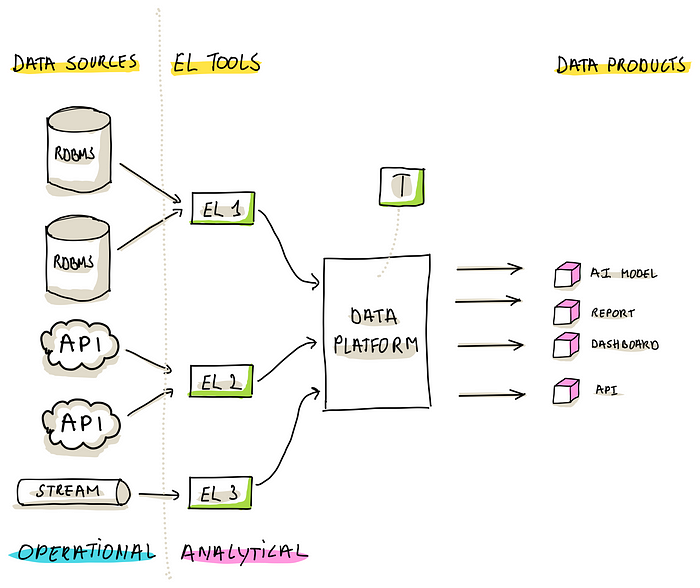
Конвейеры ELT разделены на два отдельных сегмента: компонент EL, который обрабатывает ввод данных в платформу данных, и компонент преобразования, который выполняется в платформе данных для обработки и уточнения данных (изображение предоставлено: Автор).
Этот реструктурированный процесс устраняет несколько ограничений ETL:
- Повышенная гибкость — разделение функций извлечения/загрузки и инструментов преобразования повышает адаптивность, позволяя выбирать разнообразные инструменты для различных типов данных и стандартов преобразования.
- Согласованная производительность — преобразование выполняется в рамках платформы данных, используя всю ее вычислительную мощность, и особенно эффективно для обработки больших массивов данных с помощью распределенных вычислительных механизмов.
- Улучшенная масштабируемость — гибкость, присущая ELT, облегчает выбор инструментов преобразования, которые отличаются превосходными показателями автоматизации и масштабируемости.
Несмотря на эти улучшения, модель ELT представляет новые сложности:
- Управление несколькими инструментами — использование различных инструментов для извлечения, загрузки и преобразования требует строгого управления лицензированием, ценообразованием, циклами обновления и структурами поддержки.
- Проблемы оркестровки — Более разнообразный инструментарий требует сложной оркестровки, часто основанной на направленных ациклических графах (DAG), чтобы гарантировать, что преобразования будут выполняться только после успешного извлечения и загрузки данных.
Шаблон ELT является любимым из-за своей гибкости, но он требует приверженности управлению мультиинструментальным ландшафтом и сложной стратегии согласования.
Новые шаблоны
Помимо устоявшихся шаблонов, постоянно появляются новые методологии и шаблоны. В этом разделе рассматриваются две такие новые модели: push и потоковая обработка.
Push (в отличие от Pull)
Традиционные модели, упомянутые ранее, как правило, относятся к типу “Pull”, когда аналитическая плоскость активно извлекает данные из операционной плоскости. В отличие от этого, методологии “Push” инвертируют этот поток: оперативный уровень заблаговременно отправляет или "выталкивает" данные в аналитический уровень, как только происходят изменения, такие как операции создания, чтения, обновления и удаления (CRUD).
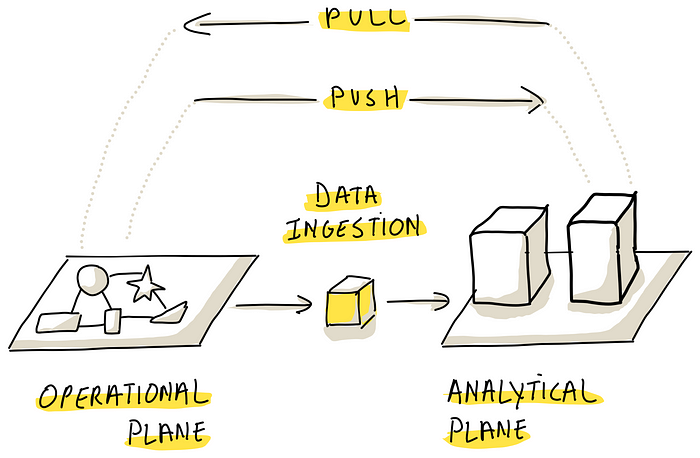
В то время как традиционные модели основаны на стратегии “вытягивания”, в определенных ситуациях может быть целесообразным “подталкивание” (ссылка на изображение: Автор).
Push-подход часто встречается в архитектурах потоковой передачи данных (обсуждается далее), но не ограничивается ими. По сути, он включает в себя операционную плоскость, инициирующую передачу данных в конечную точку, обозначенную аналитической плоскостью. При такой настройке обычно требуется, чтобы команды разработчиков внедрили механизм push либо с помощью отдельных компонентов, либо путем улучшения существующих операционных приложений.
Основное преимущество этого подхода заключается в том, что он позволяет аналитическим командам сосредоточиться на преобразовании значений данных, не отвлекаясь на создание конвейеров приема — операционные системы заботятся о доставке данных. Однако есть два существенных недостатка:
- Требуется специальная команда разработчиков приложений — Это становится проблематичным при использовании готового программного обеспечения, предложений "Программное обеспечение как услуга" (SaaS) или внешнего оборудования, такого как устройства Интернета вещей, где такая команда может отсутствовать или быть недоступной. В таких обстоятельствах может потребоваться создание специализированной "команды по интеграции данных" для облегчения внедрения в аналитическую среду, но это может быстро превратиться в узкое место.
- Обработка отказов при внедрении — архитектуры, основанные на использовании Pull, обычно демонстрируют большую устойчивость к сбоям в работе конвейера по сравнению с архитектурами, основанными на push. В случае сбоя push-запроса аналитическая платформа может повторно запустить процесс. Однако в случае сбоя push-запроса аналитическая платформа может не знать о пропавшем push-сообщении. Чтобы устранить этот недостаток, конвейеры на основе push часто встраиваются в архитектуры потоковой передачи данных с высокой доступностью, предназначенные для параллельной работы и надежной доступности.
Схема push наиболее подходит для организаций, которые имеют высокий уровень разработки программного обеспечения и/или могут согласовать возможности передачи данных при приобретении готовых решений. В тех случаях, когда это нецелесообразно, было бы разумно сочетать push с другими схемами обработки данных, чтобы обеспечить плавную и эффективную интеграцию данных.
Потоковая обработка
Потоковая обработка, также известная как потоковая обработка или потоковая передача событий, представляет собой непрерывный поток генерируемых данных, позволяющий обрабатывать и анализировать их в режиме реального времени для получения мгновенной информации. Эти системы имеют решающее значение для мгновенного принятия решений и поддерживают обработку большого объема данных с низкой задержкой для таких операций, как финансовые сделки, аналитика в режиме реального времени и мониторинг Интернета вещей.
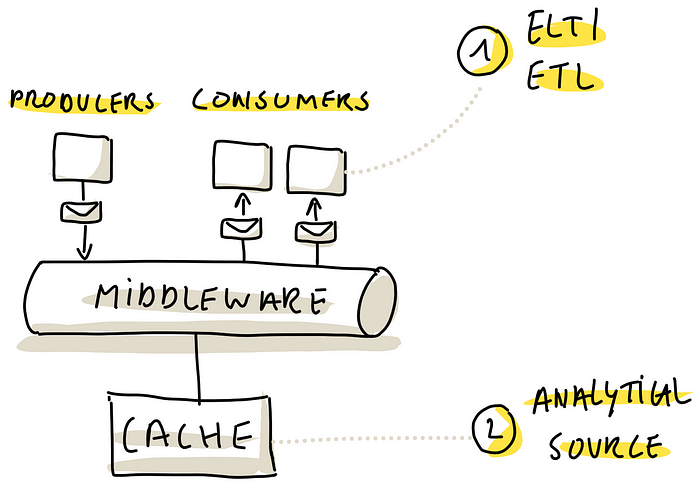
В общем, потоковое промежуточное программное обеспечение может использоваться для облегчения приема данных двумя способами: (1) с помощью пользователя ETL/ELT, который получает потоковые сообщения и отправляет их в аналитическую плоскость, или (2) используя потоковый кэш в качестве источника аналитики (изображение предоставлено: Автор).
При объединении потоковой обработки с аналитикой выделяются два подхода:
- Адаптация ELT (или даже ETL) для потоковой передачи данных — это включает в себя извлечение событий в реальном времени и загрузку их в платформы данных, сохраняя привычные рабочие процессы с использованием новых источников данных через заказных или специализированных пользователей потоковой передачи.
- Использование потоковых кэшей — Централизованные, надежные потоковые кэши служат высокопроизводительным хранилищем данных о событиях. Некоторые новые шаблоны используют эти кэши аналитически, создавая современный и эффективный вариант совместного хранения данных. Важным фактором здесь является интеграция потоковых данных со статическими источниками данных, которые могут никогда не пройти через потоковый кэш.
Объединение потоковых данных и большего количества статических данных реализуется в таких шаблонах архитектуры данных, как KAPPA и LAMBDA. Эти две архитектуры позволяют объединить оба мира (при необходимости).
Выводы
Стратегическая интеграция методов сбора данных является краеугольным камнем в развивающемся ландшафте анализа данных. В этой статье были рассмотрены четыре основных способа обработки данных — унифицированное хранилище данных, виртуализация данных, ETL и ELT, — каждый из которых обладает уникальными преимуществами и ограничениями. Проанализировав эти шаблоны, мы увидели простоту Единого хранилища данных, но ограниченную масштабируемость, возможность виртуализации данных практически в режиме реального времени при потенциальной потере производительности, централизованное управление ETL, за которым скрываются потенциальные узкие места и жесткость, а также гибкость и масштабируемость ELT, сбалансированные с проблемами оркестровки.
Кроме того, новые парадигмы потоковой обработки данных подчеркивают стремление отрасли к аналитике в реальном времени. Эти методы, хотя и являются относительно новыми, прокладывают путь к более мгновенному и динамичному подходу к обработке данных, учитывающему непрерывную скорость генерации информации.


