

Управление сбоями системы: инструкция для команд по работе с данными
Команды, работающие с данными, хорошо знакомы со всякого рода сбоями систем. К сожалению, единого правильного подхода к решению проблем не существует, многие специалисты лишь изредка заявляют об инцидентах с данными.
Пять этапов управления сбоями систем
Процесс управления сбоями можно условно разбить на пять этапов:
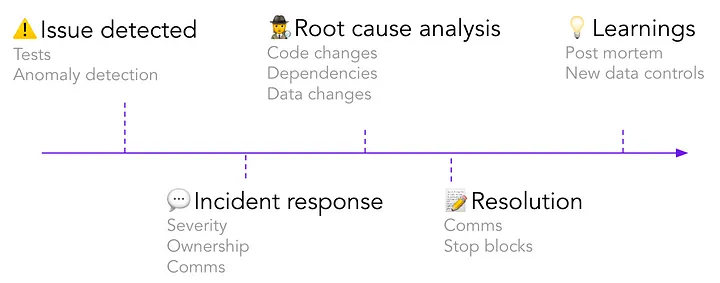
На практике некоторые из вышеперечисленных шагов по разным причинам пропускаются. В принципе весь процесс восстановления системы занимает не очень много времени, поэтому важно понимать, к каким последствиям может привести пропуск того или иного этапа:
- Неправильная приоритезация задач;
- Отсутствие информирования о возникших проблемах может привести к тому, что заинтересованные стороны будут использовать непроверенные и ненадежные данные;
- Невнимательный анализ первопричин возникших проблем;
- Не извлекая уроков из того, что произошло, Вы снова и снова будете наступать на одни и те же грабли.
1. Обнаружение проблемы
В любом случае Вы всегда узнаете о проблемах с данными от заинтересованных лиц или конечных пользователей, но если Вы серьезно относитесь к вопросу качества данных, то, скорее всего, проводите предварительное тестирование данных вручную или используя различные автоматизированные процессы.
Тестирование данных вручную
Тесты данных, выполняемые вручную, - основной способ обнаружения ошибок. Они разрабатываются с учетом всех особенностей Вашего бизнеса и охватывают наиболее важные модели и источники данных. Хорошо разработанные тесты помогут Вам выявить проблемы раньше конечных пользователей и упростить процесс отладки системы, обнаружив и исключив причины возникновения проблем.
Проведя тестирование, Вы узнаете о следующем:
- Какую роль в проактивном обнаружении проблем с данными играет «свежесть» источника данных;
- Расширенные тесты качества данных;
- Регрессионные тесты для обнаружения изменений в исторических данных.

Обнаружение сбоев
В первую очередь следует обратить внимание на тесты, проводимые вручную, ведь именно они помогут устранить наиболее распространенные проблемы и связать Ваши бизнес-цели с ожиданиями от данных. Некоторые проблемы нельзя устранить вручную – в этом случае Вам помогут автоматизированные процессы.
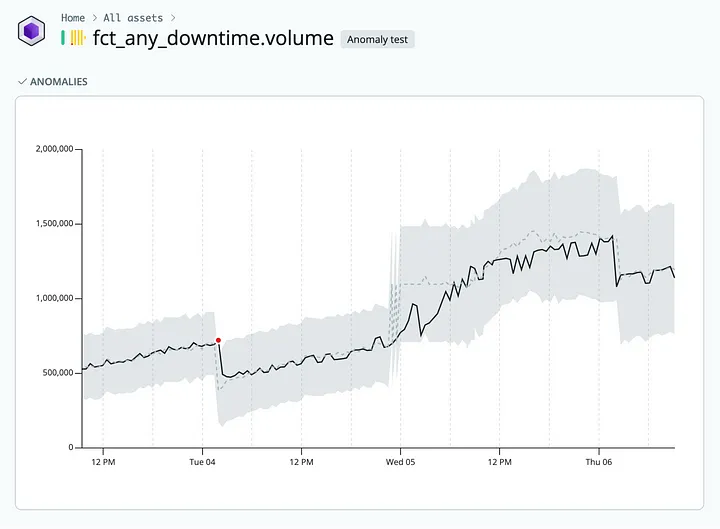
Различные проверки могут помочь Вам обнаружить проблемы по таким аспектам, как качество данных, их свежесть, объем и схемы.
- Качество данных: автоматическая проверка поможет Вам проверить такие параметры, как NOT NULL и уникальность. С их помощью Вы сможете выявить наиболее распространенные ошибки в плане качества и понять, в каких случаях данные отклоняются от ожидаемых результатов, а в каких – нет;
- Свежесть данных: автоматические проверки позволят Вам определить, не устарели ли Ваши источники или модели данных. С их помощью Вы сможете узнать о недостающих данных намного раньше конечных потребителей;
- Объем данных: такие проверки могут дать Вам представление о полноте Ваших данных. Если обычно Вы имеете дело с 500 строками и тут вдруг появляется 5000 новых строк, то совершенно очевидно, что что-то пошло не так;
- Схема данных: Проактивное информирование об изменениях схемы может дать Вам представление о том, как изменился ожидаемый тип данных и соответствует ли он Вашим ожиданиям.
2. Реагирование на сбои
План действий, связанный с обнаруженными сбоями, поможет определить, что делать в том или ином случае, какую проблему стоит рассматривать как серьезный инцидент, а какую нет, какова степень серьезности произошедшего и кого необходимо назначить ответственным.
Когда следует объявлять о произошедшем инциденте
Информируйте своих коллег как можно раньше и чаще.
Вы должны взять себе за привычку объявлять об инцидентах сразу же после их возникновения. Кроме того, очень важно разработать и реализовать четкий план реагирования на сбои, так как именно он поможет Вам заслужить доверие со стороны людей, зависящих от поставляемых Вами данных.
Объявляя о каком-либо инциденте, подумайте о следующем:
- Что именно пошло не так? Действительно ли это серьезно или лучше сначала разобраться в том, что же на самом деле произошло?
- Кому необходимо знать о случившемся? Затронет ли это только команду специалистов по работе с данными или об этом должны знать и пользователи дашбордов или еще кто-нибудь другой?
- Что нужно знать именно ВАМ?
Оцените серьезность инцидента
Иногда случаются инциденты, которые не оказывают существенного влияния на бизнес. Иногда наоборот, происходит что-то, что нельзя оставлять без внимания. Для решения этих двух типов проблем требуются совершенно разные подходы, которые, к сожалению, не всегда четко определены. Зачастую это приводит к неприятным последствиям, например, к тому, что действительно важные вопросы решаются недостаточно оперативно или к тому, что специалистам по данным приходится тратить свое драгоценное время по пустякам.
Как правило, оценить серьезность проблемы с данными можно по трем аспектам:
- Степень важности для бизнеса в целом: имеют ли данные, с которыми произошел тот или иной инцидент, критически важное значение для бизнеса или нет?
- Влияние на последующие процессы: сколько активов и кто еще пострадает в результате инцидента?
- Масштаб: каково влияние произошедшего на основополагающие данные?
Важно уметь очень быстро оценивать серьезность произошедшей проблемы, чтобы знать, как срочно ее необходимо решать. Кроме того, в организации должно быть единое понимание того, что именно стоит делать в зависимости от степени серьезности произошедшего.
Например:
- Низкая степень серьезности: добавьте задачу в бэклог, чтобы устранить проблему к концу недели;
- Средняя степень серьезности: сообщите о случившемся всем заинтересованным сторонам и постарайтесь устранить проблему к концу дня;
- Высокая степень серьезности: оставьте все свои дела, чтобы немедленно устранить возникшую проблему.
Создайте чат, посвященный инциденту, для того, чтобы все могли общаться в одном месте
На этом этапе нужно придумать название инцидента. Как правило, это краткое изложение того, что случилось. Вы также можете включить сюда любую другую важную на Ваш взгляд информацию, такую как описание инцидента или степень его серьезности.
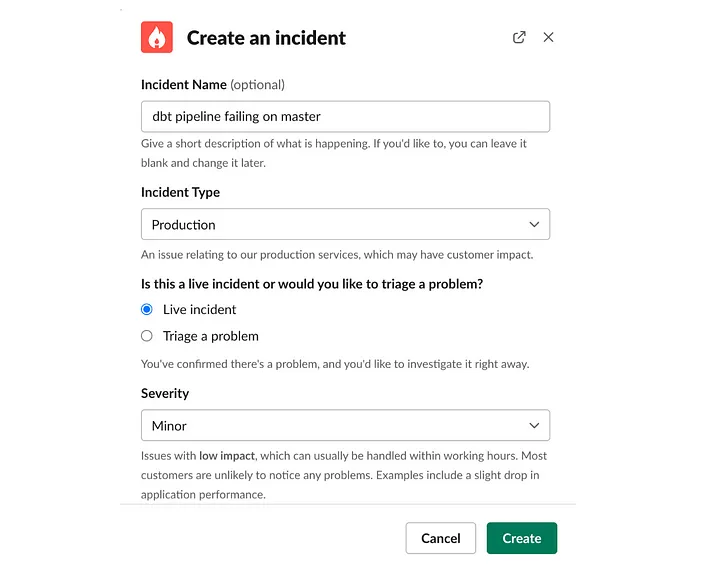
Если Вы хотите убедиться в том, что проблема действительно заслуживает внимания, или определить степень ее серьезности, изучите ее как следует. Но при этом не бойтесь бить тревогу: ложные опасения лучше, чем опасное бездействие!
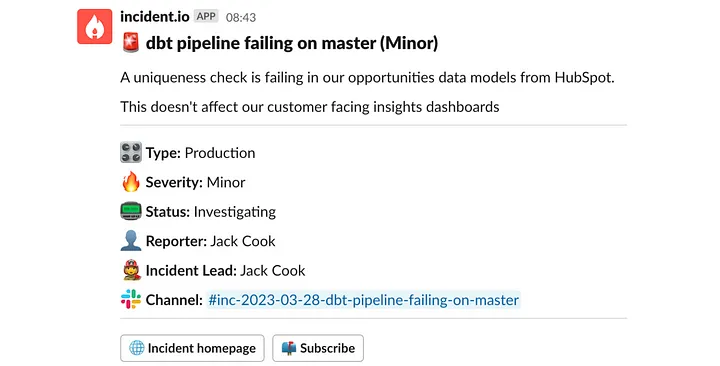
Общение в едином чате - ключ к тому, чтобы абсолютно все были на одной волне.
Распределение ролей и организация эффективной коммуникации
Как правило, существует два типа людей, принимающих участие в решении той или иной проблемы:
- Партнеры: те, кто активно участвует в процессе решения задачи;
- Наблюдатели: те, кто должен быть в курсе происходящего.
В любом случае один из специалистов должен взять на себя роль лидера, а именно следить за регулярным обновлением информации, разрабатывать план действий и информировать нужных людей о ходе рабочего процесса.
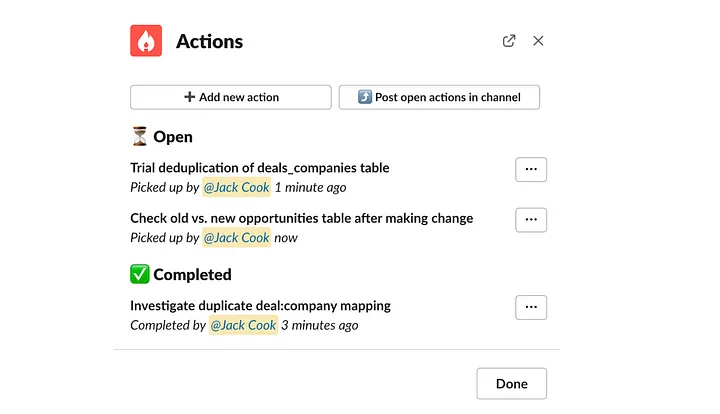
Наблюдатели могут взаимодействовать с инцидентами следующими способами:
- Следить за происходящим в Slack;
- Читать обновления, публикуемые вне канала;
- Читать краткое описание произошедшего.
Вы должны хорошо подумать о том, кто является Вашей целевой аудиторией, какой уровень детализации их интересует и как именно Вы хотите общаться с ними.
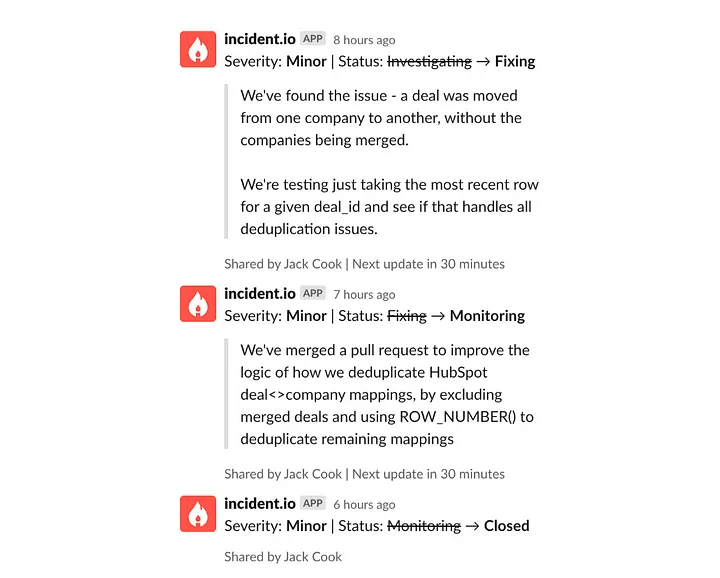
Быть на связи или нет
Быть «на связи» - значит, быть готовым отреагировать на инцидент в любой момент дня (или ночи!).
Это обычное явление в мире разработки ПО. Если Ваше приложение вдруг сломается, Вы же не захотите ждать до утра, чтобы вновь запустить его!
По мере того как работа с данными перенимает все больше и больше практик программной инженерии (в частности, тщательное документирование и тестирование кода с помощью dbt), возрастает влияние данных на некоторые важные аспекты конечного продукта, например, на алгоритм выдачи рекомендаций.
В связи с этим возникает вопрос: быть на связи или нет? Платить дата-инженеру, который будет отвечать за все сбои в работе пайплайна в нерабочее время, имеет смысл только в том случае, если:
- Пайплайны критически важны для Вашего бизнеса и требуют оперативного вмешательства;
- Вы можете четко разделить части пайплайна на те, которые требуют круглосуточной поддержки, и на те, которые не являются критически важными для Вашего бизнеса;
- У Вас есть команда, которая может эффективно распределить задачи по разрешению ситуации.
Последний пункт имеет решающее значение. Небольшая команда по работе с данными, в которой 1-2 человека отвечают за все, что происходит в нерабочее время (особенно в организации с десятками/сотнями сотрудников), - это рецепт от возможного выгорания. Если у Вас недостаточно людей, но при этом требуется круглосуточная поддержка, подумайте о том, чтобы разработать план действий по делегированию обязанностей и распределению ответственности.
Анализ первопричин
Оперативный анализ первопричин помогает сократить время простоя и высвободить время специалистов по работе с данными. 90 % проблем с данными происходят по следующим причинам:
- Ошибки тестирования - поиск первопричин ошибок тестирования;
- Проблемы, связанные с последующими процессами;
- Изменения кода или поиск последних манипуляций с кодом, которые могли привести к ошибке;
- Изменения данных - изучение изменений в базовых данных.
Ошибки тестирования
С помощью dbt Вы можете использовать скомпилированный код для выявления ошибок тестирования, позволяющих понять, какие записи не прошли тест. Каталог target/compiled содержит операторы Select, которые можно запускать в любом редакторе запросов.
Если Вы хотите вернуться и разобраться в первопричинах или поделиться результатами работы с коллегами, можете внести информацию о сбое в БД. В dbt есть очень полезная функция под названием store_failure.
Бывает так, что люди, не входящие в команду по работе с данными, лучше справляются с решением тех или иных проблем. Например, страховая компания использует store_failure для записи ошибок в таблицу, используя схему отслеживания дубликатов сбоев системы. На ее основе был создан дашборд Tableau, которым можно свободно делиться с другими сотрудниками. Каждый раз, когда возникает какая-либо проблема, команда дата-инженеров видит ее в дашборде и может решить сразу же в исходной системе.
models:
 - name: my_model
   columns:
     - name: my_column
       tests:
         - unique:
             config:
               store_failures: true  # always store failures
3. Проблемы, связанные с последующими процессами
Гораздо сложнее отлаживать проблемы, возникающие на верхнем уровне. В худшем случае это можно сравнить с поиском иголки в стоге сена… Вот несколько вопросов, которые помогут Вам выявить первопричины произошедшего сбоя:
- Могу ли я исключить тот факт, что проблема возникла в хранилище данных и задача должна быть передана команде дата-инженеров?
- С какого источника я могу начать исследование?
- Была ли допущена какая-либо ошибка в тесте?
- Какие последующие модели оказывают влияние на мою модель?
- Какие системы зависят от моего источника данных?
- Какая команда отвечает за последующую систему, к кому я могу обратиться?
Изменения в коде
Бывает такое, что последнее изменение кода негативно влияет на предшествующие процессы. Если Вы работаете в небольшой команде по работе с данными, то наверняка знаете обо всех изменениях, но в большинстве случаев уследить за всем не так-то просто.
Большинство платформ Git позволяют просматривать изменения кода, упорядочивая их по дате (как на уровне модели, так и для всего репозитория в целом).
Начните с просмотра изменений кода в модели данных. Это даст Вам понимание всех изменений кода, и того, кто именно внес их в систему.
Проверьте все изменения кода в репозитории. Возможно, были изменены последующие модели данных. Если Вы знаете, когда именно возникла та или иная проблема, то сможете найти изменения кода, которые произошли в репозитории за отдельный период времени.
Изменения данных
Изменения данных – самый сложный тип ошибок, который возникает тогда, когда данные были изменены в базовой системе, что и привело к проблемам в последующих зависимостях.
Snowflake и BigQuery предоставляют широкий спектр возможностей для просмотра того, как Ваши данные выглядели ранее, благодаря чему Вы сможете быстро определить, где именно возникла проблема.
- Snowflake time travel: Запрос и восстановление исторических данных в таблицах, схемах и базах данных за период до 90 дней;
- BigQuery time travel: Запрос и восстановление исторических данных в таблицах, схемах и базах данных за период до 7 дней.
В примере, приведенном ниже, Вы можете увидеть, как изменилась сумма выручки по каждому идентификатору MQL за день. Это может быть особенно полезно в том случае, если Вы хотите сообщить своим коллегам о том, что именно было изменено:
with yesterday as (
 select * from `prod.analytics.stg_closed_deals`
 where date = ‘2023-01-01’
),
last_week as (
 select * from `prod.analytics.stg_closed_deals`    where date = ‘2023-01-01’    for SYSTEM_TIME as of timestamp_sub(current_timestamp(), interval 7 DAY) )select yesterday.mql_id as mql_id, yesterday.declared_monthly_revenue - last_week.declared_monthly_revenue as difffrom yesterday left join last_week on yesterday.mql_id = last_week.mql_idorder by 2 desc
4. Решение
В разрешении неприятной ситуации есть два основных компонента: разрешение самого инцидента и создание превентивной системы контроля (по возможности).
Первая часть, разрешение инцидента, требует четкой коммуникации со всеми участниками процесса.
Опять же, это задача на формирование культуры доверия. Четкое понимание того, что произошло, почему и что сделать для того, чтобы этого больше не повторялось, очень полезно, особенно если речь идет о нетехнических специалистах, которые не способны вникнуть в детали задачи.
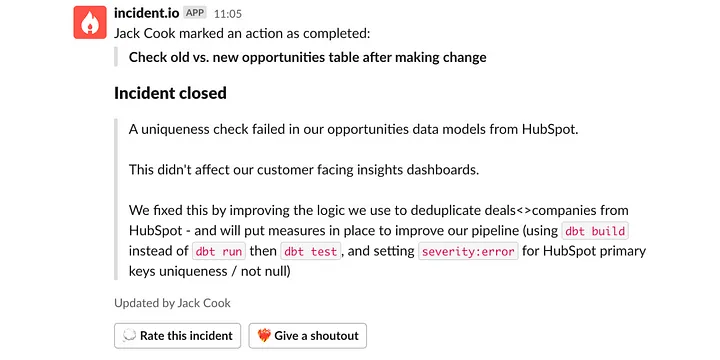
5. Выводы
Еще одним этапом в процессе восстановления системы после сбоя является создание превентивной системы контроля.
Если речь идет о чем-то не о чем серьезном, имеющем минимальные последствия для системы в целом, то не стоит уделять этому вопросу слишком много времени и внимания. В таком случае рекомендуется составить алгоритм последующих действий и проследить за их выполнением; этого будет вполне достаточно.
Если же речь идет о более крупном и серьезном инциденте, в котором хочет разобраться само руководство компании, мы настоятельно рекомендуем Вам формализовать процесс решения данной ситуации, более известный как post mortem.
Дальнейшие действия
Независимо от того, был ли это крупный или незначительный инцидент, Вам в любом случае придется принять некоторые меры, чтобы предотвратить повторение данной ситуации. Вам следует составить список последующих действий и назначить ответственных за их выполнение.
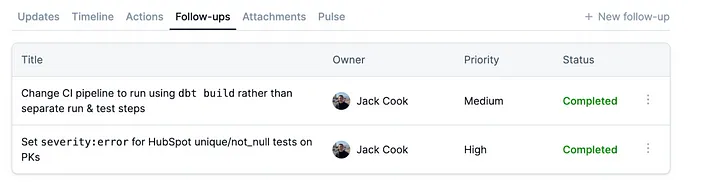
Успех запланированных мер определяется следующими 2 факторами:
- для каждого действия назначено ответственное лицо;
- для выполнения каждой задачи поставлены сроки.
Post mortem
В случае более серьезных инцидентов post mortem включает в себя совещание вовлеченных в процесс специалистов (и любых внешних заинтересованных сторон) и, как правило, содержит документ с кратким описанием инцидента, необходимый для того, чтобы детально обсудить, что именно произошло и как это можно предотвратить в будущем.
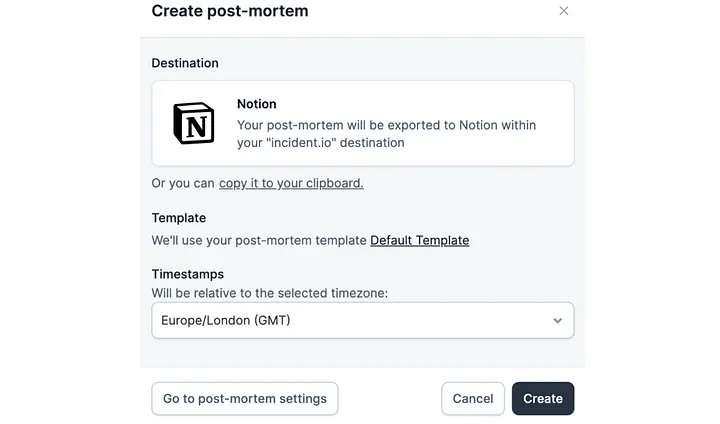
Post mortem помогает понять следующее:
- Что именно пошло не так;
- Почему это произошло;
- Каково влияние произошедшего на организацию в целом;
- Что нужно сделать, чтобы не допустить повторения данной ситуации.
Это очень полезно и для Вас самих, особенно если Вы столкнулись с проблемой качества данных. Такой алгоритм действий позволит объяснить, как случившееся повлияло на Вашу работу. Кроме того, это имеет большое значение и для других заинтересованных сторон, - так они смогут удостовериться в том, что их проблемы действительно приняты и услышаны.
Заключение
В этой статье мы рассмотрели то, как может выглядеть процесс управления инцидентами. Панацеи, к сожалению, не существует, но все же мы надеемся, что эта статья оказалась для Вас полезной. В двух словах процесс восстановления системы после сбоя можно описать так:
- Обнаружение проблемы: сочетайте тесты, проводимые вручную (требующие знаний о домене) с автоматизированными проверками;
- Реагирование на инциденты: информируйте об инцидентах как можно чаще и раньше, подходите к оценке серьезности произошедшего обдуманно;
- Анализ первопричин: для оперативного определения истинных первопричин произошедшего используйте весь арсенал имеющихся у Вас инструментов;
- Разрешение ситуации: Закройте задачу, сообщив о результатах работы всем заинтересованным сторонам, и формализуйте полученный опыт. Это позволит избежать повторения подобной ситуации в будущем;
- Выводы: для более серьезных инцидентов используйте post mortem, который, как правило, содержит документ с кратким описанием инцидента.


