

Изучаем Hadoop на практике: настройка и масштабирование Hadoop
О чем важно знать перед установкой и масштабированием Hadoop
Пришло время разобраться в том, как именно он работает, и что можно сделать с его помощью. Для начала предлагаю разобрать основные компоненты Hadoop, а именно: HDFS для хранения данных, MapReduce для их обработки, YARN для управления ресурсами и т.д. Затем поговорим о том, как лучше всего установить Hadoop (локально и в облаке) и рассмотрим несколько основных команд.
Какие компоненты являются неотъемлемой частью архитектуры Hadoop?
Архитектура Hadoop спроектирована так, чтобы быть стабильной, опираясь всего на несколько компонентов, работающих вместе. Эти компоненты разделяют большие массивы данных на более мелкие блоки, что облегчает их дальнейшую обработку и распределение по кластеру серверов. Такой распределенный подход обеспечивает эффективную процедуру обработки данных - гораздо более масштабируемую, чем может позволить централизованный «суперкомпьютер».
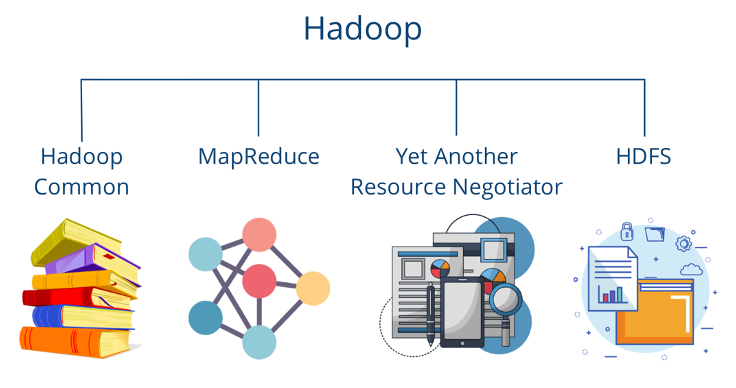
Ключевые компоненты Hadoop:
- Hadoop Common включает в себя базовые библиотеки и функции, необходимые для работы других модулей;
- HDFS (Hadoop Distributed File System) обеспечивает хранение данных на разных серверах и гарантирует большую пропускную способность;
- Hadoop YARN выполняет функцию распределения ресурсов в системе и перераспределяет нагрузку в случае, когда отдельные компьютеры достигают своего предела;
- MapReduce - это модель программирования, разработанная специально для того, чтобы сделать обработку больших объемов данных максимально эффективной.
В 2020 году к этой базовой архитектуре был добавлен еще один компонент, а именно Hadoop Ozone, используемый в качестве альтернативы HDFS. Он представляет собой распределенную систему хранения объектов, разработанную специально для работы с Big Data (особенно в облаке).
HDFS (Hadoop Distributed File System)
Давайте рассмотрим HDFS, основную систему хранения данных Hadoop, разработанную специально для обработки больших данных . Ее основной принцип заключается в том, что файлы не хранятся целиком на центральном сервере, а делятся на блоки размером 128 или 256 МБ и затем распределяются по разным узлам компьютерного кластера.
Для обеспечения целостности данных каждый блок реплицируется на разных серверах по три раза. Если один сервер выходит из строя, система восстанавливает данные из оставшихся копий.
В официальной документации Hadoop сказано, что основными целями HDFS являются следующие:
- Быстрое восстановление после сбоев за счет восстановления работоспособности компонентов;
- Обеспечение потоковой обработки данных;
- Структурирование Big Data с возможностью обработки больших массивов данных$
- Стандартизация процессов с возможностью перехода на новое оборудование или ПО.

Apache Hadoop работает по принципу «ведущий-ведомый» (master-slave). В таком кластере присутствует узел, который берет на себя роль ведущего. Он распределяет данные по разным ведомым узлам и запоминает, где хранятся различные разделы. На ведущем узле хранятся только ссылки на блоки, то есть метаданные. Если он по каким-то причинам выходит из строя, подключается вторичный узел, который может спокойно его заменить.
Управляющий узел в распределенной файловой системе Apache Hadoop называется узлом имен или NameNode. Ведомые узлы называются DataNodes. Их основная задача заключается в том, чтобы хранить блоки данных и регулярно сообщать NameNode о том, «живы» ли они или нет. Если узел DataNode выходит из строя, блоки данных реплицируются другими узлами, обеспечивая тем самым отказоустойчивость системы.
Клиент сохраняет файлы, которые хранятся на узлах DataNode. В нашем случаи они расположены на стойках 1 и 2. Как правило, на каждую машину в стойке приходится только один узел DataNode. Его основная задача - управлять блоками данных в памяти.
NameNode отвечает за запоминание того, какие блоки данных хранятся в каждом DataNode, что позволяет быстро получать к ним доступ по запросу. Он также управляет файлами и может открывать, закрывать и, при необходимости, переименовывать их.
Наконец, DataNode выполняют фактические процессы чтения и записи данных клиента. При выполнении запроса клиент получает от них всю необходимую информацию. Помимо всего прочего DataNode обеспечивают репликацию данных для обеспечения отказоустойчивости системы.
MapReduce
MapReduce - это модель программирования, обеспечивающая параллельную обработку больших объемов данных. Изначально она была разработана компанией Google. На сегодняшний момент ее можно разделить на две основные фазы:
- Map: на этом этапе закладывается процесс, преобразующий входные данные в пары ключ-значение. Затем происходит одновременная обработка большого объема данных;
- Reduce: стартует после завершения первого этапа, объединяет все значения, имеющие одинаковый ключ. Агрегирование данных может в себя различные процессы, такие как суммирование или определение максимального значения. Между окончанием фазы Map и началом фазы Reduce данные перемешиваются и сортируются в соответствии с ключами.
Классический способ применения механизма MapReduce - подсчет слов в документах (в нашем случае – в семи томах «Гарри Поттера»). Задача состоит в том, чтобы подсчитать, как часто встречаются слова «Гарри» и «Поттер». Для этого на этапе map каждое слово разбивается на пару ключ-значение, где в качестве ключа выступает слово, а в качестве значения - число один, поскольку это слово встречается один раз.
Задачи могут выполняться параллельно и независимо друг от друга (например, по каждой странице в отдельности). Это означает, что задача может быть решена гораздо быстрее. Масштабирование зависит только от доступных вычислительных ресурсов и может быть увеличено по мере необходимости при наличии соответствующего оборудования. Результат фазы map может выглядеть так:
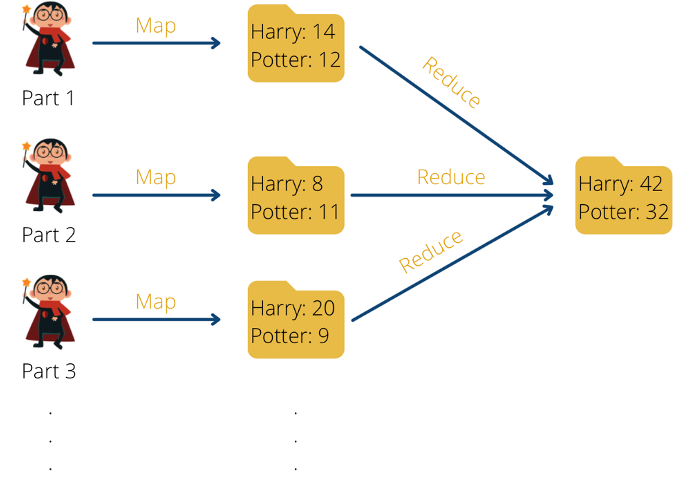
После того как mapper завершит свою работу, можно приступать к этапу reduce. Для примера с подсчетом слов все пары ключ-значение с ключами «Harry» и «Potter» должны быть сгруппированы и подсчитаны.
Полученный результат:
[(„Harry“,[1,1,1]),(„Potter“,[1,1])]
Затем сгруппированный результат агрегируется. Так как в нашем примере необходимо подсчитать общее количество слов, сгруппированные значения складываются вместе. В результате мы получаем следующее:
[(„Harry“, 3),(„Potter“, 2)]
Преимущество такой обработки заключается в том, что одна большая задача может быть распараллелена, и при ее выполнении происходит минимальное перемещение файлов. Это означает, что даже большие объемы информации могут быть обработаны в кратчайшие сроки.
Многие системы до сих пор используют MapReduce (как это было в оригинальной структуре Hadoop), однако за прошедшее время были разработаны и более эффективные фреймворки, такие как Apache Spark.
YARN (Yet Another Resource Negotiator)
YARN (Yet Another Resource Negotiator) управляет аппаратными ресурсами кластера. Он отделяет управление ресурсами от обработки данных, что позволяет нескольким приложениям (таким как MapReduce, Spark и Flink) работать на одном кластере. Он выполняет такие ключевые функции, как:
- Управление ресурсами памяти, такими как процессор или SSD-накопитель;
- Распределение свободных ресурсов между запущенными процессами, например MapReduce, Spark или Flink;
- Оптимизация и распараллеливание выполнения заданий.
Подобно HDFS, YARN также работает по принципу «ведущий-ведомый» (master-slave). Менеджер ресурсов выступает в роли ведущего и централизованно контролирует все ресурсы во всем кластере. Он также распределяет их между отдельными приложениями. В роли ведомых выступают другие менеджеры узлов, устанавливаемые на каждой машине. Они отвечают за контейнеры, в которых работают приложения, и следят за потреблением ресурсов, таких как объем памяти или производительность процессора. Эти данные передаются менеджеру ресурсов через регулярные промежутки времени для того, чтобы он мог получить общую картину.
В общих чертах запрос к YARN выглядит так: клиент обращается к менеджеру ресурсов и запрашивает выполнение задачи. Затем он ищет доступные ресурсы и, если это возможно, запускает новый экземпляр так называемого Application Master, который инициирует и контролирует выполнение приложения. Он, в свою очередь, запрашивает доступные ресурсы у менеджера узлов и запускает соответствующие контейнеры. Теперь вычисления могут выполняться параллельно и контролироваться мастером приложений. После успешной обработки задачи YARN высвобождает ресурсы, необходимые для обработки следующих задач.
Hadoop common
Hadoop Common можно рассматривать как основу экосистемы Hadoop, на которой могут быть построены основные компоненты. Он содержит базовые библиотеки, инструменты и конфигурационные файлы, которые могут использоваться всеми компонентами Hadoop. К ним относятся:
- Общие библиотеки и утилиты: Hadoop Common предоставляет набор Java-библиотек, API и утилит, необходимых для эффективной работы кластера. Сюда входят механизмы для установления связи между узлами кластера или поддержка различных форматов сериализации, таких как Avro. Также сюда включены интерфейсы, необходимые для управления файлами в HDFS или других файловых системах;
- Управление конфигурацией: Hadoop основан на большом количестве конфигурационных файлов на основе XML, которые определяют основные параметры системы. Одним из центральных аспектов являются сетевые параметры, необходимые для управления машинами в кластере. Кроме того, здесь определяются допустимые места хранения HDF-файлов или максимальные размеры ресурсов, например пространства, пригодного для хранения данных;
- Независимость платформы: Изначально Hadoop был разработан специально для Linux. Однако с помощью Hadoop Common его можно распространить и на другие операционные системы, такие как macOS или Windows;
- Инструменты для ввода/вывода: Система больших данных обрабатывает огромные массивы информации, которые необходимо хранить и обрабатывать. Поэтому такие строительные блоки для создания различных файловых систем, как TextFiles или Parquet, хранятся в Hadoop Common. Он также содержит функциональные возможности для всех поддерживаемых методов сжатия, которые обеспечивают экономию места и оптимизацию по времени обработки.
Благодаря этой единой и центральной кодовой базе Hadoop Common обеспечивает повышенную модульность фреймворка и гарантирует бесперебойную работу всех компонентов системы.
Hadoop Ozone
Hadoop Ozone - это распределенная система хранения объектов, которая была разработана в качестве альтернативы HDFS и предназначена специально для Big Data. Изначально HDFS предназначалась для хранения больших файлов, занимающих много гигабайт или даже терабайт. Однако, как только речь зашла о необходимости хранения большого количества маленьких файлов, он очень быстро достиг своих пределов. Основная проблема заключалась в ограничении узла NameNode, который хранит метаданные в оперативной памяти и поэтому при хранении миллиардов маленьких файлов сталкивается с проблемой нехватки памяти.
Кроме того, HDFS необходима для эффективного использования Hadoop в рамках вычислительного кластера. Однако в современных архитектурах достаточно часто используется гибридный подход с решениями для хранения данных в облаке. Hadoop Ozone решает эти проблемы, предоставляя масштабируемую и гибкую архитектуру хранения, оптимизированную специально для Kubernetes и гибридных облачных сред.
В отличие от HDFS, где узел NameNode обрабатывает все метаданные файлов, Hadoop Ozone представляет более гибкую архитектуру, которая не опирается только на один централизованный узел NameNode. Вместо этого в ней используются такие компоненты, как:
- Менеджер Ozone наиболее точно соответствует узлу имен HDFS, но управляет только метаданными бакета. Он обеспечивает эффективное управление объектами, а также высокую масштабируемость, поскольку не все метаданные файлов хранятся в оперативной памяти;
- Менеджер SCM можно сравнить с DataNode в HDFS, его основной задачей является управление и репликация данных в так называемых контейнерах. Поддерживаются различные стратегии репликации, такие как тройное копирование или кодирование стиранием (для экономии места);
- Шлюз Ozone 3 имеет S3-совместимый API, поэтому его спокойно можно использовать в качестве альтернативы Amazon S3. Это означает, что приложения, разработанные специально для AWS S3, могут быть подключены к Ozone и взаимодействовать с ним без необходимости изменения кода.
Такая структура дает Hadoop Ozone различные преимущества перед HDFS, которые вкратце представлены в виде следующей таблице:
|
Аспект |
Hadoop Ozone |
HDFS |
|
Структура хранения |
Объектро-ориентированная (бакеты& ключи) |
Блочно-ориентированная (файлы & блоки) |
|
Масштабируемость |
Миллионы/миллиарды маленьких файлов |
Проблемы с хранением множества небольших по размеру файлов |
|
Зависимость NameNode |
нет NameNode, при этом есть возможность масштабирования |
Разработан хуже, чем хотелось бы |
|
Интеграция в облако |
поддерживает S3 API, Kubernetes и мульти-обласко |
Привязан к кластеру Hadoop |
|
Стратегия репликации |
Классическая 3-кратная репликация или кодирование стиранием |
Только 3-кратная репликац ия |
|
Приложения |
Big data, Kubernetes, гибридное облако, S3 |
Традиционные рабочие нагрузки Hadoop |
Hadoop Ozone является мощным расширением экосистемы и позволяет реализовать гибридные облачные архитектуры, которые были бы просто невозможны при использовании HDFS. Он также легко масштабируется, поскольку больше не зависит от центрального узла имен. Это означает, что приложения для работы с большими данными, содержащие много файлов небольшого размера, используемые для измерений датчиков, также могут быть реализованы без каких-либо проблем.
Начало работы с Hadoop
Hadoop - это надежный и масштабируемый фреймворк для работы с большими данными, на котором основаны многие известнейшие приложения. Поскольку с первого взгляда он может показаться слишком сложным, мы подготовили для Вас подробное руководство по работе с ним.
Установка Hadoop
Прежде всего необходимо установить Hadoop. В этой главе мы рассмотрим 2 возможных варианта: локальную установку и установку в облаке. При этом мы рекомендуем работать с Linux или macOS (для Windows требуются дополнительные настройки). Кроме того, должна быть доступна Java (Java 8 или 11), и должно быть настроено внутреннее взаимодействие через SSH.
Локальная установка Hadoop
Для работы с Hadoop на локальном компьютере выполните одноузловую установку. Перед ее запуском убедитесь в том что Вы имеете дело с самой последней версией (доступна на сайте https://hadoop.apache.org/releases.html). В нашем случае это версия 3.4.1. Если требуется другая версия, скорректируйте номер версии в коде следующим образом:
Откройте новый терминал и выполните следующий код, который загружает искомую версию из Интернета, распаковывает каталог, а затем переходит в него:
wgethttps://downloads.apache.org/hadoop/common/hadoop-3.4.1/hadoop-3.4.1.tar.gztar-xvzf hadoop-3.4.1.tar.gzcdhadoop-3.4.1
Если в первой строке есть ошибки, то, скорее всего, это связано с неправильной ссылкой или указанная версия может быть уже недоступна. В этом случае следует использовать более актуальную версию и выполнить код заново. Размер каталога установки составляет около 1 гигабайта.
После этого можно создавать и устанавливать переменные окружения, которые сообщают системе, в какой именно директории на компьютере хранится Hadoop. Переменная PATH позволяет выполнять команды Hadoop из любого места в терминале без необходимости задавать полный путь к установке Hadoop.
exportHADOOP_HOME=~/hadoop-3.4.1exportPATH=$PATH:$HADOOP_HOME/bin
Перед запуском системы мы можем изменить базовую конфигурацию Hadoop, например, задать конкретные каталоги для HDFS или указать коэффициент репликации. Всего существует три важных конфигурационных файла, которые мы можем настроить перед запуском:
-
core-site.xmlнастраивает основные параметры Hadoop, например, информацию о подключении для нескольких узлов; -
hdfs-site.xmlсодержит специальные параметры для настройки HDFS, такие как типичные каталоги для хранения данных или коэффициент репликации, который определяет, сколько реплик данных нужно сохранить; -
yarn-site.xmlнастраивает компонент YARN, который отвечает за управление ресурсами и планирование заданий.
Мы можем настроить конфигурацию HDFS так, чтобы коэффициент репликации был равен 1, поскольку мы работаем только на одном сервере, и репликация данных просто не имеет смысла. Для этого мы используем текстовый редактор (nano) и открываем файл конфигурации HDFS:
nano $HADOOP_HOME/etc/hadoop/hdfs-site.xmlПосле этого файл откроется в терминале и, вероятно, в нем еще не будет никаких записей. Затем в области конфигурации можно добавить новый XML со следующим ключом:
<property>
    <name>dfs.replication</name>
    <value>1</value>
</property>
В соответствии с этим форматом можно задать различные свойства. Ключи, которые могут быть указаны в конфигурационных файлах, включая допустимые значения, можно найти по адресу https://hadoop.apache.org/docs/current/hadoop-project-dist/.
Теперь, когда мы закончили с конфигурацией, можно запускать Hadoop. Для этого инициализируем HDFS, что является первым важным шагом после установки, и отформатируем каталог, который будет использоваться в качестве NameNode. Следующие две команды запускают HDFS на всех узлах, настроенных в кластере, и запускают управление ресурсами YARN.
hdfsnamenode-formatstart-dfs.shstart-yarn.sh
На этом этапе могут возникнуть проблемы, особенно если не установлена Java. Однако это можно легко исправить с помощью соответствующей установки. Кроме того, когда я пробовал это и на macOS, необходимо было явно запустить NameNode и DataNode HDFS:
~/hadoop-3.4.1/bin/hdfs --daemon start namenode~/hadoop-3.4.1/bin/hdfs --daemon start datanode
Для YARN та же процедура работает для Resource и NodeManager:
~/hadoop-3.4.1/bin/yarn --daemon start resourcemanager~/hadoop-3.4.1/bin/yarn --daemon start nodemanager
Наконец, запущенные процессы можно проверить с помощью команды jps. Так Вы сможете убедиться в том, что все компоненты были запущены правильно.
Установка Hadoop в распределенной системе
Для обеспечения надежности и продуктивности процессов можно работать с Hadoop в распределенной среде с несколькими серверами, также называемыми узлами. Это обеспечивает большую масштабируемость системы. Обычно различают следующие роли кластеров:
- NameNode: хранит метаданные и управляет файловой системой (HDFS);
- DataNode: здесь хранятся фактические данные и происходят вычисления;
- ResourceManager и NodeManagers: управляют ресурсами кластера YARN.
Команды, описанные в предыдущем разделе, можно использовать на отдельных серверах. Однако между ними также должна быть установлена связь, чтобы они могли координировать работу друг с другом. В целом при установке можно придерживаться следующего алгоритма:
- Установите несколько серверов на базе Linux, которые будут использоваться для кластера;
- Настройте SSH-доступ между серверами, чтобы они могли общаться друг с другом и отправлять данные;
- Установите Hadoop на каждый сервер и выполните необходимые настройки;
- Назначьте роли и определите NameNodes и DataNodes в кластере;
- Отформатируйте NameNodes, а затем запустите кластер.
Конкретные шаги и код, который необходимо выполнить, в большей степени зависят от способа реализации.
Hadoop и облако
Многие компании используют Hadoop в облаке для того, чтобы избежать необходимости управлять собственным кластером, экономить расходы, а также получить возможность использовать самое современное оборудование. Различные провайдеры уже имеют готовые программы, с помощью которых можно использовать Hadoop в своих средах. Наиболее распространенными облачными сервисами Hadoop являются:
- AWS EMR (Elastic MapReduce): Эта программа основана на Hadoop и, как следует из названия, также использует MapReduce, что позволяет пользователям писать свои собственные программы на Java, которые обрабатывают и хранят большие объемы данных. Кластер работает на виртуальных серверах в Amazon Elastic Compute Cloud (EC2) и хранит данные в Amazon Simple Storage Service (S3). Ключевое слово «Elastic» связано с тем, что система может изменяться в зависимости от требуемой вычислительной мощности. Наконец, AWS EMR также предлагает возможность использования других расширений Hadoop, таких как Apache Spark или Apache Presto;
- Google Dataproc: альтернатива от Google под названием Dataproc позволяет создать полностью управляемый и масштабируемый кластер Hadoop в облаке Google. Он основан на BigQuery и для хранения данных использует Google Cloud Storage. Многие компании, такие как Vodafone и Twitter, используют именно эту систему;
- Azure HDInsight: для полноценного использования Hadoop в облаке Microsoft Azure Cloud предлагает HDInsight, а также обеспечивает поддержку широкого спектра других open-source программ.
Основное преимущество использования облака заключается в том, что оно не требует ручной установки и обслуживания. Несколько узлов используются автоматически и добавляются в зависимости от потребностей в вычислениях. Для заказчика преимущество автоматического масштабирования заключается в том, что можно контролировать свои расходы и платить только за то, что фактически используется.
С другой стороны, при использовании локального кластера аппаратное обеспечение обычно настраивается таким образом, чтобы оно оставалось работоспособным даже при пиковых нагрузках. Наконец, облако позволяет легко интегрировать другие важные системы.
Команды Hadoop для новичков
Независимо от выбранной Вами архитектуры для выполнения основных действий в Hadoop можно использовать следующие команды, охватывающие основные ETL-процессы:
- Загрузка файла в HDFS: Чтобы выполнить команду HDFS, всегда требуется hdfs dfs. С помощью put Вы определяете, что хотите загрузить файл из локального каталога в HDFS. В файле local_file.txt описывается загружаемый Вами файл. Для этого команда либо выполняется в каталоге файла, либо добавляется полный путь к нему. Наконец, используется /user/hadoop/, позволяющий определить каталог в HDFS, в котором и будет храниться сам файл.
hdfs dfs -put local_file.txt /user/hadoop/
- Просмотр файлов HDFS: чтобы перечислить все файлы и папки в каталоге HDFS /user/hadoop/ и отобразить их в виде списка используйте –ls:
hdfs dfs -put local_file.txt /user/hadoop/
- Загрузка файла из HDFS: Параметр -get загружает файл /user/hadoop/file.txt из каталога HDFS в локальный каталог. Точка . указывает на то, что файл хранится в текущем локальном каталоге, в котором выполняется та или иная команда. Также можно определить соответствующий локальный каталог самостоятельно:
hdfs dfs -get /user/hadoop/file.txt
- Удаление файлов из HDFS: для удаления файла /user/hadoop/file.txt из каталога HDFS используйте команду –rm, которая помимо всего прочего автоматически удаляет все репликации, распределенные по кластеру.
hdfs dfs -rm /user/hadoop/file.txt
-
Запуск команды MapReduce (обработка данных): MapReduce - это модель распределенных вычислений в Hadoop, которая используется для обработки больших объемов данных. Использование hadoop jar означает, что необходимо выполнить задание Hadoop с файлом «.jar». Соответствующий файл, содержащий различные программы MapReduce, находится в каталоге /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-*.jar. Из этих примеров необходимо выполнить задание wordcount, которое подсчитывает количество слов, встречающихся в текстовом файле. Анализируемые данные находятся в каталоге HDFS /input, а результаты сохраняются в каталог output/.hadoop jar
/usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-*.jar wordcount input/ output/
- Следите за ходом выполнения задания: Несмотря на распределенную вычислительную мощность, заданиям MapReduce требуется время, зависящее от объема информации. Поэтому их состояние можно свободно отслеживать в терминале. Ресурсы и запущенные приложения можно отображать с помощью YARN. Чтобы выполнить команду в этой системе, мы начинаем с команды yarn, а с помощью application-list получаем список всех активных приложений. Из этого списка можно прочитать различную информацию, например уникальный идентификатор приложения, пользователя, который его запустил, и прогресс в %.
yarn application –list- Отображение журналов выполняемого задания: Чтобы лучше разобраться в запущенном процессе и выявить потенциальные проблемы уже на ранней стадии, можно прочитать журналы. Для этого используется команда logs, с помощью которой можно вызвать журналы определенного приложения. Для определения приложения используется уникальный идентификатор приложения. Для этого в следующей команде необходимо заменить APP_ID на реальный ID, а также убрать знаки больше и меньше.
yarn logs -applicationId<APP_ID>
С помощью этих команд данные можно сохранять в HDFS, а также создавать различные задания MapReduce. Это основопологающие действия по наполнению кластера данными и их обработке.
Отладка и протоколирование в Hadoop
Для того чтобы кластер был устойчив в долгосрочной перспективе, важно освоить основные команды отладки и протоколирования. Поскольку Hadoop является распределенной системой, ошибки могут возникать в самых разных компонентах и узлах. Поэтому очень важно знать соответствующие команды, позволяющие быстро обнаружить и исправить ошибки.
- NameNode-Logs содержит информацию о метаданных HDFS и возможных проблемах с подключением:
cat $HADOOP_HOME/logs/hadoop-hadoop-namenode-<hostname>.log
- DataNode logs позволяет выявить проблемы, связанные с хранением блоков данных:
cat $HADOOP_HOME/logs/hadoop-hadoop-datanode-<hostname>.log
- YARN ResourceManager logs позволяет выявлять проблемы с ресурсами или ошибки в планировании заданий:
cat $HADOOP_HOME/logs/yarn-hadoop-resourcemanager-<hostname>.log
- NodeManager logs помогает в отладке выполненных заданий и их логики:
cat $HADOOP_HOME/logs/yarn-hadoop-nodemanager-<hostname>.log
С помощью этих журналов можно выявить проблемы в процессах и найти возможные решения. Однако если проблемы существуют во всем кластере, и Вы хотите проверить общее состояние отдельных серверов, имеет смысл провести детальный анализ кластера с помощью следующей команды:
hdfsdfsadmin-report
Сюда входят активные и отказавшие DataNodes, а также доступная и занятая емкость хранилища. Здесь также отображается статус репликации файлов HDFS и предоставляется дополнительная информация о кластере. Пример:
Configured Capacity: 10 TBDFS Used: 2 TBRemaining: 8 TBNumber of DataNodes: 5DataNodes Available: 4DataNodes Dead: 1
Благодаря выше описанным действиям Вы сможете настраивать Hadoop в различных средах, хранить и управлять данными в HDFS, выполнять задания MapReduce и читать журналы. Это позволит Вам начать свой первый проект на Hadoop и получить ценный опыт работы с фреймворками, ориентированными на Big Data.
В этой статье мы рассмотрели основные компоненты Hadoop, включая HDFS, YARN и MapReduce. Мы также внимательно изучили процесс установки, начиная с настройки Hadoop в локальной или распределенной среде и заканчивая настройкой ключевых файлов, таких как core-site.xml и hdfs-site.xml. Понимание этих компонентов очень важно для эффективного хранения и обработки больших массивов данных на кластерах.
Если этой базовой настройки Вам недостаточно, и Вы хотите узнать, как можно расширить кластер Hadoop для того, чтобы сделать его еще более масштабируемым, предлагаем Вашему вниманию нашу следующую статью. В ней мы углубимся в большую экосистему Hadoop и изучим такие инструменты, как Apache Spark, HBase, и Hive. Остаемся на связи!


