

Информационные продукты: Аргументы против архитектуры Medallion
Если мы хотим возбудить дело против архитектуры Medallion, нам нужно поработать юристом с обеих сторон и сначала привести доводы в пользу Medallion — его значимости, причин его появления, влияния и того, почему он работал или не работал. И не волнуйтесь, мы будем держать оборону недолго, чтобы у нас была возможность подготовиться к предстоящему.
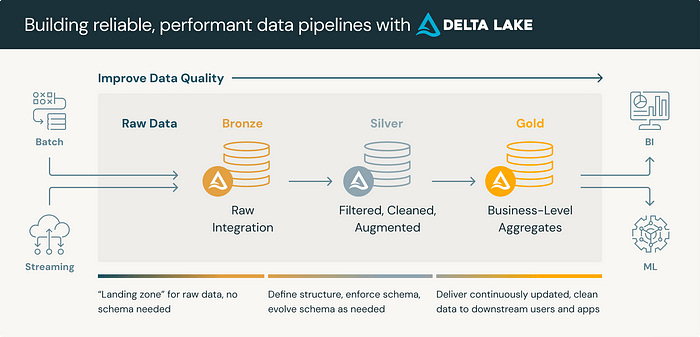
Почему появился медальон?
Архитектура Medallion была создана для удовлетворения насущных потребностей. Поиск в Google или chatGPT о причинах появления Medallion будет сильно отличаться от этого анализа. В общем виде можно привести такие причины, как улучшение управления, устранение узких мест или стандартизация процессов. Но на самом деле это не решило их, и мы все еще по уши увязаем в этих проблемах. Так в чем же была истинная причина его появления и что он позволил решить? Что мы видим с высоты 10 тысяч футов?
Общая картина оказывается совсем иной.
В связи с постоянно растущей нагрузкой на команды обработки бизнес-данных, которые продолжают расширяться, возникла острая необходимость в обеспечении очевидной “простоты управления данными”. Это позволяет почувствовать, что имеющийся у нас огромный объем данных в какой-то мере поддается управлению.
Архитектура Medallion дала командам, работающим с данными, максимальную психологическую разгрузку, повысив производительность и управление с культурной точки зрения, а не с технической точки зрения: Она разбила большую проблему на более мелкие части.
Хотя это всегда лучший подход — разбить большую проблему на более мелкие решаемые элементы, важно также то, как происходит это разделение. Что касается Medallion, мы хотели бы отметить, что сам подход к разделению большой части привел к сбою в архитектуре.
Как не разбить большую часть на более мелкие расходные материалы
Хотя управление данными казалось более выполнимым, поскольку разные уровни предъявляли все более разные требования к качеству, каждый из которых выигрывал от первого, это был очевидный прогресс без реального прогресса. Неправильное назначение каждого уровня приводило к тому, что на каждом из них размещались некачественные данные, которые усугублялись на следующем уровне.

Продукты для обработки данных: Аргументы против архитектуры Medallion
Medallion стал приманкой для многих организаций, которым требовалось избавиться от давления больших объемов данных и больших ожиданий от данных. Несомненно, это в какой-то степени решило реальные проблемы, но в конечном итоге привело к появлению трех уровней "узких мест".
Чтобы понять, насколько Medallion не соответствует нашим ожиданиям в области управления данными, мы воспользуемся архитектурой продукта данных в качестве сравнительной карты, чтобы рассмотреть ситуацию в перспективе.
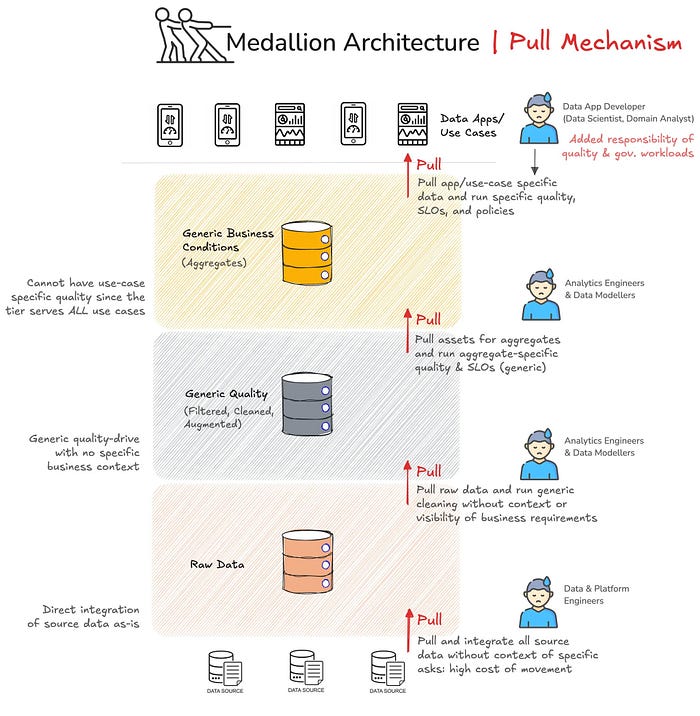
Принудительное внедрение Bronze
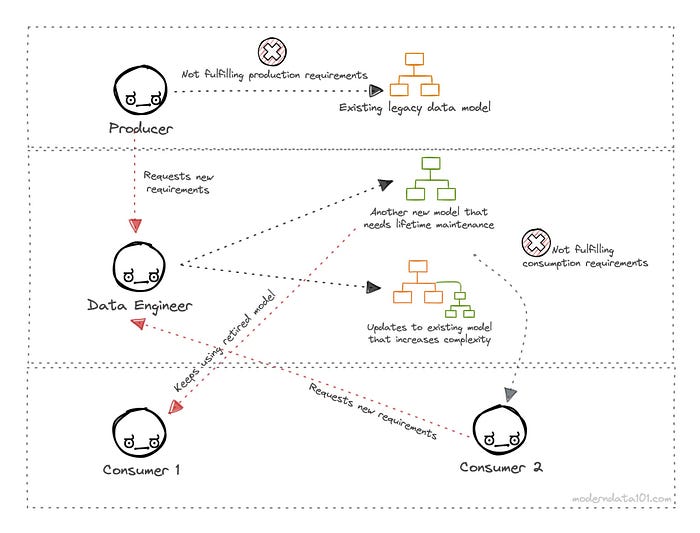
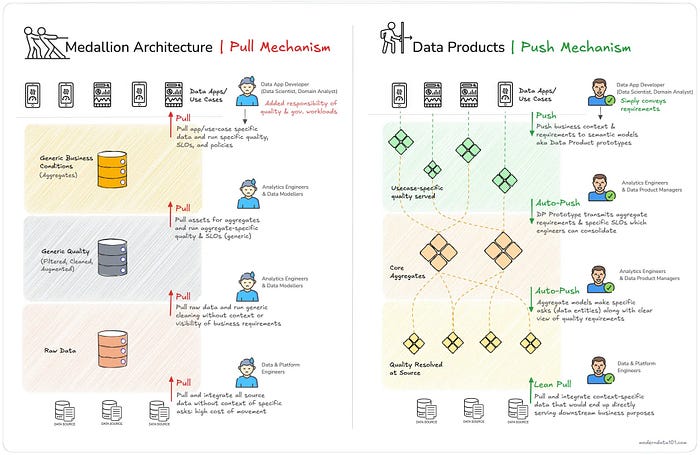
Инженеры по обработке данных должны извлекать и интегрировать все исходные данные на уровень bronze без учета конкретных бизнес-запросов. Это увеличивает стоимость перемещения данных, увеличивая затраты на хранение и вычислительные ресурсы.
- Увеличение затрат на хранение: хранение нескольких копий данных на разных уровнях приводит к увеличению затрат на облачное хранилище.
- Требуется много вычислительных ресурсов: постоянное перемещение данных по уровням приводит к ненужной обработке и неэффективности запросов.
Эта модель, в некотором смысле, увеличивает прибыль разработчиков этой архитектуры, поскольку она тесно связана с традиционными архитектурами Lakehouse. Увеличение объема памяти и вычислительных ресурсов приводит к высоким расходам на выставление счетов при любой модели оплаты по мере поступления.
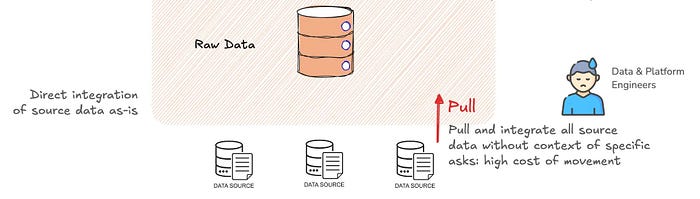
Механизм извлечения в бронзовом слое медальона | Источник: Авторы
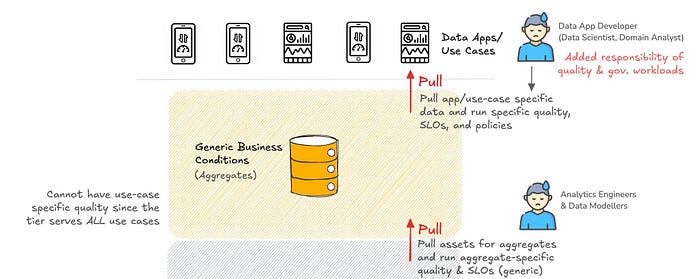
Что еще более важно, обратите внимание, что на этом слое не выполняется качественная работа, но вы, по сути, вводите постоянно генерируемые данные и создаете кучу в своем домике у озера. Ожидается, что инженеры и бизнес-пользователи нижестоящих уровней будут работать с большим объемом информации, чтобы выполнять реальную работу по качественному выполнению рабочих нагрузок.
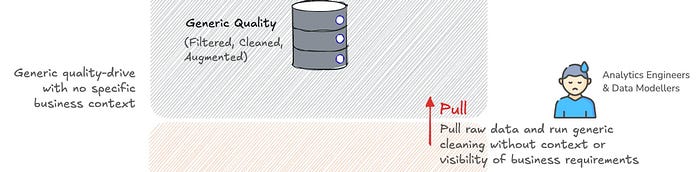
Первый толчок: Контекст
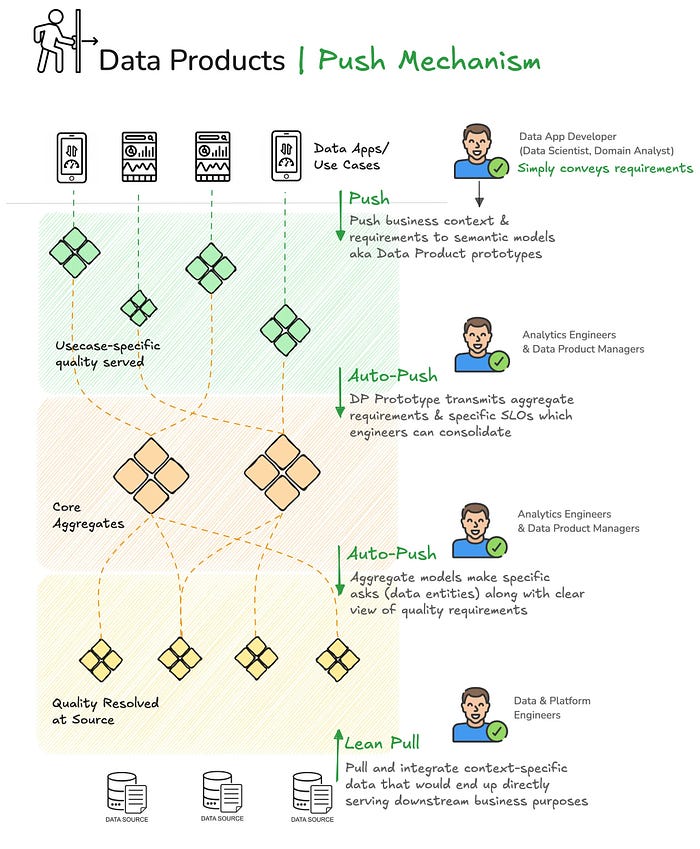
Основным видом деятельности в любой платформе, ориентированной на продукт, является “ввод данных пользователем”, что переводится в бизнес-контекст экосистемы продуктов обработки данных. Последующие пользователи, работающие над сценарием использования данных, делятся своими требованиями, скажем, через удобный для бизнеса интерфейс. Этот контекст сопоставляется в виде семантической модели. Какие объекты данных необходимы для этого варианта использования, как они связаны друг с другом и какие меры и метрики важны?
Каскадный контекстный анализ
Этот контекст фиксируется семантической моделью, зависящей от конкретного варианта использования (эта модель является частью продукта данных, ориентированного на потребителя; скоро мы увидим, насколько). Как только этот контекст будет зафиксирован, он автоматически будет перенесен на вышестоящие уровни продуктов. Инженеры-аналитики и специалисты по моделированию данных, создающие продукты aggregate Data, точно знают, что нужно сопоставлять и какие показатели качества использовать для обслуживания последующей семантической модели.
Этот агрегированный продукт данных (также с компонентом семантической модели) передает бизнес-контекст на более удаленный уровень (ближе к источникам данных). Обратите внимание, что до сих пор не происходило перемещения или обработки данных.
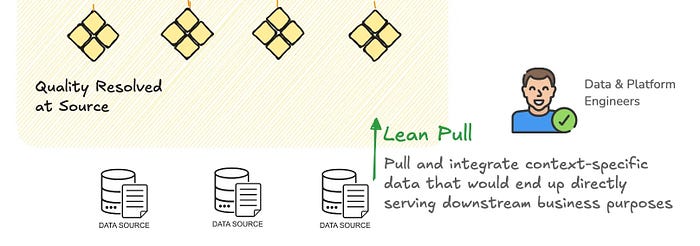
Как только контекст попадает к источнику, инженеры Data & Platform получают очень четкое представление о том, какие данные следует переместить и какие качественные рабочие нагрузки следует выполнить для удовлетворения конкретных запросов в нисходящем потоке. У них есть полная ясность и представление о том, какие варианты использования данных будут использоваться, какие объекты необходимы и какие SLO требуются как на локальном, так и на глобальном уровнях.
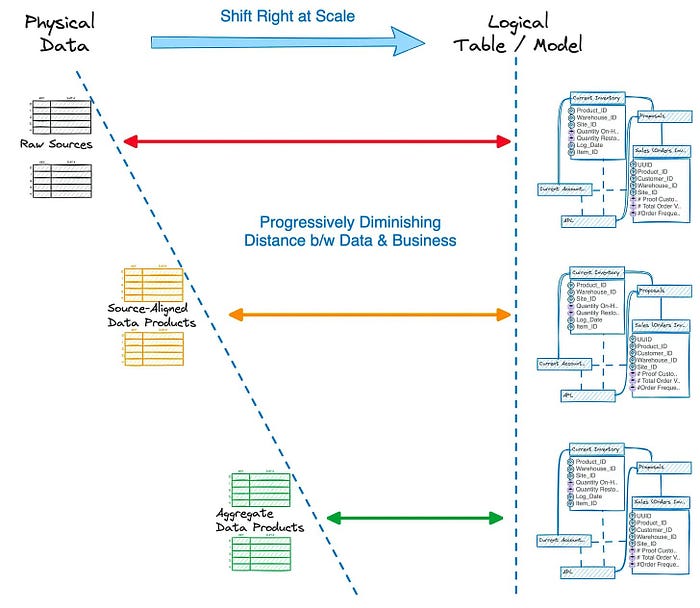
Управление изменениями в бизнесе
Любой запрос на изменение имеет один и тот же жизненный цикл, когда пользователь просто добавляет контекст к семантическому аналогу продукта данных, и тот же контекст передается в крайний левый раздел, где начинается реальная работа и данные доходят до потребителя.
Важно понимать, что этот процесс не отнимает много времени, и на самом деле частота развертывания в экосистемах продуктов обработки данных намного выше, чем в традиционных архитектурах, таких как medallion. Это происходит благодаря контекстуальному взаимодействию, которое обеспечивает экосистема продуктов обработки данных.
Основные моменты кейса: Критические аргументы
Выдвигая аргументы против архитектуры Medallion, мы основывали их на сравнительном анализе и сравнении привлекательности с другими архитектурными решениями. Механизмы распространения информации и то, как каждый из них влияет на стек данных и граждан на разных уровнях. При этом мы слегка коснулись нескольких критических аргументов, которые заслуживают отдельного упоминания.
А: Перекладываем основную работу на потребителей данных!
Архитектура Medallion с ее многоуровневым подходом возлагает на потребителей данных большую операционную нагрузку. Благодаря прогрессивному процессу доработки, она, по сути, задерживает доступ к значимым аналитическим данным, требуя от нижестоящих команд выполнения сложных преобразований.
Эта модель обременяет потребителей данных (аналитиков, специалистов по обработке данных или разработчиков приложений) необходимостью постоянно ожидать данных, подготовленных кураторами, или разрабатывать собственные преобразования. Это влечет за собой увеличение трения, дублирование усилий и несогласованную бизнес-логику, разбросанную по командам. Потребители получают то, что диктуют вышестоящие конвейеры, что оставляет им мало возможностей для управления формированием данных в соответствии с их потребностями.
Напротив, архитектура продукта обработки данных меняет парадигму, делая акцент на Обработка данных с помощью сдвига влево или справа налево. Вместо того, чтобы передавать частично обработанные данные по потоку и перекладывать работу по преобразованию на потребителей, информационные продукты разрабатываются как объекты, ориентированные на потребителя - упакованные, доступные для обнаружения и надежные с самого начала. Смещая ответственность влево (ближе к тому месту, где создаются данные и осуществляется управление ими), организации устраняют узкие места, сокращают время создания ценности и предоставляют модель "контекст-толчок", при которой потребители запрашивают и получают именно то, что им нужно.
B: Усугубляет проблемы с качеством
Архитектура Medallion часто усугубляет проблемы с качеством данных, а не решает их. На каждом уровне выполняются поэтапные преобразования, но ошибки и несоответствия, которые появляются на ранних этапах, беспрепятственно распространяются по уровням. Поскольку преобразования часто применяются на разных этапах разными командами, ответственность за качество данных становится фрагментарной. Часто обнаруживаются отклонения в схеме, несоответствия данных и устаревшие или некорректные данные, что требует дорогостоящих усилий по отладке и согласованию. Ошибки передаются по цепочке, где пользователи данных должны либо обнаруживать проблемы и сообщать о них (после их устранения), либо создавать свои собственные исправления (потребителю требуется больше работы).
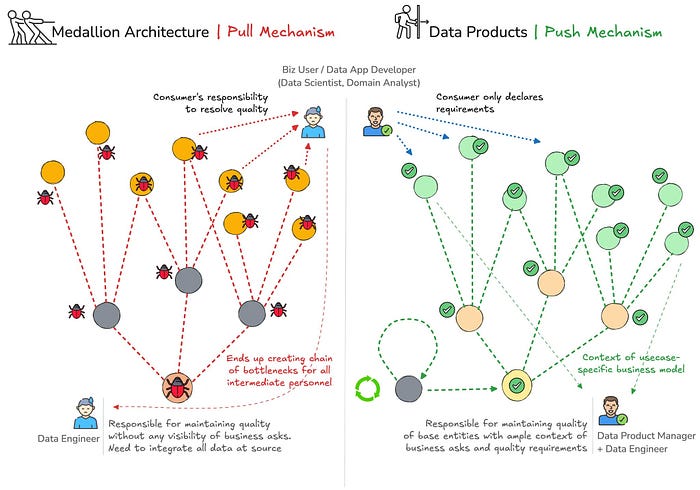
Сочетание условий качества на разных уровнях в архитектурах Medallion и Data Product
С другой стороны, экосистема продуктов обработки данных с самого начала заботится о качестве, применяя подход "Сдвиг влево", при котором механизмы контроля качества, валидации и управления внедряются как можно раньше в схему происхождения данных. Благодаря тому, что данные рассматриваются как продукт с четко определенными соглашениями об уровне обслуживания, контрактами и правами собственности, качество активно поддерживается в источнике, а не откладывается на потом в процессе использования. Потребители взаимодействуют только с высококачественными и надежными данными, снижая операционные издержки и повышая доверие и удобство использования.
C: Ненужное перемещение данных: увеличивает затраты и задержку выполнения
Чрезмерное перемещение данных между различными уровнями приводит к высоким эксплуатационным расходам и задержкам. По мере прохождения данных по уровням Medallion они многократно извлекаются, преобразуются и загружаются (ETL), что приводит к избыточным копиям или ненужным преобразованиям.
Это усложняет работу и увеличивает нагрузку на обслуживание, особенно при работе с большими объемами данных. Постоянный обмен данными увеличивает риск того, что они станут устаревшими или противоречивыми, что увеличивает техническую задолженность. Поскольку данные перемещаются и преобразуются на каждом этапе, это увеличивает время обработки и затраты на инфраструктуру.
В отличие от этого, архитектура продуктов обработки данных сводит к минимуму ненужное перемещение данных, обеспечивая децентрализованное, целенаправленное перемещение и обработку данных. Результатом является минималистичная экосистема данных с данными, которые непосредственно используются нижестоящими приложениями или вариантами использования. Общая картина, огромная экономия вычислительных ресурсов и хранилища на каждом уровне, где преобразования являются экономичными и согласованы с конкретными потребностями бизнеса.
D: Отсутствие понимания контекста/бизнеса на вышестоящих уровнях Medallion
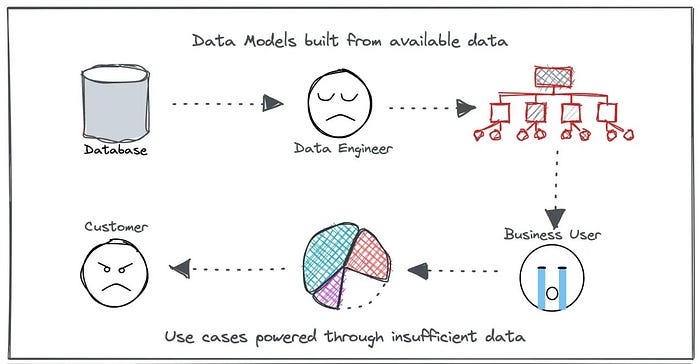
Одним из фундаментальных недостатков архитектуры Medallion является отсутствие бизнес-контекста на вышестоящих уровнях. Поскольку архитектура делает упор на поэтапную доработку, качество данных остается неизменным вплоть до заключительных этапов. В результате получается система, в которой исходные данные часто лишены необходимого контекста, который делает их значимыми для принятия решений. Поскольку оценка качества проводится без тесной связи с бизнес-целями, система рискует быть оптимизированной с точки зрения технической полноты, а не деловой значимости.
Нижестоящим командам приходится заново вводить утраченный контекст, и к тому времени, когда данные доходят до предполагаемых потребителей, любые ошибки преобразования или несоответствия бизнес-логике оказываются глубоко укоренившимися. Это также приводит к задержкам в принятии решений, поскольку ценная информация полностью осознается только на уровне Gold, к этому времени потенциальные возможности могут быть упущены.
Подход к разработке продуктов обработки данных принципиально отличается от подхода, основанного на внедрении бизнес-контекста как можно раньше. Вместо того, чтобы рассматривать необработанные данные как изолированный ресурс, который постепенно приобретает значение, информационные продукты с самого начала разрабатываются с четким намерением и удобством использования (контекстно-ориентированный подход).
E: Ограниченные возможности использования и большие очереди ожидания
Жесткая структура Medallion ограничивает режимы использования. Потребители данных вынуждены использовать предопределенные пути, обычно это таблицы на основе пакетной обработки или API, предназначенные для конкретных конечных пользователей. Если команде нужны данные в другом формате, с другой степенью детализации или с другим механизмом доставки (например, потоковые события), им часто приходится ждать дополнительных преобразований или создавать собственные обходные пути. Поэтапная доработка также увеличивает время ожидания для последующих пользователей. Длинные очереди на обработку, ожидающие завершения преобразований.
Информационные продукты, напротив, разрабатываются с учетом собственной доступности и различных моделей потребления (чтобы соответствовать предпочтениям потребителей данных). “Порты вывода” вам что-то говорят? Одни и те же данные, но множество вариантов использования. Это значительно ускоряет внедрение данных в нишевые бизнес-процессы, которые имеют встроенные инструменты и предпочтительные способы использования данных.
- Пакетный, потоковый и управляемый API доступ: Продукты для обработки данных предоставляют множество вариантов использования, позволяя бизнес-пользователям, приложениям и моделям ML получать доступ к данным с помощью API, потоков в реальном времени или запланированного пакетного экспорта.
- Модель самообслуживания: Вместо того, чтобы ждать преобразований в восходящем потоке, потребители данных могут взаимодействовать с продуктами данных на разных уровнях детализации или запрашивать предпочтительные режимы использования на основе своего варианта использования или встроенных стеков инструментов.
- Оптимизирован для архитектуры, управляемой событиями: Благодаря встроенным возможностям потоковой передачи, продукты обработки данных интегрируются в современные системы, управляемые событиями, что позволяет принимать решения в режиме реального времени, не дожидаясь запланированных преобразований.
F: Medallion создает хрупкие основы
Архитектура Medallion может показаться структурированной, но она создает хрупкий фундамент данных — каждый уровень сильно зависит от предыдущего, что означает, что сбои или неэффективность будут возникать в дальнейшем.
В отличие от этого, подход, основанный на использовании продуктов данных, ставит во главу угла прочные, автономные основы. Вместо того, чтобы полагаться на иерархическую модель преобразования, продукты данных с самого начала разрабатываются таким образом, чтобы их можно было повторно использовать и они были самодостаточными.
Заключительное замечание
Вместо архитектуры Medallion:
- Продукты данных, основанные на моделях: Определяйте структуры данных и стеки с учетом бизнес-моделей и аналитических потребностей, а не произвольных и фиксированных этапов преобразования.
- Создайте мощный семантический центр: инвестируйте в понимание семантических уровней, деревьев показателей и продуктов обработки данных и того, как они помогают создавать контекстно-зависимую базу данных.
- Lakehouse с полезными данными вместо ВСЕХ данных ЦЕЛИКОМ: Сократите количество ненужных уровней благодаря целенаправленному хранению и обработке.


