

Качество данных не должно быть сложным
Три решения с нулевыми затратами, Которые Требуют Часов, А Не Месяцев
В моей карьере инициативы по повышению качества данных обычно означали серьезные изменения. От процессов управления до дорогостоящих инструментов и внедрения dbt – проекты по повышению качества данных, похоже, никогда не хотят быть маленькими.
Более того, устранение проблем с качеством данных таким образом часто приводит к возникновению новых проблем. Больше сложности, больше затрат, медленнее публикуются данные в проекте…
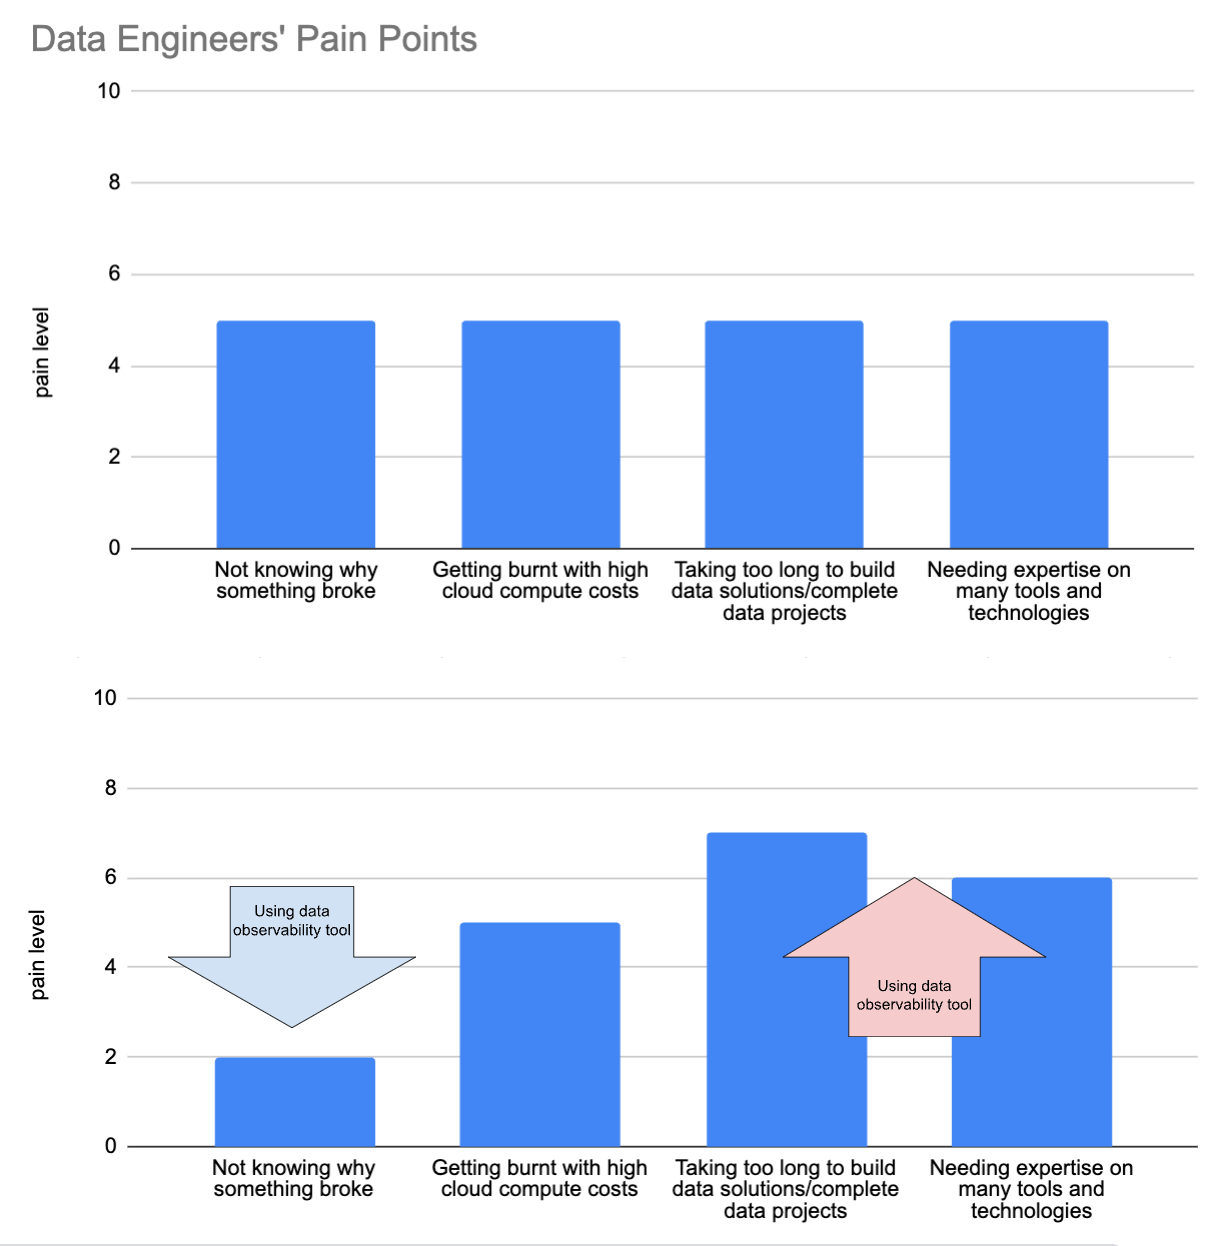
Но это не обязательно должно быть так.
В то время как таким компаниям, как Google и Meta, требуются обширные системы обеспечения качества данных из-за их огромного масштаба и сложности, большинство организаций могут добиться превосходного качества данных с помощью гораздо более простых подходов.
В этой статье мы рассмотрим три метода, которые малые и средние проекты по обработке данных могут использовать для быстрого улучшения качества своих данных, сводя при этом сложность к минимуму, а новые затраты - к нулю. Давайте перейдем к делу!
TL;DR
- Воспользуйтесь старыми приемами работы с базами данных, такими как перечисление типов данных и ограничения столбцов.
- Создайте пользовательскую панель мониторинга для решения вашей конкретной проблемы с качеством данных.
- Создайте линейку данных с помощью одного небольшого скрипта на Python.

Воспользуйтесь старыми приемами работы с базами данных
За последние 10-15 лет мы стали свидетелями масштабных изменений в индустрии обработки данных, в частности, больших объемов данных, параллельной обработки, облачных вычислений, хранилищ данных и новых инструментов (множества новых инструментов).
В результате нам пришлось отказаться от некоторых вещей, чтобы освободить место для всего этого нового. Есть положительные моменты (на ум приходит Microsoft Access), но некоторые из них в лучшем случае сомнительны, например, традиционные принципы проектирования данных, качество данных и их проверка при приеме. Последнему и будет посвящен данный раздел.
Во-первых, что я подразумеваю под "качеством данных и их проверкой при приеме"? Проще говоря, это означает проверку данных перед их вводом в таблицу. Представьте вышибалу у входа в ночной клуб.
На смену ему пришел метод построения с последующим тестированием, который означает сначала внесение новых данных в таблицы, а затем их последующую проверку. Метод построения с последующим тестированием является предпочтительным для многих современных инструментов обеспечения качества данных, включая самый популярный - dbt.
Сначала Dbt запускает весь конвейер преобразования данных, и только после того, как все новые данные будут готовы, он проверяет, соответствуют ли они действительности. Конечно, во многих случаях это может быть оптимальным решением. Например, если бизнес готов пожертвовать качеством ради скорости, или если перед рабочей таблицей стоит таблица контроля качества (в Netflix ее называют "Запись-аудит-публикация"). Однако инженеры, которые используют только этот метод контроля качества данных, потенциально упускают некоторые важные преимущества для своей организации.
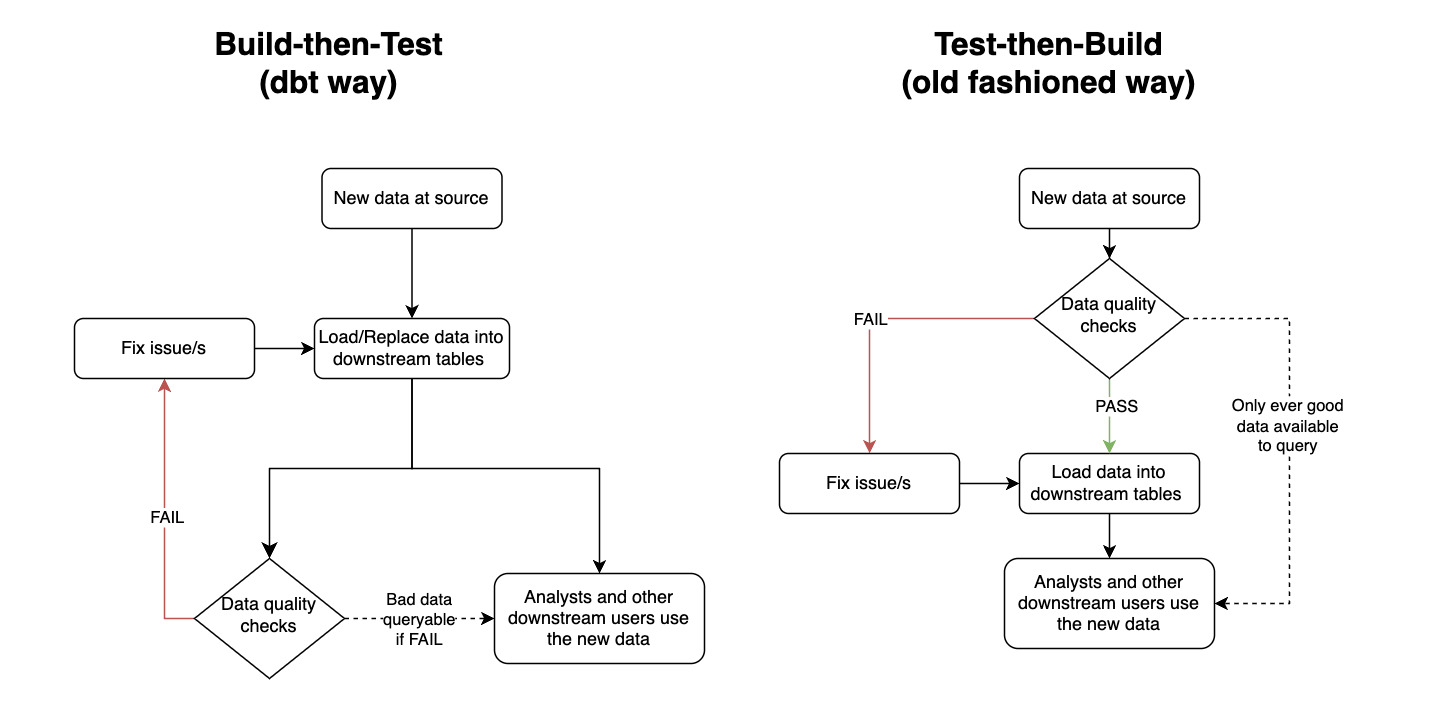
Test-then-build имеет два основных преимущества перед build-then-test.
Во-первых, это гарантирует, что данные в последующих таблицах соответствуют стандартам качества, которые всегда ожидаются. Это придает данным уровень надежности, которого так часто не хватает пользователям последующих таблиц. Это также может снизить беспокойство инженера по обработке данных, ответственного за конвейер.
Я помню времена, когда у меня был ключевой финансовый конвейер для компании, в которой я раньше работал. К сожалению, этот конвейер был очень подвержен проблемам с качеством данных, и решением была система сборки, а затем тестирования, которая запускалась каждую ночь. Это означало, что мне нужно было каждый день рано утром спешить на свою станцию, чтобы проверить результаты прогона, прежде чем другие пользователи начнут просматривать свои данные. Если возникали какие-либо проблемы, мне нужно было либо быстро устранить их, либо отправить компании официальное сообщение о том, что данные отстойные, и, пожалуйста, наберитесь терпения, пока я их исправляю.
Конечно, тестирование, а затем сборка не устраняет проблему беспокойства полностью. Ситуация изменилась бы от необходимости в срочном устранении проблемы, чтобы избежать получения некачественных данных для последующих пользователей, к необходимости в срочном устранении проблемы, чтобы избежать получения устаревших данных для последующих пользователей. Однако инженерный подход заключается в взвешивании плюсов и минусов различных решений. И я знаю, что в этом случае старые данные были бы лучшим из двух зол как для бизнеса, так и для моего здравомыслия.
Второе преимущество метода тестирования с последующей сборкой заключается в том, что его гораздо проще реализовать, особенно по сравнению с настройкой всей области контроля качества, которая представляет собой простое решение для решения большинства проблем с качеством данных. Все, что вам нужно сделать, это указать свои критерии качества данных при создании таблицы. Посмотрите на приведенный ниже запрос PostgreSQL:
CREATE TYPE currency_code_type AS ENUM (
    'USD', -- United States Dollar
    'EUR', -- Euro
    'GBP', -- British Pound Sterling
    'JPY', -- Japanese Yen
    'CAD', -- Canadian Dollar
    'AUD', -- Australian Dollar
    'CNY', -- Chinese Yuan
    'INR', -- Indian Rupee
    'BRL', -- Brazilian Real
    'MXN'  -- Mexican Peso
);

CREATE TYPE payment_status AS ENUM (
    'pending',
    'completed',
    'failed',
    'refunded',
    'partially_refunded',
    'disputed',
    'canceled'
);

CREATE TABLE daily_revenue (
    id INTEGER PRIMARY KEY,
    date DATE NOT NULL,
    revenue_source revenue_source_type NOT NULL,
    gross_amount NUMERIC(15,2) NOT NULL CHECK (gross_amount >= 0),
    net_amount NUMERIC(15,2) NOT NULL CHECK (net_amount >= 0),
    currency currency_code_type,
    transaction_count INTEGER NOT NULL CHECK (transaction_count >= 0),
    notes TEXT,

    CHECK (net_amount <= gross_amount),
    CHECK (gross_amount >= processing_fees + tax_amount),
    CHECK (date <= CURRENT_DATE),
    CONSTRAINT unique_daily_source UNIQUE (date, revenue_source)
);
Эти 14 строк кода обеспечат соответствие таблицы daily_revenue следующим стандартам:
id
- ограничение первичного ключа id гарантирует уникальность.
date
- Не может быть будущей датой (с помощью ограничения CHECK).
- Является частью уникального ограничения с помощью revenue_source.
revenue_source
- Не может быть нулевым.
- Является частью уникального ограничения с помощью date.
- Должно быть допустимым значением из перечисления revenue_source_type.
gross_amount
- Не может быть нулевой.
- Должно быть >= 0.
- Должно быть >= обработка_платежей + сумма налогов_.
- Должно быть >= net_amount.
- Точная десятичная обработка.
net_amount
- Не может быть NULL.
- Должно быть >= 0.
- Должно быть <= gross_amount.
- Точная десятичная обработка.
currency
- Должно быть допустимым значением из перечисления currency_code_type.
transaction_count
- Не может быть нулевым.
- Должно быть >= 0.
Все просто. Надежный. И можете ли вы поверить, что все это стало доступно нам с момента выпуска PostgreSQL 6.5... который вышел в 1999 году!
Конечно, бесплатного обеда не бывает. Применение ограничений таким способом имеет свои недостатки. Например, это делает таблицу намного менее гибкой и снижает производительность при обновлении таблицы. Как всегда, вам нужно подумать как инженеру, прежде чем переходить к какому-либо инструменту/технологии/методу.
Создайте пользовательскую панель мониторинга
Я хочу кое в чем признаться. Раньше я думал, что хорошие инженеры по обработке данных не используют инструменты информационной панели для решения своих проблем. Я думал, что настоящий инженер просматривает журналы, трудночитаемый код и все остальное, что позволяет ему выглядеть умным, если кто-то когда-нибудь посмотрит на экран его компьютера.
Я был тупицей.
Оказывается, они могут быть действительно полезными, если выполняются эффективно и с четкой целью. Кроме того, большинство инструментов бизнес-аналитики позволяют создавать информационные панели очень просто и быстро, не тратя (слишком) много времени на изучение этого инструмента.
Вернемся к моему личному опыту работы с конвейерами. Раньше я управлял ежедневной сводной таблицей всех источников дохода для бизнеса. Каждый источник поступал от разных поставщиков доходов и, следовательно, от разных систем. Некоторые из них поступали с помощью вызовов API, другие - по электронной почте, а третьи - через общую корзину S3. Как и следовало ожидать любому инженеру, некоторые из этих источников время от времени выходили из строя, и поскольку они поступали от третьих лиц, я не мог устранить проблему в источнике (только запросить, что имело очень ограниченный успех).
Изначально я использовал журналы сбоев только для определения того, где что-то требовало исправления. Проблема была приоритетной. Некоторые сбои требовали быстрого устранения, в то время как другие были недостаточно важны, чтобы из-за них отказываться от всего (у нас были источники дохода, которые приносили буквально копейки в день). В результате возникли небольшие проблемы с качеством данных, которые стало трудно отслеживать.
Я создал очень простую панель мониторинга, в которой отображались метаданные по источнику дохода и дате за последние 14 дней. Мне было достаточно трех показателей:
- Зеленая или красная метка указывала, присутствуют данные или отсутствуют.
- Количество строк в данных.
- Сумма доходов от данных.
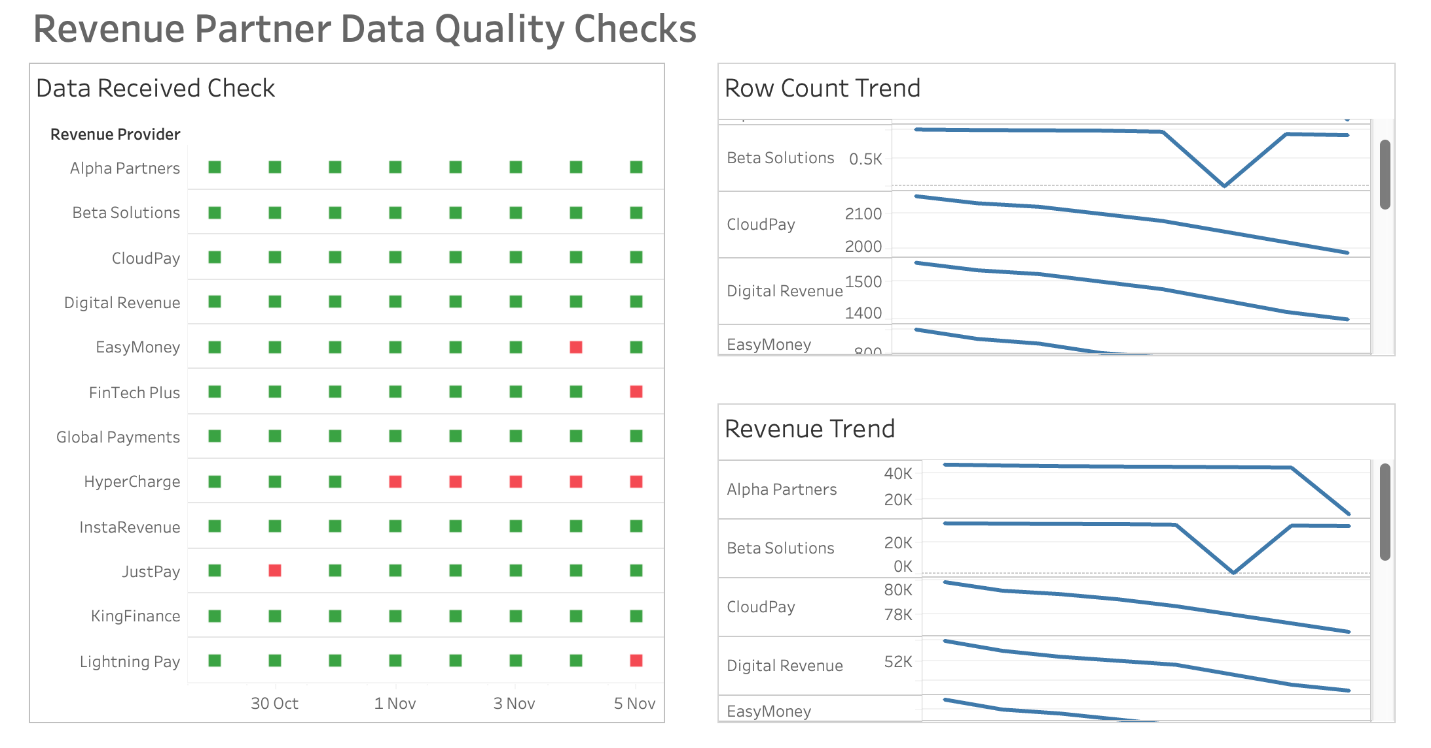
Это значительно упростило управление качеством данных в конвейере. Это не только позволило мне гораздо быстрее разобраться в том, где были проблемы, но и стало достаточно удобным для чтения другими людьми, что позволило разделить ответственность.
После внедрения информационной панели количество сообщений об ошибках, о которых сообщал бизнес, связанный с конвейером, сократилось практически до нуля, как и риск инсульта.
Сопоставьте свои данные с помощью линейной диаграммы
Простые решения для обеспечения наблюдаемости данных не ограничиваются информационными панелями.
Анализ данных может стать мечтой для быстрого определения того, на какие таблицы повлияли неверные данные в восходящем потоке.
Однако это также может оказаться сложной задачей для реализации.
- На мой взгляд, главным виновником этого является dbt. Ключевым преимуществом этого инструмента с открытым исходным кодом являются его возможности передачи данных. Но чтобы достичь этого, вы должны подчиниться принципам dbt. Включая, но не ограничиваясь этим:
- Внедрение Jinja3 во все ваши SQL-файлы.
- Создаем файл YAML для каждой модели данных.
- Добавляем конфигурацию исходных данных с помощью файлов YAML.
- Настраиваем процесс разработки и тестирования, например, среду разработки, систему управления версиями, CI/CD.
Настройка инфраструктуры, например, размещение собственного сервера или покупка управляемой версии (dbtCloud).
Да, это много.
Но это не обязательно. В конечном счете, все, что вам нужно для работы с динамическими данными lineage, - это компьютер, который сканирует ваши SQL-файлы, и что-то для вывода удобной для пользователя карты lineage. Благодаря Python это может быть достигнуто с помощью скрипта, содержащего всего 100 строк кода.
Если вы немного разбираетесь в Python и владеете LLM-подсказками, вы сможете взломать код за час. В качестве альтернативы, существует легкий инструмент с открытым исходным кодом на Python под названием SQL-WatchPup, в котором уже есть код.
При условии, что у вас есть все доступные файлы SQL, через 15 минут настройки вы сможете генерировать динамические карты происхождения данных, например, таким образом:
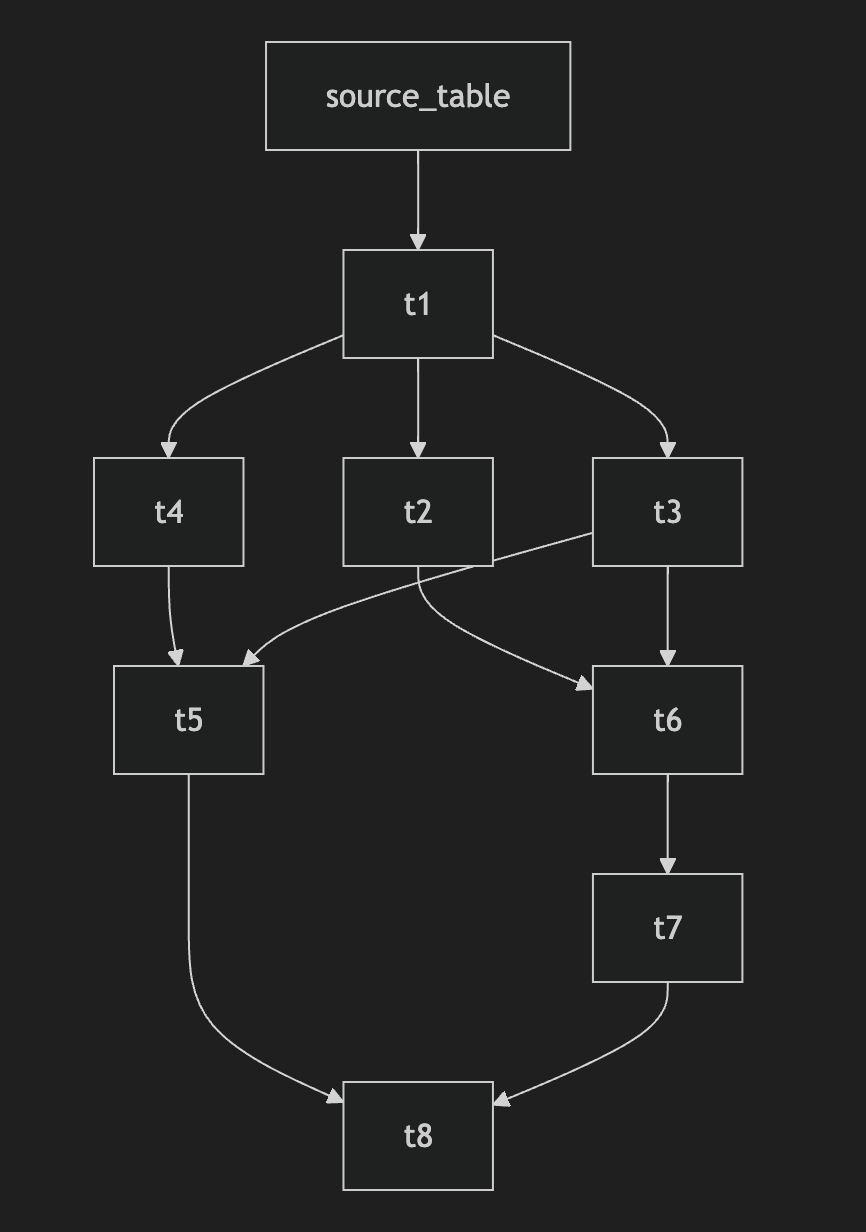
Это оно. Никаких затрат на размещение сервера. Никаких дополнительных компьютерных языков для изучения. Никакой реструктуризации ваших файлов. Просто запустите один простой скрипт на Python локально.
Вывод
Давайте посмотрим правде в глаза – мы все любим новые модные инструменты, но иногда лучшие решения оказываются старыми, некрутыми и/или непопулярными.
В следующий раз, когда у вас возникнут проблемы с качеством данных, сделайте шаг назад, прежде чем приступать к масштабной перестройке инфраструктуры. Спросите себя: могут ли помочь простое ограничение базы данных, базовая панель мониторинга или легкий скрипт на Python?
Ваше здравомыслие будет благодарно вам за это. Бюджет вашей компании тоже изменится.


