

Эволюция архитектур данных: от DWH к Data Mesh
Данные стали ключевым ресурсом для бизнеса, но их эффективное использование требует продуманных подходов к хранению и обработке.
Эпоха современных хранилищ данных началась с появления реляционных баз данных. Далее, с развитием BI появились DWH. Дальнейший рост объемов данных и возникновение термина Big Data привели к последуюшей эволюции архитектур данных, со временем появились такие новые концепции, как Data Lake, Data Lakehouse, Data Fabric и Data Mesh.
В этой статье мы рассмотрим путь развития технологий работы с данными и сравним все выше упомянутые концепции.
1. Хронология развития хранилищ данных
Основные этапы:
- 1960–1970-е гг.: Развитие банковской и финансовой сфер обусловило потребность в надежной модели хранения и обработки данных. В 1959 году организация CODASYL создала свой собственный язык программирования COBOL, а в 1969 году опубликовала его спецификацию для модели данных CODASYL (CODASYL Data Model). Примерно в это же время появилась концепция информационной экономики и прототипы BI, в 1966 году для программы «Аполлон» компанией IBM была разработана первая промышленная СУБД — иерархическая система IMS (Information Management System);
- 1970–1980-е гг.: Эдгар Франк Кодд начал работу над упрощением принципов хранения данных. В 1970 году он издал статью под названием «Реляционная модель данных для больших общих банков данных», которая стала основой для появления реляционной модели данных, а также послужила толчком для создания языка программирования SEQUEL (Structured English Query Language), который затем превратился в SQL. В 1976 году была разработана ER‑модель данных (Entity‑Relationship model), а в 1979 году была выпущена первая версия РСУБД Oracle Database на базе SQL. В 1980 году появилась СУБД dBASE, ставшая самым популярным на то время решением
- 1980–1990-е гг.: Э. Кодд опубликовал 12 правил Кодда, которым должна соответствовать каждая РСУБД. В 1986 г. Была представлена первая версия стандарта языка SQL, а в 1987 году был принят первый международный стандарт SQL — ICO SQL-87. В этом же году стартовал проект POSTGRES по созданию одноименной СУБД для исследовательских и производственных задач. IBM разработала семейство продуктов для управления данными DB2, предоставившее удобный интерфейс для заполнения данных и средства для генерации отчетов. В этот же период появились термины OLTP — Online Transaction Processing (обработка транзакций в режиме реального времени) и Business Intelligence.
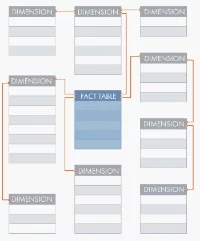
- 1990–2000-е гг.: В 1991 году Билл Инмон опубликовал книгу «Building the Data Warehouse» и ввел в обиход концепцию DWH как централизованного хранилища данных. Антагонистом его теории стал Ральф Кимбалл, чья идея была направлена на денормализацию структуры хранилища и упрощения анализа. Их концепции остаются популярными до сих пор и часто используются параллельно. В 1993 году Э. Кодд предложил «12 правил аналитической обработки в реальном времени», ознаменовавших появление OLAP (OnLine Analytical Processing). В 1990–1991 Microsoft выпустил первые релизы реляционной SQL Server, а в 1994 году появился open source проект Postgres95 (в 1996 году на его базе была создана PostgreSQL);
-
2000–2010-е гг.: Появилось понятие Big Data, началось создание высокомасштабируемых интернет‑приложений (поисковиков, сервисов электронной почты и т.д.).
Были созданы нереляционные СУБД (NoSQL), а также появилась модель распределенных вычислений MapReduce, разработанная Google. В 2006 году на ее базе была создана распределенная файловая система Hadoop (HDFS). В то же самое время была представлена модель проектирования корпоративных хранилищ данных Data Vault.
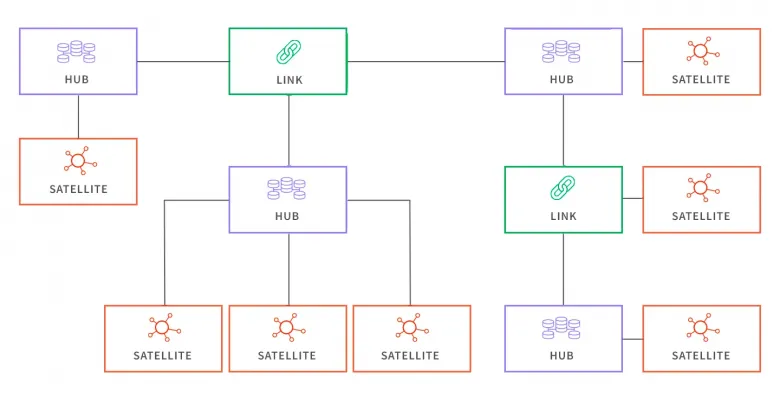
- 2010–2020-е гг.: В экосистему проектов Hadoop вошли такие фреймворки, как Apache Spark, Apache PySpark, СУБД Apache Hive и Apache Pig. Появились Data Lake и Data Fabric, более гибкие по сравнению с DWH. Спроектирована СУБД Greenplum и ClickHouse, появились Apache Airflow, Kafka, Storm. В 2011–2014 гг. появилось сразу несколько облачных хранилищ (BigQuery, Amazon Redshift, Snowflake). Появился тренд на перемещение инфраструктуры данных в облака, Data Science и машинное обучение.
- Настоящее время: Появление решений, позволяющих внедрять ML и ИИ в бизнес‑аналитику и управление данными. Разработка новых концепций: Data Lakehouse и Data Mesh.

2. Data Warehouse vs. Data Lake
Основными процессами в управлении хранилищами данных являются: ETL — Extract, Transform, Load и ELT — Extract, Load, Transform.
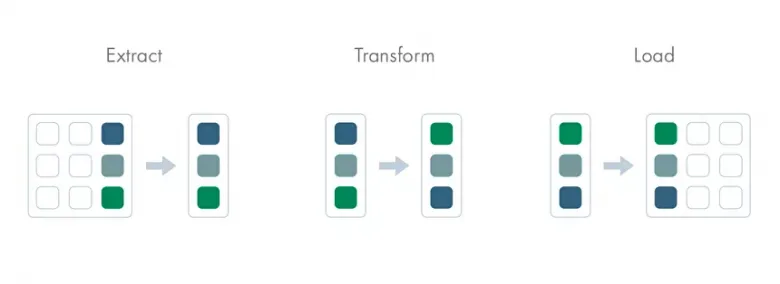
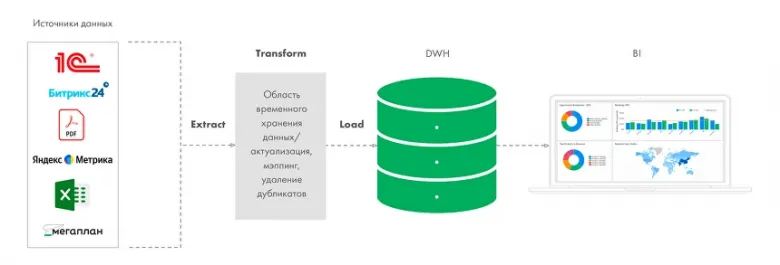
При внедрении ETL‑процесса архитектура хранилища данных состоит из 3 компонентов
- Источники данных;
- Область временного хранения данных;
- Получатель данных (DWH или база данных)
DWH — это централизованный репозиторий, предназначенный для хранения и анализа структурированных данных.
Корпоративное хранилище данных позволяет актуализировать, нормализовать, обогащать данные и объединять их из различных информационных систем в единую структуру. В корпоративных хранилищах архивные и исторические данные хранятся в формате, подходящем для анализа трендов во времени.
Появление концепции Big Data и рост объема информации повлияли на способы обработки данных, стал развиваться ELT‑подход.
В ELT‑процессе данные сначала извлекаются в «сыром» виде, затем загружаются в хранилище Data Lake и только затем преобразуются в необходимый формат.
Data Lake — хранилище, в которое поступают потоки структурированных, полуструктурированных и неструктурированных Big Data.
Неструктурированные данные — это данные, в которых отсутствует формат и упорядоченность (текстовые документы, изображения, видео и т. д.)
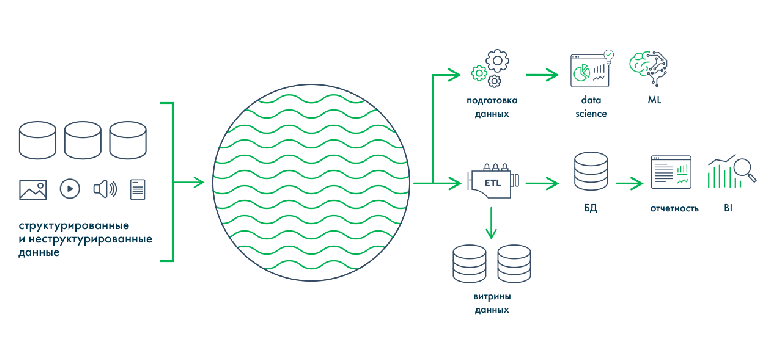
Такой поход позволяет использовать данные не только для бизнес‑аналитики, но и для инструментов искусственного интеллекта или машинного обучения. Data Lake строят на базе DFS, фреймворков Hadoop и Spark, форматов Apache Parquet или Avro, объектных хранилищ (Apache Ozon) и других open-source инструментов.
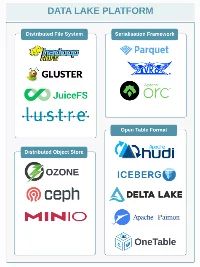
Современные крупные компании используют и DWH, и Data Lake (в зависимости от задач в области управления данными).
|
Критерий |
Data Warehouse (DWH) |
Data Lake |
|---|---|---|
|
Типы данных |
Только структурированные |
Любые: сырые, полу-/неструктурированные |
|
Обработка |
ETL (очистка перед загрузкой) |
ELT (загрузка → трансформация по запросу) |
|
Использование |
Отчетность, BI |
ML, AI, расширенная аналитика |
|
Плюсы |
Высокая скорость аналитики |
Гибкость, масштабируемость |
|
Минусы |
Ограниченный формат данных |
Риск превращения в "болото данных" |
Пример: DWH подходит для регулярной отчетности, а Data Lake — для экспериментов с ИИ.
3. Data Lakehouse: гибридный подход
Концепция Lakehouse берет свое начало от многоуровневой архитектуры Medallion Lakehouse, предложенной DataBricks. Она совмещает гибкость озер данных с четкой структурой DWH, поверх которой развертываются Apache CarbonData, Apache Iceberg, Open Delta, и Apache Hudi.
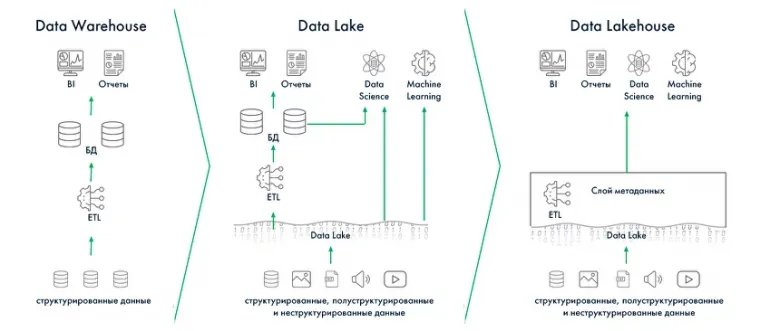
Концепция объединяет основные плюсы DWH и Data Lake:
- Единое хранилище для всех типов данных.
- Поддержка ACID-транзакций и SQL-запросов.
- Интеграция с инструментами BI и ML (например, Apache Iceberg).
Основное преимущество концепции: Упрощает инфраструктуру, но при этом требует сложной настройки.
4. Data Fabric: виртуализация и ИИ
Концепция Data Fabric призвана обойти ограничения, связанные с работой с большими объемами разрозненной информации.
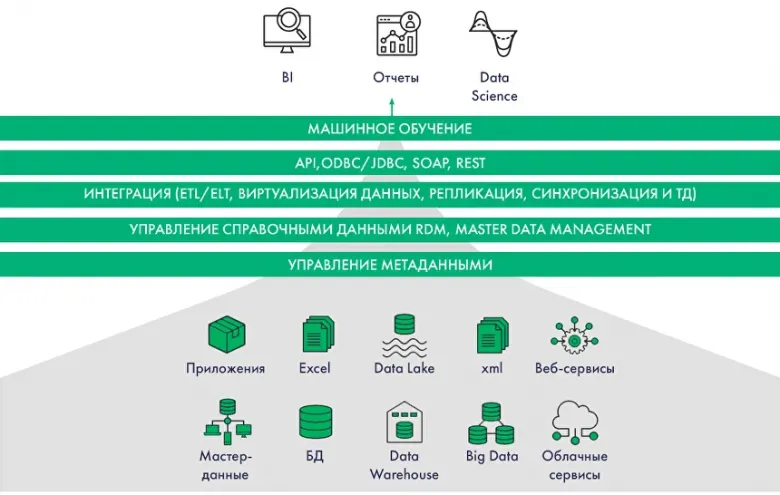
Data Fabric — дополнительный слой виртуализации данных, состоящий из технологий обработки данных в режиме реального времени, API‑интерфейсов, MDM, семантических сетей, инструментов искусственного интеллекта и машинного обучения, а также методик Data Governance.
Важно понимать, что данная концепция - это не хранилище, а именно слой для управления разрозненными данными через:
- ML-алгоритмы (для автоматизации интеграции);
- Метаданные (для отслеживания связей между данными
Пример концепции: Arenadata EDP.
Зачем нужна концепция Data Fabric: в разы ускоряет доступ к данным из разных источников без физического перемещения.
5. Data Mesh: децентрализация данных
Концепция Data Mesh сфокусирована на Data Governance, а также на повышении качества данных.
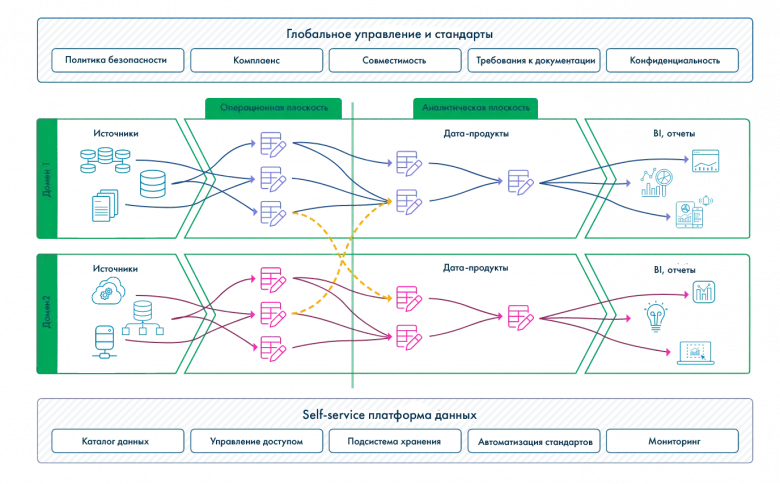
Данная концепция основана на идее децентрализации данных — их распределении и владении отделами компании (доменам), к каждому из которых прикреплена собственная ИТ‑команда.
Конечный результат работы каждого домена - дата‑продукт, обладающий собственными стандартами и метриками.
Итак, основные принципы концепции:
- Владение данными передается бизнес-доменам (например, отделу продаж).
- Self-serve платформа для самостоятельной работы с данными.
- Дата-продукты — стандартизированные выходные данные доменов.
Данная концепция в первую очередь подходит крупным компаниям с распределенными командами.
Для чего предназначена каждая концепция?
- DWH: Стандартная аналитика и регулярная отчетность;
- Data Lake: Работа с Big Data и ИИ.
- Data Lakehouse, Data Fabric, Data Mesh: дополнительные уровни работы с данными, охватывающие организационную структуру компании.
Совет: Начните с аудита имеющихся данных и определения Ваших бизнес-целей, так Вы сможете быстрее определиться с тем, какая концепция подходит Вам больше всего.


