

Современная архитектура данных: различные подходы к построению DWH
В современном мире, где каждый клик и каждая транзакция сразу же фиксируются и становятся данными, на первый план выходит архитектура данных. Современные архитектуры данных — это не просто традиционные DWH, это достаточно сложные системы, обеспечивающие оперативный доступ к искомой информации и возможность эффективной обработки Big Data.
Архитектуру данных можно сравнить со «скелетом» информационной системы, определяющим то, как данные собираются, хранятся, трансформируются, передаются и т.д. Она прошла достаточно долгий путь развития: от простых файловых систем до комплексных облачных и распределенных решений. По мере своего эволюционирования архитектура данных столкнулась с различными подходами к ее построению, каждый из которых обладает своими плюсами и минусами. Наиболее знаковыми из них являются классические подходы, предложенные У. Инмоном и Р. Кимбаллом.
Подходы к проектированию архитектуры DWH
Классические подходы:
- DWH по Инману (3NF) ориентированы на создание единого, интегрированного хранилища данных;
- DWH по Кимбаллу (звезда, dimensional modelling) сфокусированы на построении многомерных моделей, пригодных для аналитических целей;
- Modern stack (архитектура Big Data) предлагает наиболее гибкие и масштабируемые решения.
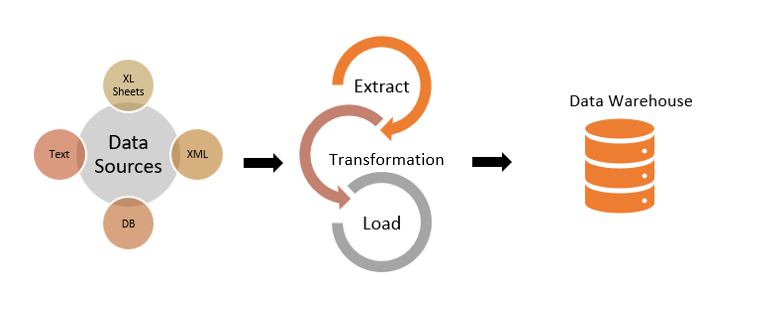
Модель Инмона
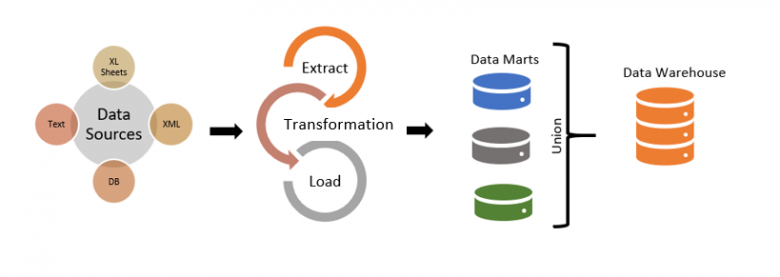
Модель Кимбалла
Как правило, современные DWH состоят из несколько слоев:
- Staging Area (область подготовки данных);
- Operational Data Store (операционное хранилище данных);
- DDS или Detailed Data Store (детальный слой);
- Data Mart (презентационный слой).
В отдельных случаях слоев может быть гораздо больше.
В частности, в современном DWH могут быть представлены следующие слои: stg lake, lake, stg ods, ods, специализированный слой для ML и т.д. Благодаря этому у компаний сегодня есть множество возможностей по организации и анализу своих корпоративных данных.

3-х уровневая архитектура данных
Kappa vs. Lambda
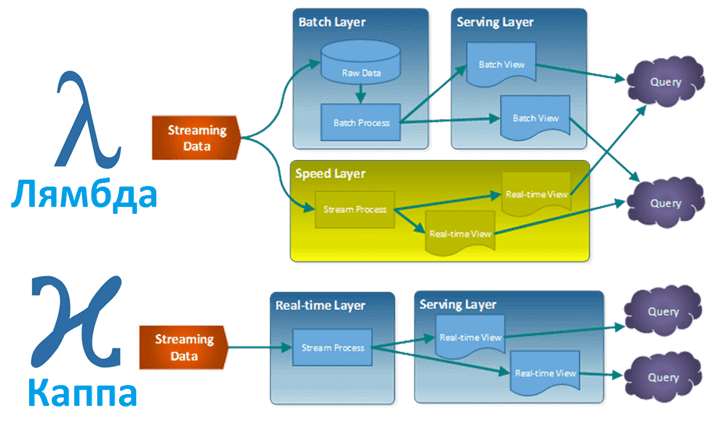
Лямбда и Каппа – современные архитектуры Big Data, представляющие собой 2 разных подхода к построению ETL - пайплайнов.
- Lambda-архитектура
Подход, способный достаточно быстро адаптироваться к постоянно изменяющимся рыночным условиям и обеспечивать максимально возможную релевантность предложений. Данный архитектурный тип больше всего подходит для решения таких задач, как персонализированная рассылка предложений о скидках, где необходимо учитывать как исторические данные о клиентах, так и их текущее местонахождение.
Основные компоненты Lambda-архитектуры
- Пакетный уровень (Batch Layer): данные хранятся в своем исходном виде и обрабатываются с определенной задержкой. Это в первую очередь относится к нормативно-справочной документации, которая обновляется довольно редко. С помощью современных методов ML на данном уровне проводится анализ исторических данных (для сегментации клиентов или создания прогнозных моделей);
- Уровень скорости (Speed Layer): обеспечивает анализ данных в режиме реального времени с минимальной задержкой. Здесь для обработки информации с коротким жизненным циклом используются такие фреймворки, как Apache Spark, Storm или Flink. В данном случае на первое место выходит скорость обработки данных;
- Уровень обслуживания (Serving Layer): предоставляет удобный интерфейс для эффективного объединения данных из пакетного уровня и уровня скорости, позволяющий получить доступ к консолидированным и актуальным данным.

Таким образом, Lambda-архитектура представляет собой универсальный подход, позволяющий адаптироваться к происходящим изменениям в максимально сжатые сроки, обеспечивая при этом релевантность предложений, что особенно важно в современную цифровую эпоху.
Lambda-архитектура и Big Data
Лямбда-архитектура предназначена для эффективной работы с большими объемами данных с минимальной задержкой. Ее главными отличительными чертами являются отказоустойчивость и масштабируемость, достигаемые за счет оптимального сочетания пакетной обработки и скоростного анализа, позволяющих оперативно интегрировать новые данные, сохраняя при этом целостность и доступность исторической информации. Благодаря этому данный вид архитектуры востребован в современных Big Data проектах и широко применяется такими крупными компаниями, как Twitter, Netflix и Yahoo.
Для чего применяется Lambda-архитектура
- Одноразовая обработка запросов с применением неизменяемых DWH;
- Оперативное получение ответов и интеграция новых потоков данных;
- Сохранение исторических данных с возможностью добавления обновлений.
- Kappa-архитектура
Каппа-архитектура - модель обработки данных, где все данные представлены как последовательный поток событий, которые систематически упорядочиваются в едином журнале (при этом каждое новое событие обновляет его текущее состояние). В отличие от Lambda-архитектуры, Kappa полностью игнорирует пакетный уровень, фокусируясь на потоковой обработке в режиме реального времени и сохранении информации в форме постоянно обновляемого представления.
Kappa-архитектура в разы упрощает процесс проектирования систем Big Data, избавляя пользователей от необходимости организации пакетной обработки информации и полностью полагаясь на журнал событий. Такой подход позволяет обрабатывать данные непосредственно из журнала, дополняя их информацией из вспомогательных DWH (если в этом есть необходимость).
Технологии, используемые в Kappa-архитектуре:
- Системы постоянного логирования событий ( Apache Kafka, Amazon Kinesis);
- Фреймворки потоковых вычислений (Apache Spark, Flink);
- БД на сервисном уровне (от резидентных до специализированных решений, предназначенных для полнотекстового поиска)
Kappa-архитектура и Apache Kafka
В основном Kappa-архитектура применяется в следующих случаях:
- Пользователю необходимо настроить управление очередью событий/ запросов в распределенной файловой системе;
- Последовательность событий не фиксирована, потоковые фреймворки могут взаимодействовать с данными в любой момент времени;
- Большое значение имеют высокая доступность и устойчивость, поскольку обработка данных происходит на каждом узле системы.
Во всех этих случаях идеальным решением является использование Apache Kafka, предоставляющую собой быструю, сверх надежную и масштабируемую платформу данных. Kappa - архитектура на базе Kafka отлично подходит для таких популярных проектов, как LinkedIn, где для обслуживания множественных идентичных запросов необходимо обрабатывать и хранить большие объемы данных.
Заключение
Сегодня многообразие архитектур данных настолько велико, что открывает перед нами практически неограниченные возможности в области управления и анализа информации. Абсолютно все подходы, существующие на данный момент, представляют собой базис, на котором основаны самые мощные и гибкие системы обработки данных.
Но не стоит забывать и о том, что освоение всех этих технологий требует не только времени и усилий, но и глубоких узкоспециализированных познаний. Именно поэтому для реализации поставленных задач так важно правильно выбирать партнера или платформу данных.


