

Взбираемся на Iceberg с ClickHouse
Размышляя о 2024 годе, можно выделить одну технологию, которая неизменно выделяется: Apache Iceberg и, в более широком смысле, парадигму lakehouse. Эта тенденция проявилась во многих событиях в отрасли, начиная с приобретения Tabular компанией Databricks, недавнего анонса Amazon S3 Tables от AWS во время Re, инвестиций, которые GCP сделала для улучшения интеграции между Iceberg и BigQuery/BigLake, а также инвестиций Snowflake в Iceberg и их поддержки посредством разработки программного обеспечения.
Все эти объявления заставляют людей задуматься:
- Как ваши data lake и lakehouse интегрируются с ClickHouse?
- Какие планы у ClickHouse на 2025 год в этой области?
Эта статья в блоге ответит на эти два вопроса, а также расскажет об архитектурах, которые мы видели в полевых условиях при работе с нашими пользователями. Мы также расскажем вам о некоторых деталях реализации от нашей команды инженеров и, наконец, о дорожной карте на 2025 год!
Как вы можете использовать ClickHouse в вашем data lake и lakehouse?
Если вы посмотрите на некоторые из самых ранних запросов на получение данных в репозитории ClickHouse, вы увидите, что большое внимание уделяется интеграции с внешними системами. Со временем ClickHouse превратился в мощный мост между озерами данных и хранилищами данных, поддерживающий очереди, базы данных и хранилища объектов с совместимостью более чем с 60 форматами ввода и вывода. Эта универсальность позволяет пользователям использовать гибкость озера данных, сохраняя при этом производительность запросов в режиме реального времени.
Сегодня большинство пользователей ClickHouse используют этот подход, а S3 является одним из наиболее широко используемых источников данных как для загрузки данных, так и для специальных запросов. Такие функции, как s3Cluster и недавно представленный S3Queue (также доступный для GCS и Azure), упростили эту интеграцию, позволяя ClickHouse либо запрашивать данные на месте для предварительного анализа, либо эффективно использовать их для высокопроизводительной аналитики.
Поскольку многие компании и команды сейчас переосмысливают свои стратегии создания data lake и хранилищ данных, некоторые из них уже внедрили ClickHouse, в то время как другие только начинают изучать, насколько это согласуется с их амбициями в области lakehouse.
Существует несколько сценариев, в которых ClickHouse используется в контексте lakehouse и data lake. Мы можем условно разделить их на три категории:
- Загрузка данных из data lake/lakehouse в ClickHouse
- Специальные и объединенные запросы к data lakehouse/lakehouses
- Частые запросы к озерам данных/lakehouses
Загрузка данных из озера данных в ClickHouse
Как упоминалось ранее, одной из наших самых популярных интеграций в ClickHouse являются табличные функции s3cluster и s3queue, а также их эквиваленты для облачных хранилищ Google Cloud и Azure Blob. Пользователи обычно используют эти функции для загрузки данных в ClickHouse либо однократно (с помощью s3cluster), либо постепенно, используя s3queue. ClickPipes основана на первой из этих функций, предоставляя возможности как массовой, так и инкрементальной загрузки из хранилища объектов с семантикой "ровно один раз".
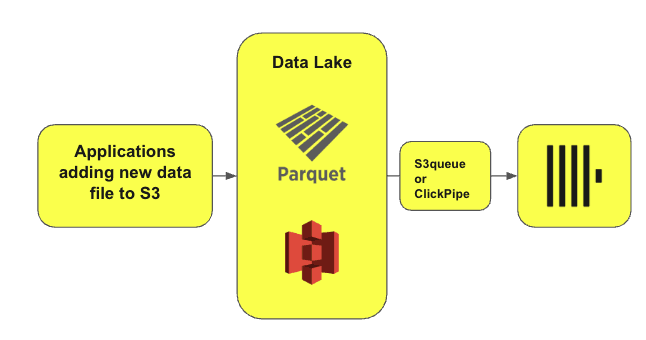
На приведенной выше диаграмме показан один из наиболее распространенных архитектурных шаблонов, часто используемый в сценариях, где приложениям необходимо добавлять данные постепенно, например, в случаях использования журналов и веб-аналитики.
В этом случае ClickHouse постоянно загружает данные из хранилища данных, сохраняя их в таблицах ClickHouse для быстрой аналитики. ClickHouse будет часто опрашивать S3, чтобы проверить, есть ли новые данные. При обнаружении новых файлов ClickHouse автоматически считывает, загружает и объединяет все данные в указанные таблицы.
Эту концепцию можно легко распространить на открытые табличные форматы, такие как Iceberg, Delta или даже Hudi.
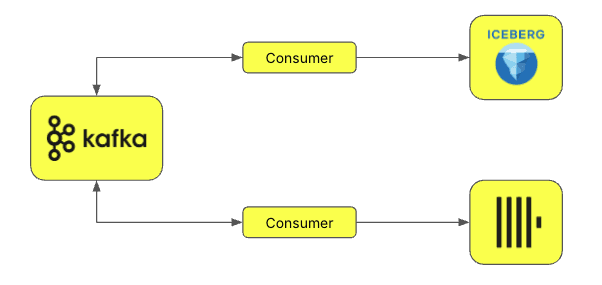
Подмножества данных также могут быть загружены из вашего хранилища данных в ClickHouse с использованием метода двойной записи. Мы видим, что этот метод используется там, где команды отвечают за свою платформу обработки данных, где основной целью является хранение большей части данных компании, обеспечивая при этом беспрепятственный доступ и удобство использования для различных команд, каждая из которых имеет свои собственные требования и инструменты. Iceberg особенно полезен для этого сценария. Данные передаются по разделу Kafka, при этом несколько пользователей одновременно загружают их в таблицы ClickHouse и Iceberg. Этот подход идеально подходит для неизменяемых данных и случаев использования только для добавления, когда записи остаются неизменными с течением времени.
Специальные и объединенные запросы к озерам данных и приозерным постройкам с помощью ClickHouse
Другой часто используемый шаблон, который мы наблюдаем в полевых условиях, - это когда клиент уже использует ClickHouse, но ему иногда требуется выполнить запрос к таблице Iceberg или Delta или даже к набору файлов на S3. Предполагая, что эти данные запрашиваются нечасто, загрузка их в ClickHouse не обязательно обеспечивает достаточную ценность. В этом случае ClickHouse также может использоваться для запроса этих данных на месте, эффективно заменяя такие технологии, как Athena. Этого можно достичь с помощью функций s3cluster, icebergCluster и deltaLakeCluster. Хотя производительность в этих сценариях не соответствует производительности встроенной таблицы ClickHouse, где время отклика в миллисекундах является нормой, нечастые шаблоны доступа обычно делают приемлемым время отклика второго порядка.
Если мы рассмотрим предыдущий пример, мы можем легко представить себе сценарий, в котором нормативные цели требуют наличия возможности проверять активность, связанную с конкретным продуктом или пользователем, в течение определенного количества месяцев.
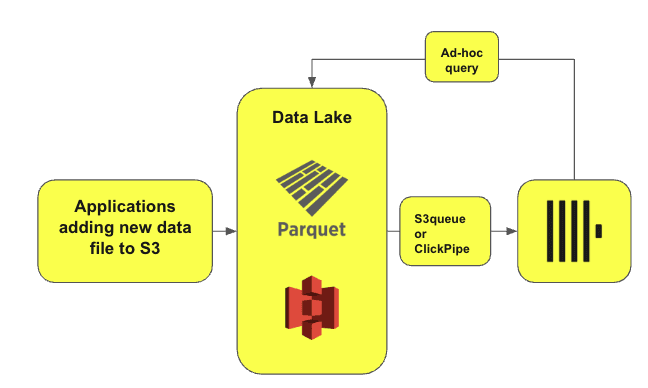
Очевидно, что эти сценарии могут быть распространены на Айсберг, Дельта-Лейк и даже на таблицы Hudi.
Таким образом, ClickHouse можно рассматривать как горячий слой, а Айсберг - как холодный. Подавляющее большинство запросов выполняется в ClickHouse, в то время как несколько запросов должны быть полностью выполнены в data lake или объединены с data lake (когда информация распределяется по этим двум хранилищам).
Учитывая универсальность и возможности интеграции ClickHouse, объединение запросов становится все более распространенным способом использования, подобно тому, как используется Athena.
Кроме того, ClickHouse поддерживает форматы файлов и открытых таблиц, что позволяет выполнять запросы к нескольким источникам данных и сопоставлять результаты. Типичными источниками для объединения запросов являются:
- PostgreSQL
- MySQL
- Data lake (S3, GCS, Azure)
- Таблица ClickHouse
- MongoDB
Это обеспечивает большую гибкость, в частности, при изучении и обработке наборов данных, которые запрашиваются недостаточно часто, чтобы оправдать их хранение в столбчатой базе данных, такой как ClickHouse.
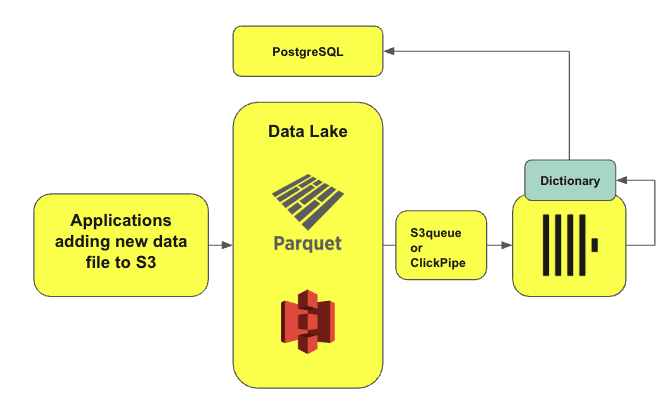
Мы также видим примеры использования, когда пользователи должны сопоставлять и обогащать строки в ClickHouse данными, хранящимися в MongoDB и PostgreSQL. В этих сценариях MongoDB и PostgreSQL могут использоваться в качестве источника словаря.
Частые запросы к данным о озерах / lakehouses с помощью ClickHouse
Чтобы лучше проиллюстрировать последний сценарий, представьте себе компанию, предоставляющую финансовые услуги или занимающуюся криптографией, которой необходимо иметь доступ ко множеству различных наборов данных для своих исследований. Несмотря на то, что доступ к этим наборам данных можно получить с помощью API или аналогичных подходов, по мере роста объемов данных и затрат на их хранение, типичным вариантом является совместное использование набора данных с использованием Iceberg или других форматов открытых таблиц. Вы можете увидеть пример этого на странице интеграции Allium. Табличные функции, такие как icebergCluster или deltaLakeCluster, позволяют ClickHouse легко выполнять запросы к таким системам. Однако в настоящее время это имеет ряд ограничений.
Собственный формат (в настоящее время) работает быстрее
Во-первых, этот подход не использует оптимизированный внутренний формат ClickHouse, что приводит к снижению производительности запросов в data lake по сравнению с данными, хранящимися в ClickHouse. Этот недостаток характерен для баз данных, поддерживающих открытые табличные форматы, где внутреннее хранилище и механизмы обработки запросов тесно взаимосвязаны. Кроме того, базы данных, которые обрабатывают как прием, так и запросы, сталкиваются с более серьезными проблемами, чем обычные механизмы обработки запросов. В 2025 году мы планируем сократить разрыв в производительности между собственным форматом ClickHouse и открытыми стандартами.
Улучшение обнаружения данных
Вторым ограничением является обнаружение данных. Хотя эта концепция существует уже некоторое время, недавно она была обновлена с появлением новых каталогов, которые помогают в поиске и интеграции таблиц, а также управляют доступом и разрешениями пользователей. Исторически сложилось так, что ClickHouse не мог автоматически обнаруживать все таблицы, управляемые каталогом, что требовало от пользователей явного указания URL-адреса таблицы Delta или Iceberg, к которой они хотели бы обратиться. Это ограничение часто становилось проблемой для наших пользователей. Учитывая это ограничение, мы недавно добавили начальную поддержку для интеграции с каталогом Iceberg REST.
Из трех перечисленных выше сценариев, это, вероятно, тот сценарий, для которого нам больше всего нужно улучшить работу наших пользователей. Следовательно, мы потратили время на разработку и расширение наших интеграций для поддержки каталогов. Но это только первый шаг; в ближайшие месяцы мы планируем выпустить множество дополнительных функций и поддержки.
Недавняя работа
Вот обзор нашей недавней работы и того, на чем мы сосредоточим наши усилия в этой области в ближайшие месяцы.
Интеграция каталогов
Несмотря на то, что ClickHouse уже поддерживает Iceberg, DeltaLake и Hudi с помощью специальных табличных движков, для запроса к таблице по-прежнему требуется прямой путь к ней. Лучшим способом улучшить эту ситуацию, как отмечалось выше, является интеграция с каталогами данных. Мы представляем себе систему, в которой ClickHouse взаимодействует как с каталогом данных, так и с хранилищем, чтобы иметь возможность считывать нужные метаданные: определять путь к таблице, автоматически интегрироваться с любыми средствами контроля доступа и считывать только необходимые данные.
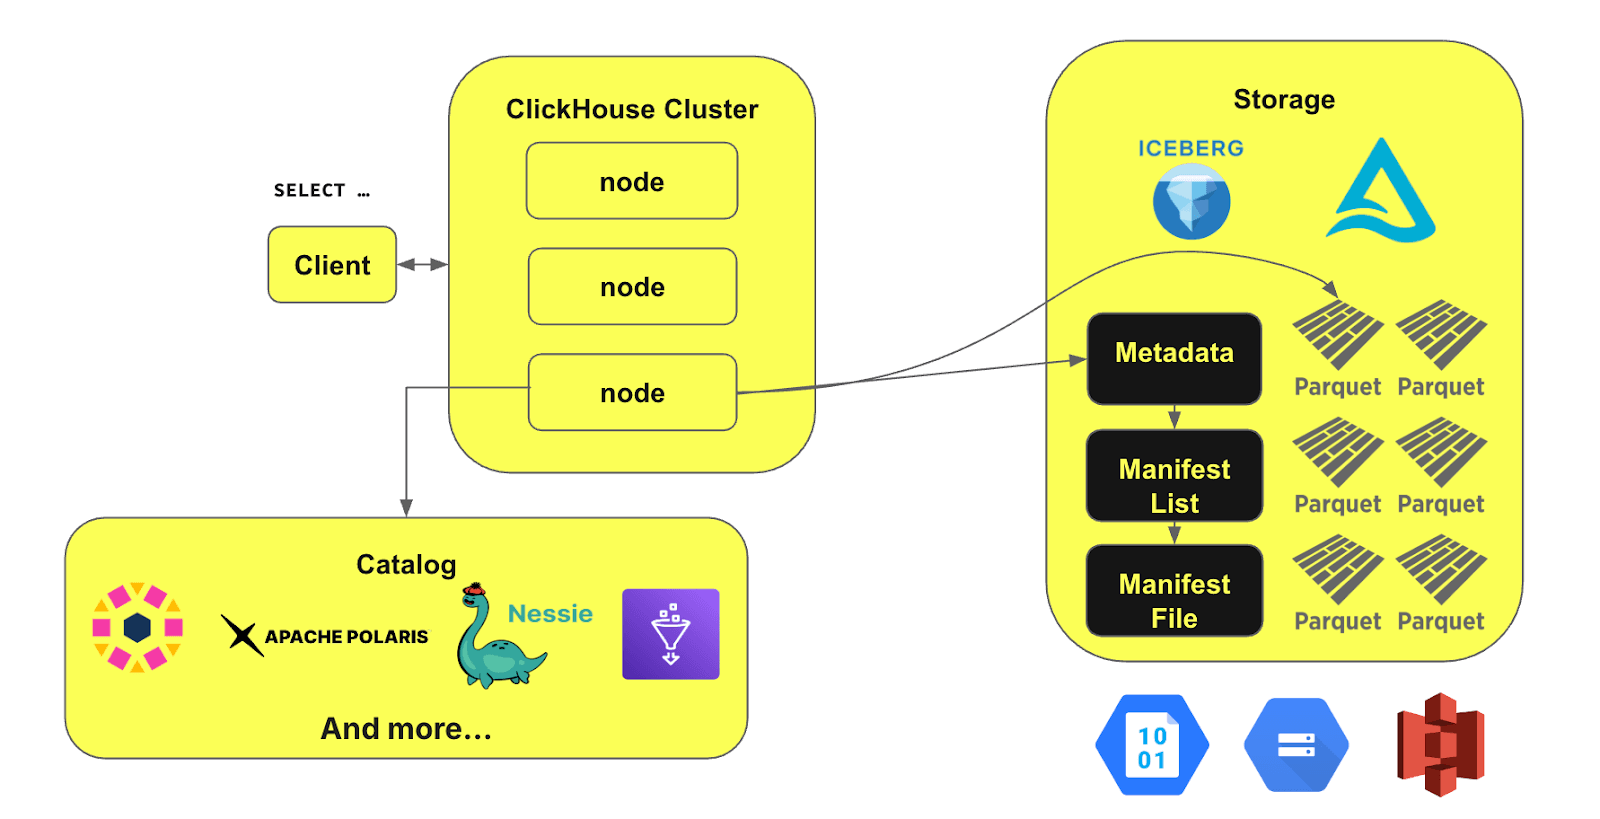
Хотя мы находимся на ранней стадии разработки, мы уже можем продемонстрировать эту концепцию в действии с помощью каталога Polaris:

В приведенном выше примере некоторые таблицы находятся в таблице Iceberg в Snowflake, которая предлагает управляемый сервис Polaris. Начиная с версии 24.12, ClickHouse внедрил поддержку этих каталогов Iceberg, что позволяет пользователям интегрироваться с каталогом и запрашивать его непосредственно из ClickHouse. Теперь вы можете запрашивать свою таблицу, управляемую Iceberg, в Snowflake с помощью ClickHouse через каталог!
Давайте проиллюстрируем это на примере. На скриншоте выше вы можете увидеть каталог и его различные пространства имен. Давайте создадим подключение к каталогу в ClickHouse:
CREATE DATABASE catalog
ENGINE = Iceberg('https://********************/polaris/api/catalog/v1')
SETTINGS catalog_type = 'rest', catalog_credential = '*********************', warehouse= 'polarisch'
Теперь вы можете приступить к исследованию:
SHOW TABLES

   ┌─────────────────────────────────────────┐
   │ name                                    │
   ├─────────────────────────────────────────┤
1. │ benchmark.notpartitionedwikistats       │
2. │  core.alerts                            │
3. │  core.logs                              │
4. │  hits.dailypartitionned                 │
5. │  hits.notpartitioned                    │
6. │  product.roadmap                        │
7. │  website.logs                           │
   └─────────────────────────────────────────┘

7 rows in set. Elapsed: 2.449 sec.
Проверьте схему ваших таблиц:
SHOW CREATE TABLE catalog.`product.roadmap`

CREATE TABLE catalog.`product.roadmap`
(
 `feature` Nullable(String),
 `team` Nullable(String),
 `owner` Nullable(String),
 `engineering_lead` Nullable(String)
)
ENGINE = Iceberg('s3://paths/', 'user', '[HIDDEN]')

1 row in set. Elapsed: 0.219 sec.
И самое главное, вы можете запрашивать данные с помощью ClickHouse.:
SELECT *
FROM `product.roadmap`
WHERE feature ILIKE '%Lakehouse%'

┌────────────┬──────────┬────────┬──────────────────┐
│ feature  │ team  │ owner  │ engineering_lead │
├────────────┼──────────┼────────┼──────────────────┤
│ Lakehouse  │ Samurai  │ Melvyn │ Sasha S.      │
└────────────┴──────────┴────────┴──────────────────┘

1 row in set. Elapsed: 0.477 sec.
Наша первоначальная реализация поддерживает каталог REST, но это только начало. В ближайшее время мы планируем добавить поддержку каталога Glue, а также каталога Unity для дельта-таблиц.
Функция кластеризации для lakehouse
Существующую функцию s3Cluster уже можно использовать для запроса данных к озерам. Это позволяет кластеру распределять обработку запроса между несколькими узлами. До недавнего времени мы не поддерживали эту функцию для Iceberg, Hudi или Delta Lake. Эта проблема была решена в версии 24.11. Если у вас не было времени протестировать ее, вот некоторые результаты, свидетельствующие об улучшении производительности при использовании кластера из 3 узлов.
SELECT count(*) FROM icebergS3Cluster('my_cluster', 's3://path/', '****************', '****************') WHERE (project = 'en') AND (subproject = 'turing')

┌──────────┐
│ count(*) │
├──────────┤
│     146  │
└──────────┘

1 row in set. Elapsed: 907.256 sec. Processed 95.97 billion rows, 2.53 TB (105.78 million rows/s., 2.79 GB/s.)
Peak memory usage: 2.69 GiB.
В неоптимизированной и неуплотненной таблице ускорение линейно зависит от количества узлов в кластере.
SELECT count(*) FROM iceberg('s3://path/', '****************', '****************') WHERE (project = 'en') AND (subproject = 'turing')

┌─────────┐
│ count(*)│
├─────────┤
│     146 │
└─────────┘

1 row in set. Elapsed: 2595.390 sec. Processed 95.97 billion rows, 2.53 TB (36.98 million rows/s., 974.86 MB/s.)
Peak memory usage: 2.78 GiB.
Ведется работа над форматами открытых таблиц
Помимо инвестиций в поддержку каталогов, мы активно совершенствуем нашу поддержку форматов открытых таблиц.
Iceberg
Хотя Iceberg обладает богатой экосистемой, к сожалению, ни одна библиотека не была разработана на C++. Хотя это может скоро измениться, это затрудняет поддержку некоторых новейших функций, предлагаемых спецификацией Iceberg, таких как поддержка удаленных строк.
За последний год ClickHouse добился значительного прогресса в расширении поддержки Iceberg: несколько функций уже реализованы, а другие находятся в стадии разработки, в том числе:
Поддержка сокращения разделов
Поддержка эволюции схемы
Поддержка путешествий во времени
После завершения поддержки функций Iceberg версии 2 мы планируем поработать над добавлением поддержки для версии 3.
Delta Lake
Одним из наших ключевых приоритетов, который уже реализуется, является улучшение поддержки Delta Lake в ClickHouse. Ядро Delta, первоначально выпущенное в качестве экспериментальной функции в 2023 году, как ожидается, скоро появится в GA. Оно поставляется в двух вариантах: Java и Rust. Для ClickHouse мы интегрируем ядро Rust, чтобы ускорить разработку Delta Lake в будущем. Как только ядро будет поддерживать запись в дельта-таблицы, ClickHouse также сможет предложить поддержку записи.
В дополнение к этому мы можем продолжить нашу работу с Iceberg для улучшения поддержки Delta. В результате многие функции Iceberg вскоре будут доступны и для Delta. Как и в случае с Iceberg catalog, мы стремимся поддерживать Delta catalog (в первую очередь Unity). Используя нашу первоначальную реализацию Iceberg catalog, расширить поддержку Delta должно быть относительно просто.
Дорожная карта для lakehouses на 2025 год
Каждый год мы публикуем новую дорожную карту для основной базы данных ClickHouse, и 2025 год не является исключением. Хотя планируется множество функций, в целом мы сосредоточимся на трех ключевых областях:
1. Улучшение пользовательского опыта при выполнении разовых и частых запросов к озерам данных/lakehouses
- Расширение интеграции каталогов для Iceberg и Delta
- Внедрение уровня кэширования метаданных для повышения производительности запросов
- Полная поддержка функций, специфичных для Iceberg и Delta, включая сложные типы данных, такие как variant type
- Усовершенствование нашего Parquet Reader для повышения эффективности
- Эта работа необходима для того, чтобы пользователи могли легко находить свои данные в своем хранилище данных и делать их доступными и запрашиваемыми в ClickHouse. В дополнение ко всем вышеперечисленным функциям планируется также провести некоторую работу по улучшению выполнения распределенных запросов при чтении формата Parquet. В настоящее время распределение задач осуществляется на уровне файлов. Поскольку размеры файлов часто меняются, это приводит к неоптимальному распределению работы. Таким образом, мы намерены сделать модуль распределения более детализированным, используя свойства формата Parquet.
2. Улучшаем возможности ClickHouse для работы с озерами данных/lakehouses
- Включая поддержку записи для Iceberg и Delta
- Сжатия и кластеризации liquid
- Внедрение внешних материализованных представлений для повышения эффективности запросов
- В настоящее время ClickHouse нельзя использовать в качестве средства записи для Iceberg, что накладывает некоторые ограничения. ClickHouse широко используется для предварительной обработки данных, в частности, благодаря широкой поддержке материализованных представлений. Благодаря поддержке записи мы сможем использовать наш опыт работы с табличным движком MergeTree для реализации эффективного сжатия таблиц Iceberg и Delta.
3. Iceberg CDC Connector в ClickPipes: простая репликация таблиц Iceberg в собственные таблицы ClickHouse для аналитики в реальном времени, ориентированной на клиента.
С целью устранения миллисекундных задержек запросов в таблицах data lake, эта работа включает в себя:
- Полная поддержка начальной загрузки и сбора данных об изменениях (CDC) в таблицах, доступных только для добавления.
- В последующих версиях будет расширена поддержка репликации обновлений и операций УДАЛЕНИЯ.
- Полностью управляемый интерфейс ClickHouse Cloud со встроенными метриками и мониторингом.
- Кроме того, мы будем внедрять специальные облачные функции, чтобы упростить ввод данных в эксплуатацию, улучшить доступ к данным и оптимизировать использование облачных ресурсов.
- Разрабатывая эти новые возможности и совершенствуя поддержку форматов открытых столов и архитектур lakehouse, мы тесно сотрудничаем с сообществом, чтобы собрать отзывы и улучшить качество обслуживания.


