

Эволюция стратегий репликации данных: от ручных методов к автоматизированным платформам на базе Debezium и Apache Kafka
В современном цифровом ландшафте, где данные стали ключевым активом бизнеса, обеспечение их доступности, целостности и согласованности в распределенных средах является не просто задачей, а стратегической необходимостью. Наша компания, как ведущий поставщик решений в области управления данными, предлагает глубокий анализ эволюции подходов к репликации. Мы детально рассмотрим первоначальные, часто ручные методики, их внутренние ограничения и плавный переход к высокоавтоматизированным, отказоустойчивым платформам, использующим мощь таких технологий, как Apache Kafka и Debezium. Этот материал будет особенно полезен архитекторам, инженерам баз данных и техническим руководителям, стоящим перед выбором или модернизацией системы репликации.
Императивная необходимость надежной репликации данных
Фундаментальным драйвером для внедрения сложных систем репликации стало повсеместное распространение географически распределенных дата-центров (ДЦ). Первоначальная, казалось бы, надежная архитектура с двумя полностью изолированными ДЦ — условно «Альфа» и «Бета» — где каждый обладал автономным экземпляром базы данных, на практике таила в себе значительные риски. Хотя изоляция гарантировала, что отказ одного ДЦ не приводил к каскадному падению второго, она создавала критическую уязвимость: данные, обновленные в «Альфе» после рассинхронизации, были безвозвратно утеряны в случае его полного отказа. Клиентские транзакции, финансовые операции, изменения статусов заказов — все это пропадало, что приводило к прямым финансовым потерям, репутационному ущербу и нарушению бизнес-континуитета.
Таким образом, репликация данных трансформировалась из опциональной практики в краеугольный камень любой отказоустойчивой архитектуры. Ее ключевые цели многогранны. В первую очередь, это обеспечение непрерывности бизнес-процессов (Business Continuity and Disaster Recovery, BC/DR). В случае катастрофического сбоя в первичном ДЦ система должна seamlessly (бесшовно) переключиться на вторичный центр с минимальными потерями данных (RPO - Recovery Point Objective) и временем простоя (RTO - Recovery Time Objective). Во-вторых, это повышение производительности и масштабируемости – географически распределенные реплики позволяют обслуживать пользователей из региона, физически близкого к ним, снижая сетевую задержку. Чтение данных может быть распределено по всем репликам, значительно разгружая первичную базу данных (БД). В-третьих, это выполнение нормативных требований - многие индустрии (финансы, здравоохранение, государственный сектор) строго регламентируют хранение и доступность данных. Репликация позволяет создавать изолированные, безопасные копии для аудита и соответствия стандартам, таким как GDPR, PCI DSS, HIPAA. И , наконец, это оптимизация использования ресурсов, нагрузка может быть динамически распределена между центрами, что позволяет более эффективно использовать вычислительные мощности и избегать ситуаций с «простаивающими» резервными серверами.
Без продуманной стратегии репликации компания неизбежно сталкивается с рисками потери данных, длительных простоев, несоблюдения регуляторных норм и, как следствие, потерей конкурентного преимущества.

Исходная стратегия: кастомный репликатор на основе опорных колонок
На заре проектирования распределенной системы нашими инженерами была реализована первоначальная стратегия, ключевым принципом которой была простота и скорость внедрения. Этот подход, известный как «pattern-based replication» или «репликация по триггерам», заключался в следующем.
В каждую таблицу, подлежащую репликации, добавлялись две дополнительные служебные колонки:
- data_center_id (или source_id): VARCHAR. Содержал уникальный идентификатор дата-центра, в котором была произведена запись (напр., 'ALPHA', 'BETA').
- last_updated_ts: TIMESTAMP. Фиксировал точное время последнего обновления или создания записи.
Для фактической отправки изменений был разработан отдельный сервис — «репликатор». Его алгоритм работы был цикличным:
- Опрос - с заданным интервалом (например, каждые 30 секунд) репликатор выполнял запрос к базе данных-источнику:
SELECT * FROM orders WHERE data_center_id = 'ALPHA' AND last_updated_ts > :last_replication_time
ORDER BY last_updated_ts LIMIT 1000;
- Пакетная обработка данных - извлеченные записи (пакетом до 1000 штук) упаковывались в сообщения (часто в формате JSON или Avro);
- Отправка в Kafka - пакет сообщений отправлялся в определенный топик Apache Kafka. Использование Kafka обеспечивало буферизацию и гарантировало доставку хотя бы раз (at-least-once delivery).
- Прием на стороне потребителя - консьюмер на стороне целевого ДЦ читал сообщения из топика Kafka и применял изменения (INSERT/UPDATE) к своей базе данных.
- Коммит и обновление курсора - после успешной обработки пакета значение :last_replication_time обновлялось на максимальный таймстамп из обработанного пакета.
Преимущества такого подхода, которые были актуальны на тот момент, заключаются в следующем. Во-первых, это низкий порог входа - стратегия не требовала глубоких знаний специфичных технологий репликации БД. Для ее реализации было достаточно знаний SQL и основ брокера сообщений. Во-вторых, это полный контроль над логикой - разработчики могли тонко настраивать логику фильтрации, трансформации данных перед отправкой и обработки ошибок. В-третьих, это минимальное воздействие на основную базу - в отличие от триггеров на уровне БД, которые создают нагрузку на транзакции, этот подход использовал отдельные запросы.
Однако несмотря на все свою первоначальную простоту, эта стратегия очень быстро выявила серьезные недостатки, которые стали узкими местами при росте нагрузки. Возникла проблема производительности и масштабирования (Performance Bottleneck). Запрос с условием WHERE ... > ... ORDER BY ... LIMIT N при больших объемах изменений (десятки тысяч записей в минуту) становился крайне тяжелым для базы данных. Несмотря на индекс по last_updated_ts, необходимость сортировки и лимитирования создавала высокую нагрузку на CPU и дисковую подсистему. Ограничение в 2000 записей за раз было не произвольным, а вынужденным — большие пакеты приводили к таймаутам транзакций и блокировкам.
Далее, обозначился риск потери данных (Data Loss Risk). Механизм обновления курсора (last_replication_time) создавал классическую проблему «последнего пакета». Если процесс репликатора аварийно завершался после обработки пакета, но до обновления курсора, при следующем запуске этот же пакет данных отправлялся повторно. Это приводило к дублированию данных на стороне потребителя. Гарантия «хотя бы раз» от Kafka лишь усугубляла эту проблему.
Нельзя не упомянуть и высокие операционные затраты (High Operational Overhead). Добавление каждой новой таблицы в процесс репликации требовало:
- Изменения схемы БД (добавление data_center_id, last_updated_ts).
- Написания нового кода в репликаторе для обработки этой таблицы.
- Создания нового топика в Kafka или сложной маршрутизации в существующем.
- Обновления консьюмера на принимающей стороне.
Этот процесс был слишком трудоемким, чересчур подверженным человеческим ошибкам и плохо поддавался автоматизации.
Кроме того, стало явным отсутствие поддержки удалений (No Support for Deletes). Базовая реализация часто захватывала только INSERT и UPDATE. Операции DELETE не фиксировались в колонке last_updated_ts, что требовало создания отдельного механизма «мягкого удаления» (soft delete) с флагом is_deleted, что еще более усложняло логику приложения.
И, наконец, это согласованность данных (Data Consistency). Подход не гарантировал точную порядковую согласованность (transactional consistency). Если в одной транзакции обновлялись несколько строк, они могли попасть в разные пакеты и быть применены на реплике в разное время, что могло временно нарушить целостность бизнес-правил.
Все эти недостатки четко обозначили необходимость перехода к более совершенной, дешевой в поддержке и надежной технологии.
Новая эра: автоматизированная репликация на основе Change Data Capture (CDC) с Debezium
Осознав ограничения кастомного решения, наша команда приняла стратегическое решение о переходе на парадигму Capture Data Change (CDC). После тщательного анализа рынка был выбран Debezium — open-source проект, идеально интегрирующийся с экосистемой Apache Kafka.
Debezium работает как набор коннекторов для Kafka Connect. Его фундаментальное отличие — он не опрашивает таблицы, а читает журнал транзакций базы данных (Write-Ahead Log - WAL в PostgreSQL, binlog в MySQL, redo log в Oracle). Этот журнал содержит непрерывную, строго упорядоченную последовательность всех изменений, произошедших в базе.
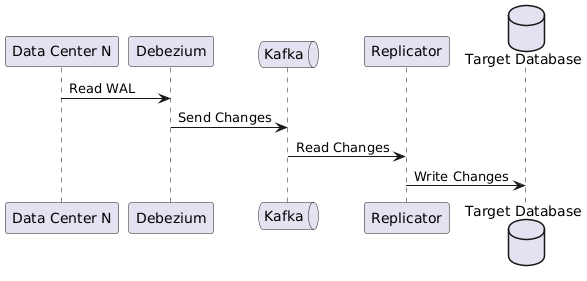
Архитектуру решения можно примерно описать следующим образом:
- Источник данных (База данных) - на стороне источника (например, PostgreSQL) необходимо обеспечить соответствующую конфигурацию для поддержки логической репликации (wal_level=logical), а также создать пользователя с правами на чтение WAL.
- Коннектор Debezium - разворачивается в составе Kafka Connect. Коннектор подключается к базе-источнику как репликационный слот и начинает непрерывно считывать записи из журнала.
- Apache Kafka. Для каждой таблицы источник Debezium создает отдельный топик (напр., dbserver1.public.orders). Сообщения в топике содержат полное состояние строки до и после изменения (для операций UPDATE), а также метаданные (имя источника, транзакции, LSN - Log Sequence Number).
- Консьюмеры (Sink Connectors или кастомные приложения) - принимающие приложения читают данные из топиков Kafka. Это могут быть:
- Sink-коннекторы для записи в другие БД (JDBC Sink Connector, Elasticsearch Sink Connector).
- Стриминг-приложения на Kafka Streams или ksqlDB для трансформации данных.
- Кастомные микросервисы, реагирующие на изменения данных в реальном времени.
Детальный пример сообщения от Debezium в Kafka:
{
  "before": {
    "id": 1001,
    "user_id": 201,
    "amount": 99.99,
    "status": "PENDING"
  },
  "after": {
    "id": 1001,
    "user_id": 201,
    "amount": 99.99,
    "status": "CONFIRMED"
  },
  "source": {
    "version": "1.9.7.Final",
    "connector": "postgresql",
    "name": "dbserver1",
    "ts_ms": 1659877531000,
    "snapshot": "false",
    "db": "mydb",
    "sequence": "[\"1000001\",\"1000002\"]",
    "schema": "public",
    "table": "orders",
    "txId": 12345,
    "lsn": 1000002,
  },
  "op": "u",
  "ts_ms": 1659877531800
}
- op: Операция ('c' - create, 'u' - update, 'd' - delete, 'r' - read (from snapshot)).
- lsn: Log Sequence Number — уникальный идентификатор позиции в WAL, критически важен для обеспечения порядка и отсутствия потерь.
- ts_ms: Таймстамп обработки события самим Debezium.
Преимущества данного подхода в первую очередь заключаются в нулевой нагрузке на источник (Near-Zero Impact). Чтение из журнала, который и так пишется, практически не создает дополнительной нагрузки на основную БД, в отличие от polling-запросов. Кроме того, это и высокая производительность и пропускная способность: Debezium способен обрабатывать десятки тысяч изменений в секунду без задержек, так как не имеет ограничений на размер пакета. Это и точная порядковая гарантия (Transactionally Consistent) - Debezium сохраняет порядок изменений в пределах одной транзакции. Все изменения одной транзакции попадают в один и тот же partition топика Kafka, что гарантирует их порядок при потреблении. Более того, это поддержка всех операций (CRUD) - фиксируются операции INSERT, UPDATE, DELETE без необходимости изменения схемы приложения. Это и простота масштабирования и управления - добавление новой таблицы для репликации сводится к простому изменению конфигурации коннектора (через REST API Kafka Connect) без написания кода. Наконец, это гибкие трансформации, позволяющие использовать встроенные или кастомные трансформации SMT (Single Message Transforms) для маскировки данных, переименования полей, извлечения состояния после изменения и т.д.
При всем при этом стоит заметить, что переход на Debezium — не панацея, он требует тщательной подготовки и планирования. Здесь в первую очередь стоит упомянуть экспертизу и обучение. Основная ошибка — недооценка необходимых знаний. Команда должна понимать работу WAL, репликационных слотов в PostgreSQL, иметь опыт работы с Kafka Connect и знать Java для глубокой отладки и кастомизации. Решением в данном случае могут стать инвестиции в обучение команды или привлечение внешних экспертов на этапе внедрения.
Стоит сказать и о риске заполнения диска WAL. Если консьюмеры Kafka долго недоступны, коннектор Debezium перестает двигать свою позицию в репликационном слоте. WAL продолжает накапливаться, чтобы сохранить все изменения, что может привести к полному заполнению диска и остановке базы данных. Решение - тщательный мониторинг консьюмеров и размера репликационных слотов, настройка оповещений.
Кроме того, существуют сложности начальной синхронизации. Debezium может сделать снимок исходного состояния данных. Для очень больших таблиц (несколько TB) этот процесс может занять часы или дни, в течение которых WAL должен храниться. Решение состоит в том, чтобы планировать начальный снимок в период наименьшей нагрузки, рассматривать гибридные подходы с использованием резервных копий.
Далее, существует такое понятие, как семантика доставки. Конфигурация по умолчанию обеспечивает доставку "хотя бы раз". Для идемпотентных операций это приемлемо, но для неидемпотентных может потребоваться точная настройка для достижения "ровно один раз" (exactly-once). Решение - тщательно проектировать логику приложения-консьюмера для обработки дубликатов.
Наконец, поговорим и о мониторинге и наблюдаемости данных. Развертывание Debezium без полноценного мониторинга (метрики Kafka Connect, lag, количество ошибок, LSN) — путь к проблемам. Решение состоит в том, чтобы интегрировать Kafka Connect с Prometheus/Grafana для понимания всей цепочки репликации.
Будущее репликации: полная автоматизация и Data Mesh
Взгляд в будущее показывает, что репликация становится не просто инструментом копирования данных, а фундаментальным слоем для построения динамичных data-платформ. Наша дорожная карта в первую очередь включает полную автоматизацию жизненного цикла. Внедрение GitOps-подхода для управления конфигурациями коннекторов. Изменения в Git-репозитории автоматически применяются к кластерам Kafka Connect, устраняя необходимость ручных вмешательств и заявок к администраторам.
Далее поговорим о самообслуживании (Self-Service) - предоставлении инструментов разработчикам для самостоятельного подключения нужных им таблиц к потокам данных через стандартизированные шаблоны и пайплайны, что полностью соответствует принципам Data Mesh.
Стоит упомянуть и умную маршрутизацию и трансформацию - использование движков потоковой обработки (ksqlDB, Flink) для обогащения, фильтрации и маршрутизации данных на лету перед их отправкой в конечные системы-потребители.
В заключении стоит сказать о повышении надежности - внедрение механизмов автоматического восстановления при сбоях коннекторов, а также более тесная интеграция с системами управления схемами данных (Schema Registry) для обеспечения контрактов на данные.
Эволюция от кастомного, трудоемкого и ограниченного подхода к репликации к современной, основанной на CDC платформе с использованием Debezium и Apache Kafka — это наглядный пример того, как технологии позволяют превратить операционную нагрузку в стратегическое преимущество. Новая архитектура не только решает проблемы производительности и масштабируемости, но и открывает двери для создания реактивных, событийно-ориентированных приложений, которые работают с данными в реальном времени. Наша компания готова стать вашим надежным партнером на этом пути, предложив экспертизу, проверенные решения и комплексную поддержку на всех этапах внедрения и эксплуатации.


