

Стратегия данных и видение продукта
Стратегия данных и видение продукта — это связующее звено между бизнес-целями компании и технологиями обработки данных. Для нового сотрудника это не просто список инструментов: это понятная модель, как данные становятся ценностью для клиента и бизнеса. Здесь вы узнаете, как формировать стратегию данных, как превратить данные в продукт, какие роли и процессы задействованы, какие инструменты применяются в реальных условиях и какие риски следует учитывать на старте проекта.
Теоретическая часть
Что такое продукт данных
Данные как продукт — это набор данных, доступный конкретным пользователям внутри организации с ясной ценностью, гарантиями качества, устойчивостью к изменению требований и понятным способом использования. В отличие от «сырых» датасетов, продукт данных имеет целевую аудиторию, определённые показатели качества, обслуживание и эволюцию во времени. Важные нюансы:
- Ценность для пользователя: какие задачи решаются на основе данных (например, повышение конверсии, оптимизация цепочек поставок, контроль риска).
- Пользовательские роли: аналитик BI, дата-аналитик, дата-сайентист, разработчик продукта, риск-менеджер, бизнес-оператор.
- Контракт данных: явное заявление о составе данных, их формате, ограничениях и SLA по доступности.
- Эволюция и версия: новые версии набора данных, совместимость контрактов, управление миграциями схем.
Стратегия данных и видение продукта
Стратегия данных — это план, как данные поддерживают цели бизнеса и продуктовую линейку компании в долгосрочной перспективе. Она определяется вместе с бизнес-целями, правилами комплаенса, финансовыми ограничениями и техническими возможностями. Видение продукта — это конкретное, измеряемое и доступное каждому заинтересованному лицу описание того, какие данные будут доступны, какие сервисы будут предоставлены, какие метрики будут отслеживаться и как пользователи будут достигать целей. Обычно видение продукта включает:
- Миссию продукта данных: какую проблему клиента мы решаем через данные.
- Целевые аудитории и их потребности.
- Основные метрики использования: активные пользователи, доля удовлетворённых запросов, время отклика, качество данных.
- Роадмап и выпуск обновлений: какие функциональности появятся и в какие сроки.
- Соответствие требованиям безопасности и приватности.
Данные как часть архитектуры продукта
Эффективная стратегия данных требует понятного архитектурного представления. Часто выделяют слои:
- Источники данных: ERP, CRM, веб-аналитика, IoT, внешние поставщики данных.
- Ингестия и поток обработки: конвейеры загрузки и обработки данных, трансформации.
- Хранение и управление данными: data lake, data warehouse, аналитическая база, слой метаданных.
- Потребление и сервисы: API, дашборды, визулизация, фичинг для моделей.
- Управление качеством, безопасностью и доступом: качество данных, lineage, мониторинг, контроль доступа, шифрование.
- Управление данными и соответствии: учет данных, политика персональных данных, аудиты.
Методы и подходы
- Product thinking в данных: формирование ценности, постановка задач в виде пользовательских историй и acceptance criteria.
- Data contracts и схемы совместимости: формальные описания форматов данных, версионность и правила изменения схем.
- Data governance и качество: политика качества данных, набор метрик (accuracy, completeness, timeliness), механизмы тестирования и мониторинга.
- DataOps и MLOps: интеграция разработки данных и эксплуатации, автоматизация развёртывания, мониторинг производительности и качества.
- Управление рисками: оценка рисков на уровне продукта, контроль соответствия, план действий при инцидентах.
Ключевые термины
- Данные как продукт (Data product): данные, предлагаемые как сервисы для пользователей внутри компании, с целевой аудиторией, SLA и качеством.
- Data contract: соглашение об области данных, формате, обновлениях и ответственности сторон.
- Data governance: набор политик, ролей и процессов, обеспечивающих управление данными и соблюдение регламентов.
- Data lineage: прослеживаемость данных от источника до потребителя, помогающая понять влияние изменений и восстановление источников.
- Data catalog: каталог метаданных, который облегчает поиск и понимание доступных наборов данных.
- Data quality: совокупность методов проверки точности, полноты, своевременности и согласованности данных.
- Data mesh vs data lake/warehouse: подход к организации данных в компании; mesh ориентирован на домены и ответственность за данные в командной среде, в то время как традиционные архитектуры централизованы.
- DataOps и MLOps: парадигмы автоматизации разработки и эксплуатации данных и моделей, соответственно.
- ETL/ELT: процессы извлечения, преобразования и загрузки данных (или их переработки внутри целевой системы).
Практические примеры
Пример 1. Аналитическая панель по продажам на основе открытого стека
Контекст: компания retail хочет дать бизнес-подразделениям единую панель KPI по продажам за последние 12 месяцев, с доступом к детализации по регионам и каналам. Цель — снизить цикл подготовки отчётов и увеличить прозрачность данных.
Архитектура и стеки:
- Источники: ERP-система, CRM, веб-аналитика.
- Ингестия: Kafka для стриминга событий продаж и изменений статусов заказов.
- Хранение: data lake на основе Parquet в облачном хранилище; аналитическая база на базе ClickHouse для быстрых запросов.
- Обработка: Apache Spark для батчи микро-потоков, трансформации и агрегации; Delta Lake или Apache Hudi для управления версиями данных.
- Контракты и каталог: OpenMetadata в качестве каталога метаданных; схема и версии через Apache Avro/Schema Registry.
- Контент и доступ: Apache Superset или Metabase для дашбордов; API для внутреннего доступа.
- Контроль качества: Great Expectations с набором тестов на полноту, валидность и уникальность ключей; мониторинг с Prometheus и Grafana.
- Обеспечение безопасности: IAM и RBAC на уровне данных и визуализации; шифрование в REST и at rest.
- Примеры российских решений: хранение в ClickHouse, использование Яндекс.Облако или Яндекс.Облака для развёртывания сервисов; возможно использование Yandex DataSphere для моделей и экспериментов.
- Ценности и результаты: сокращение времени подготовки отчётов, повышение точности KPI, прозрачность источников, снижение дублирования данных, улучшение качества данных за счёт автоматических тестов.
Пример 2. Рекомендательная система и аналитика поведения клиента с российскими технологиями
Контекст: интернет-магазин хочет персонализировать рекомендации и оперативно анализировать поведение клиента.
Архитектура:
- Источники: клиентское приложение, веб-аналитика, платежи.
- Потоковые данные: Kafka, обработка в реальном времени с Spark Streaming.
- Хранение: ClickHouse для быстрых агрегатов и (реже) Hadoop/S3-совместимое хранилище для долговременного хранения.
- Машинное обучение: FЕast/Custom feature store для управления признаками; Open-source MLflow для экспериментов и розыгрыша моделей.
- Визуализация: мощные панели в Superset.
- Гигиена данных: OpenMetadata или Amundsen для каталога; Great Expectations для контроля качества.
- Российские решения: усиление использования ClickHouse как колонки/аналитической БД в реальном времени; развертывание на Яндекс.Облаке или в СберCloud для гиперлокальных требований.
Ценности: Улучшение точности рекомендаций, снижение времени реакции системы, прозрачное управление данными и их качеством.
Пример 3. Финансовая дисциплина и комплаенс
Контекст: банк или финансовая организация обязана соблюдать требования по защите персональных данных и регуляторные требования. Включение data contracts и политики доверия критично.
Архитектура:
- Источники: транзакции, риск-скоры, учетное наследие.
- Ингестия: конвейеры с Airflow или Apache NiFi для интеграции источников.
- Хранение: слой data lake с Parquet/ORC; аналитическая база на ClickHouse для быстрых аналитических запросов; приватные данные в зашифрованном виде.
- Безопасность: RBAC/ABAC для доступа к данным; маскирование данных (PII/PII-скрытие) на уровне сервиса; аудит и логирование доступа.
- Контракты и качество: набор контрактов по версиям схем, тесты на соответствие требованиям; контроль качества данных через Great Expectations.
- Обеспечение соответствия: оперативные политики по 152-ФЗ и локализации данных; журнал аудита и уведомления менеджерам.
- Российские сервисы: Яндекс.Облако для безопасной инфраструктуры, ClickHouse для анализа, OpenMetadata/OpenTelemetry для мониторинга и трассировки.
Технические детали
Архитектура «данные как продукт» и ключевые артефакты
1) Архитектура данных
- Источники данных: систем происхождения, внешние поставщики, датчики, веб-слои.
- Ингестия: потоковые и пакетные конвейеры; обработка в реальном времени и пакетная обработка для ретроспективного анализа.
- Хранение: разделение слоёв — data lake для «сырья» и data warehouse/аналитическая БД для готовых наборов. Форматы: Parquet, ORC для эффективности хранения и быстрого чтения; сжатие и партиционирование по ключам бизнеса.
- Сервисы потребления: дашборды, API, фичинг для моделей, экспорт для BI-инструментов.
- Метаданные и управление: каталог данных, линейность, версии схемы, качество данных.
2) Метаданные и каталог
- Data catalog необходим для быстрого поиска и понимания доступных наборов данных, их владельцев, целей и ограничений.
- В качестве открытых решений можно использовать OpenMetadata, Amundsen, DataHub. В российских условиях можно рассмотреть локальные развёртывания и интеграции с Yandex DataSphere или Яндекс.Облако через API каталогов и сервисов.
3) Контракты данных
- Data contracts описывают набор полей, их типы, правила валидации, допустимые значения и SLA по доступности данных.
- Версионирование контрактов и поддержка миграций схем без нарушения потребителя.
- Примеры: схемы Avro/Schema Registry, тестовые наборы тестов на полноту и валидность.
4) Контроль качества и тестирование данных
- Great Expectations для определения ожиданий по данным и автоматического тестирования.
- Наборы тестов: полнота, корректность форматов, отсутствие дубликатов, согласованность ключей.
- Мониторинг качества: дэшборды в Grafana, подсказки о degradations через оповещения.
5) Безопасность и соответствие
- Модели доступа: RBAC на уровне источников, таблиц и колонок; ABAC по атрибутам пользователя.
- Маскирование и обезличивание: политики PII, PII masking на этапе конвейера.
- Шифрование: TLS для передачи, прозрачное шифрование данных в хранилищах.
- Аудит и соответствие: хранение журналов доступа, отслеживание изменений, регулярные проверки соответствия требованиям.
6) Операционная часть и мониторинг
- Оркестрация: Apache Airflow или альтернативы; DAG-процессы для контроля над пайплайнами.
- Мониторинг и логирование: Prometheus/Grafana, EFK/ELK стек для логов; трассировка через OpenTelemetry.
- Развёртывание и версии: CI/CD для пайплайнов и моделей; управление версиями набора данных и контрактов.
7) Примеры инструментов (open-source и российские решения)
- Ингестия и поток: Apache Kafka (open-source). В российском контексте — интеграции через Яндекс.Облако или СберCloud с теми же концепциями.
- Обработка: Apache Spark, Flink (open-source).
- Хранение: Apache Parquet/ORC в Data Lake; ClickHouse как аналитическая база для быстрых запросов.
- Каталоги и метаданные: OpenMetadata, Amundsen, DataHub (open-source). В рамках российского рынка — интеграции с локальными облачными платформами и решениями.
- Контракты и схемы: Apache Avro, Schema Registry, параллельная валидация через тесты в Great Expectations.
- Визуализация и анализ: Apache Superset, Metabase (open-source). Российские альтернативы — адаптируемые панели в рамках Яндекс.Даскс или Яндекс.Облака.
- Мониторинг и качество: Prometheus, Grafana; Great Expectations.
- Фичинг и модели: Feast (open-source) для управления признаками; MLflow как платформа экспериментов и развёртывания моделей (open-source).
Риски и ограничения
1) Технические и архитектурные риски
- Сложность интеграции разнотипных источников и систем; риск несогласованности данных и задержек.
- Управление версиями данных и контрактов — усложнение миграций, возможная несогласованность потребителей и производителей.
- Управление качеством: отсутствие полноты и точности данных может приводить к неверным бизнес-решениям.
- Безопасность и приватность: риск утечки персональных данных, нарушение регуляторных норм.
2) Организационные риски
- Разрозненность команд: ответственность за данные может быть распределена между несколькими подразделениями.
- Необходимость постоянного обучения сотрудников, поддержания компетенций в области технологий данных.
- Контроль бюджета и затрат на инфраструктуру: рост вычислительных и хранилищных расходов при росте объёма данных.
3) Риски внедрения и практика внедрения
- Проблемы с качеством и согласованностью входных данных, что может привести к «data debt».
- Избыточная централизация или, наоборот, чрезмерная децентрализация — нужно выбрать подход, подходящий для домена.
- Риск зависимости от конкретного поставщика облачных услуг и инструментов (vendor lock-in).
4) Регуляторные и правовые риски
- Требования по защите персональных данных (например, локализация, редактирование, удаление данных по запросу).
- Нормативы по сохранности и доступу к данным в финансовом секторе.
5) Риски внедрения в российском контексте
- Ограничения доступа к внешним сервисам и необходимость локального хранения данных.
- Неполное соответствие требованиям отечественных решений и ограничение по доступности некоторых зарубежных технологий.
- Необходимость адаптации к российским облачным платформам (Яндекс.Облако, СберCloud) и интеграциям с локальными решениями (ClickHouse, локальные репозитории данных).
Стратегия данных и видение продукта — это стратегия, ориентированная на ценность для бизнеса через данные. Она требует ясного определения целевой аудитории и её потребностей, формализованных контрактов и метаданных, контроля качества, управления безопасностью и соответствием, а также устойчивой архитектуры конвейеров данных. В рамках курса вы учитесь превращать абстрактные данные в реальные продукты: с понятной ценностью, конкретными метриками, планами внедрения и механизмами мониторинга. Важную роль играет выбор инструментов — как open-source, так и российские решения — которые соответствуют требованиям безопасности, масштабируемости и локальной регуляторной среде. При этом важно помнить о рисках и ограничениях, и строить процессы так, чтобы минимизировать их влияние на бизнес.
Вопрос–Ответ (FAQ)
1) Что такое «данные как продукт» и зачем это нужно в компании?
Данные как продукт — это концепция, означающая, что данные публикуются и обслуживаются так же, как и любой другой продукт: у него есть целевая аудитория, ценность, SLA, обеспечение качества, документирование и поддержка. Это позволяет бизнесу быстрее получать ценностные инсайты, уменьшать повторную работу, снижать риск ошибок и повышать прозрачность источников данных. Внутренний клиент может быть аналитиком BI, дата-сайентистом, менеджером продукта,Ops-менеджером и т.д. Наличие data contracts и каталога данных помогает минимизировать недопонимания и ускоряет развитие продуктовой линейки.
2) Какие ключевые элементы должны входить в стратегию данных?
Ключевые элементы: видение и миссия данных, целевые аудитории и их потребности, набор контрактов данных, политика качества данных, каталог метаданных, архитектура конвейеров, требования к безопасности и соответствию, операционная модель (кто отвечает за данные), план внедрения и дорожная карта, показатели успеха (KPIs) и механизмы мониторинга. Также важно определить принципы выбора инструментов (open-source vs проприетарные), требования к локализации данных и регуляторные ограничения.
3) Какой подход выбрать для управления данными: централизованный склад или децентрализованная модель?
Это зависит от домена и организации. Централизованный склад работает хорошо в компаниях с единым набором потребителей и высоким уровнем консолидации данных, но может стать bottleneck’ом. Data mesh предлагает децентрализованный подход, где каждый домен отвечает за свои данные и продукт. В реальных условиях чаще применяют гибрид: централизованный каталог и общие сервисы (каталог, качество, безопасность) плюс децентрализованный конвейер в рамках доменов. В любом случае важно соблюдать единые принципы контрактов, согласованные схемы и политики.
4) Какие открытые решения и российские инструменты можно использовать в первой волне проекта?
Открытые решения: Apache Spark и Flink для обработки, Apache Kafka для данных в потоке, Apache Airflow для оркестрации, Parquet/ORC для хранения, ClickHouse для аналитических запросов, Feast для фичей и MLflow для экспериментов, Great Expectations для качества, OpenMetadata/Amundsen/DataHub для каталогов, Superset/Metabase для визуализации. Российские решения и подходы: ClickHouse как основа аналитической БД, Яндекс.Облако/Яндекс DataSphere для инфраструктуры и рабочих пространств, интеграции с локальными системами и данными, использование локальных облачных сервисов и региональных региональных данных для соответствия локальному регулированию. Важно выбрать сочетание, которое обеспечивает безопасность, локализацию и доступность.
5) Какие риски наиболее критичны при внедрении стратегии данных?
Критичные риски — это несогласованность источников данных, несоответствие контрактов данным и потребителям, низкое качество данных, задержки в конвейерах, недостаточный уровень безопасности и нарушения регуляторных требований. Также критично риск роста стоимости инфраструктуры, нехватка специалистов и вакуум между ИТ и бизнес-подразделениями. Для снижения рисков полезно внедрять поэтапно: определить пилотные домены, быстро получить первые ценности, затем масштабировать архитектуру, обеспечивая при этом политики качества, контрактности и мониторинга.
6) Как лучше организовать работу команд вокруг данных?
Необходимо определить роли: продуктовый менеджер по данным, дата-архитектор, инженер данных, инженер по качеству данных, специалист по безопасной обработке персональных данных, бизнес-аналитик, data steward. В командной работе ценны согласованные артефакты: data contracts, каталог данных, набор тестов качества, дорожная карта и регулярные синхронизации между бизнесом и техподразделением. В идеале внедрять «данные как продукт» на пилотном домене, затем расширять на другие домены.
7) Какие метрики стоит использовать для оценки эффективности стратегии данных?
Лаконичный набор: доступность и время отклика данных (latency), доля ошибок в данных (data quality pass rate), полнота и точность наборов данных (accuracy, completeness), количество активных потребителей данных, частота использования дашбордов, доля автоматизированных конвейеров, скорость выпуска обновлений данных, уровень соответствия требованиям безопасности и регуляторики. Важно связывать эти метрики с бизнес-целями: например, увеличение конверсии на X% за счет точной сегментации, снижение времени подготовки аналитических материалов на Y%.
8) Какие принципы безопасности и комплаенса применяются к данным в рамках видения продукта?
Необходимо заранее определить политики доступа, маскирование персональных данных, аудит и журналирование, хранение и обработку данных в рамках локальных и региональных ограничений, обеспечение безопасности в пути и на месте хранения, а также режимы хранения исторических данных и удаление по запросу. В зависимости от отрасли применяются требования к локализации данных, архивированию, защиты от потери данных и регулярного тестирования систем.
9) Каковы преимущества использования российского стека в рамках стратегии данных?
Преимущества включают соответствие локальным требованиям, улучшение интеграции с локальной инфраструктурой и сервисами, более простые варианты поддержки и локализацию бизнес-процессов, потенциально меньшие задержки из-за размещения данных внутри страны. При этом открытые инструменты и международные сервисы часто поддерживают нужные сценарии и обеспечивают широкую экосистему. Важно соблюдать баланс между локализацией и необходимостью использования передовых технологий.
10) Какую роль играет выбор инструментов в реализации стратегии данных?
Выбор инструментов влияет на скорость внедрения, масштабируемость, безопасность и стоимость владения. Открытые решения дают гибкость и прозрачность, а российские решения и облачные сервисы обеспечивают локализацию и соответствие требованиям. Важно выбрать стек, который покрывает весь жизненный цикл данных: от ингестии до публикации в виде API и дашбордов, обеспечить качество и безопасность, а также иметь возможность эволюционировать по мере роста требований и данных.
Эта глава дала вам рамку, как подходить к стратегии данных и формированию видения продукта. Помните: данные — это продукт, который требует внимательного управления, четкого определения потребителей и постоянной поддержки. Успех зависит от согласованных контрактов, качественных конвейеров и прозрачной коммуникации между бизнесом и технологической командой. Используйте открытые и российские решения в сочетании, наращивайте компетенции команды и внимательно управляйте рисками — и данные станут действительно сильной и устойчивой частью вашего продукта.
Вопрос–Ответ (FAQ) — продолжение
11) Каким образом сформировать дорожную карту продукта данных?
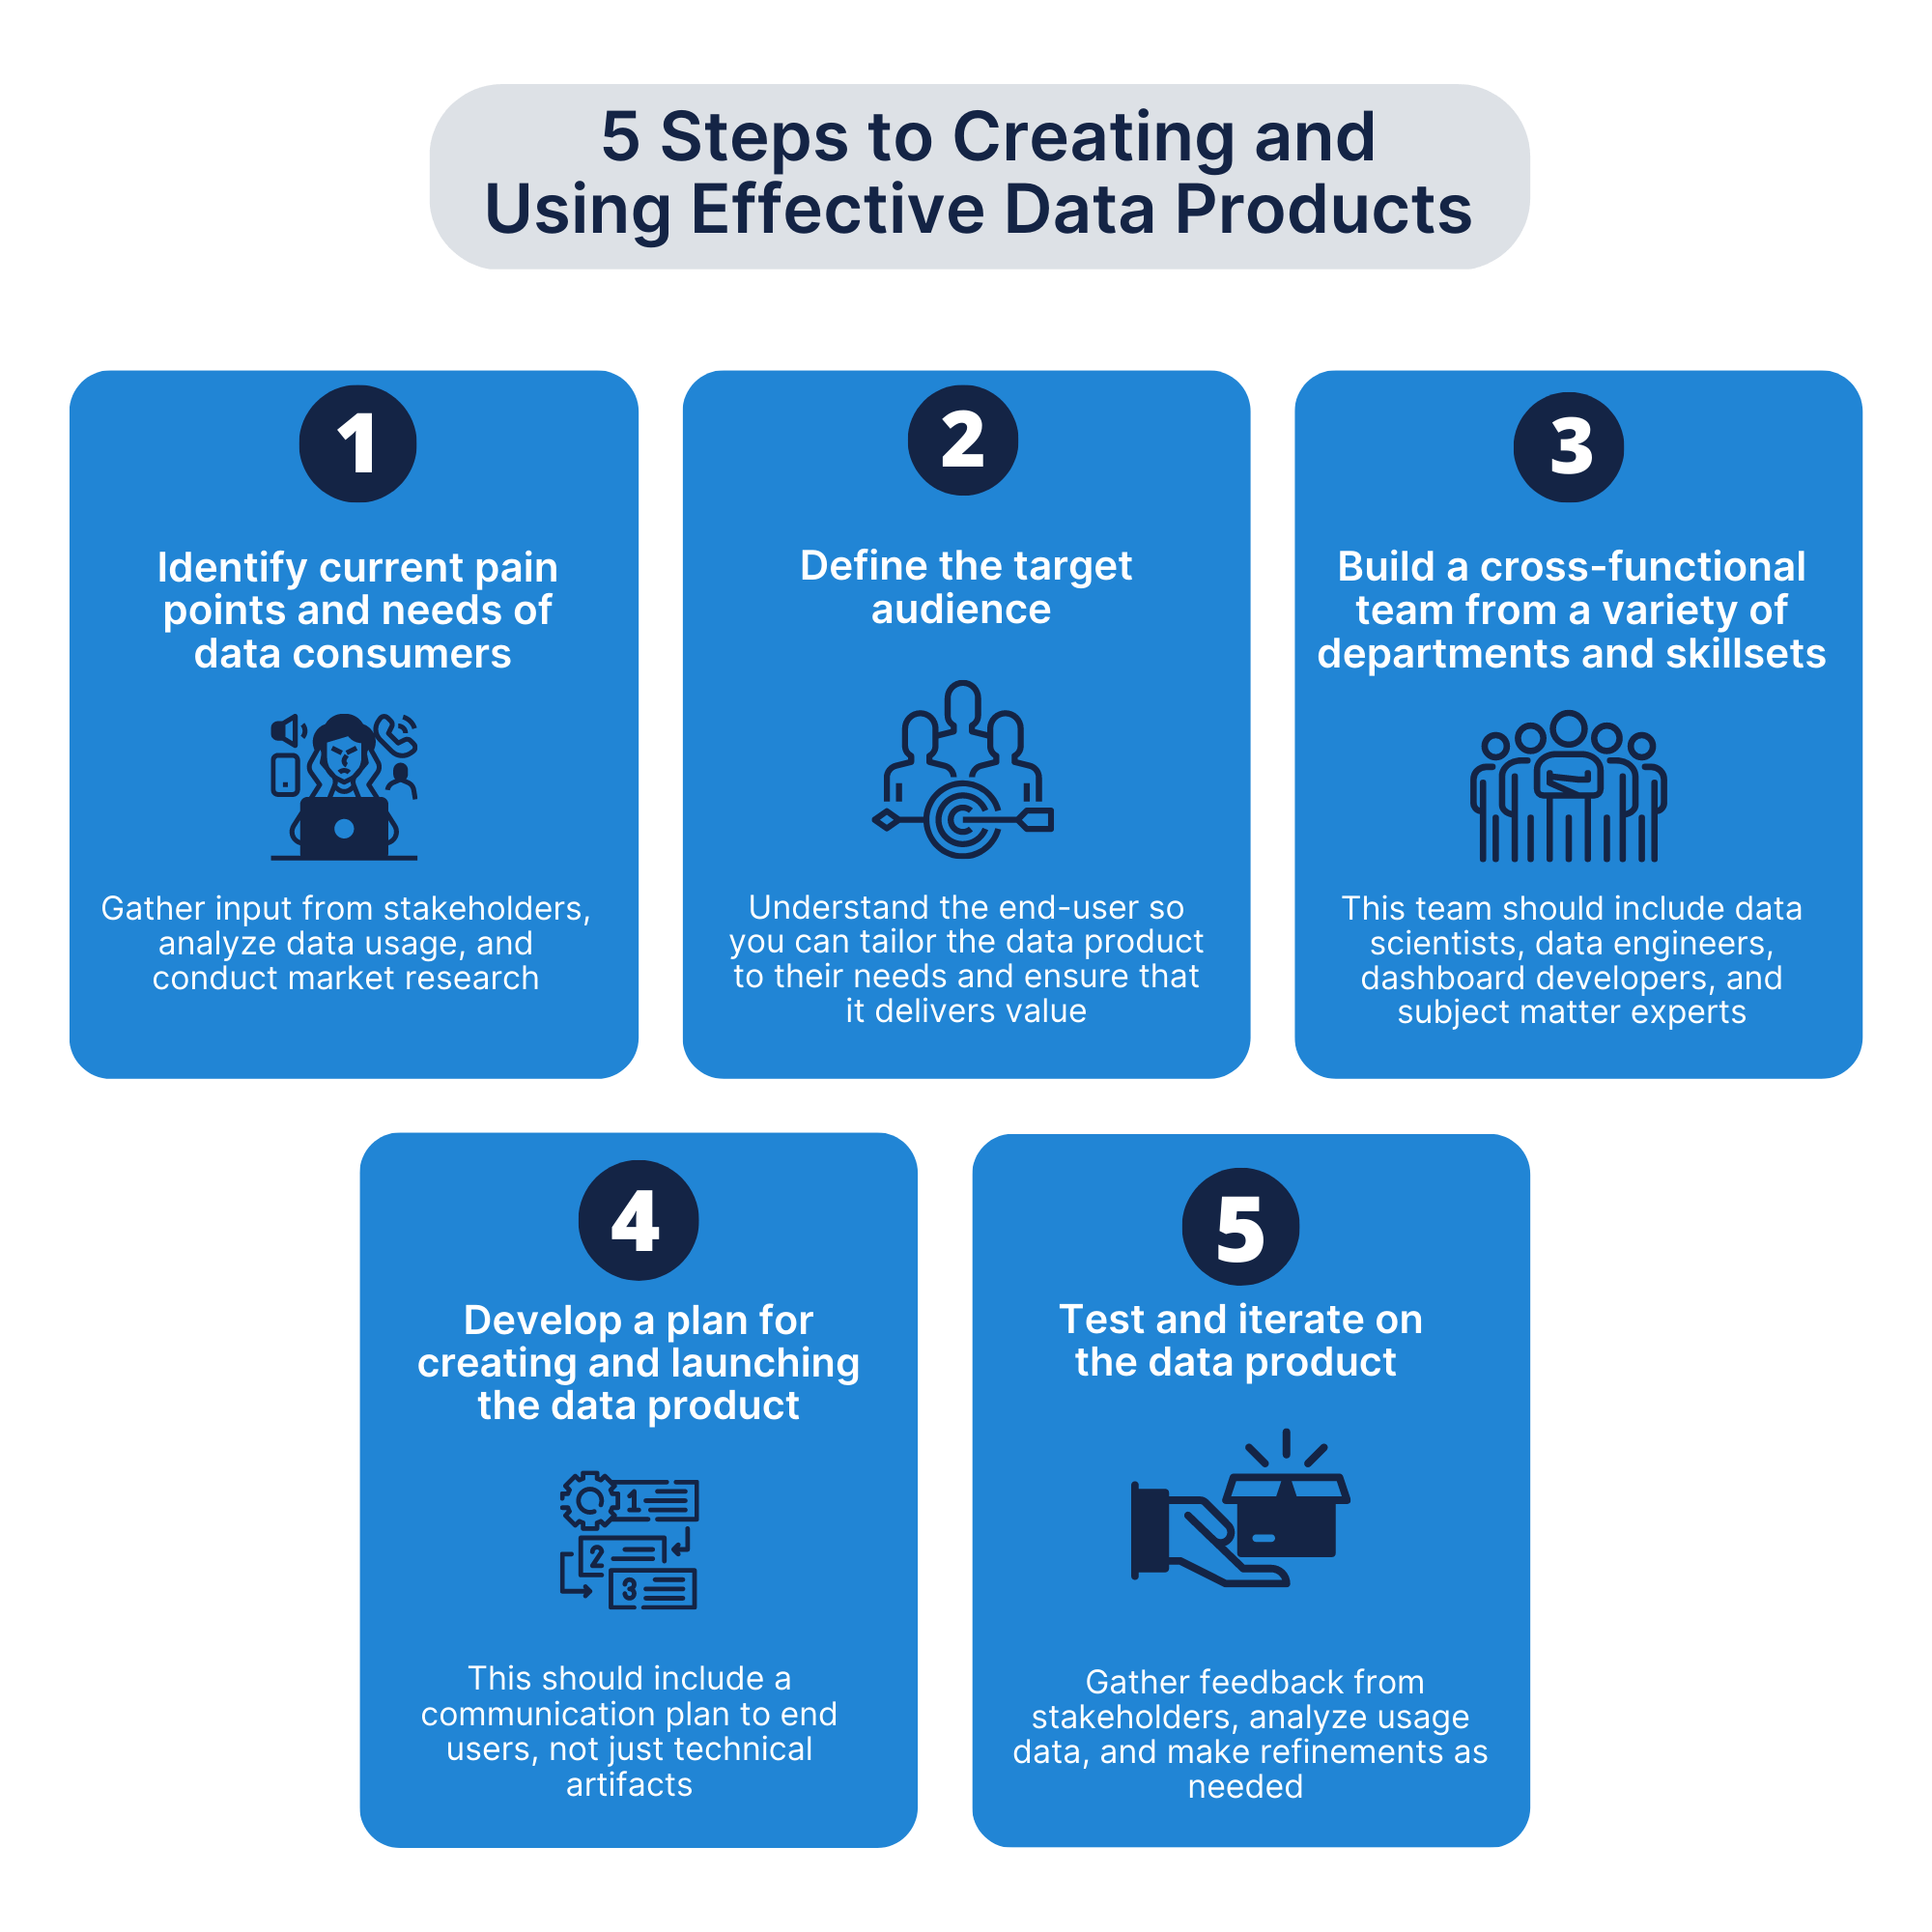
Начните с выявления критических потребностей пользователей данных и бизнес-целей. Затем формируйте набор эпиков: «ремонт качества», «публичные наборы данных», «самообслуживание BI», «фичи для моделей», «контроль доступа и безопасность». Определите зависимости между эпиками и их приоритеты. Разбейте дорожную карту по выпускам, где каждый выпуск приносит конкретную ценность: например, выпуск 1 — каталог данных и базовый набор метрик, выпуск 2 — дашборды и контракты, выпуск 3 — фич-стор и модели. Ваша дорожная карта должна быть живым документом и обновляться по мере изменений бизнеса и данных.
12) Как внедрять data contracts на практике?
Определите набор ключевых полей, форматы типов, допустимые значения, политики валидации и времена обновления. Введите версионирование контрактов и тестирование совместимости. Установите процессы уведомления потребителей об изменениях и регламент миграций схем. Прототипируйте контракт на небольшом наборе данных и расширяйте на остальные источники по мере уверенности в архитектуре. Доказательство концепции и ранний MVP по контрактам помогают уменьшить риск при масштабировании.
13) Какие практики повышения качества данных особенно эффективны?
- Внедрять автоматические тесты качества и регрессионные проверки на каждом шаге конвейера.
- Визуализировать и мониторить метрики качества с понятной визуализацией.
- Использовать линейность данных и трассировку, чтобы видеть, как изменение в источниках влияет на потребителей.
- Обеспечивать защиту приватности и соответствие регуляторике с самого начала цепочки.
- Регулярно проводить аудиты и ретроспективы по качеству и контрактам.
14) Как интегрировать российские решения в глобальную экосистему данных?
Используйте открытые форматы и протоколы обмена данными (Parquet/ORC, Avro, JSON Schema), чтобы данные могли легко двигаться между системами. Интегрируйте с локальными инфраструктурами и облаками для соблюдения локальных правил, но выбирайте совместимые инструменты (например, ClickHouse для аналитики, Kafka для потоков, Spark/Beam для обработки). Обеспечьте единые политики безопасности, мониторинга и контрактов независимо от выбранной платформы. Это позволит сохранить гибкость и устойчивость к изменениям в регуляторике и технологиях.
15) Что сделать в первые 30–60 дней на новом месте?
- Провести аудит существующих источников данных и потребителей.
- Определить первых двух–трёх доменов для пилотного внедрения data contracts, каталога и базового набора метрик качества.
- Настроить простой конвейер ETL/ELT и базовую визуализацию ключевых KPI.
- Внедрить начальные политики доступа и маскирование для чувствительных данных.
- Организовать регулярные встречи с бизнес-стейкхолдерами для сбора обратной связи и корректировки дорожной карты.
Примечания к техническим примерам
- Открытые инструменты: их преимущества — гибкость, активное сообщество, прозрачность. В качестве основы можно выбрать стек с Apache Kafka, Spark, Airflow, Parquet/ORC, ClickHouse, Superset, Feast, Great Expectations, OpenMetadata.
- Российские компоненты: ClickHouse как аналитическая база, Яндекс.Облако и Яндекс DataSphere для инфраструктуры и экспериментов, локальные решения для миграции и локализации данных. Важно сочетать открытые технологии с локальными сервисами для обеспечения соответствия требованиям и уменьшения задержек.
Дайте знать, если нужно адаптировать материал под конкретный домен вашей компании (финансы, ритейл, телеком и т.д.) или привести конкретные сценарии внедрения под ваш организационный контекст.


