

План устойчивого развития НСИ: обновления и перспективы
План устойчивого развития НСИ: обновления и перспективы — это часть курсового модуля по внедрению системы НСИ (системы нормативно-справочной информации). В этой главе мы сосредоточимся на том, как выстроить долговременную, управляемую и предсказуемую практику обновления справочников и нормативной информации в рамках организации или ведомства. Мы обсудим теорию устойчивого развития НСИ, ключевые методологии, практические подходы к реализации, технические детали и риски, связанные с внедрением. В конце — блок вопросов и ответов, которые помогут закрепить материал и подготовить к реальным задачам.
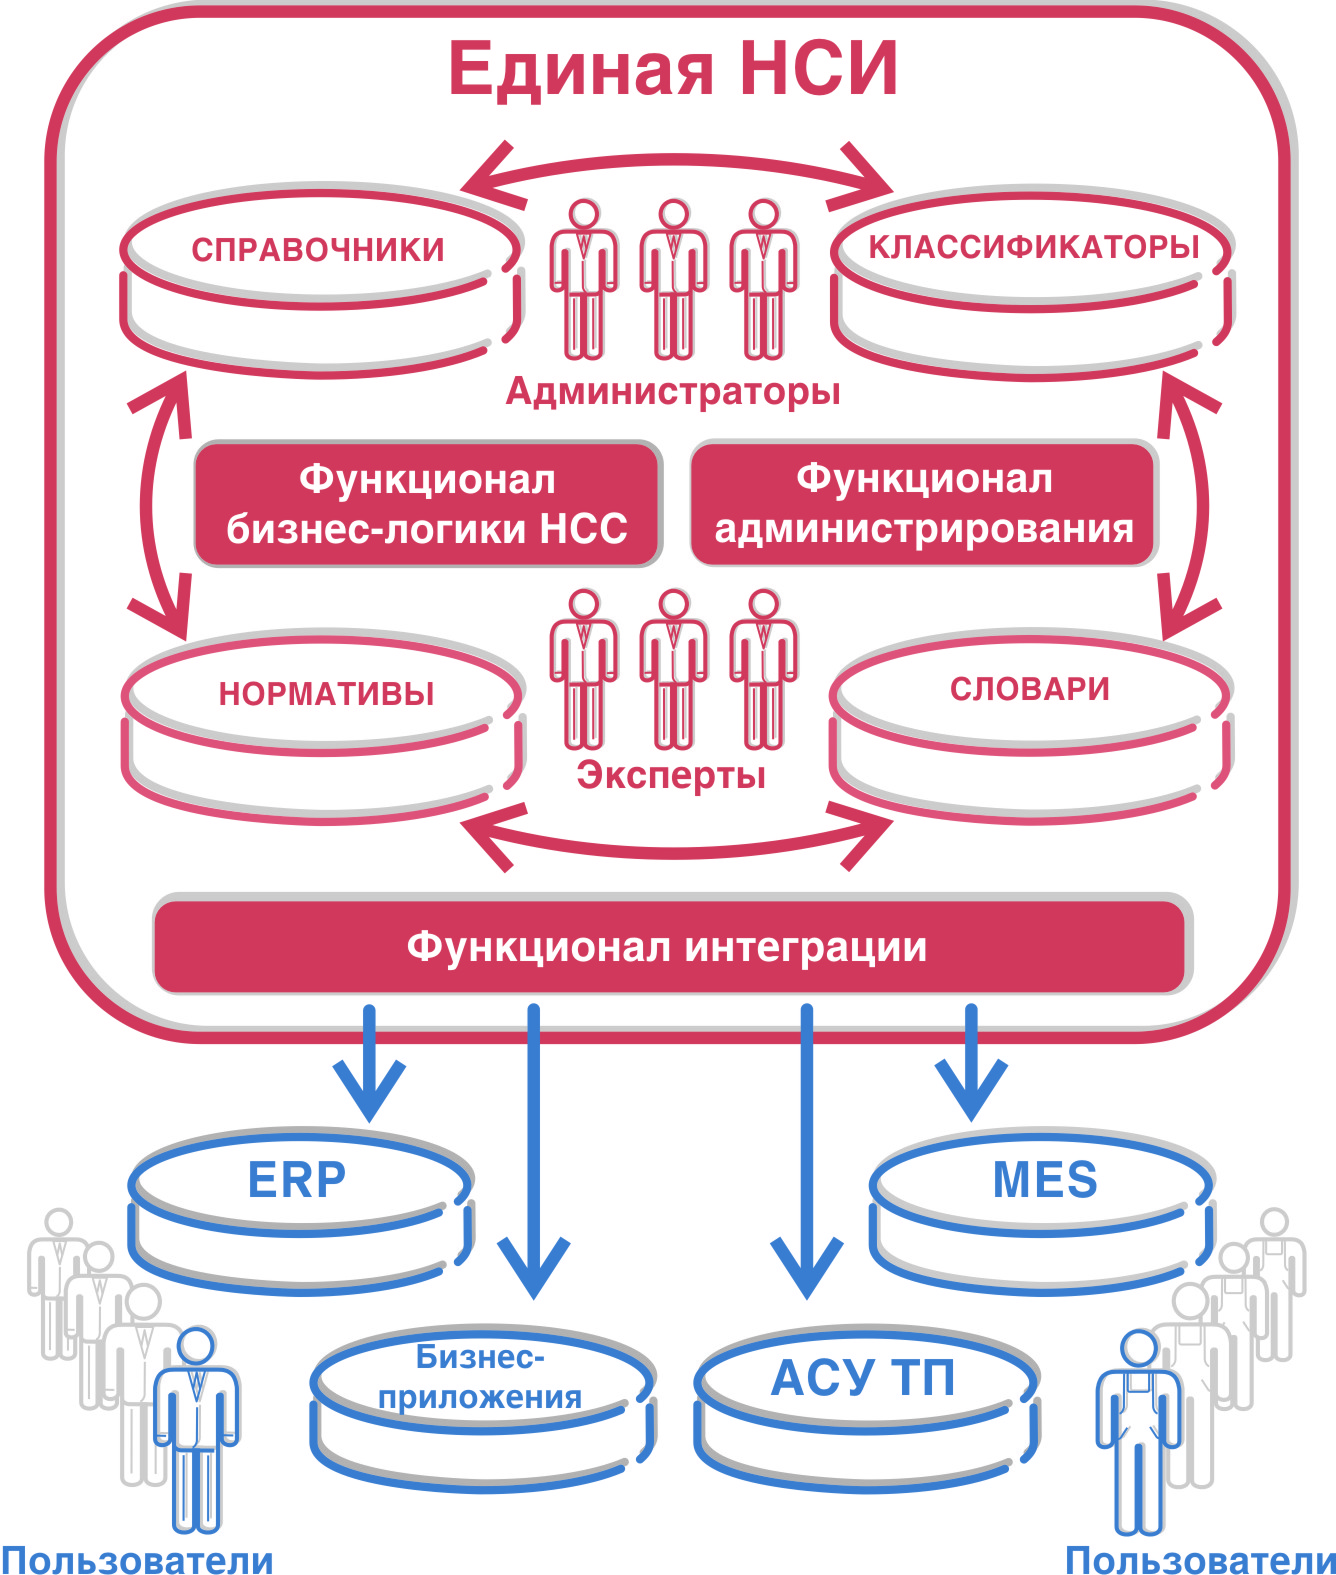
Что такое устойчивое развитие НСИ
Устойчивое развитие НСИ — это способность организации поддерживать и совершенствовать плановую цепочку управления нормативно-справочной информацией на протяжении всего жизненного цикла справочников: от их создания и обновления до публикации, хранения версий и архивирования. Ключевые характеристики устойчивости: своевременность обновлений, однозначная идентификация элементов справочников, полная и корректная информация о версиях, прозрачность процессов согласования, доступность для потребителей и совместимость с внешними запросами.
Основные концепции и термины
- НСИ (нормативно-справочная информация): информационные единицы, которые регламентируют поведение систем, процессов и объектов в организации и регулируют взаимоотношения между ними.
- Справочник: набор элементов НСИ (кластеры, элементы справочников, атрибуты), объединенный общей семантикой и бизнес-правилaми.
- Версионирование: хранение нескольких версий справочника и его элементов, чтобы можно было проследить изменения во времени, понять, что именно изменилось и почему.
- Управление данными (data governance): совокупность процессов, ролей и технологий, обеспечивающих качество, доступность, актуальность и соответствие требованиям к данным.
- Привязка к законодательству и регуляторике: НСИ должна отражать актуальные нормы, определения и ссылки на нормативные акты, стандартные формы и регламентирующие документы.
- Метаданные и происхождение данных ( provenance): информация о происхождении, времени обновления, источниках и согласованиях справочников.
- Интероперабельность: способность систем обмениваться данными с другой системной средой через общие форматы, схемы и API.
- Модель жизненного цикла данных (data lifecycle): этапы создания, редактирования, согласования, публикации, обновления, архивирования и удаления элементов справочника.
Методологии и подходы к внедрению
- Жизненный цикл НСИ как управляемый процесс: планирование обновлений, сбор изменений, их валидация, согласование, версияция и публикация в продакшен. В рамках каждого этапа существуют роли и регламенты, которые должны быть документированы.
- Управление изменениями (change management): формализация процедур запрашивания изменений, их оценки в плане влияния на потребителей НСИ, тестирования и аудита перед публикацией.
- Архитектура на основе сервисов: разнесение функций по микросервисам и API, что обеспечивает масштабируемость и гибкость. В контексте НСИ это могут быть сервисы: каталог НСИ, конвейеры обновлений, валидаторы данных, сервисы семантики и поиск.
- Безопасность и соответствие: соблюдение требований к персональным данным, защиты информации, аудита изменений, журналирования и мониторинга доступа.
- Метаданные и качество: применение стандартов описания, верификация полноты и точности данных, мониторинг качество данных в режиме реального времени и по расписанию.
Роль технологий и инфраструктуры
Устойчивость НСИ достигается не только за счет процессов, но и через архитектурные решения и современные технологии. Важны:
- Управление версиями: возможность хранить и восстанавливать версии элементов справочников.
- Нормативные ссылки и идентификация: уникальные идентификаторы (URI или устойчивые к версии идентификаторы), чтобы элементы НСИ можно было однозначно ссылаться в системе и внешних сервисах.
- Метаданные и семантика: использование описательных метаданных, связанных понятий, ссылок на законодательные источники, использование PROV-O (пирамида происхождения данных) для аудита изменений.
- API-first подход: открытые REST/GraphQL API для потребителей НСИ, документированные интерфейсы и понятные контракты данных.
- Каталог и сбор изменений: система каталогов с возможностью агрегации из разных источников, методики сбора изменений, мониторинг и уведомления.
- Архитектура хранения: сочетание реляционных баз данных для структурированных данных, графовых хранилищ для семантики и связей, а возможно и RDF-хранилищ для сложной семантики и запросов.
Практические примеры
1) Пример обновления справочника и его жизненного цикла
Предположим, у организации есть справочник «Классификаторы нормативно-правовых актов». План обновления на квартал включает следующие шаги:
- Сбор изменений: от юридического отдела и руководителей отраслевых справочников.
- Валидация и нормализация изменений: проверки на полноту, отсутствие противоречий с другими справочниками, проверка уникальности идентификаторов.
- Драфт-версия: создание рабочей версии справочника с пометками об изменениях.
- Согласование: участие владельцев справочников, регламентные проверки и подтверждения обновлений.
- Публикация: перевод драфта в официальную версию, обновление доступа к данным через API и каталог НСИ, уведомление потребителей.
- Архивирование: сохранение предыдущих версий и журнал изменений.
- Мониторинг и аудит: отслеживание использования обновленной версии, логирование обращений к данным и контроль качества.
2) Практическая реализация на базе CKAN и открытых инструментов
CKAN (Comprehensive Knowledge Archive Network) — открытая платформа для публикации и управления наборами данных и метаданными. Пример реализации:
- Развертывание CKAN как каталога НСИ: хранение метаданных, версий и связей между элементами справочника.
- Интеграция с источниками через Harvesting: механизмы самозборки изменений из регуляторных порталов и внутренних систем.
- Механизмы версионирования: каждый элемент справочника имеет версии и changelog. Потребители могут запросить конкретную версию или увидеть историю изменений.
- API и поиск: REST API и полнотекстовый поиск по элементам справочников; фильтры по версиям, типам и источникам.
- Метаданные и семантика: добавление PROV-O-совместимых полей, указание источников, дат обновления и владельцев.
- Инфраструктура: размещение CKAN на отечественных облачных площадках (Яндекс.Облако или СберОблако), использование PostgreSQL как БД, Elasticsearch для полнотекстового поиска и Redis для кэширования.
3) Пример с российскими реалиями и локальными практиками
- Архитектура: локальное развёртывание в рамках российского облачного окружения с соблюдением требований по соблюдению законодательства о защите данных и отечественной криптографии (КриптоПро для цифровой подписи и PKI инфраструктура).
- Безопасность: внедрение аутентификации через OpenID Connect, роли и доступ по принципу минимальных прав, аудит доступа к НСИ.
- Законодательство и источники: связь элементов справочников с российскими нормативными актами, ссылками на сайты регуляторов и правовых актов. Вся история изменений документирована в журнале аудита.
- Обновления: плановый выпуск обновлений, где каждая новая версия сопровождается уведомлениями потребителей через подписку и интеграцию с системами уведомлений внутри организации.
4) Технические примеры архитектуры для устойчивого НСИ
- Базовые слои: источник данных — ETL/ELT конвейер, промежуточная логика — сервисы проверки и валидаторы, хранение — реляционная БД (PostgreSQL), семантика — тройки RDF в хранилище (например, Apache Jena Fuseki), каталог — CKAN, API — REST/OpenAPI.
- Сервисы: сервис справочников, сервис версионирования, сервис согласования, сервис уведомлений, сервис аудита и мониторинга.
- Инфраструктура: Kubernetes-кластер для оркестрации микросервисов, контейнеризация через Docker, CI/CD через GitLab CI/CD или Jenkins, мониторинг через Prometheus и Grafana, логирование через ELK-стек (ElasticSearch, Logstash, Kibana).
- Безопасность и соответствие: PKI, шифрование данных в покое и в транзите, управление доступом через роли, аудит и соответствие требованиям ФЗ о защите персональных данных и госрегламентам.
5) Российские решения и практики в рамках открытых технологий
- Яндекс.Облако и СберОблако как облачные площадки, где можно разместить CKAN, PostgreSQL, Kafka, Jena и другие компоненты, с учётом требований к отечественной инфраструктуре, сертификации безопасности и соответствующим локализационным настройкам.
- Использование отечественных криптографических средств (КриптоПро), встроенных в подпись документов и протоколы обмена (PKI, подписи документов, электронной подписи).
- Применение открытых форматов и протоколов для совместного использования НСИ: JSON, XML, RDF, SPARQL, REST API, OpenAPI, OAuth2, OpenID Connect.
- В рамках законодательства — обеспечение доступности справочников для субъектов, которые нуждаются в данных, и возможность аудита и отчётности по обновлениям и их влиянию на бизнес-процессы.
6) Роли и управление изменениями
- Владелец справочника: отвечает за корректность, полноту и актуальность сведений; принимает решения об обновлениях.
- Управляющий данными: координирует процессы обновления между подразделениями, следит за соблюдением регламентов.
- Бизнес-подразделения и регуляторы: инициируют изменения и получают уведомления об обновлениях.
- Техническая команда: реализует конвейер обновлений, обеспечивает качество данных, управляет инфраструктурой и безопасностью.
7) Метрики успеха
- Время цикла обновления: время от запроса на изменение до публикации новой версии.
- Процент успешных публикаций без ошибок в валидаторах.
- Уровень доступности НСИ для потребителей (uptime).
- Точность и полнота данных по метрикам качества.
- Уровень удовлетворенности потребителей через обратную связь и опросы.
Архитектура и данные
- Модель данных: элементы справочника имеют уникальный идентификатор, версию, статус (черновик, утверждено, опубликовано), временные рамки действия, источники изменений и ссылки на нормативные акты.
- Идентификаторы: используйте URI/URN для элементов НСИ, чтобы обеспечить долговечность ссылок и повторное использование в разных системах.
- Метаданные: применяйте наборы как Dublin Core для базовых полей, а также специфические поля для НСИ (например, ссылка на акт, номер версии, статья закона, дата обновления, ответственность лица).
- Семантика: для сложной интеграции можно использовать RDF и OWL с формальным описанием понятий и связей между элементами. Это упрощает семантический поиск и интеграцию с другими системами.
Хранение и версии
- Реляционная БД (PostgreSQL) поддерживает строгие схемы и транзакции, и хорошо подходит для хранения структурированных данных НСИ.
- Графовое хранение (например, Neo4j) может быть полезно для моделирования связей между элементами НСИ и связанных документов.
- RDF-хранилища (например, Apache Jena Fuseki) позволяют выполнять семантические запросы с помощью SPARQL и поддерживают гибкую модель семантики.
- Версионирование: хранение версий элементов и связанных материалов, журнал изменений (чего коснулся каждый апдейт, кто одобрил и т. д.). Веб-архивы и журнал аудита сохраняют целостность и прослеживаемость.
Конвейер обновлений и автоматизация
- Интеграция источников изменений: настройка извлечения изменений из регуляторных порталов и внутренних систем через API, RSS/Atom-каналы, OAI-PMH или кастомные коннекторы.
- Валидаторы: автоматические проверки полноты, согласованности между справочниками, отсутствия дубликатов, совместимости с бизнес-правилами.
- Конвейер согласования: задача на утверждение изменений, уведомления соответствующим лицам, автоматическая блокировка в случае несоответствия.
- Публикация: автоматический выпуск новой версии в каталог НСИ и распространение потребителям через API и подписки.
- Архив: хранение предыдущих версий, обеспечение доступа к истории изменений.
API и интеграции
- REST API: доступ к элементам НСИ, версиям, фильтрам по типу справочника, состоянию, источнику. Поддержка аутентификации OAuth2/OpenID Connect.
- GraphQL (опционально): гибкие запросы к данным НСИ без перегрузки ответов.
- Событийная архитектура: использование Kafka или RabbitMQ для оповещений потребителей об обновлениях и изменений.
- Интеграционные паттерны: табличные экспорты, вебхуки, пакетные загрузки и синхронизация в режиме реального времени.
Безопасность и соответствие
- Аудит доступа и изменений: хранение журналов доступа, действий по каждому элементу справочника, чтобы можно было отследить любые нежелательные операции.
- Защита данных: шифрование в покое и в транзите, управление ключами, сегментация прав доступа между уровнями.
- Соответствие требованиям: соблюдение законов о персональных данных, требования к госинформационным системам, сертификации и методологий ФСТЭК/ФСБ по безопасности.
Практические примеры реализации
- Развертывание CKAN на российских облачных площадках, связанное с локализацией и настройкой доступа. Каталог НСИ хранит метаданные и версии, а сам текст нормативной справки остается в безопасной хранилище.
- Использование Apache Jena для семантики и RDF-моделей, чтобы обеспечить сложный поиск и связи между актами, нормами и справочниками.
- Интеграция с отечественными средствами подписи и PKI для обеспечения безопасной аутентификации и подписи обновлений.
- Визуализация и мониторинг через Grafana или Metabase для контроля качества, времени публикации, доступности и других KPI.
Риски и ограничения
1) Риск несоответствия законодательству и регуляторике
- Обновления и новые нормы могут потребовать оперативного пересмотра справочников. Необходимо иметь процесс управления изменениями, чтобы быстро адаптироваться к изменениям законодательства и обеспечить точность справочников.
2) Риск качества данных
- Неполнота, противоречивость или устаревшие данные ведут к неправильной интерпретации и ошибочным бизнес-решениям.
- Решение: автоматические валидаторы, рейтинги качества, регулярные аудиты и контроль данных.
3) Риск инфраструктуры и доступности
- Проблемы с производительностью или доступностью при больших объемах данных и активной подписке.
- Решение: горизонтальное масштабирование, кэширование, резервное копирование, мониторинг и аварийное восстановление.
4) Риск безопасности и конфиденциальности
- Утечки данных, нарушение аутентификации, несанкционированный доступ к НСИ.
- Решение: строгие политики доступа, аудит, шифрование, использование PKI и безопасной инфраструктуры, тестирование на проникновение.
5) Риск зависимости от внешних поставщиков
- В случае использования коммерческих сервисов существует риск изменения условий или прекращения поддержки.
- Решение: использование открытых форматов, поддержка локальных решений и создание резервного плана.
6) Ограничения в частоте обновления и синхронизации
- В зависимости от регуляторной практики обновления могут иметь разные таймлайны, и синхронизация между системами может быть сложной.
- Решение: устанавливать реалістичные графики обновлений, автоматическую очередность и понятные правила публикации.
7) Ограничения в квалификации персонала
- Необходимость постоянного обучения сотрудников и развитие навыков по данным и data governance.
- Решение: создание обучающих материалов, наставничество, регулярные тренинги и сертификации по данным и безопасности.
8) Локализация и соответствие российского законодательства
- Внедрение и адаптация к требованиям по локализации и ограждению данных в РФ.
- Решение: выбор отечественных облачных площадок, использование российских криптографических средств, соблюдение ФЗ и регуляторных требований.
9) Ограничения совместимости и интеграции
- Разные системы внутри организации могут использовать несовместимые форматы или версии.
- Решение: стандартизация форматов данных (JSON, XML, RDF), документирование контрактов и контрактов версий, внедрение API-управления.
План устойчивого развития НСИ — это многоуровневый подход к управлению нормативно-справочной информацией на протяжении всего ее жизненного цикла. Включение продуманной архитектуры, открытых форматов, контрактов версий и безопасной инфраструктуры, а также четкие регламенты обновлений и согласований позволяют обеспечить точность, доступность и прозрачность НСИ. Важными элементами являются: правильные роли и процессы, мощная технологическая база (реляционные и графовые хранилища, RDF, API, очереди), а также соблюдение законодательства и обеспечение защищенности данных. В результате вы получаете устойчивую систему, которая поддерживает бизнес-процессы, регуляторные требования и потребности пользователей, а также готова к будущим изменениям и расширениям.
Вопрос–Ответ (FAQ)
1) Что такое план устойчивого развития НСИ и зачем он нужен?
Ответ: Это набор процессов, регламентов и технических решений, обеспечивающих устойчивое управление обновлениями НСИ в рамках жизненного цикла справочников: от запроса изменений до публикации, архивирования и аудита. Он нужен для обеспечения точности, своевременности и прозрачности справочников, предотвращения ошибок и обеспечения совместимости между системами.
2) Какие роли задействованы в устойчивом управлении НСИ?
Ответ: Владелец справочника отвечает за корректность и актуальность, Управляющий данными координирует процессы обновления, бизнес-подразделения инициируют изменения, техническая команда реализует конвейеры обновлений, а регуляторы и потребители — пользуются результатами и дают обратную связь.
3) Какие технологические решения можно использовать для реализации НСИ?
Ответ: Открытые решения включают CKAN как каталог данных, Apache Jena для семантики и RDF-хранилища, PostgreSQL для структурированных данных, Elasticsearch для поиска, Kafka или RabbitMQ для событийной архитектуры. В качестве инфраструктуры можно использовать Kubernetes, Docker, CI/CD (GitLab CI/CD), мониторинг через Prometheus и Grafana. Реализация может происходить на российских облачных площадках (Яндекс.Облако, СберОблако) с использованием отечественных средств защиты (КриптоПро).
4) Как обеспечить качество данных в НСИ?
Ответ: Через автоматические валидаторы данных, определение процедур контроля качества, плановые аудиты, контроль полноты и согласованности между справочниками, а также через журнал изменений и аудит доступа к НСИ.
5) Какие риски наиболее критичны при внедрении НСИ?
Ответ: Несоответствие законодательству и регуляторике, низкое качество данных, проблемы с безопасностью и доступностью, зависимость от внешних поставщиков, ограничения по обновлениям и ограничение квалификации персонала. Все они требуют соответствующих процессов управления изменениями, мер по безопасности, планов устойчивости и квалифицированной команды.
6) Какие практические шаги можно начать в ближайшее время?
Ответ: Определить ключевые справочники для проекта, сформировать регламенты обновлений и согласований, выбрать каталог НСИ (например, CKAN) и базовую инфраструктуру (PostgreSQL + RDF-хранилище), настроить API и уведомления, обеспечить безопасность и аудиты, начать пилотную реализацию на одном или двух справочниках с планом масштабирования.
7) Как обеспечить соответствие требованиям российского законодательства?
Ответ: Использовать отечественные облачные площадки и инфраструктуру, применять криптографические средства (КриптоПро), внедрить процедуры аудита доступа и изменений, держать обновления и источники в соответствии с регуляторами, документировать процессы и обеспечить прозрачность операций.
8) Какие метрики важны для оценки устойчивости НСИ?
Ответ: Время цикла обновления, доля успешных публикаций, доступность НСИ, качество данных (точность, полнота), время реакции на запросы пользователей и удовлетворенность потребителей, частота аудитов и соответствие регламентам.
9) Какую роль играют метаданные и provenance в НСИ?
Ответ: Метаданные описывают содержание и свойства справочников; provenance фиксирует происхождение, источники изменений и контекст обновлений, что обеспечивает аудит и воспроизводимость изменений.
10) Что важно учесть при выборе архитектуры для НСИ?
Ответ: Необходимость поддержки версий и аудита, обеспечение безопасного доступа, гибкую интеграцию с потребителями через API, возможность масштабирования и поддержки семантики, использование открытых форматов и совместимых протоколов, а также внедрение устойчивой инфраструктуры на отечественных площадках.


