

Что такое каталог Iceberg: принципы работы
Что такое каталог Iceberg и зачем он нужен в Lakehouse? В мире современных хранилищ данных Iceberg выступает как открытый формат таблиц для больших наборов данных, который обеспечивает надежную схему, эффективное управление версиями метаданных и совместимую работу разных инструментов обработки данных. Каталог Iceberg — это не просто место, где лежат таблицы; это механизм регистрации и доступа к метаданным таблиц: он хранит связь между логическим именем таблицы и физическим местоположением ее метаданных, обеспечивая единый путь к данным независимо от того, какой инструмент или язык обращения вы используете. Эта глава посвящена принципам работы каталога Iceberg и тому, как с его помощью выстроить устойчивый и управляемый процесс работы с данными в рамках курсового направления «Настройка и использование каталогов для Iceberg Lakehouse».
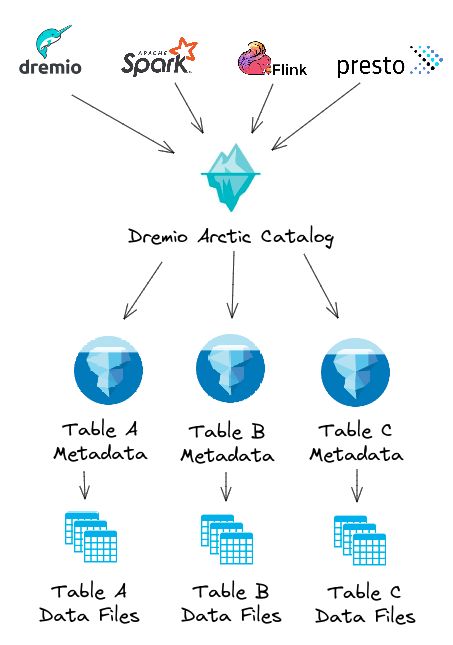
Что хранит Iceberg и зачем нужен каталог
Iceberg моделирует данные как таблицу, для которой вся история изменений и текущее состояние управляются через набор файлов в файловой системе (или объектном хранилище). Главные элементы: данные в файлах форматов Parquet/ORC, схема таблицы, манифесты, снимки (snapshots) и, главное, метаданные, которые описывают текущее состояние таблицы и её эволюцию во времени.
- Метаданные (metadata) — центральный репозиторий состояния таблицы, который хранится в каталоге таблицы. В Iceberg обычно имеется файл-версия манифестов и снимок, указывающий на актуальное состояние.
- Метаданные версии и истории — позволяют реализовать «временное перемещение» по данным (time travel) и восстанавливать предыдущее состояние таблицы.
- Схема и эволюция схемы — Iceberg поддерживает безопасное изменение схемы, добавление/удаление столбцов, изменение типов и переименование с сохранением обратной совместимости.
- Разделение по партитионным стратегиям — Iceberg может управлять разделами (partition specs) независимо от физического размещения файлов, обеспечивая эффективный доступ без полного пересоздания таблицы.
- Метаданные и транзакции — каждый коммит изменений таблицы — операция атомарная, и Iceberg гарантирует целостность на уровне файловой системы, даже если при этом участвуют несколько обработчиков данных.
Каталог Iceberg: определение и роли
Каталог Iceberg — это компонент, который регистрирует имена таблиц и сопоставляет их с конкретными местами хранения их файлов и метаданных. Каталог позволяет обратиться к одной и той же таблице по логическому имени независимо от того, какой инструмент работает с ней (Spark, Flink, Presto/Trino, Hive, и т. д.). В Iceberg существует несколько реализаций каталога, каждая из которых подходит под разные сценарии эксплуатации:
- Hive Metastore (HMS) каталог — наиболее распространенный в связке с Hadoop/Spark, когда таблицы Iceberg интегрируются с Hive Metastore. HMS хранит базовую конфигурацию базы данных и таблиц и обеспечивает централизованный реестр.
- Hadoop Catalog (локальный каталог) — каталог, который хранит информацию в файловой системе целиком в виде файловой структуры под каталогом конкретной таблицы; подходит для «локального» deployments без внешнего HMS. Применим в условиях изолированной инфраструктуры.
- Iceberg REST Catalog — современная реализация каталога через REST-сервис. Обычно разворачивается как отдельный сервис и поддерживает безсерверные/облако-ориентированные сценарии, где HMS недоступен или не желателен.
- Облачные каталоги: AWS Glue Catalog, Azure Data Catalog и т. п. — специализированные реализации под облачные провайдеры, которые интегрируются в экосистему вашего облака и обеспечивают управляемый сервис каталога.
Как каталог работает в связке с процессами обработки
- Определение и создание таблицы: пользователь или процесс обработки задает таблицу через соответствующий каталог. Каталог регистрирует таблицу и указывает путь к ее метаданным.
- Запись и изменение данных: при добавлении данных Iceberg обновляет файлы-данные и обновляет метаданные; каталог обеспечивает согласованное разрешение имен и доступ к текущему набору данных.
- Чтение и запросы: обработчики данных (Spark, Flink, Trino) используют каталог для резолвинга имени таблицы в конкретное место хранения; затем читают данные через формат Parquet/ORC и применяют схему и разделение.
- Эволюция схемы и разделов: Iceberg позволяет безопасно эволюционировать схему и параметры разделения; каталог обеспечивает согласованное применение изменений и историческую отслеживаемость.
- Time travel и история изменений: через снимки и истории таблицы пользователь может возвращаться к предыдущим состояниям данных для аудита, воспроизводимости экспериментов и восстановления после ошибок.
Теоретические принципы устойчивости и согласованности
- Консистентность метаданных: каждый коммит к таблице завершившийся успешно обновляет набор метаданных в каталоге; это минимизирует риск несогласованности между данными и их описанием.
- Отделение данных и метаданных: сами данные (файлы Parquet/ORC) и метаданные разделены; это позволяет эффективно обновлять метадную часть без повторной загрузки всех файлов.
- Механизмы блокировок и атомарности: Iceberg использует механизмы блокировок при коммитах, чтобы несколько процессов не конфликтовали при одновременном обновлении одной таблицы.
- Безопасное изменение схемы: изменения происходят через безопасные операции добавления, удаления, переименования столбцов с проверкой совместимости, чтобы не нарушить существующие запросы.
- Совместимость между каталогами: в отдельных сценариях можно мигрировать между разными типами каталогов, хотя это требует планирования и тестирования.
Практические примеры
Open-source примеры:
1) Пример с Hive Metastore (HMS) как каталогом
Сценарий: у вас есть кластер Spark и HMS в качестве реестра таблиц. Вы хотите открыть таблицу Iceberg, хранить метаданные в HMS и держать данные в Parquet на HDFS или S3.
Что нужно: запуск HMS (установить MySQL или PostgreSQL под HMS, настроить thrift-сервис), настройка Hive конфигураций в кластере, запуск Spark/Flink с зависимостями Iceberg.
Как это делается:
- Настройка HMS: запустите Hive Metastore с базой данных (например, MySQL). Убедитесь, что HMS доступен по thrift URI.
- Настройка Spark для использования HMS как каталога:
- В конфигурации Spark зарегистрируйте каталог Iceberg:
      spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
      spark.sql.catalog.my_catalog.type = hive
      spark.conf.set("spark.sql.hive.metastore.uris","thrift://metastore-host:9083")
Создание таблицы Iceberg:
- В Spark SQL: CREATE TABLE my_catalog.my_db.my_table (id BIGINT, name STRING) USING ICEBERG PARTITIONED BY (name)
Запись и чтение:
- spark.read/write через Spark SQL: вы можете писать и читать так же, как обычные Spark DataFrames, используя путь через my_catalog.my_db.my_table
История и time travel:
- можно запросить историю через SHOW HISTORY FOR my_catalog.my_db.my_table или через специальную функциональность Iceberg, например, AT TIMESTAMP или AT SNAPSHOT.
Преимущества и ограничения:
- Преимущества: централизованный HMS, хорошо знакомый инструмент для администраторов Hive-экосистемы.
- Ограничения: инфраструктура HMS требует поддержки и администрирования; возможны задержки в обновлениях метаданных при большом числе таблиц.
2) Пример с REST Catalog (Iceberg REST Catalog)
Сценарий: кластеры Spark и Flink работают в облаке, HMS недоступен, нужна независимая реализация каталога.
Что нужно: развёрнуть Iceberg REST Catalog сервис, настроить его под нужную инфраструктуру, подключить к Spark и/или Flink.
Как это делается:
- Разворачиваем Iceberg REST Catalog (обычно через контейнеры Docker/Kubernetes или в виде сервиса).
- Конфигурация клиентиков:
    spark.sql.catalog.my_rest_catalog = org.apache.iceberg.rest.SparkCatalog
    spark.sql.catalog.my_rest_catalog.type = rest
    spark.sql.catalog.my_rest_catalog.uri = http://iceberg-rest-catalog-host:8181
Создание таблицы через REST Catalog:
CREATE TABLE my_rest_catalog.my_schema.my_table (id BIGINT, data STRING) USING ICEBERG
Преимущества:
- Гибкость и масштабируемость, независимость от HMS.
- Хорошо подходит для облачных контейнеризированных рабочих нагрузок.
3) Российские решения и практики
Контекст: в российских условиях часто требуется локальная инфраструктура, где потенциально HMS развертывается внутри частного облака или локального дата-центра, данные хранятся в локальных или региональных хранилищах, а доступ к каталогу — через безопасные каналы, Kerberos и TLS.
Реализация на практике:
- Каталог HMS в локальной инфраструктуре: разворачивайте Hive Metastore на базе MySQL/MariaDB или PostgreSQL, настраивайте Kerberos и TLS для безопасности, используйте Iceberg в связке со Spark/Flink как в открытых примерах.
- REST Catalog в частном облаке: разворачивайте в Kubernetes как микросервис, используйте безопасный доступ через TLS и авторизацию/token-based; каталожная сервисная часть позволяет централизованно управлять таблицамиIceberg в рамках частной инфраструктуры.
- Интеграция с отечественными хранилищами: используйте Iceberg с Parquet на локальном HDFS или S3-совместимом хранилище, адаптируя конфигурацию доступов под корпоративные требования (VPN, VPC, приватные сетевые подключения).
- Примеры операций: создание таблицы через Spark, управление схемой и разделами, обеспечение консистентности между различными кластерами обработки, аудит изменений через журнал истории Iceberg.
Что это дает в российских условиях:
- Контроль над данными внутри юрисдикции компании.
- Возможность настройki соответствия требованиям нормативов и внутренней политики.
- Возможность использования открытых стандартов и интеграции с существующей инфраструктурой без сильной зависимости от внешних облачных сервисов.
Архитектура каталога и таблиц Iceberg
- Каталог: регистрирует таблицы и их манифесты, хранит путь к директории, где лежат метаданные к таблице.
- Таблица Iceberg: состоит из файлов данных ( Parquet/ORC ), файлов метаданных и сегментов, которые описывают конкретные разделы и версии.
- Метаданные: набор файлов в каталоге таблицы, включая метадный файл (metadata.json), ссылки на снимки, списки манифестов.
- Снимки (snapshots): фиксации состояния таблицы на конкретный момент времени; позволяют выполнять time travel.
- Манифесты (manifests): списки файлов данных, которые участвуют в конкретном снимке и в конкретной операции записи.
- Папки таблицы и структура: в каталоге таблицы Iceberg существует директория METADATA, где лежат текущий metadata.json и предыдущие версии. Также существуют директории data, possibly partitions, и т. д.
Типы каталогов и их особенности
Hive Metastore (HMS) каталог:
- Преимущества: знакомый инструмент для администраторов Hadoop-экосистемы, единое место регистрации; поддерживает централизованный контроль.
- Ограничения: требует поддержания HMS; нагрузка на HMS может увеличиваться при большом количестве таблиц и частых коммитах.
Hadoop Catalog (локальный файловый каталог):
- Преимущества: простота развёртывания, не требует внешнего сервиса каталога.
- Ограничения: ограниченная гибкость в мульти-кластерной архитектуре; простая регистрация может быть непригодна для больших команд.
Iceberg REST Catalog:
- Преимущества: независим от HMS, масштабируемость, удобство для контейнеризированных/кластерных сред.
- Ограничения: требует наличия отдельного сервиса и надёжного мониторинга/защиты.
Облачные каталоги (Glue и др.):
- Преимущества: готовые сервисы провайдера, интеграция с облачными хранилищами.
- Ограничения: зависимость от конкретного провайдера, стоимость и возможные ограничения по политике.
Безопасность и доступ
- Аутентификация и авторизация: Kerberos, TLS для метаданных и данных; интеграция с IAM или аналогичными механизмами в облаке; настройка ролей и ограничение по доступу.
- Шифрование на лежащем в almacenamiento: данные в Parquet защищены шифрованием на уровне хранилища; метаданные тоже могут быть зашифрованы в хранилище.
- Разграничение по проектам/пользователям: настройка прав на уровне каталога для чтения/записи, аудит действий.
Практические команды и конфигурации (примерные)
Пример конфигурации Spark для использования HMS каталогa:
  spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
  spark.sql.catalog.my_catalog.type = hive
  spark.sql.hive.metastore.uris = thrift://metastore-host:9083
Затем создание таблицы: CREATE TABLE my_catalog.my_db.my_table (id BIGINT, name STRING) USING ICEBERG PARTITIONED BY (name)
Пример конфигурации для REST Catalog:
  spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
  spark.sql.catalog.my_catalog.type = rest
  spark.sql.catalog.my_catalog.uri = http://iceberg-rest-catalog-host:8181
Создание аналогично предыдущему примеру, только через REST каталог.
Вопросы совместимости и миграции:
- Планируйте миграцию с HMS на REST Catalog, с учетом конвертации существующих таблиц Iceberg и их метаданных.
- Проведите тестирование в тестовой среде перед переносом в продакшн.
Риски и ограничения
Риски внедрения каталога Iceberg
- Сложность инфраструктуры: для надёжной работы каталога потребуется грамотное конфигурирование HMS/REST Catalog, TLS, Kerberos и мониторинг.
- Производительность и масштабируемость: у HMS может возникнуть узкое место при большом числе таблиц и частых коммитах. REST Catalog требует устойчивости сервиса и достаточного пространства для хранения версии метаданных.
- Миграции и совместимость: переход между каталогами (например, HMS ↔ REST Catalog), а также версий Iceberg может потребовать дополнительных миграционных шагов и тестирования.
- Безопасность: доступ к каталогу и хранилищу должен быть хорошо защищён, иначе возможны компрометации данных. Управление ключами, сертификатами, и доступами критично.
- Консистентность между кластерами: если у вас несколько кластеров Spark/Flink, нужно согласовать версии Iceberg и конфигурацию каталога, чтобы избежать несовместимости.
- Ведение аудита и соответствие требованиям: журнал изменений и история версий необходимы для аудита, особенно в регламентируемых отраслях (финансы, телеком и т. д.).
Ограничения и проектные решения
- Зависимость от базового каталога: если выбирается HMS, необходима стабилизация и поддержка HMS, включая обновления версий и совместимость с используемыми обработчиками.
- Законодательные ограничения на данные: в некоторых случаях требуется ограничение на кросс-региональное хранение или доступ к данным, что влияет на выбор каталога и архитектуры.
- Управление метаданными: большого объема таблиц и больших изменений требует продуманной политики хранения старых метадных файлов и эффективной очистки устаревших версий.
- Стоимость и операционное обслуживание: поддержка каталога, его высокодоступности и резервного копирования требует бюджета и квалифицированного персонала.
Каталог Iceberg играет ключевую роль в экосистеме Iceberg Lakehouse, объединяя множество инструментов обработки и обеспечивая единый путь к данным. Понимание принципов работы каталога, его типов и способов интеграции с существующей инфраструктурой позволяет проектировать устойчивые, безопасные и гибкие data-lake архитектуры. В реальной эксплуатации выбор каталога должен опираться на требования к доступу, масштабу, региональности и поддержке инфраструктуры: HMS для знакомого и централизованного подхода, REST Catalog для более гибкой и облако-ориентированной архитектуры, локальные каталоги для изолированных сред и облачные каталоги для использования преимуществ облачных сервисов. В любом случае, внедряя каталоги Iceberg, важно держать под контролем безопасность, аудит и устойчивость к изменению схемы и объема данных.
Вопрос–Ответ (FAQ)
1) Что такое каталог Iceberg и как он связан с таблицей Iceberg?
Каталог Iceberg — это механизм регистрации и доступа к таблицам Iceberg: он сопоставляет логическое имя таблицы с местом её метаданных и данных. Он не хранит сами данные, но управляет тем, где лежат файлы и как к ним обратиться. Таблица Iceberg — это совокупность файлов данных и метаданных, каталог же обеспечивает доступ к этим файлам и версионность.
2) Какие типы каталогов существуют и в чем их преимущества?
Существуют Hive Metastore (HMS), Hadoop Catalog (локальный файловый каталог), Iceberg REST Catalog и облачные каталоги (например, Glue). HMS предоставляет централизованный реестр и хорошо подходит для интеграции в существующую Hadoop-экосистему. REST Catalog удобен в контейнеризированных и облачных окружениях без зависимости от HMS. Hadoop Catalog прост и подходит для локальных, изолированных сред. Облачные каталоги облегчают интеграцию в облаке, но привязаны к конкретному провайдеру.
3) Какие параметры нужно учитывать при выборе каталога?
Учитывайте доступность метаданных, требования к локализации данных, уровень администрирования, требования к безопасности (Kerberos, TLS, IAM), масштабируемость, стоимость и совместимость с инструментами обработки (Spark, Flink, Trino). Если у вас есть уже существующий HMS и вы хотите централизованное управление, HMS — естественный выбор. Для облачных и контейнеризованных сред часто выбирают REST Catalog.
4) Как выглядит «путь» к таблице Iceberg и её метаданным?
Каждая таблица имеет свою директорию в хранилище, содержащую метаданные (metadata.json), списки манифестов и данные. Каталог хранит сопоставление между логическим именем таблицы и этой директории, обеспечивая доступ к таблице по имени независимо от того, какой инструмент работает с ней.
5) Как реализовать time travel в Iceberg?
Time travel доступен через снимки (snapshots) и историю изменений таблицы. Вы можете запросить данные на момент конкретного снимка или по TIMESTAMP. Это позволяет повторно воспроизводить эксперименты, восстанавливать данные после ошибок и проводить аудиты.
6) Какие риски связаны с внедрением каталога Iceberg в локальной инфраструктуре?
Риски включают сложность настройки и обслуживания HMS или REST Catalog, потенциальные узкие места при большом числе таблиц, вопросы миграции между каталогами, требования к безопасности и аудиту, а также необходимость обучения сотрудников работе с новой архитектурой.
7) Какие примеры практических внедрений можно привести?
Open-source примеры: использование HMS в Spark с созданием Iceberg таблиц и управлением метаданными через Hive Metastore; использование Iceberg REST Catalog для контейнеризированных и облачных сред; миграции между различными каталогами в тестовой среде перед продакшеном. Российские практики: развёртывание HMS внутри частного облака/локального дата-центра и интеграция Iceberg с локальными хранилищами, применение безопасного доступа через Kerberos/TLS, использование REST Catalog в частном облаке для гибкости и масштабирования; адаптация к региональным требованиям и политикам безопасности.
8) Нужно ли переписывать существующие запросы при переходе на Iceberg Catalog?
Обычно нет: запросы к Iceberg таблицам через Spark/Flink/Trino остаются аналогичными, но путь к таблице определяется через каталог. Однако миграция с одного каталога на другой требует проверки конфигураций и возможно миграции метаданных.
9) Какой уровень обучения необходим для команды?
Команда должна понимать принципы работы Iceberg, базовые концепции метаданных и манифестов, работу с каталогами, особенности конфигурации инструментов обработки (Spark, Flink, Trino), вопросы безопасности, аудит и мониторинга. Рекомендуется провести практические тренинги на тестовых таблицах и постепенно переходить к продакшен-сценариям.
10) Какие шаги можно рекомендовать для начала внедрения?
- Определите требования к локализации данных, доступу и безопасности.
- Выберите тип каталога (HMS, REST Catalog или локальный) в зависимости от окружения.
- Разверните выбранный katalog и базовые таблицы Iceberg в тестовой среде.
- Подключите к кластеру обработки (Spark/Flink) и проверьте базовые операции: создание таблиц, вставку данных, чтение, time travel.
- Организуйте управление версиями и аудит изменений, настройте мониторинг и алерты.
- Разверните миграционный план на продакшн с поэтапной проверкой и резервами.
Этот материал дал обзор концепций каталога Iceberg, рассмотрел практические сценарии внедрения и затронул риски и практические шаги. Теперь вы можете перейти к более детальному планированию реализации в вашей инфраструктуре, учитывая специфику рабочих нагрузок, регуляторные требования и доступные ресурсы.


