

Модели хранения и доступ к данным в облаке
Эта глава посвящена моделям хранения и доступу к данным в облаке. В ней объясняется, какие варианты хранения применяются в современных облачных решениях, какие принципы и API лежат в основе доступа к данным, какие требования к управлению данными возникают в рамках миграции в облако, какие оптимизации и риски сопровождают внедрение. Цель — дать новому сотруднику прочную теоретическую базу и практические инструменты для выбора подходящей модели хранения, проектирования архитектуры сохранения данных, планирования миграции и эксплуатации облачных хранилищ как части комплексной инфраструктуры обработки данных.
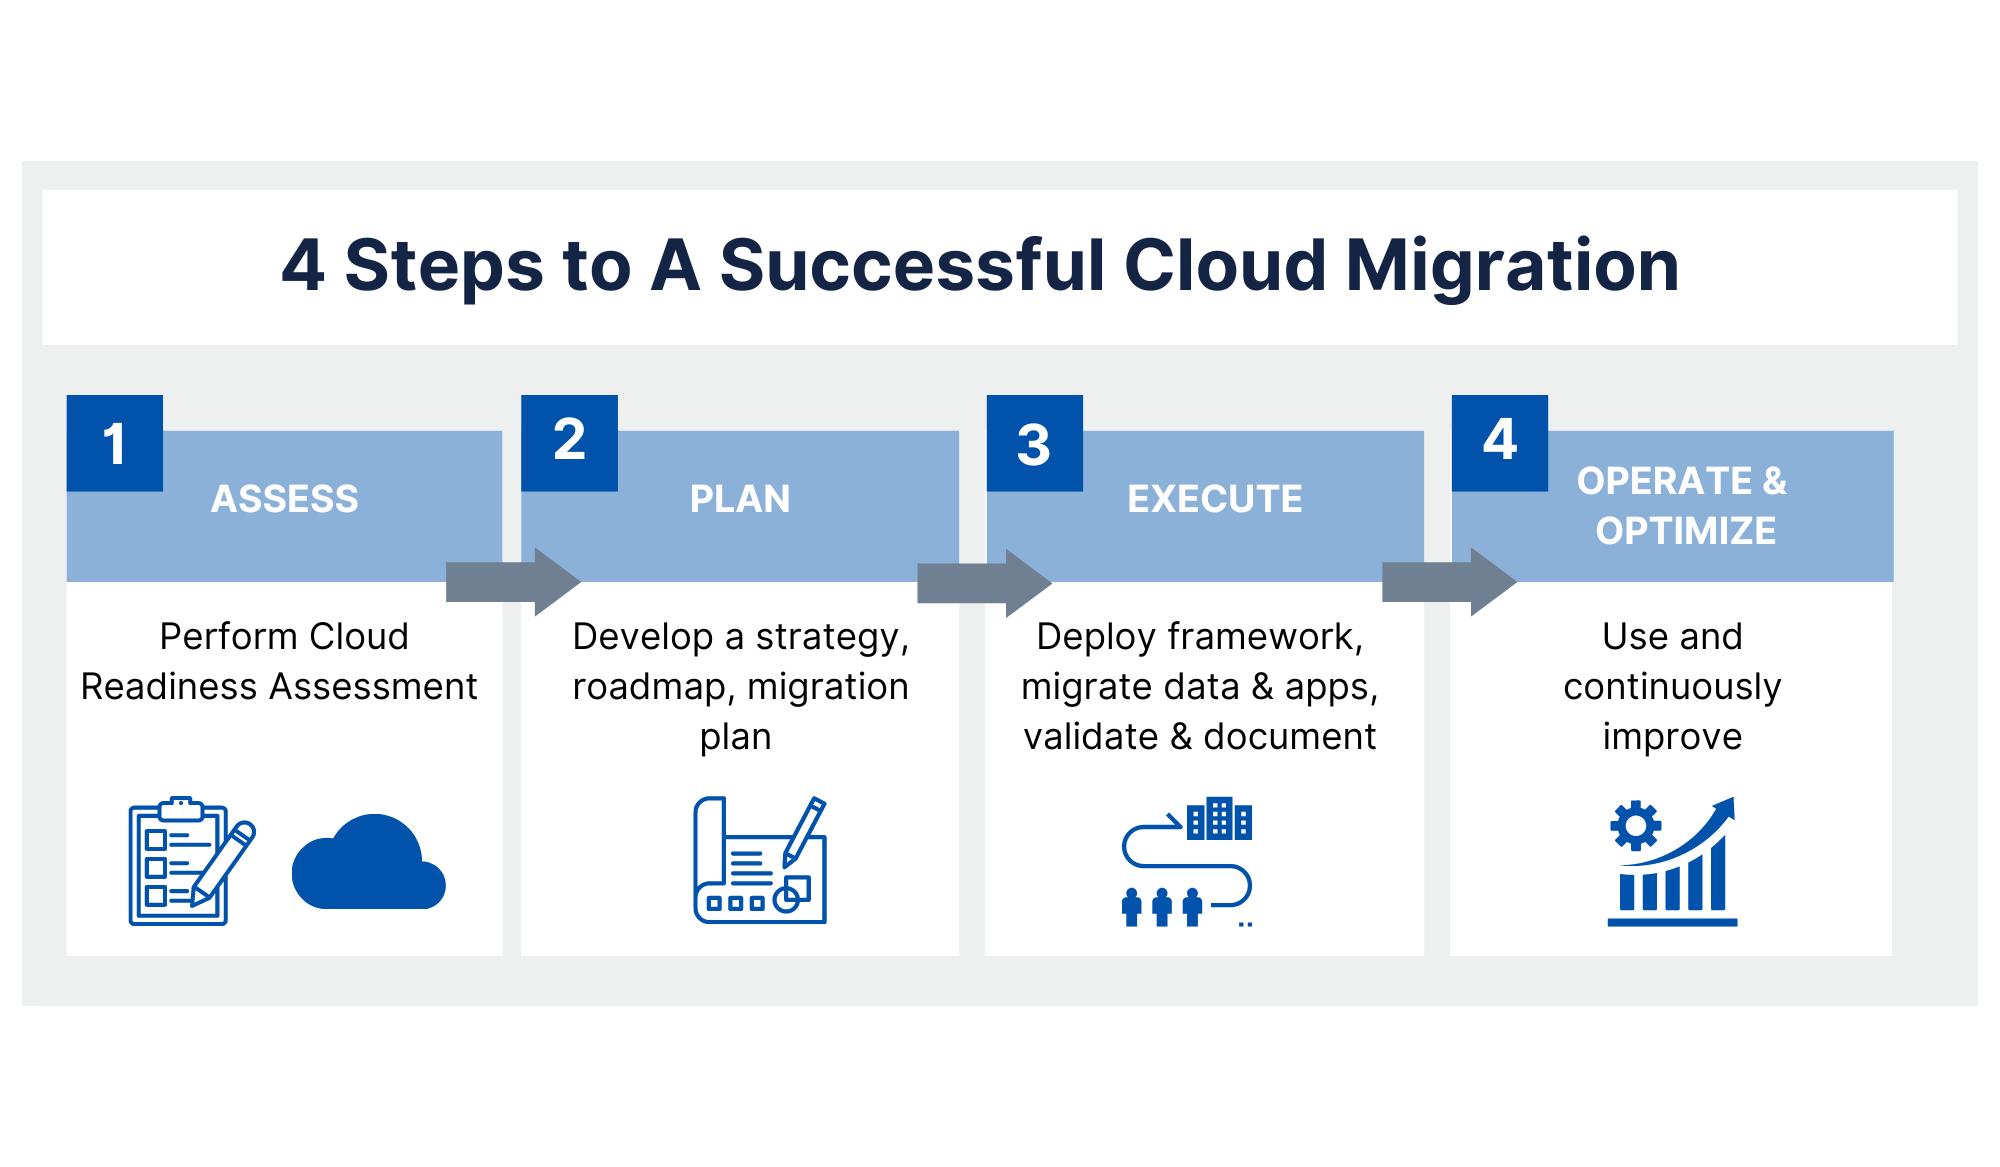
Модели хранения данных в облаке
- Объектное хранение (object storage). Это базовый и наиболее гибкий вид хранения для больших массивов полуструктурированных и неструктурированных данных: лог-файлы, мультимедийные файлы, архивы, снимки баз данных. Данные сохраняются как объекты в контейнерах-«бакетах» и индексируются метаданными. Характеристики: высокая масштабируемость, долговечность, доступ по уникальному идентификатору объекта, поддержка версионирования, жизненного цикла и политики хранения. API чаще всего совместим с S3-совместимым API, что облегчает переход между провайдерами и инструменты.
- Блочное хранение (block storage). Предоставляет блочные устройства, которые монтируются как диск на виртуальную машину. Подходит для операционных систем, баз данных и приложений, требующих низкой задержки и предсказуемой производительности ввода-вывода. Часто реализуется как виртуальные диски (VBD) внутри облака или частного облака. Производительность и латентность привязаны к размеру и характеру нагрузки.
- Файловое хранение (file storage). Предоставляет сетевые файловые системы, доступные по NFS/SMB. Удобно для приложений с POSIX-совместимым доступом и совместной работой между несколькими узлами. Применение: рабочие каталоги разработчиков, совместная работа, миграция файловых сервисов.
- Хранилища данных для аналитики и науки о данных (data lake, data warehouse, аналитические хранилища). Объектное хранение часто служит основой data lake, где хранятся сырые данные и метаданные, а поверх строят преобразование и загрузку в data warehouse. В облаках можно сочетать хранение в объектном формате и специализированные хранилища под аналитические запросы.
- Размещение и горизонтирование доступов. В рамках облаков часто применяются горизонтальные архитектуры: данные в одном бакете или наборе бакетов, но доступ к ним организуется через политики доступа, роли, принцип наименьших прав и сегрегацию сред (например, разделение между средой разработки, тестирования и эксплуатации).
Основные понятия и параметры
- Надежность и доступность. Показатели долговечности (durability) и доступности (availability) являются ядром SLO/SLA поставщика. В большинстве публичных облаков долговечность достигает 99.999999999% (11 девят), но она распространяется на конкретную стратегию хранения и уровень конфигурации (реконструкция данных, репликация между зонами/регионами).
- Производительность и пропускная способность. Включают операции ввода-вывода, пропускную способность сети, задержку доступа и размер блока. Для блокового хранения важны IOPS и latency, для объектного хранения — операции PUT/GET, скорость передачи больших объектов и параллелизм.
- Модель доступа и API. Самые распространенные интерфейсы — S3-совместимый API, REST, POSIX/NFS для файловых решений, SMB для совместной работы. S3-совместимый API позволяет легко мигрировать между провайдерами и интегрировать с инструментами open-source и корпоративными системами.
- Безопасность и соответствие. Шифрование данных в покое (AES-256 или аналог), управление ключами (KMS/CMK), шифрование в tránsito (TLS), IAM/ACPs (Identity and Access Management, политики доступа, роли), аудит и логи, соответствие требованиям регуляторов (GDPR, локализация данных, хранение архивов).
- Управление версиями, жизненный цикл и архивирование. Версионирование объектов помогает защититься от случайной или злонамеренной порчи. Жизненный цикл позволяет автоматически перемещать данные в менее дорогие классы хранения или удалять их спустя заданные сроки.
Архитектурные подходы к хранению данных в облаке
- Мультиоблачность и S3-совместимые уровни. Архитектура, позволяющая хранить данные в нескольких облаках, либо в гибридах локального и облачного хранилища. Важны согласованность политики, каталогизация и управление доступом.
- Локальные преферены и кэширование. Для снижения задержек можно применять кэширование на периферии (edge) или у клиентов, а также локальные копии важных наборов данных.
- Data lake vs Data warehouse. Data lake — это хранилище для неструктурированных/полуструктурированных данных, а Data warehouse — оптимизированное под SQL-аналитику хранение структурированных данных. Часто строят лейеры: ingestion layer (raw), processing layer (curated), presentation layer (BI-ready).
- Резервирование и DR. Резервное копирование, георепликация между регионами, автоматическое восстановление после сбоев. Важно определить RPO (временной промежуток между резервными копиями) и RTO (время восстановления после сбоя).
Роли и ответственность: управляемость и безопасность
- Роль заказчика. Определение политики доступа, классификация данных, требования к защите, данные резидентности и правила хранения.
- Роль операционного отдела. Мониторинг использования, конфигурации безопасности, настройка резервного копирования и восстановления, аудит.
- Роль DevOps/Cloud Engineering. Автоматизация развёртываний, создание пайплайнов миграций, управление версиями, контроль изменений и согласование политик.
- Роль аудита и комплаенса. Контроль за доступами, хранение логов, поддержка требуемых регламентов.
Практические примеры
Пример 1. Перенос набора больших файлов в облачное объектное хранилище с использованием MinIO и Rclone
- Контекст. Компания имеет локальный NAS с данными проектов и хочет переместить архивы в облако для долговременного хранения, сохранив доступ через S3-совместимый API.
- Решение. Развернуть локальный MinIO в тестовой среде как S3-совместимый шлюз. Настроить Rclone как инструмент переноса: rclone config создаёт удалённое подключение к облачному бакету (например, Яндекс Облако Object Storage или другой S3-совместимый сервис). Затем выполнить копирование: rclone sync /path/to/local/data remote:bucket-name —progress.
- Роли и шаги. 1) Оценить наборы данных (объем, размер объектов, частоту изменений). 2) Соглашение о именовании и метаданных. 3) Включить версионирование и политику жизненного цикла для активной миграции. 4) Тестировать целостность файлов через контрольные суммы. 5) Настроить мониторинг и алертинг на ошибки передачи. 6) После проверки — отключить запись на исходном NAS или перенести в архив.
- Технические детали. Можно использовать S3-совместимый endpoint, например, у выбранного провайдера. В случае Яндекс.Облака Object Storage это возможно через соответствующий URL и ключи доступа. Пример утилиты rclone поддерживает параллельную передачу, копирование и синхронизацию больших наборов данных. Для ускорения можно использовать мультипоточность и пакетную передачу крупных объектов.
Пример 2. Развёртывание частного облачного хранилища на базе Ceph RGW (RADOS Gateway) с S3 API
- Контекст. Организация демонстрирует частное облако по требованию локализации данных и контроля над инфраструктурой.
- Решение. Развернуть кластер Ceph с RGW (Object Gateway). Это позволяет иметь S3-подобный интерфейс в рамках частного облака, с теми же API, что и в облаке публичном.
- Архитектура. Узлы Ceph MON/OSD, RGW на отдельном узле или контейнере; клиентские приложения получают доступ через S3 API. Рекомендовано применить репликацию между узлами и настройку политик хранения (например, EC для распределения данных по нескольким дискам).
- Технические детали. Конфигурация CRUSH-алгоритма, настройка bucket-уровней и политики: версионирование, жизненный цикл, доступ по лицензиям. Можно настроить HTTPS и TLS для передачи. В целях безопасности — интеграция с внешними системами IAM, например через S3 совместимый маппинг ролей.
- Практическое применение. Это решение полезно для тестовых окружений, исследований и частных实现, где требуется полный контроль над данными, включая безопасность и соответствие.
Пример 3. Использование Яндекс Облака Object Storage для проекта аналитики
- Контекст. Команда выбирает облачное хранилище в рамках экосистемы Яндекс.Облако для хранения больших массивов данных, с доступом через S3-совместимый API.
- Решение. Создать бакет в Яндекс.Object Storage, включить версионирование и задать политику хранения. Можно задать жизненный цикл (перемещение в холодные классы хранения или удаление) и включить кросс-регионную репликацию, если нужно.
- API и доступ. Яндекс.Облако поддерживает REST API и S3-совместимый интерфейс, что позволяет использовать привычные инструменты (AWS CLI, S3-подобные клиенты) и открытое ПО. Пример использования: aws configure — регион: ru-central1, access_key и secret_key, endpoint_url: https://s3.yandexcloud.net. Загрузка файлов выполняется через aws s3 cp или s3api.
- Применение. Лог-данные, архивы, сырые данные из источников, которые периодически обрабатываются аналитическими пайплайнами. Возможна интеграция с Data Processing сервисами Яндекс.Облако и внешними инструментами.
Пример 4. Локальное кэширование и обработка через Kubernetes с использованием Ceph через rook
- Контекст. Требуется поддержка динамических PVC для приложений в кластере Kubernetes и согласованности доступа к данным.
- Решение. Установить rook-ceph в Kubernetes, чтобы обеспечить объектное/ файловое блочное хранилище внутри кластера. Это позволяет динамически выделять тома под поды и монтировать файловые системы CephFS или блочные RBD-диски.
- Практическая польза. Ускорение миграций, упрощение пайплайнов для ETL и BI-инструментов, централизованное управление данными и доступом внутри контейнеризованных приложений.
API и доступ к данным
- Объектное хранение. Большинство провайдеров поддерживают S3-совместимый API, что обеспечивает единый интерфейс для загрузки и выгрузки данных, метаданных и управления версиями объектов. Применение S3-совместимого API упрощает интеграцию с инструментами open-source и позволяет легко переносить данные между облаками.
- File и block storage. Файловые хранилища подразумевают сетевые протоколы (NFS/SMB) и позволяют POSIX-совместимый доступ. Блочное хранение предоставляется как виртуальный диск, монтируемый на виртуальные машины.
- Безопасность. Шифрование в покое и в транзите. Управление ключами: KMS/CMK; политика доступа с использованием IAM/ACL; аудит доступов и событий. В большинстве облаков доступ к данным регулируется через роли и политики, привязанные к аккаунтам, сервисам и конкретным ресурсам.
Жизненный цикл и защита данных
- Версионирование объектов. Позволяет восстанавливать предыдущие версии объектов и защищает от непреднамеренной порчи.
- Политики жизненного цикла. Автоматически перемещают данные между классами хранения (hot → warm → cold) и удаляют данные по сроку хранения.
- Резервирование и DR. Георепликация между регионами, многократные копии на разных географических локациях. Важно определить RPO и RTO, а также тестировать сценарии восстановления.
Безопасность и соответствие
- Механизмы аутентификации. Использование ключей доступа (Access Key/Secret Key) или интеграция через IAM-роли, сервисные аккаунты, временные креды (STS).
- Шифрование. SSE (Server-Side Encryption) в покое; SSE-KMS для управления ключами и аудита. TLS/HTTPS для передачи данных.
- Контроль доступа. Политики桶, ACL, роли, ограничения по IP-адресам, VPC endpoints. Важно избегать открытых и общедоступных бакетов без надлежащих ограничений.
Производительность и миграции
- Архитектура доступа. Важно распланировать параллелизм и батчи загрузки; выбор между прямым доступом и кэшированием; использование CDN/edge кэшей там, где требуется низкая задержка.
- Миграционные подходы. ETL/ELT-подходы, параллельная загрузка и верификация целостности данных; использование инструментария для миграции и интеграции данных: ETL-решения (Apache NiFi, Airflow), инструменты копирования (Rclone, AWS CLI, s3cmd), конвейеры обработки (Spark, Hadoop) для обработки больших данных перед загрузкой в хранилище.
Риски и ограничения
1. Задержки и стоимость передачи данных
- Внешние сети и egress-издержки влияют на общую стоимость миграции и эксплуатацию. Перемещение больших объемов данных между регионами или между локальным центром и облаком может стать значительным расходом.
- Задержка доступа к данным в облаке может быть чувствительна для приложений реального времени. Решения: кэширование, размещение рабочих наборов в ближайшей зоне, выбор близких регионов, приватные конечные точки.
2. Риск привязки к поставщику (vendor lock-in)
- Объектные хранилища и их API могут различаться между провайдерами, даже если они поддерживают S3-совместимый интерфейс. Стоит тщательно продумывать стратегию миграции и использования стандартов, чтобы снизить зависимости от конкретного провайдера.
- Выбор гибридной архитектуры и мультиоблачности может снизить риск, однако повышает сложность эксплуатации.
3. Безопасность и соответствие
- Неправильная настройка политик доступа, открытые бакеты, слабые ключи доступа могут привести к утечке данных.
- Законодательство и требования к локализации данных (регуляции, GDPR, локальные требования к хранению) требуют управлять резидентностью и аудитами.
4. Управление данными и качеством данных
- Миграционные проекты сталкиваются с проблемами консистентности и согласованности метаданных. Нужно уделять внимание согласованию форматов, схем, типов данных и документов об источниках.
- Архивирование и обработка в больших данных могут приводить к задержкам при доступе к данным и необходимости поддержания дополнительных систем.
5. Операционная сложность
- Эксплуатация гибридной инфраструктуры требует знаний по дополнительным инструментам, мониторингу, управлению секретами и обновлениями. Необходимо обеспечить обучение сотрудников и наличие процессов по управлению изменениями.
Модели хранения и доступ к данным в облаке представляют собой набор взаимосвязанных архитектурных решений, которые позволяют организовать эффективное, безопасное и масштабируемое хранение больших массивов данных. Облачные хранилища дают мощные возможности: масштабируемость, высокую долговечность, разные уровни хранения и гибкие механизмы доступа через API. При выборе модели важно ориентироваться на требования бизнеса: размер данных, частоту доступа, требования по задержке, безопасность, соответствие и стоимость. Важны также подходы к миграции: планирование переноса, выбор инструментов (open-source и коммерческих), проверка целостности и обеспечение непрерывности операций.
Вопрос–Ответ (FAQ)
1) Что такое объектное хранение и чем оно отличается от файлового и блочного хранения?
Объектное хранение хранит данные как объекты, с уникальным идентификатором и связанными метаданными, без традиционной файловой структуры. Это обеспечивает масштабируемость и простоту хранения больших массивов данных. Файловое хранение ориентировано на доступ к данным через файловые протоколы (NFS/SMB) и POSIX-совместимый доступ. Блочное хранение представляет данные как дисковые блоки, которые монтируются как устройства. Выбор зависит от сценария: объекты — для больших неструктурированных наборов, файлы — для совместной работы и общего доступа, блоки — для систем баз данных и ОС.
2) Какие преимущества даёт S3-совместимый API?
Он обеспечивает единый и широчайший набор инструментов для работы с данными, поддерживаемый множеством облачных провайдеров и open-source инструментов. Это упрощает миграции между провайдерами и интеграцию с пайплайнами обработки данных. Кроме того, многие инструменты и библиотеки уже адаптированы под этот API.
3) Какие риски чаще всего возникают при миграции данных в облако?
Основные риски: задержки и затраты на передачу данных, риск привязки к одному поставщику, риск неправильной конфигурации доступа (утечки, случайное публичное размещение данных), сложности с соответствием и локализацией данных, проблемы с качеством данных и миграционными метаданными, операционная сложность.
4) Как организовать безопасность доступа к данным в облачном хранилище?
Важно использовать принципы наименьших прав, роли и политики доступа, шифрование в покое и в транзите, управление ключами (KMS), аудит и журналы доступа. Не допускать открытых бакетов, использовать приватные конечные точки и ограничение по IP/сетевым политикам. Регулярно проводить аудиты конфигураций.
5) Какие практические инструменты можно использовать для миграции в облако?
MinIO и Ceph RGW для локального и частного облака, Rclone и s3cmd для передачи данных в облако, AWS CLI (или аналогичные клиенты) с S3-совместимым эндпойнтом, CI/CD пайплайны и инструменты оркестрации (Airflow, Apache NiFi) для ETL-процессов. В качестве примера можно развернуть Ceph RGW как экспериментальную инфраструктуру и проверить миграции через Rclone.
6) Как выбрать подходящий уровень хранения в облаке и когда переходить в холодные классы?
Разумно начинать с уровня хранения, который соответствует реальной частоте доступа к данным. Для больших архивов и устаревших данных, доступ к которым нужен редко, целесообразно переходить в холодные классы (Nearline/Coldline/Archive) с автоматическими правилами жизненного цикла, чтобы снизить стоимость хранения. Важно учитывать время, необходимое на восстановление и стоимость доступа к данным.
7) Что учитывать в планировании миграции в облако?
Оценивать размер данных, частоту доступа, форматы файлов, требования к метаданным и совместимости, формировать дорожную карту миграции (поэтапно, с тестированием), учитывать требования к доступности и DR, планировать тестирование целостности, определить ответственных и сроки, а также предусмотреть резервирование и эксплуатацию в режиме эксплуатации после переноса.
8) Какие российские решения и примеры можно упомянуть как варианты реализации?
Яндекс.Облако Object Storage с S3-совместимым API. Это позволяет использовать привычные инструменты и интегрироваться в экосистему российского провайдера. Кроме того, открытые решения вроде Ceph (и его RGW) широко применяются в российских дата-центрах и частных облаках. Для локальных разработок можно применять MinIO как легковесный S3-совместимый шлюз и тестировать миграции без доступа к внешнему интернету.
9) Чем отличается Data Lake от Data Warehouse и как хранение в облаке помогает этим концепциям?
Data Lake предназначен для хранения больших объемов неструктурированных и полуструктурированных данных в их исходной форме. Data Warehouse оптимизирован для аналитики и запросов к структурированным данным, часто с предопределённой схемой. В облаке можно строить гибридные архитектуры: данные сначала попадают в Data Lake в объектном хранилище, затем после обработки загружаются в Data Warehouse или аналитические хранилища, чтобы ускорить бизнес-аналитику.
10) Какие лучшие практики можно вынести из этой главы в повседневную работу?
Планирование миграции с учетом требований к доступности, безопасности и стоимости; использование S3-совместимого API для унификации инструментов; внедрение версионирования и политик жизненного цикла; настройка шифрования и управления ключами; мониторинг и аудит; тестирование восстановления после сбоя; документирование метаданных и процессов миграции; выбор гибридной или мультиоблачной стратегии в зависимости от бизнес‑целей.


