

Введение: цели и ценность Data Catalog
Данные стали активом номер один для современной компании. Однако их ценность появляется лишь тогда, когда данные можно найти, понять, доверять им и безопасно использовать. Именно для этого существует каталог данных — системный инструмент управления метаданными, который объединяет технические характеристики источников данных, бизнес-термины, владельцев и правила доступа, а также прослеживаемость перемещений данных от источника к потребителю. Цель настоящей главы — представить новое сотруднику полное и понятное введение в концепцию Data Catalog, объяснить его ценность для бизнеса, описать теоретические основы и практические подходы к внедрению в компании, рассмотреть примеры и технические детали, а также разобрать риски и ограничения проекта.
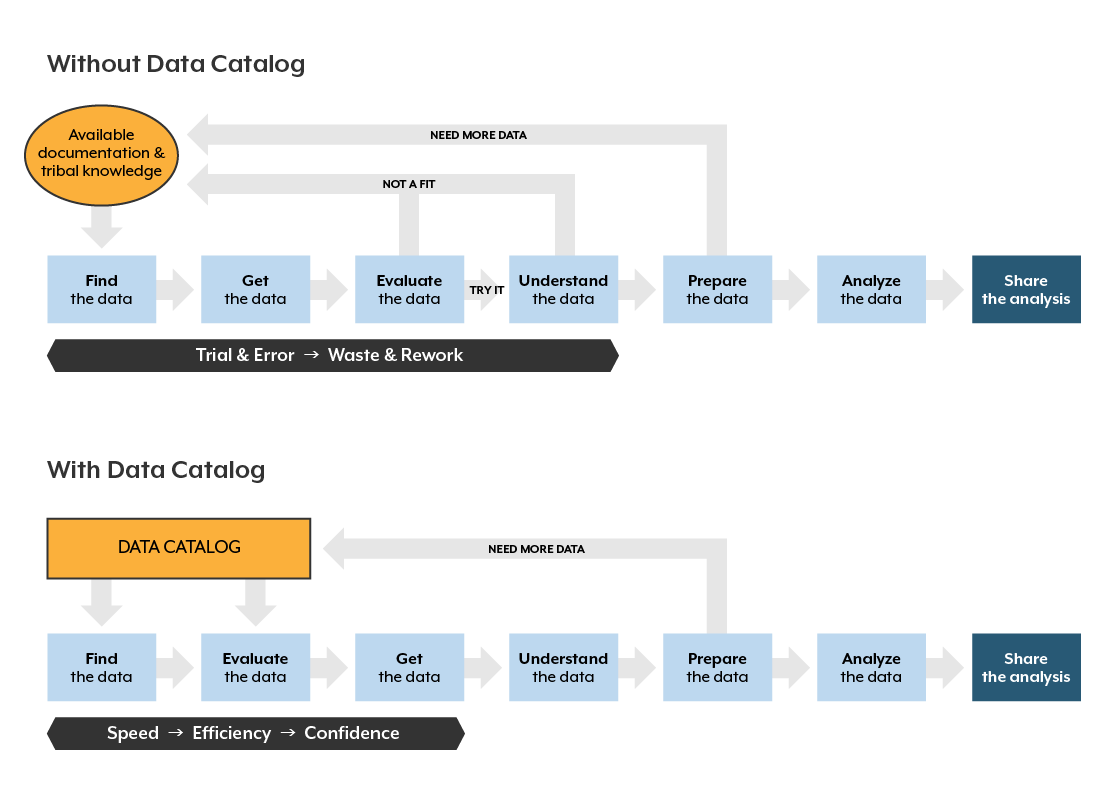
Что такое каталог данных и какие задачи он решает
- Определение. Каталог данных — это централизованный репозиторий метаданных и связанных артефактов (описания данных, схемы, линейности, версии, владельцы, политики доступа, теги и бизнес-терминология), которые позволяют находить, понимать, использовать и управлять данными в организации.
- Основные функции: поиск и обнаружение активов данных; описание и категоризация (глоссарий и бизнес-терминология); управление качеством данных; прослеживаемость (data lineage); управление доступом и соответствие требованиям; сотрудничество между специалистами и бизнес-пользователями (data stewards, аналитики, инженеры данных, бизнес-аналитики).
- Пользователи и роли. В каталоге участвуют разные роли: владельцы данных (data owners), хранители/опекунов данных (data stewards), инженеры данных, аналитики, бизнес-читатели и регуляторы. Хорошо настроенная рольовая модель снижает риск неправильного применения данных и повышает доверие к ним.
- Связь с управлением метаданными (metadata management) и управлением данными. Каталог данных — часть большего контекста управления данными, который включает политику доступа, качество данных, классификацию по чувствительности, жизненный цикл данных и регуляторные требования. Каталог не заменяет источники данных и их инфраструктуру, но облегчает взаимодействие с ними и координацию действий участников.
- Связь с данными как продуктом и концепцией data mesh. В условиях распределённых команд и множества источников данных каталоги помогают создать единое представление о данных как продукте, где каждый набор данных имеет владельца, цели использования, требования к качеству и способы оценки удовлетворения потребностей потребителей.
Ключевые термины и концепции
- Метаданные. Любая информация о данных: структура, формат, происхождение, владелец, частота обновления, права доступа, качество, пример значения и т. д.
- Линейность данных (data lineage). Визуализация пути данных от источника до потребителя, включая все трансформации и промежуточные этапы.
- Глоссарий и бизнес-термины. Совместные определения понятий, чтобы бизнес-пользователи и ИТ говорили на одном языке и понимали риск несоответствий.
- Метаданные управления качеством. Правила и данные, используемые для оценки качества, контрольные показатели (погрешности, полнота, корректность, консистентность).
- Метаданные о доступности и безопасности. Правила доступа, политики защиты данных, классификация чувствительности, соответствие требованиям и аудит.
- Интеграция источников и грануляция. Каталог поддерживает разрезы по источникам (базы данных, дата-лейеры, хранилища, потоки данных) и по уровням детализации (сущности, поля, примеры значений).
Методологии и подходы к внедрению
- DCAM и DAMA-DMBOK. Это отраслевые ориентиры: DCAM описывает архитектуру и управляемые процессы каталога и метаданных; DAMA-DMBOK задаёт рамки управления данными, включая метаданные, качество, риски и роли.
- Data governance как процесс. Каталог поддерживает данные реестры, политики доступа, требования соблюдения и эскалацию вопросов качества через роли управления.
- Начальная пилотная программа. Рекомендуется начать с малого, выбрать ограниченный набор источников критичных данных, определить владельцев и метаданные, которые жизненно необходимы бизнесу, и постепенно наращивать охват.
- Федеративная и централизованная архитектуры. В федеративной модели данные остаются в источниках, а каталог агрегирует метаданные и предоставляет единый поиск. В централизованной модели часть данных и метаданных хранится внутри каталога. Удобно комбинировать эти подходы: центральная концепция и локальные источники метаданных с интенсифицированной синхронизацией.
- Этапы внедрения: сбор требований бизнеса, выбор стека инструментов, согласование модели метаданных, настройка пайплайна загрузки и синхронизации, внедрение политики доступа, обучение пользователей и настройка KPI.
Практические примеры
Open-source решения и как они работают на практике
- Amundsen. Открытая платформа каталога данных, разработанная в рамках экосистемы Lyft. Основные компоненты: движок хранения метаданных, индексная база (ElasticSearch), графовая база данных для линейности и зависимостей (Neo4j или аналогичная), веб-интерфейс и сервисы API. В типичном сценарии Amundsen собирает метаданные из источников (PostgreSQL, Hive, Spark, S3, Snowflake и др.), конвертирует их в единый формат, создаёт бизнес-термины, назначает владельцев, политику доступа и линейность. Пример пайплайна: источник данных → консьюмер/инджестер → метаданны и линейности → индексация → поиск. Практическая adaptation: вы создаёте конфигурацию аннотаций и маппинг полей, настраиваете сборщики (harvesters) и интегрируете в интерфейс через REST или GraphQL API. Пример метаданных: DataAsset: orders; DataSource: postgres_sales; Fields: order_id, customer_id, amount; Owner: data_analytics_team; Tags: pii, sensitive; Lineage:/orders->staging.orders_stage->warehouse.sales. Такой подход улучшает поиск и позволяет аналитикам быстро находить релевантные наборы данных и понимать, как они трансформируются.
- DataHub. Ещё одна популярная открытая платформа, созданная с упором на масштабируемость и интеграцию с большим числом источников. DataHub поддерживает концепцию “data assets” и “sub-entities”, включая схемы, поля, теги и линейность. Интеграционные коннекторы позволяют подключать источники как облачные, так и локальные, а также обеспечивают версионирование метаданных. В реальной практике DataHub может использоваться для каталогизации как структурированных данных в хранилищах, так и полуструктурированных файлов в объектных хранилищах.
- OpenMetadata. Современная платформа с открытым исходным кодом, позволяющая агрегировать метаданные, обеспечивать поиск, линейность и глоссарий. Архитектура строится вокруг сервиса управления метаданными и коннекторов к источникам, с упором на расширяемость и работоспособность в облаке. Применимо к крупным экосистемам, где важно поддерживать единый контекст данных в разных командах.
Российские решения и локализация
Потребность рынка России. В России рынок решений для каталогов данных часто ориентирован на локализацию, соответствие регулятивным требованиям, интеграцию с локальными системами контроля доступа, сертификацию ФСТЭК/ФСБ и требованиям по защите данных. Многие организации прибегают к проприетарным решениям от российских поставщиков или к локализованным версиям международных платформ с дополнительной поддержкой.
Особенности внедрения в российской среде. В рамках российских проектов акцент делается на:
- локализация метаданных и терминологии под русский язык и бизнес-контекст.
- интеграции с LDAP/AD для управления доступом и аудита.
- соответствие требованиям по защите персональных данных (152-ФЗ) и регулятивной документации.
- совместимость с отечественными решениеями по криптографии и сертификации, в том числе с применением средств криптографической защиты информации (СКЗИ).
Практическая постановка задачи с российскими решениями. В типичном примере крупной финансовой организации могут применяться проприетарные решения, адаптированные под RU-правовую среду, с модульной архитектурой, включающей:
- модуль каталогирования метаданных и глоссария на русском языке;
- модуль управления доступом с учётом соответствия регулятивным требованиям;
- интеграцию с внутренними системами управления идентификацией и аудитом;
- возможность сертифицированной защиты данных на уровне интерфейсов и хранения метаданных.
Важно помнить, что российские решения часто требуют более длительной стадии внедрения, но в этом и заключается их польза: глубокая локализация, соответствие регулятивным требованиям и лучшее взаимодействие с локальной инфраструктурой.
Практические примеры внедрения и сценарии использования
- Пример 1: пилот в банке. Выделяем критичные источники данных: базу клиентов, витрины продаж, логи транзакций. В рамках пилота настраиваем Amundsen DataHub-образную конфигурацию: подключаем PostgreSQL и Hadoop/HDFS, создаём бизнес-глоссарий и владельцев, описываем линейность от исходной таблицы до отчетных витрин. Итог: ускорение поиска данных, повышение доверия к данным, снижение количества повторных запросов к ИТ-подразделению на тему источников и трансформаций. Время на внедрение пилота — 6–8 недель, затем масштабирование на дополнительные источники и новые бизнес-подразделения.
- Пример 2: госхолдинг и интеграция с локальными системами. В рамках задачи по управлению персональными данными и регулятивной политикой мы применяем локализованный проприетарный продукт каталога с поддержкой RU-ориентированной политики доступа и сертификаций. Каталог интегрируется с внутренним LDAP/AD и системами аудита, обеспечивает маркировку данных по уровням чувствительности и соответствие требованиям обработки данных. В качестве практики может быть реализован глоссарий бизнес-терминов на русском языке и карта линейности, показывающая траекторию чувствительных данных от источника до потребителя.
- Пример 3: унифицированный стек с открытым исходным кодом и локальной адаптацией. Компании в розничной торговле могут сочетать Amundsen/DataHub с локальными адаптациями и интеграцией с российскими решениями по хранению логов и аудитам. В этом сценарии бизнес-термины (например, "клиент", "заказ", "товар") фиксируются в глоссарии, а политики доступа и аудит ведутся через локальные сервисы. Каталог обеспечивает быструю навигацию по данным и прозрачность цепочек происхождения данных, что особенно ценно для аналитиков и финансовой дисциплины.
Модель данных и архитектура
Основные сущности: DataAsset (набор данных), DataSource (источник данных), Field (поле), GlossaryTerm (термин), Owner/Steward, Tag, DataQualityRule, DataLineage (линейность), Documentation, AccessPolicy.
Архитектура. Часто применяется микросервисная архитектура с разделением на:
- Ingestion/Harvesting сервисы — извлекают метаданные из источников и приводят их к унифицированной схеме.
- Метаданные хранилище — база данных для метаданных (рядом с графовой базой для линейности).
- Поисковый компонент — индексирование и полнотекстовый поиск.
- API и фронтенд — доступ к данным каталогам, управление и просмотр.
- Сервисы политики доступа и аудита — управление правами и журналами.
Стратегия хранения. Метаданные хранятся в специализированной базе данных (реляционной или графовой) и индексируются в полнотекстовом поисковике для быстрого поиска. Линейность обычно моделируется через графовую структуру, что позволяет визуализировать зависимости между источниками, трансформациями и потребителями.
Подключение источников и сбор метаданных
- Коннекторы и гиды. В качестве источников могут выступать базы данных (PostgreSQL, MySQL, Oracle, SQL Server), хранилища данных (Hive/Impala, Snowflake, Redshift), файловые системы (HDFS, S3, GCS), системы BI и отчётности. Встраиваются коннекторы, которые извлекают схемы, структуры полей, комментарии, владельцев, а также транслируют данные об обновлениях.
- Инструменты сбора. Существуют готовые harvesters, которые периодически синхронизируют метаданные, а также механизмы инжекции ручного описания и автоматической генерации. Плюс к этому — возможность импортировать существующие бизнес-термины и правила качества.
- Примеры конфигураций. В Amundsen конфигурация включает источники, которые должны быть обнаружены, путь к метаданным, правила маппинга и схема бизнес-терминов. В DataHub — аналогично, с поддержкой расширяемых полей и которые позволяют строить линейность и карточки активов.
Безопасность и соответствие требованиям
- Управление доступом. В каталоге должны быть роли и политики, позволяющие ограничивать доступ к данным на основе уровня чувствительности и ролей. В RU-условиях это значит точная настройка прав на основе LDAP/AD и поддержка локальных регламентов по защите данных.
- Шифрование и аудит. Метаданные должны храниться с защитой доступа, а критичные части — с шифрованием. Вводится аудит действий пользователей и изменений в метаданных.
- Защита персональных данных (ПД). Каталог должен поддерживать маркировку данных как PII, а также протоколировать трансформации и доступ к таким данным для обеспечения соответствия требованиям закона.
Управление качеством данных и прозрачностью
- Контроль качества. Метаданные о качестве охватывают полноту, точность, консистентность и своевременность данных. В каталоге можно хранить показатели качества и прикреплять правила проверки к конкретным активам данных.
- Линейность и трассируемость. Возможность увидеть путь данных и трансформаций. Это критично для аудита, воспроизводимости аналитики и соответствия регулятивным требованиям.
- Глоссарий и термины. Наличие единого словаря бизнес-терминов снимает барьеры между бизнесом и ИТ и снижает риск двусмысленности в отчетности.
Метрики успеха и принципы эксплуатации
- KPI внедрения. Время от запроса до доступности данных в каталоге, доля критических источников, доля активов с описанием, доля активов с линейностью, скорость разрешения запросов пользователей, частота использования поиска.
- Эволюция каталога. Пошаговое расширение на новые источники, увеличение числа задач по описанию активов и рост числа зарегистрированных пользователей.
- Обучение и поддержка. Важно не просто внедрить инструмент, но и обучить бизнес-пользователей работать с ним, определить ответственных за обновления глоссария, и наладить процессы поддержки.
Риски и ограничения внедрения
Риски
- Недостаточная вовлечённость data owners и stewards. Без активного участия бизнеса каталог остаётся пустым или неполезным, что снижает окупаемость.
- Неполезность или устаревание метаданных. Метаданные требуют регулярного обновления; без процессов курации они быстро устаревают.
- Внедрение часто сопровождается сложной интеграцией источников и техническими ограничениями. Не все источники легко поддаются автоматическому извлечению метаданных.
- Вопрос адаптации к регулятивным требованиям. Неправильная маркировка данных или недокументированные политики доступа могут привести к нарушениям закона.
- Стоимость владения и риск vendor lock-in. Коммерческие решения могут требовать долгосрочных контрактов и сложной миграции при смене поставщика.
Ограничения
- Каталог — не источник данных. Он описывает и координирует данные, но не заменяет источники и инфраструктуру. Важно помнить, что качественный каталог требует активной курации и интеграции с реальными источниками данных.
- Зависимость от качества исходной документации и инфраструктуры. Без достаточного описания полей, трансформаций и контекста многие активы будут менее полезны.
- Локализация и регуляторика. В российских условиях требования к защите данных и локализации требуют дополнительной настройки и сертификации, что может удлинить цикл проекта.
- Поддержка масштаба. При росте количества активов и источников может потребоваться переработка архитектуры, перераспределение ресурсов и оптимизация процессов.
Советы по снижению рисков
- Запуск пилота на ограниченном наборе критических источников с чётко определёнными владельцами и целями.
- Определение минимального набора метаданных и линейности для первых активов, чтобы получить быстрый выигрыш и доказать ценность.
- Вовлечение бизнес-пользователей в создание глоссария и описаний активов для укрепления доверия к каталогу.
- Постепенная интеграция источников с учётом регулятивных требований и политики безопасности.
- Регулярная проверка актуальности метаданных и настройка процессов курации.
Выводы
Кратко о ценности Data Catalog для компании:
- Улучшение поиска и понимания данных за счет единого репозитория метаданных, глоссария и линейности.
- Повышение доверия к данным и ускорение аналитических процессов: пользователи тратят меньше времени на поиск данных и больше на анализ.
- Улучшение управляемости данными: роли, политики доступа и аудит позволяют соблюдать регулятивные требования и снижать риски.
- Поддержка бизнеса и регуляторики: единая платформа для документирования бизнес-терминов, прозрачности источников и аудита данных.
- Гибкость к изменениям: интеграция с различными источниками и возможность расширения функциональности по мере роста организации.
В завершение материала полезно помнить: каталог данных — это инструмент трансформации культуры работы с данными. Он требует участия людей, процессов и технологий. Сам по себе инструмент не решит все задачи: важны роль владельцев данных, качество описаний, регулярная актуализация и ясные политики доступа. Но с правильно спроектированным и внедрённым каталогом данные начинают работать эффективнее, становятся доступными и понятными для широкого круга сотрудников, а бизнес получает возможность принимать решения на основе достоверной информации.
Вопрос–Ответ (FAQ)
1) Что именно даёт каталог данных бизнесу?
Каталог обеспечивает быстрый поиск и понимание доступных данных, единый бизнес-глоссарий и термины, прозрачность источников и трансформаций, контроль доступа и аудита. В результате аналитики и бизнес-подразделения получают больше уверенности в данных, уменьшают задержки на поиск и повышают качество решений.
2) Чем отличается открытое решение от российского коммерческого? Как выбрать?
Open-source решения дают большую гибкость, прозрачность и возможность адаптации под конкретную инфраструктуру, но требуют ресурсов на настройку, поддержку и интеграцию. Российские коммерческие решения чаще предлагают готовые интеграции с локальной инфраструктурой, сертифицированные механизмы защиты и поддержку в рамках регуляторной среды. Выбор зависит от стратегических целей: скорость внедрения, требования к локализации, бюджет, регуляторика и готовность вкладываться в собственную команду администраторов.
3) Какие источники данных чаще всего интегрируются в каталоги?
Чаще всего интегрируются реляционные базы данных (PostgreSQL, MySQL, Oracle, SQL Server), облачные хранилища (S3, GCS, Azure Blob), хранилища данных и обработчики (Hive, Snowflake, Redshift), файловые системы и источники BI-инструментов. Важно начать с тех источников, которые критичны для бизнеса и чья регуляторная нагрузка наиболее высока.
4) Каковы главные риски внедрения и как их минимизировать?
Главные риски — отсутствие вовлечённых владельцев, устаревшие метаданные, затруднённая интеграция источников, регуляторные проблемы и высокий TCO. Их минимизируют через пилот, раннюю вовлечённость бизнеса, чёткую модель владения активами, автоматизированные пайплайны сбора и курацию, а также обучение пользователей и поддержание жизненного цикла метаданных.
5) Какой цикл внедрения наиболее эффективен?
Ремарка: начать с пилота на 2–3 критичных источниках и ограниченного набора активов, определить владельцев и метаданные, внедрить базовый набор функций (поиск, глоссарий, линейность), затем постепенно расширяться на новые источники и функции. Обычно пилот занимает 1–3 месяца, затем следует этап масштабирования на 6–12 месяцев в зависимости от объёма данных и организационной готовности.
6) Что означают KPI для каталога и как их измерять?
KPI могут включать время до first usable asset в каталоге, долю активов с заполненными описаниями и линейностью, частоту использования поиска, долю пользователей, удовлетворённых результатами поиска, показатель соответствия регуляторным требованиям и экономическую окупаемость (снижение времени на подготовку данных, сокращение повторных запросов к ИТ). Важно устанавливать измеримые цели на этапе планирования и регулярно пересматривать их.
7) Как каталог помогает управлять качеством данных?
Каталог позволяет сохранять метрики качества, связанные с конкретными активами, регистрировать правила проверки, отслеживать статус качества и вместе с инструментами профилирования данных помогать аналитикам выявлять проблемные участки. Он делает явной ответственность за качество и упрощает совместную работу между командами, отвечающими за данные и их использование.
8) Какие критерии помогут выбрать между централизованной и федеративной архитектурой каталога?
Централизованная архитектура удобна в малых и средних организациях с ограниченным количеством источников и потребителей — она даёт единое место хранения и упрощает администрирование. Федеративная архитектура предпочтительна при большом количестве источников, распределённой организации и необходимости сохранения автономии источников; она позволяет держать данные как есть, но агрегирует метаданные в центральном каталоге для поиска и управления.
9) Как подготовиться к внедрению с точки зрения регуляторики и безопасности?
Необходимо определить требования локализации и защиты данных, рольовую модель и политики доступа, план аудита и журналирования, разработать классификацию данных (типы чувствительности), подготовить процедуры курации метаданных и обеспечить соответствие требованиям 152-ФЗ и другим регулятивным актам. Важно, чтобы решения каталога поддерживали сертификацию и интеграцию с криптографическими средствами защиты и системами контроля доступа.
10) Какие шаги полезно сделать в первые 90 дней после запуска каталога?
- Определить набор критичных источников и владельцев.
- Заполнить базовый глоссарий и описание для нескольких активов.
- Настроить базовую линейность для этих активов.
- Включить ключевых пользователей в обучение и сбор обратной связи.
- Внедрить простой процесс курации и обновления метаданных.
- Оценить первые KPI и наметить план расширения.


