

Прослеживаемость данных
Прослеживаемость данных (data lineage) — это способность проследить путь данных от исходного источника до конечного потребителя, включая все трансформации, обработки и перемещения, которые данные переживают в течение жизненного цикла. В контексте внедрения Data Catalog в компании это один из ключевых компонентов: он позволяет ответить на вопросы: какие данные используются в конкретном отчёте или модели, откуда они пришли, какие операции повлияли на них, кто имеет право на доступ, и как данные изменялись со временем. Для нового сотрудника важно не только понять технологическую сторону вопроса, но и увидеть как прослеживаемость данных поддерживает бизнес-процессы: соблюдение регуляторных требований, управление рисками, обеспечение качества данных и ускорение аналитической работы.
Данная глава посвящена полноте теории прослеживаемости данных, методикам её сбора и использования, практическим примерам внедрения на примерах открытых и отечественных решений, а также техническим деталям реализации и рискам, с которыми приходится сталкиваться в реальных проектах. Мы рассмотрим, как связать прослеживаемость с архитектурой каталога, как моделировать lineage в рамках метаданных и как организовать работу по прослеживаемости в рамках команды по управлению данными и бизнес-аналитиками.
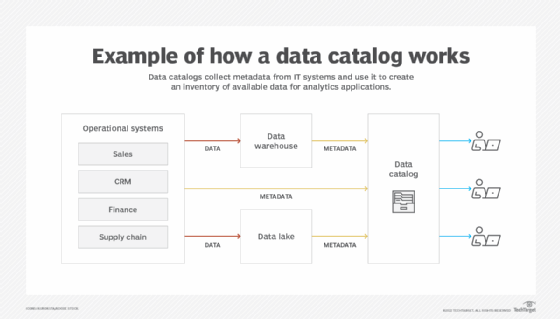
Определения и базовые понятия
- Прослеживаемость данных (data lineage) — совокупность информации о путях данных, источниках, преобразованиях и местах сохранения данных на протяжении всего жизненного цикла. В идеале она формализуется как граф: узлы — это активы данных (таблицы, файлы, наборы данных, поля), транзакции и процессы — преобразования; дуги — зависимости и направление потока.
- Источник (source) и потребитель (consumer) данных — источник это место или система, где данные созданы или впервые записаны; потребитель — система или пользователь, который читает или использует данные.
- Трансформация (transformation) — операция или серия операций, которые изменяют данные: агрегации, обогащение, фильтрации, расчеты, объединения.
- Физическая прослеживаемость (physical lineage) — путь данных через конкретные хранители и носители: файл, таблица, файл на HDFS, объект в облаке и т. п.
- Логическая прослеживаемость (logical lineage) — как данные проходят через наборы процессов и трансформаций на уровне бизнес-логики, маппинга источников к целям, без привязки к конкретной физической реализации.
- Семантическая прослеживаемость — связь между данными и бизнес-терминами: например, «клиент_возраст» в BI-отчете соответствует полю age в таблице customers и к словарю бизнес-значений.
Типы прослеживаемости
- Полная прослеживаемость end-to-end — от исходного источника до финального потребителя через все стадии обработки. Этот тип наиболее требовательный к инфраструктуре и к качеству метаданных.
- Частичная или модульная прослеживаемость — охватывает часть цепочки, например, только траекторию данных в конкретном пайплайне или между двумя системами.
- Временная прослеживаемость — фиксация версий данных и изменений во времени: какие версии файлов, таблиц, моделей были задействованы в конкретном отчете или расчете.
- Контролируемая прослеживаемость — привязка lineage к политикам доступа, ответственностям и ответственным лицам (owners), что упрощает аудит и управление доступом.
Метаданные и модели данных
- Метаданные в контексте lineage — это данные о данных: структура источников, форматы, владельцы, политики доступа, чьи данные используются, какие transformations применяются, какие линейки зависимостей существуют.
- Модели метаданных для прослеживаемости обычно реализуют графовую структуру: узлы — активы данных и процессы, ребра — зависимости между ними.
- Важные сущности: DataAsset (актив данных), DataSet/DatasetColumn (набор данных и его поля), Transformation/Job (процесс обработки), Lineage (путь данных), Run/Version (конкретный прогон или версия набора данных), Owner/ Steward (ответственный), Policy/Classification (классификация чувствительности, правила доступа).
Методологии и подходы
- Интеграционная методология: собираем метаданные и lineage из всех источников через коннекторы и пулы инцидентов, объединяем в единый реестр. Подход хорошо работает в условиях большого числа источников и зелёной/серой зоны интеграций.
- Инструментальный подход (instrumentation-based): внедряем в источники и пайплайны механизмы автоматического извлечения lineage, например через хуки в ETL/ELT инструменте, плагины в Spark, NiFi, Airflow и т.д.
- Инструменты на основе событий (event-driven lineage): записываем события о создании/модификации данных и трансформациях в централизованный реестр. Часто применяется вместе с системами мониторинга и журналирования.
- Границы ответственности и роли: аналитики данных формируют бизнес-линию, инженеры по данным обеспечивают техническую инфраструктуру и сбор метаданных, субъекты по соответствию следят за соблюдением регуляторных требований.
- Стандарты и практики: DCAM (Data MANAGEMENT CONTROL STANDARDS) для организации метаданных и прослеживаемости, DAMA-DMBOK как руководство по данным, архитектура ориентирована на согласование терминологии, версионирования и управления изменениями. Нормативные требования в разных юрисдикциях (GDPR, 152-ФЗ, 242-ФЗ и т. п.) требуют, чтобы lineage помогал отвечать на вопросы: какие данные подлежат защите, кто имеет доступ, как данные используются в аналитике и отчетности.
Технические детали архитектуры прослеживаемости
- Архитектура в общих чертах: источники данных — сбор метаданных и линей — хранение в каталоге метаданных — обработка и визуализация lineage в UI каталога — поддержка поиска и аудита.
- Метаданные хранятся в метадат-стоpе (metadata store). В зависимости от решения он может быть relational (PostgreSQL, MySQL), графовым (Neo4j, JanusGraph) или полиграфовым, где графовые компоненты под капотом ускоряют пути lineage.
- Графовая модель позволяет быстро выполнять запросы типа: «покажи все источники, через которые прошла таблица X» или «покажи все трансформации, влияющие на поле Y».
- Коннекторы и интеграции: коннекторы к источникам данных (СУБД, хранилища данных, ETL/ELT инструменты, BI-платформы, дата-лупы, ML-пайплайны) обеспечивают автоматическую сборку lineage. В некоторых случаях применяют ручное документирование для участков, где автоматизация сложна или недоступна.
- Безопасность и управление доступом: хранение sensitive metadata и lineage требует контроля доступа, аудита изменений, шифрования в покое и при передаче, использования ролей и политик.
- API и интеграции: REST и/или GraphQL API для интеграции с внешними системами (BI, аналитическими инструментами, сервисами обработки данных). Поддержка веб-интерфейса для удобной навигации по lineage и метаданным.
- Производительность и масштабирование: при росте числа источников и глубины графа важно выбрать подходящий хранилище и конфигурацию кластера; инкрементные обновления и кэширование помогают держать задержку на уровне приемлемого времени отклика.
- Управление качеством данных и lineage: помимо записи пути, часто хранится информация о качестве данных на разных узлах: полнота, корректность, срок годности, соответствие бизнес-правилам.
DCAM и другие стандарты
- DCAM (Data Centered Architecture Management) — один из основных стандартов по управлению метаданными и прослеживаемостью. Он помогает унифицировать термины, модели и процессы.
- DAMA-DMBOK — руководство по управлению данными, содержащее принципы, роли и процессы управления данными, включая lineage как часть инфраструктуры данных.
- DCAP/ISO-метаданные — при необходимости можно связывать с международными стандартами, чтобы обеспечить совместимость и возможность экспорта данных между системами.
Практические примеры
Open-source решения
1) Apache Atlas
- Что это: открытое решение для управления метаданными и прослеживаемостью в рамках экосистемы Hadoop, поддерживает графовую модель lineage.
- Как работает: Atlas хранит типы данных (types) и объекты (entities). Lineage собирается посредством интеграций: Spark, Hive, Sqoop, NiFi и прочие коннекторы генерируют события, которые Atlas регистрирует и отображает в виде графа.
- Пример сценария внедрения: разворачиваем Atlas, подключаем Spark и Hive, включаем Atlas Hooks в Spark, настраиваем классы и типы для DataAsset, Transformation, Run. После этого запуск ETL-пайплайна автоматически фиксирует файлы и таблицы через линк к каждому шагу обработки.
- Преимущества: зрелость, интеграции с Hadoop-оркетермой, поддержка политик доступа, соответствие регуляторным требованиям, возможность настройки классификаций.
- Ограничения: требовательность к настройке и инфраструктуре, сложность расширения под небазовые источники, может потребоваться больше технических ресурсов на администрирование.
2) Amundsen
- Что это: открытая платформа от Lyft, ориентированная на поиск метаданных и визуализацию lineage через интеграции с различными источниками.
- Как работает: Amundsen имеет движок метаданных и сервисы поиска. Lineage собирается через интеграцию с пайплайнами и источниками (например, через metadata service и ingestion tooling). В качестве примера можно подключить Airflow, Spark и базы данных.
- Преимущества: современная архитектура, удобный UI, активное сообщество, хорошая поддержка индексации и быстрого поиска, возможность настройки плагинов.
- Ограничения: может потребоваться доп. настройка для полного покрытия всех источников, миграции и поддержки большого количества видов активов.
3) DataHub
- Что это: платформа открытого кода, ориентированная на управление данными, включая полноценную поддержку lineage.
- Как работает: DataHub предоставляет метаданные, к которым можно подключать источники данных и пайплайны, а также графовую модель линейности. Встроены коннекторы к различным инструментам и удобный UI.
- Преимущества: гибкость, широкие возможности интеграций, активное развитие, поддержка микроподходов к ингестации.
- Ограничения: зависимость от инфраструктуры и настройка требует компетенции в настройке сервисов.
4) OpenMetadata
- Что это: современная платформа для управления метаданными с акцентом на простоту интеграции, поддержка графового lineage и REST/GraphQL API.
- Как работает: интеграции с источниками и пайплайнами, ингеретинг событий, графовая модель lineage. UI позволяет просматривать lineage, смотреть зависимости и осуществлять поиск.
- Преимущества: модульность, простая интеграция с существующим стеком, ориентирован на практическое применение в организациях.
- Ограничения: может потребоваться настройка совместимости с конкретными версиями инструментов.
5) Apache NiFi и прочие инструменты для линейности
- NiFi имеет встроенные возможности коду и визуальные конвейеры, где можно отслеживать lineage на уровне потоков данных и формировать базовую карту прослеживаемости.
- Применим к сценариям, где важна потоковая обработка и контроль за данными на уровне передачи между системами.
Российские решения и практики
Важно подчеркнуть, что рынок отечественных решений часто строится на тех же фундаментальных подходах, что и зарубежные продукты: локальная инсталляция, хранение метаданной информации в локальных дата-центрах, соответствие требованиям российского законодательства и стандартам информационной безопасности. В рамках практики внедрения в российских компаниях встречаются два подхода:
1) Использование отечественных платформ каталога данных на базе открытых стандартов и отечественных инфраструктур
- Архитектура: локальный оркестратор метаданных, хранение в локальном реестре, интеграции с отечественными системами аутентификации, поддержка хранения метаданных и lineage в рамках российского дата-центра.
- Плюсы: соответствие локальным требованиям, контроль над данными, минимизация риска прохода за пределы территории.
- Типовые коннекторы: к отечественным ERP/CRM-системам (например, 1С) и к СУБД, к локальным хранилищам данных, таким как PostgreSQL, Oracle, MS SQL Server, а также к локальным BI-инструментам.
- Кейсы внедрения: сбор метаданных из источников, создание общих справочников бизнес-терминов, автоматическое извлечение линейности через коннекторы и ручные доработки, а также настройка политики доступа к данным.
2) Внедрение локального каталога данных в рамках крупных системных интеграторов и облачных партнерств
- Архитектура: каталог, адаптированный под реалии российского рынка, с интеграцией в локальные сервисы, системы аудита и отчётности, поддерживающий DCAM или аналогичные принципы.
- Плюсы: поддержка бизнес-процессов и регуляторных требований, готовые коннекторы к отечественным источникам и сервисам, поддержка локального специалистами.
- Важные аспекты: обеспечение безопасности, соответствие требованиям ФЗ о персональных данных, настройка доступа и аудитирования, защита информации в ходе миграций данных.
- Пример реализации: локальная система метаданных, соединение с источниками данных (1С, БД, файлы), хранение графового lineage в отечественном сервере, интеграция с внутренними BI-решениями.
Практические примеры внедрения
Типичный сценарий: компания имеет набор источников данных: PostgreSQL, Oracle, 1С, файловое хранилище, ETL-пайплайны на базе Airflow или аналогов. Необходимо понять, какие данные используются в конкретном отчетe, откуда они идут, и как они трансформируются.
Пример реализации с открытым ПО:
- Развертываем Apache Atlas (метаданные и базовая прослеживаемость).
- Включаем интеграцию Spark/Hive в Atlas через hooks, создаем типы DataAsset, Transformation и Lineage.
- Подключаем источники: Postgres, Oracle, файловый HDFS/облако; для каждого источника настраиваем сбор метаданных и событий.
- Настраиваем UI и политики доступа, проводим аудит соответствия бизнес-терминологии.
- Результат: пользователь может увидеть путь от таблицы в Postgres до BI-отчета и модель, и определить ответственных за данные.
Пример реализации с отечественными подходами:
- Развернуть локальный каталог на базе отечественных решений, адаптировать под локальные источники: 1С, ESB, локальные СУБД, корпоративная LDAP/AD.
- Интегрировать с внутренними системами учета и контроля доступа, обеспечить хранение метаданных внутри российского дата-центра.
- Внедрить базовую прослеживаемость: фиксирование источников, трансформаций и потребителей, создание графа зависимостей, настройка оповещений и аудит.
- Результат: локальный реестр метаданных, который отражает весь путь критически важных данных внутри организации и позволяет оперативно отвечать на вопросы бизнес-подразделений.
Архитектура и компоненты
- Источники данных: базы данных (PostgreSQL, Oracle, MSSQL), файловые хранилища (HDFS, S3, локальный NAS), ERP-системы (1С и т.д.), пайплайны ETL/ELT (Airflow, Dagster, NiFi), ML пайплайны.
- Ингестор метаданных: коннекторы, которые извлекают описание объектов и событий из источников и отправляют их в метадиданные хранилище.
- Метаданные и репозиторий lineage: база данных/графовая система, где хранится схема активов и граф зависимостей.
- Индекс и поиск: сервисы, обеспечивающие быстрый поиск по активам и их атрибутам.
- UI и визуализация: веб-интерфейсы для просмотра lineage, связанных активов и терминологии, панели аудита и управления доступом.
- API: REST/GraphQL API для интеграции с BI-инструментами, ER-платформами, и внутренними системами.
Модели метаданных и сущности
- DataAsset — актив данных: набор данных, таблица, файл, API, модель ML.
- DataSet/Field — набор данных и его поля; атрибуты поля включают имя, тип, описание, классификации.
- Transformation/Job — процесс обработки: какие шаги выполняются, какие источники и результаты.
- Lineage — граф зависимостей между активами через Transformation.
- Run/Version — конкретная версия набора данных или прогон пайплайна, позволяющая отслеживать изменения во времени.
- Owner/ Steward — ответственные лица и команды.
- Classification/Policy — чувствительность, приватность (PII, GDPR), правила доступа.
- Tags и taxonomy — бизнес-термины и контекст данных.
Хранение и производительность
- Хранение метаданных может быть реализовано на основе relational DB (PostgreSQL/MySQL), графовой БД (Neo4j, JanusGraph) или в гибридной схеме. Графовые решения особенно удобны для быстрых запросов по lineage.
- Ингесторы генерируют lineage-последовательности, которые записываются в графовую модель и обновляются инкрементально.
- API и UI должны обеспечивать быстрый доступ кNavigate по активам и их зависимостям, поддерживать фильтры по источникам, источникам данных, бизнес-области, владельцам и уровню доступа.
- Безопасность: применяется шифрование данных в покое и в передаче, интеграция с LDAP/AD, управление ролями и правами доступа, аудит изменений.
Инструменты и лучшие практики внедрения
- Определение минимально необходимого объема lineage для запуска бизнес-процессов и регуляторных требований.
- Постепенная автоматизация: начать с наиболее критичных пайплайнов и источников, затем расширять покрытие.
- Нормализация терминологии: создание словаря бизнес-терминов и схемы именования активов, чтобы упростить поиск и согласование между бизнес-единицами.
- Верификация lineage: периодическая проверка точности линий: сопоставление фактических источников и трансформаций с записями в каталоге на основе аудита и тестов данных.
- Контроль качества: связывать lineage с качеством данных — полнота, точность, актуальность и соответствие политикам.
- Обеспечение соответствия: настройка политики доступа к данным, аудит использования и возможность полного аудита изменений.
Риски и ограничения
Неполнота или неточность lineage
- Проблемы: не все источники поддерживают автоматический сбор lineage, некоторые трансформации скрыты за сторонними инструментами; изменения в источниках могут приводить к рассинхрону между реальным путем данных и отображаемым путём в каталоге.
- Решения: постепенное добавление коннекторов, ручное документирование там, где автоматизация невозможна, внедрение периодических контрольных тестов на согласованность.
Производительность и масштабирование
- Проблемы: большой граф зависимостей может влиять на скорость поиска и обновления lineage, особенно если источники обновляются часто.
- Решения: инкрементные обновления, кэширование популярных запросов, горизонтальное масштабирование метаданных, архитектура с разделением по бизнес-областям.
Сложность внедрения и обучение
- Проблемы: требуется команда с компетенциями по данным, метаданным, безопасности и интеграциям.
- Решения: поэтапное внедрение, обучение сотрудников, создание документации, поддержка локальных практик по управлению терминологией и процессами.
Соответствие требованиям и безопасность
- Проблемы: работа с персональными данными и чувствительной информацией требует соблюдения законов и регуляторных норм.
- Решения: классификация, доступ на основе ролей, анонимизация/маскирование, аудит и управление рисками.
Непрерывность и версияing
- Проблемы: обновления версий источников и пайплайнов могут привести к несовместимостям.
- Решения: управление версиями метаданных, фиксация версии данных, поддержка rollback и исторических записей.
Масштабируемость и совместимость технологий
- Проблемы: устаревающие коннекторы, несовместимость версий, зависимость от конкретной СУБД или инструмента.
- Решения: модульная архитектура, использование стандартных форматов обмена метаданными, поддержка множества источников и версий.
Прослеживаемость данных — это не просто технология, а основа доверия к данным и управлению ими в рамках компании. Внедряя Data Catalog, следует ориентироваться на стратегические бизнес-цели: повышение прозрачности данных, ускорение аналитики, соответствие требованиям регуляторов, обеспечение качества и безопасности. Важно помнить, что полная end-to-end прослеживаемость требует времени, ресурсов и стратегического подхода к архитектуре и процессам: начиная с критичных источников и пайплайнов, поэтапно расширяя покрытие, внедряя стандарты, правовую и бизнес-терминологию, а также обучая команду.
FAQ — Вопрос–Ответ
1) Что такое прослеживаемость данных и зачем она нужна в Data Catalog?
Ответ: Прослеживаемость данных — это карта пути данных от исходных источников до потребителей и результатов обработки, включая трансформации и перемещения. Она нужна для прозрачности бизнес-процессов, аудита использования данных, ускорения аналитики и обеспечения соответствия требованиям регуляторов. Data Catalog служит центральным хранилищем метаданных, где хранится и визуализируется эта прослеживаемость.
2) Какую роль играет линейность (lineage) в регуляторной комплаенсности?
Ответ: Линия данных позволяет показать, каким образом персональные данные перетекают через системы, какие трансформации применяются и кто имеет доступ к данным. Это облегчает ответы на запросы регуляторов, обеспечивает аудит изменений, поддержку политики минимального доступа и возможность подмены уязвимых участков в случае инцидента.
3) Какие источники данных чаще всего участвуют в прослеживаемости?
Ответ: Чаще всего это база данных (PostgreSQL, Oracle, MSSQL), файловые хранилища (HDFS, S3), ERP/CRM-системы (например, 1С), ETL/ELT-инструменты (Airflow, NiFi, Dagster) и BI-платформы. В ML-пайплайнах прослеживаемость может включать данные и модели, а также параметры обучения.
4) Какие инструменты открытого кода чаще всего используются для прослеживаемости?
Ответ: Apache Atlas, Amundsen, DataHub, OpenMetadata, Apache NiFi — это одни из популярных решений для управления метаданными и lineage. Они предлагают графовую модель данных, API и UI, позволяют интегрироваться с источниками и пайплайнами, а также поддерживают часть функциональности по соблюдению регламентов.
5) Какие современные подходы к внедрению прослеживаемости существуют?
Ответ: Интеграционная методология с автоматическим извлечением метаданных, instrumentation-based подход с хуками и плагинами в источниках, и event-driven подход с регистрацией lineage через события. Часто применяется гибридный подход: автоматизированная сборка в стабильной части системы и ручное дополнение там, где автоматизация затруднена.
6) Какие риски связаны с внедрением прослеживаемости данных и как их минимизировать?
Ответ: Риски включают неполноту линейности, задержки обновления, сложность поддержки и риски безопасности. Минимизация осуществляется через поэтапное внедрение, автоматизацию там, где возможно, строгие политики доступа, нормализацию терминологии, аудит изменений и тестирование согласованности данных.
7) Как связать прослеживаемость с качеством данных?
Ответ: Прослеживаемость позволяет видеть, какие данные участвуют в конкретном отчете или модели, а качество данных оценивается через параметры полноты, точности, актуальности. Это позволяет выявлять «узкие места» и автоматически предупреждать об отклонениях. В каталоге можно держать связанные показатели качества и уведомления.
8) Какие достоинства и ограничения у российских решений по прослеживаемости?
Ответ: Преимущества включают соответствие локальным требованиям, контроль за данными в рамках отечественного дата-центра и адаптацию под российские регуляторные нормы. Ограничения могут быть связаны с меньшей экосистемой интеграций по сравнению с мировыми лидерами и потребностью в дополнительных усилиях по адаптации под конкретные источники данных, особенно при использовании корпоративных или устоявшихся бизнес-приложений.
9) Как начать внедрять прослеживаемость в нашей компании?
Ответ: Сначала определить критичные источники и пайплайны, которую часть линейности нужно охватить в первую очередь. Затем выбрать подходящее решение (open-source или отечественное) и запустить пилотный проект на ограниченном наборе источников. Постепенно расширять покрытие, при этом работать над нормализацией терминологии, политик доступа и процессов аудита. Важно обеспечить обучение сотрудников и документирование.
10) Какие метаданные в каталоге наиболее важны для прослеживаемости?
Ответ: DataAsset, DataSet, Field, Transformation, Job, Lineage, Run/Version, Owner, Policy, Classification, Tags. Эти сущности позволяют описывать активы, трансформации и пути, а также управлять доступом и ответственностью.
Если у вас есть конкретные источники данных и инструменты в вашей компании, можно приступить к проектированию каркаса прослеживаемости и выбрать набор коннекторов для быстрого старта. Начать можно с минимальной end-to-end цепочки: источник данных — преобразование — целевой набор данных/отчет, затем постепенно развивать покрытие и точность lineage, одновременно работая над политиками доступа и качеством данных.


