

SLA, SLO, SLI: концептуальная рамка управления надёжностью, контрактной логикой и мониторингом
Введение: постановка проблемы и мотивация различия SLA и SLO
Развитие современных цифровых сервисов требует ясной и измеримой коммуникации об уровне надёжности между поставщиком и потребителем. В этом контексте часто возникает путаница между терминами SLA (Service Level Agreement — договор об уровне сервиса) и SLO (Service Level Objective — целевые значения уровня сервиса). Эта путаница приводит к неверному восприятию ответственности, излишней осторожности или, наоборот, недооценке рисков. Важной целью данной статьи является не развлекательная дискуссия, а выстраивание концептуальной рамки, позволяющей различать внешнюю юридическую ответственность и внутренние договорённости об обслуживании, а также правильно связывать метрики надежности с процессами мониторинга, изменения и аудита.
Идея можно резюмировать так: SLI (Service Level Indicator — индикатор уровня сервиса) и SLO задают как внутри организации, так и внешним потребителям конкретные, измеримые величины надёжности; SLA – это юридическое оформление, которое объясняет последствия несоблюдения этих обязательств. При ясной внутренней структуре целей, механизмов оповещения и управления изменениям, компании получают устойчивую систему доверия, снижают юридические риски и улучшают операционную эффективность. В статье будут рассмотрены термины и взаимосвязи, логика контрактов, выбор и формулировка метрик, управление ошибочным бюджетом, аудит и визуализация, примеры использования в реальных сценариях, а также практические руководства по внедрению.
Следует подчеркнуть, что основная ценность SLA/SLO не только в формализмах, но в выверке процессов ответственности и влияния на решения по выпуску изменений. В рамках этой рамки важно различать: внешнюю ориентацию SLA как обязательство перед внешними пользователями и юридическую основу, и внутреннюю SLO как ориентир для команд внутри организации, управляемый через оповещения и изменения кода. Осознание этой дифференциации улучшает коммуникацию между бизнесом, инженерами и юридическим отделом и повышает общую надёжность сервиса.
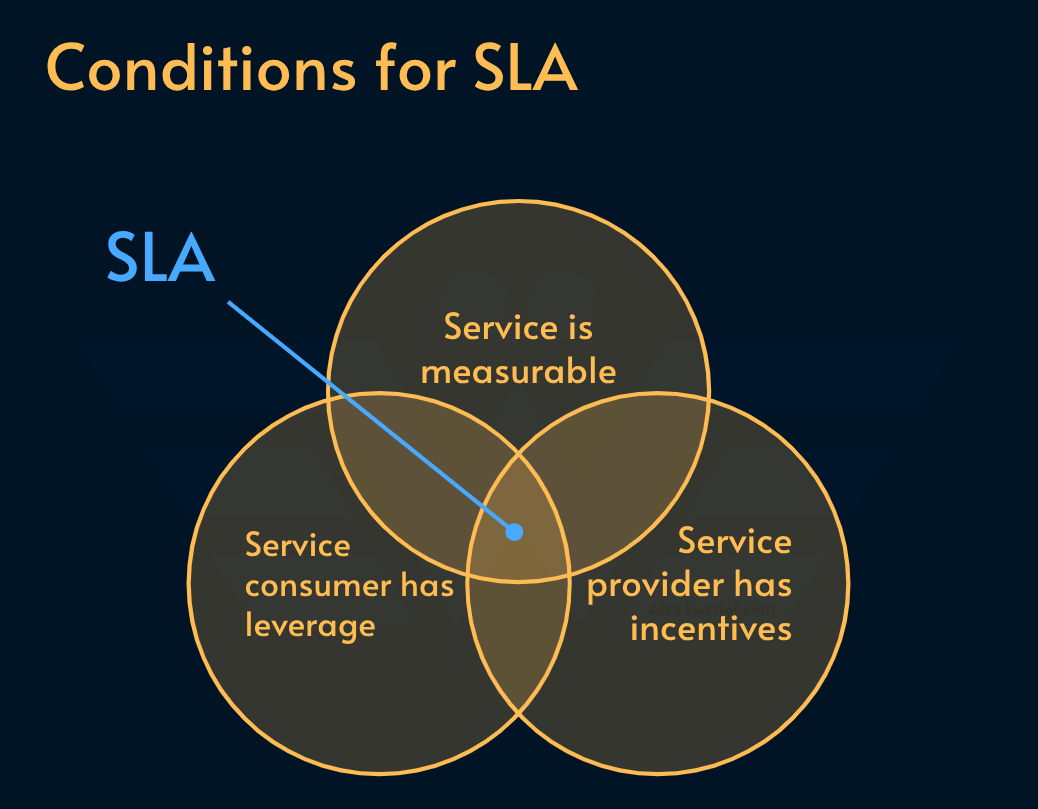
Термины и взаимосвязи: SLI, SLS, SLO, SLA — определения и отношения
-
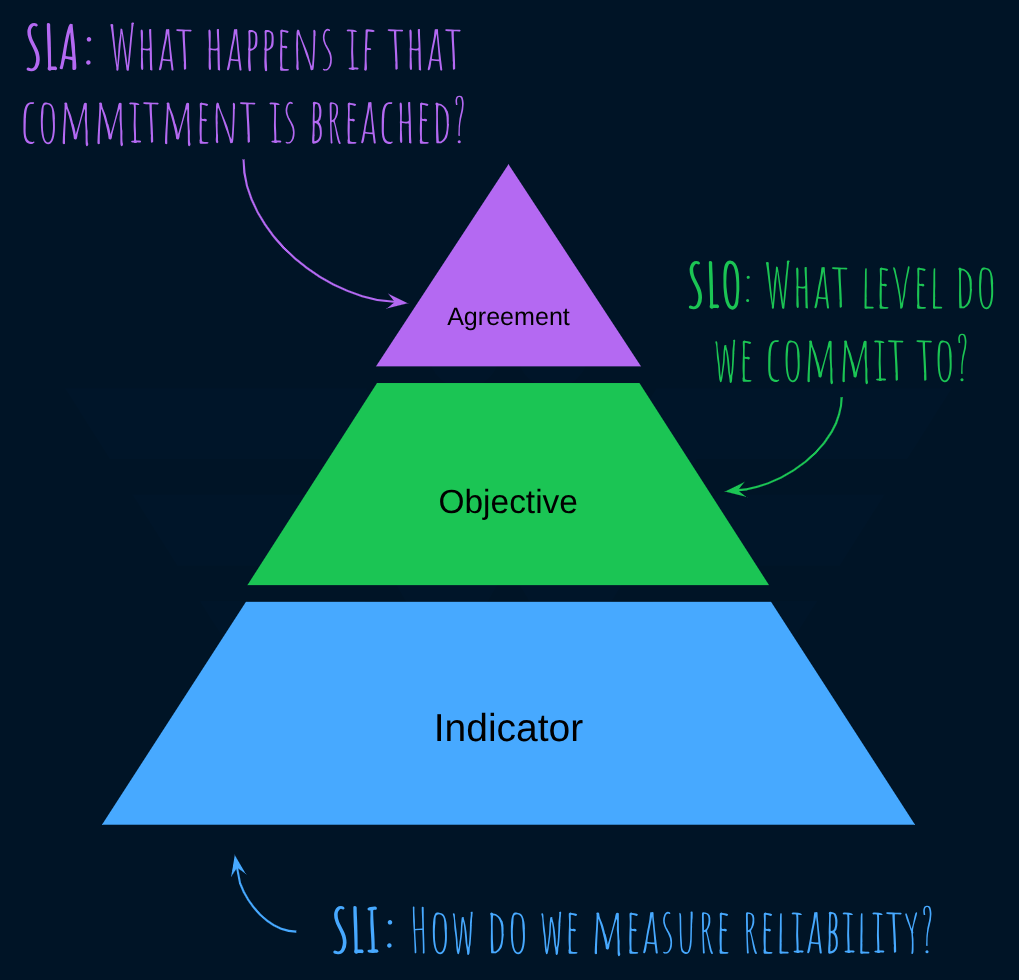
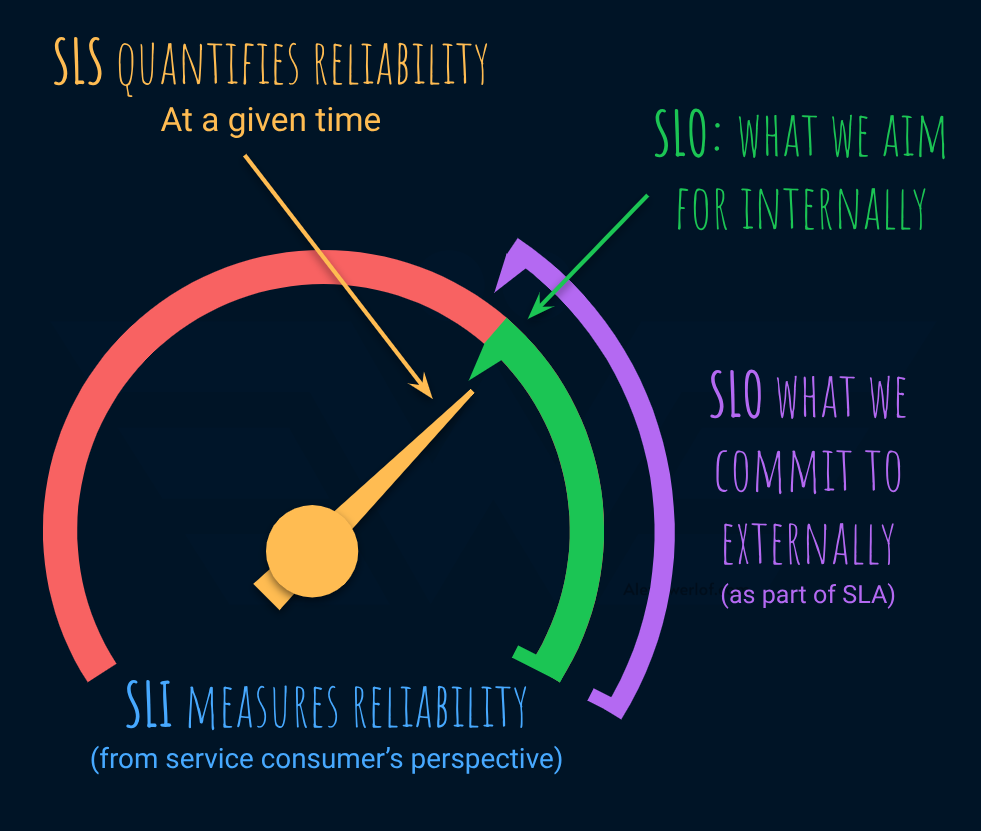
SLI (Service Level Indicator) — индикатор уровня сервиса. Это конкретная метрика, отображающая восприятие потребителя о надёжности сервиса. Примеры: доля успешных запросов, среднее время восстановления после инцидента, латентность запроса на уровне p95, процент ошибок в транзакциях. Важно подчеркнуть, что SLI относится к внешнему восприятию сервиса (для потребителя) и может быть связан как с внешними, так и с внутренними потребителями, в зависимости от того, какие аспекты сервиса считаются критичными.
-
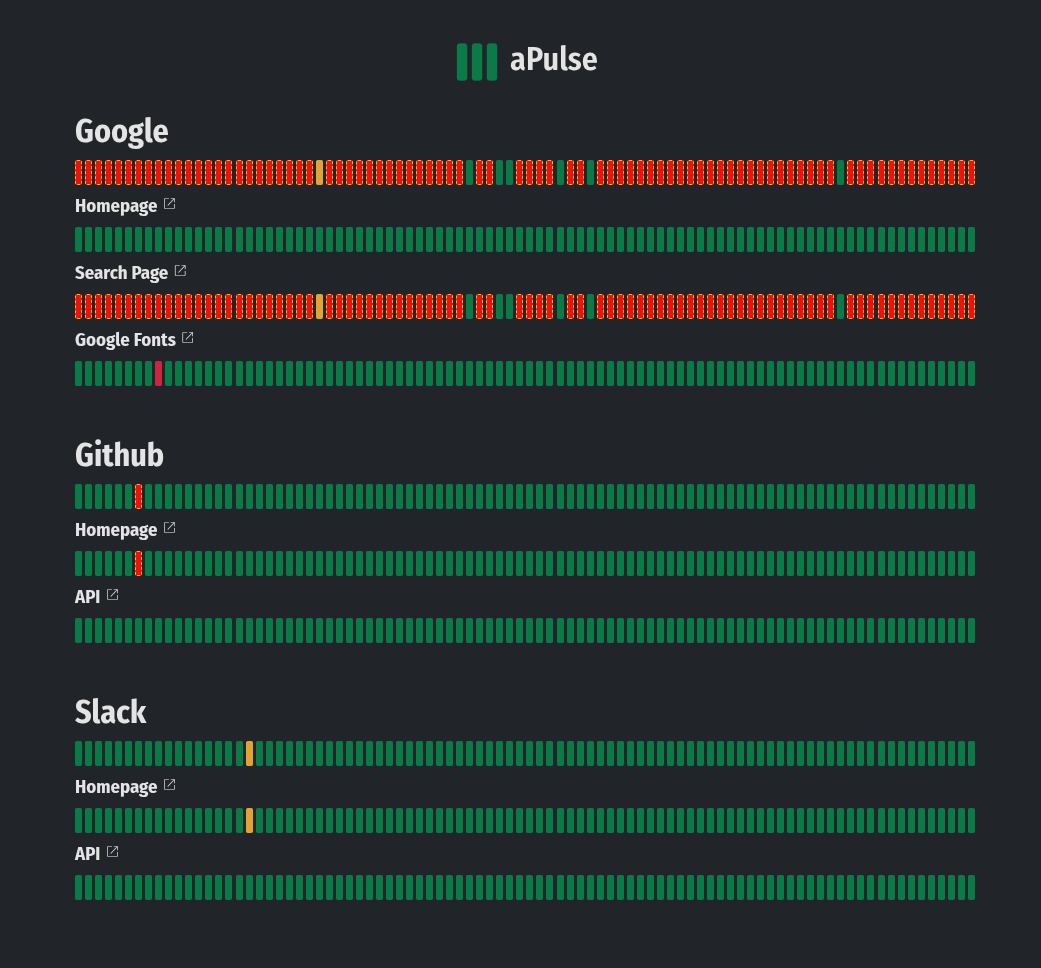
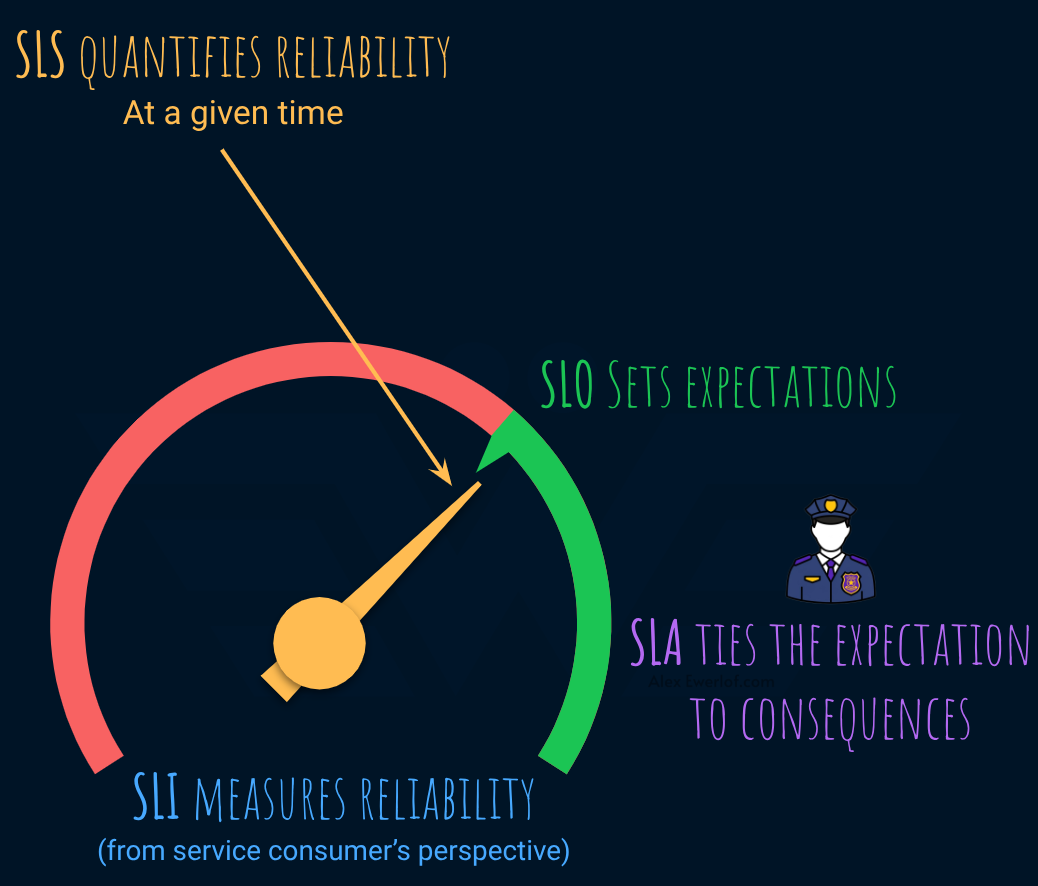
SLS (Service Level Status) — фактическое состояние индикатора в заданный период. Это конкретные наблюдаемые значения SLI за окно измерения (например, за 30 дней) и их представление в дашбордах или статус-страницах. SLS демонстрирует реальность того, как сервис соответствовал или отклонялся от целей.
-
SLO (Service Level Objective) — целевые значения по тем же метрикам за определённый период времени. Обычно устанавливаются для таких периодов, как 30, 90 или 365 дней, и представляют требуемый уровень надёжности, который организация обязуется поддерживать для потребителей. Внутренне SLO служит ориентирами для команд и процессов, включая правила деплоя и реагирования на инциденты.
-
SLA (Service Level Agreement) — юридическое соглашение, связывающее внешние потребительские требования с конкретными последствиями за невыполнение. В SLA часто перечисляются гарантийные условия, исключения, процедуры компенсаций или кредитов, сроки реакции и поддержки. Важное пояснение: SLA – это не просто набор метрик; это правовая конструкция, в которой закрепляются последствия для поставщика и условия для потребителя.
Связь между этими понятиями состоит в следующем: SLI формирует измеримую основу, на которую опираются SLO и SLA. SLO задаёт целевые значения, которые служат опорой для управляемости и согласования изменений. SLA может применяться к внешним клиентам и описывать юридические последствия, если SLO не достигаются. Внутри организации SLO может применяться как контракт между командами, поддерживающий ответственность и эскалацию без юридических последствий. В этом контексте SLA часто выступает как “слой” поверх SLO/Sli, который закрепляет коммерческие последствия. Важный вывод: если поле ответственности разделено правильно и существует связь между SLO и процессами аварийного реагирования и изменений, то SLA становится эффективным инструментом, а не формальностью.
Пояснение взаимосвязей в виде практических правил:
- Привязка внешних платежей к SLO допускается только через ясно указанные SLI и условия, иначе это будет риск неправильно установленной ответственности.
- Внутренние SLO – это детализированные SLI, адресованные инженерным командам и целевые уровни для операций, они могут быть более “тонкими” и технически детализированными.
- SLS должен быть доступен для соответствующего круга лиц: внешний статус-страницы (если SLA внешне ориентирован) или внутренний дашборд (для команды и CTO/правления).
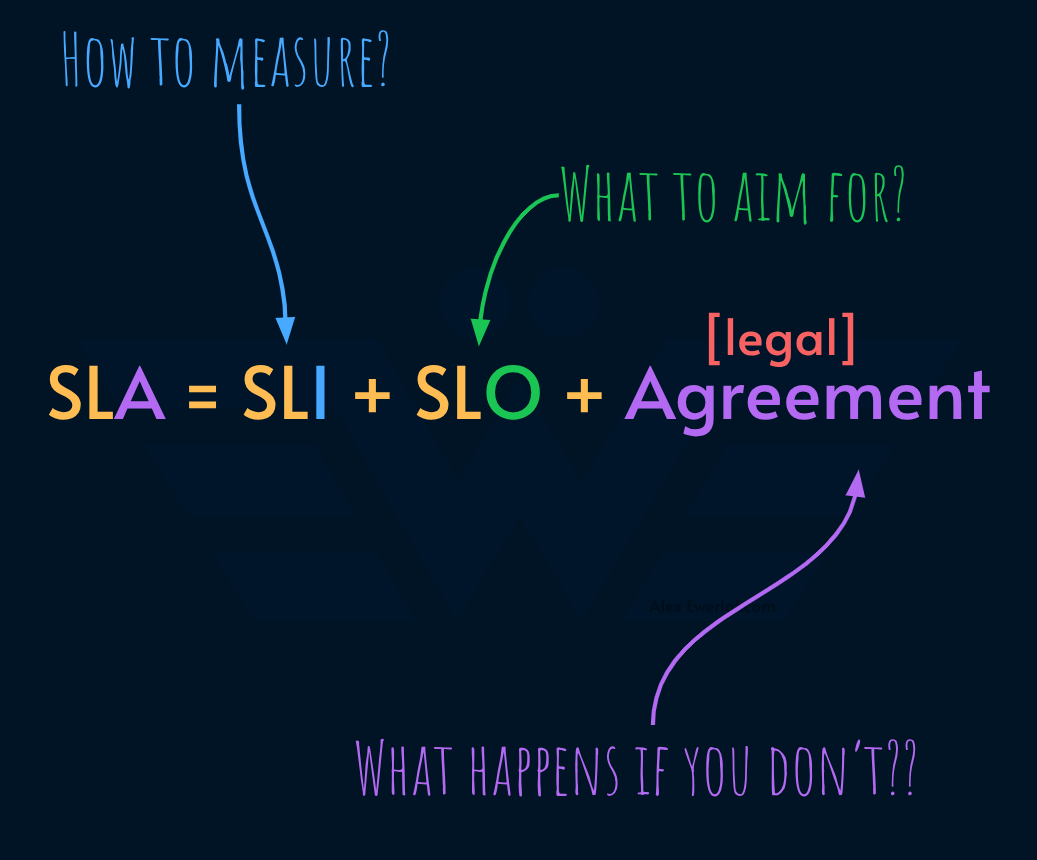
Контрактная логика: внешнее соглашение SLA против внутренней ответственности SLO
Контрактная логика различает внешнюю юридическую ответственность и внутреннюю операционную подотчётность. Внешний контракт SLA оформляет договорные обязательства между продавцом услуги и потребителем и описывает последствия, если ожидаемое качество не достигается. Это может включать компенсации, кредиты на обслуживание, приоритетное обслуживание и юридические механизмы разбирательства. Компаниям важно формировать SLA как документ, который легко найти, понять и применить на практике — не как длинный юридический свод правил без четкой привязки к реальной работе команд.
С другой стороны, внутренняя ответственность SLO — это целевые значения, которые команды ставят перед собой, чтобы обеспечить надёжность сервиса. Эти цели служат двигателем для изменений, принятия решений и распределения ресурсов внутри организации. Связь между SLA и SLO должна быть ясной: внешняя договорённость не должна ставить под угрозу внутреннюю устойчивость сервиса. Обратная сторона — SLO, не подкреплённая активной ответственностью через оповещения и изменения в CI/CD, перестаёт работать как инструмент дисциплины и становится чистой бюрократией.
Практические принципы:
- SLA должен быть документирован и доступен внешним потребителям, включать ясные условия и исключения, а также механизмы ответственности.
- SLO должен быть тесно интегрирован в процесс разработки и эксплуатации: оповещения должны активироваться, когда состояние SLS не достигает целевых значений; ошибки бюджета должны использоваться как ограничение для изменений.
- Роль аудита: периодический аудит SLA/SLO помогает выявлять несоответствия между обещанными уровнями и фактическими процессами; корректирующие действия должны быть встроены в стратегию изменений.
Метрики надежности: выбор, формулы SLI; целевые значения SLO
Выбор метрик (SLI) зависит от контекста сервиса и ожиданий потребителя. Классический набор включает:
- Availability (доступность): доля времени, когда сервис отвечал удовлетворительно; обычно выражается как октавная пропорция в окне измерения.
- Latency (латентность): время ответа, например p95 или p99 латентности для критических операций.
- Error rate (уровень ошибок): доля неудачных запросов или транзакций.
- Throughput: пропускная способность, например количество успешно обработанных транзакций в единицу времени.
- Freshness or data timeliness (свежесть данных): насколько актуальны данные для пользователя.
Формулы SLI представляют собой конкретизацию метрик:
- Availability = (Время безотказной работы) / (Общее время измерения).
- Latency SLI (например, p95) измеряется как пороговую величину времени отклика, ниже которой 95% запросов укладываются.
- Error rate = (Количество ошибок) / (Общее число запросов).
SLO устанавливают целевые значения на период измерения:
- Пример SLO по доступности: 99.9% за 30 дней.
- Пример SLO по латентности: 95-й перцентиль отклика менее 200 мс за 30 дней.
- Пример SLO по ошибкам: доля ошибок не более 0.1% за тот же период.
Уточнение: период измерения и методика расчёта влияют на восприятие надёжности. При выборе SLO стоит учитывать естественную вариативность нагрузки, сезонные пики и влияние изменений в инфраструктуре. Важнее всего — чтобы внутренние и внешние SLI/SLO были согласованы и отражали возможности команды влиять на оценку (например, через архитектурные изменения, оптимизацию кода, улучшение кэширования). В контексте предметной области целевые значения SLO должны быть сбалансированы между амбициями и реальной способностью команды поддерживать их.
Ошибочный бюджет и управление изменениями: связь SLO с CI/CD и релизами
Error budget (бюджет ошибок) — это остаток доступной надёжности, рассчитанный как 1 минус SLO. Он позволяет управлять рисками при внедрении изменений и релизах. Применение бюджета ошибок в рамках CI/CD имеет смысл как средство контроля риска: если сервис израсходовал значимую часть бюджета за счёт инцидентов или низкой производительности, создание неотложных изменений может быть приостановлено или вовсе запрещено до восстановления состояния.
Ключевые принципы:
- Привязка изменений к бюджету ошибок: каждый релиз или изменение в продакшене должен учитывать текущий темп израсходования бюджета. Если бюджет истощён, приоритетность изменений должна снижаться, а регуляторные изменения (безопасные обновления) должны быть отложены.
- Регистрация и аудит: каждое изменение должно документировать его влияние на SLO и бюджет ошибок, чтобы можно было отследить, какие изменения приводят к ухудшению состояния.
- Эскалация и корректирующие меры: при израсходовании бюджета следует применить контрмеры: ускорение тестирования, пауза в релизах, усиление мониторинга, дополнительные аудиторы или временное изменение приоритетности задач.
Смысл в том, что управление изменениями становится сознательной политикой управления рисками, а не произвольной процедурой. Такой подход помогает балансировать инновации с надёжностью, обеспечивая предсказуемость и устойчивость сервиса.
Управление ожиданиями и аудит: оповещения, дашборды, статус-страницы, ревизия
Управление ожиданиями требует прозрачности и постоянного контроля за состоянием сервиса. Основные элементы:
- Оповещения: алертинг должен быть настроен в связке с SLO, чтобы ответственные команды знали, когда SLS падает ниже целевых значений. В идеале оповещения должны минимизировать ложные срабатывания и направлять к конкретным ответным действиям.
- Дашборды: внутренние и внешние визуализации разных уровней детализации. Внешние статус-страницы демонстрируют потребителям текущее состояние (is it me or is it them?), а внутренние дашборды — детализированный взгляд на элементы архитектуры и их зависимостей.
- Статус-страницы: для внешних потребителей важна доступность информации об инцидентах, приблизительное время восстановления и ориентиры по сервисам. Примеры: публичные страницы статуса крупных облачных провайдеров.
- Ревизия: периодические обзоры по SLO, SLA, изменениями в архитектуре и процессах. Внутренний аудит позволяет скорректировать цели и процедуры, учитывать изменения в пользовательском поведении и в регуляторной среде.
Аудит должен быть не только ретроспективой инцидентов, но и превентивным инструментом для совершенствования мониторинга, управления изменениями ие подтверждения того, что удовлетворяются внешние обязательства и внутренние цели.
Декомпозиция технических компонентов и их взаимодействие: архитектурная карта сервисов, слои, зависимости
Эффективное управление надёжностью требует ясной архитектурной картины. Необходимо разложить сервис на логические уровни, выявить зависимости и определить, какие SLIs соответствуют каждому уровню. Типовая архитектурная карта включает:
- Внешний уровень (граница сервиса): API, клиентские интерфейсы, платформа, контракты, SLA.
- Промежуточные уровни: сервисы-агрегаторы, маршрутизаторы, очереди сообщений, очереди событий и кэширование. На этом уровне важно определить зависимости между компонентами и границы ответственности.
- Внутренний уровень: микросервисы, базы данных, очереди, очереди задач, мониторинг и журналирование. Здесь SLI может быть более детализированным и привязан к конкретной реализации.
- Инфраструктурный уровень: облачные ресурсы, сетевые компоненты, балансировщики нагрузки, графики зависимостей и внешние системы.
Каждый уровень должен иметь набор SLI, соответствующих его границам и задачам. Важное требование: монтирование SLA должно учитывать внешние потребности, в то время как внутренняя SLO опирается на контроль над конкретными компонентами и их взаимодействиями. Разделение по слоям облегчает идентификацию узких мест и упрощает планирование изменений без риска нарушения целевых уровней надежности.
Мониторинг и оперативная практика: SLS, внешние и внутренние статусы, видимость потребителю
Мониторинг — это не только сбор метрик, но и своевременная их интерпретация и действия. В рамках практики следует различать:
- SLS (Service Level Status) — фактическое состояние индикаторов в заданном окне. Это набор текущих значений, которые состоят в сумме по всем критическим SLIs и показывают степень соответствия целям SLO.
- Внешний статус: открытая и понятная статус-страница, которая публикует текущее состояние сервиса, инциденты, обновления и ориентировочные сроки восстановления. Этот элемент особенно важен для внешних потребителей и партнеров.
- Внутренний статус: дашборды, доступные команде и руководству. Эти элементы позволяют роботизированные механизмы CI/CD принимать решения по выпуску изменений и координировать работу служебных команд.
- Видимость потребителю: прозрачная коммуникация о текущем состоянии сервиса, доступ к информации об инцидентах и их статусе, а также понятные сообщения об ограничениях и датах восстановления.
Эти практики требуют тесной интеграции между мониторингом, алертингом, CI/CD и планированием инцидент-ответа. В идеале лимиты на аварийные изменения и автоматическое отклонение изменений на проде должны основываться на уровнях SLO и бюджете ошибок.
Визуализация и иллюстрации: схемы, примеры, аллегории
Для эффективной коммуникации и обучения команды полезно использовать простые визуальные метафоры и схемы:
- Графическое отображение SLI на виде шкалы-гейта: индикатор, отображающий текущее значение и пороги целевых значений SLO. Такой образ помогает быстро определить, требует ли сервис вмешательства.
- Мнемонические схемы: например, треугольник ответственности между бизнесом, инженерами и юридическим отделом, демонстрирующий роли в SLA/SLO управлении.
- Архитектурные диаграммы, где видны границы ответственности между внешними контрактами и внутренними процессами, показывают, как SLI связаны с конкретными сервисами и слоями.
- Визуальные представления бюджета ошибок: графики burn-rate, показывающие темп расходования бюджета и влияние на релизы.
Эти визуальные инструменты улучшают понимание и ускоряют принятие решений на уровне команды и руководства.
Кейсы применения в реальных сценариях: варианты отраслей и сценарии использования SLA/SLO
- Финансовый сектор: сервисы онлайн-банкинга, платежные системы. Внешний SLA может включать доступность платежей на 99.95% и максимальное время простоя за месяц, в то время как внутренние SLO определяют пороги latency и обработку транзакций. Ошибочный бюджет блокирует рискованные обновления, если он истощён.
- Здравоохранение: телемедицина и электронные медицинские записи. Важны как доступность, так и безопасность данных. SLA и SLO должны сочетаться с соблюдением регуляторных требований (например, защита конфиденциальности).
- Государственный сектор: открытые порталы услуг, кадастровые системы. Внешний SLA в контрактах с гражданами, внутренний SLO — с инфраструктурой и государственными структурами.
- Розничная торговля: онлайн-лендинги и обслуживание клиентов. SLA может включать время отклика и доступность платежных сервисов; внутренняя SLO управляет кэшированием и обработкой заказов.
- П SaaS и платформы: критические сервисы зависимы от многокомпонентной архитектуры; SLOs могут быть связаны с доступностью API, временем задержки в обработке запросов и качеством данных.
Ключевые выводы: в разных отраслях практики SLA/SLO применяются по-разному, но общий принцип — соединение внешних обязательств и внутренних управленческих практик через четкие SLI и SLO, а также привязка к механизмам мониторинга и изменениям.
Интеграция технологических стеков и синергия: как связаны мониторинг, алертинг, CI/CD, incident response
Эффективная синергия между стеком мониторинга, алертингом, CI/CD и incident response предполагает:
- Единую модель SLI/SLO: все уровни архитектуры должны поддерживать согласованные индикаторы надёжности. Метрики должны быть доступны для всех заинтересованных сторон.
- Алертинг, привязанный к SLO: оповещения должны вызывать эскалацию, когда состояние сервиса отклоняется от целевых значений. В идеале алерты должны вести к конкретным инструкциям по устранению инцидента.
- CI/CD как механизм контроля риска: бюджет ошибок используется для определения, когда можно совершать изменения в продакшене. Релизы должны проходить через проверки, которые учитывают текущий статус SLO и бюджет ошибок.
- Incident response: план действий в случае инцидентов, включающий роль ответственных, каналы уведомления, процесс эскалации и пост-инцидентный разбор (post-incident reviews) для корректировки SLO и изменений в архитектуре.
Интеграция таких элементов обеспечивает не только быстрое реагирование на инциденты, но и систематическое улучшение сервиса, основанное на данных. Важно, чтобы все участники знали и использовали единый набор определений и процедур, что снижает риск непонимания и ошибок.
Применение в экономических секторах: финансовый, здравоохранение, государственный, розничная торговля
- Финансовый сектор: требования к доступности сервисов критичны; регуляторика часто требует строгого аудита и прозрачности. SLA/SLO должны сочетаться с соблюдением финансовых стандартов и природой транзакционной обработки.
- Здравоохранение: требования к приватности и целостности данных (регуляторные требования). SLA/SLO учитывают критичность данных и доступность сервисов для пациентов и медицинских работников.
- Государственный сектор: высокие требования к надёжности и прозрачности. Система отчетности и аудита должна обеспечивать доступность информации и защиту персональных данных.
- Розничная торговля: онлайн-ресурсы и платежные платформы требуют высокой доступности и быстрой реакции на инциденты, особенно в пиковые периоды. SLO могут включать скорость обработки заказов и точность данных по складам.
- Общие выводы: отраслевые отличия требуют адаптации SLI/SLO/SLA к специфическим требованиям, включая регуляторику, клиентскую осведомлённость, и требования к безопасности.
Анализ рисков, уязвимостей и ограничений: юридические, операционные, методологические риски; метрики эффективности
- Юридические риски: SLA несет правовую ответственность, включая штрафы и компенсации. Неправильное формулирование может привести к спорам. Важно обеспечить ясные определения, исключения и способы разрешения конфликтов.
- Операционные риски: несогласованность между маркетингом, продажами и IT позволяет ожиданиям выходить за пределы реальности. Необходима прозрачная коммуникация и согласованные SLO.
- Методологические риски: неверная выборка метрик, слишком узкие SLI, слабая связь между SLO и операционными процессами. Риск снижается через корректный дизайн метрик, регулярную ревизию и учет реального поведения пользователей.
- Метрики эффективности: показатель эффективности включает не только достижение целевых значений, но и способность быстро адаптироваться к изменениям нагрузки и конфигурации. Включает в себя скорость исправления инцидентов, частоту релизов в рамках бюджета ошибок и качество пост-инцидентных разборов.
Компаративный анализ конкурирующих решений и их дифференциация: сравнение поставщиков и практик
- Google SRE подход: акцент на публичной доступности SLIs/SLOs и использование бюджета ошибок в управлении изменениями. Внутренний и внешний уровень разделены четко, и юридическая часть (SLA) — отдельная плоскость.
- Atlassian, PagerDuty и отраслевые практики: предоставляют инструменты для мониторинга, оповещений и пост-инцидентных разборов, но различаются по глубине трактовки SLA и степени детализации SLO для внутренних пользователей.
- Вендорные SLA: зачастую более “cookie-cutter” и ориентированы на внешних клиентов; требуют адаптации под конкретные сервисы и юридические требования.
- Практики: предпочтение отдается Socratic подходу к метрикам, где метрики должны быть связаны с бизнес-целями и операционной стратегией. Некоторые решения фокусируются на внешних статусах, другие — на внутренних метриках и алертах. Ключ к дифференциации — возможность адаптировать SLI/SLO/SLA к специфике сервиса и регуляторной среды.
Практические руководства: шаблоны документов, чек-листы внедрения, примеры расчета error budget
- Шаблон SLO: цель по метрике, окно измерения, пороги, детализация по компонентам, ответственность за мониторинг и эскалацию.
- Шаблон SLA: применимый к внешним клиентам, включает определения, исключения, услуги поддержки, сроки реакции, компенсации и порядок урегулирования споров.
- Чек-лист внедрения: определить ключевые SLIs, согласовать SLO с бизнес-заказчиками, разработать процесс мониторинга и alerting, план по бюджету ошибок, подготовить статус-страницу для внешних пользователей, провести пилотный выпуск и аудит.
- Расчет error budget: Budget = 1 - SLO. Burn rate = фактическое потребление бюджета за период / планируемый бюджет за период. Пример: SLO = 99.9% Availability за 30 дней, Budget = 0.1% пропусков; если реальная пропускная способность превышена, burn-rate > 1, и необходимо ограничить изменения.
- Примеры расчета: можно привести конкретные числовые примеры для доступности, латентности и ошибок, и как они влияют на CI/CD политика и релизы.
Выводы и направления будущих исследований
Итоговая рамка SLA, SLO, SLI и SLS представляет систематизированный подход к управлению надёжностью, который сочетает внешнюю юридическую ответственность и внутреннюю операционную дисциплину. Важность заключается в том, что эффективное управление надёжностью требует согласования между метриками, процессами и политиками — от архитектурной карты до CI/CD и пост-инцидентного анализа. В будущем следует развивать методики автоматического сопряжения мониторинга с проектами изменений, расширять практики аудита, и исследовать новые способы визуализации сложных зависимостей между сервисами. В рамках регуляторной и бизнес-среды возрастают требования к прозрачности и доказуемости надежности, что делает тему SLA/SLO/SLI/SLS ключевым компонентом современных управленческих практик в индустрии.
Вопрос-Ответ:
Вопрос: Что такое SLI и чем он отличается от SLO?
Ответ: SLI (Service Level Indicator) — это конкретная метрика, отражающая восприятие потребителя о надёжности сервиса (например, доля успешных запросов). SLO (Service Level Objective) — целевое значение по этой метрике на заданный период (например, 99.9% доступности за 30 дней). SLI — измерение, SLO — целевое ограничение, которое организация намерена соблюдать.
Вопрос: Как SLA связан с SLO и SLI?
Ответ: SLA — это юридическое соглашение, связывающее внешнюю сторону потребителя с конкретными последствиями за несоблюдение целевых уровней. В большинстве случаев SLA опирается на определённые SLI и SLO, но обладает юридическим характером и деталями компенсаций, датами реакции и условиями расторжения.
Вопрос: Как использовать ошибочный бюджет в управлении выпуском?
Ответ: Ошибочный бюджет (budget of error) равен 1 минус SLO. Его использование позволяет блокировать рискованные изменения, если бюджет истощён, или ускорять тестирование и аудит изменений, если бюджет в норме. Это помогает синхронизировать выпуск новых функций с надёжностью сервиса.
Вопрос: Какая роль мониторинга в управлении ожиданиями между бизнесом и инженерией?
Ответ: Мониторинг обеспечивает прозрачность и управляемость. Внешние статус-страницы информируют потребителей о текущем состоянии, внутренние дашборды помогают командам управлять изменениями и реагировать на инциденты, а аудит обеспечивает соответствие требованиям и непрерывное улучшение процессов.
Вопрос: Какие особенности имеют отраслевые применения SLA/SLO?
Ответ: Разные отрасли предъявляют различную регуляторную и операционную нагрузку. В финансовом секторе важна точность и восстановление после сбоев; здравоохранение требует приватности и доступности данных; государственный сектор — прозрачность и соответствие политике; розничная торговля — скорость отклика и устойчивость к пиковым нагрузкам. В каждом случае SLI/SLO должны быть адаптированы к конкретной предметной области и регуляторным требованиям.
Вопрос: Какие риски стоит учитывать при внедрении SLA/SLO?
Ответ: Юридические риски из-за нечетко сформулированных соглашений; операционные риски из-за несогласованности между бизнес-интересами и инженерной реализацией; методологические риски из-за неверного подбора метрик и неадекватной связи SLO с изменениями. Важно проводить аудит, корректировать метрики и поддерживать тесную координацию между всеми участниками.
Вопрос: Каковы шаги к практическому внедрению SLA/SLO в компании?
Ответ: Шаги включают: (1) определить ключевые SLIs и соответствующие SLO; (2) разработать SLA для внешних клиентов и внутреннюю политику по управлению изменениями; (3) внедрить мониторинг и оповещения, настроить статус-страницы; (4) подготовить шаблоны документов и чек-листы для внедрения; (5) провести пилотный выпуск, аудит и корректировку; (6) поддерживать цикл ревизий и улучшений на основе данных.
Вопрос: Что следует учитывать при составлении SLA для внешних клиентов?
Ответ: В SLA важно включить понятные определения, исключения, методику расчёта доступности, сроки реакции на инциденты, уровни поддержки, компенсационные механизмы и процедуры разрешения споров. Также следует обеспечить доступность SLA (легко найден и понятен) и зафиксировать условия, которые не зависят от поставщика.


