

Интеграция данных: ETL и ELT для DDP
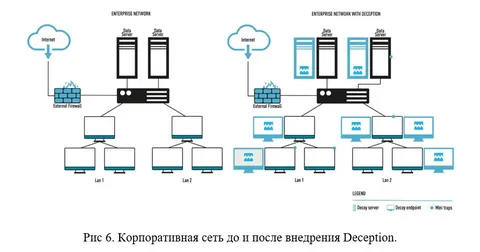
Эта глава посвящена интеграции данных в контексте Distributed Deception Platform (DDP) — платформы, ориентированной на создание обманных и защитных сценариев в информационных системах. В BI и DWH контекстах задача интеграции данных выходит на первый план: источник данных может быть разнородным — транзакционные БД, логи веб-приложений, журнальные файлы, внешние источники и сенсорные потоки; целевая система — хранилище аналитических данных, где строятся отчёты, дашборды, моделируются сценарии защиты и даже тестируются стратегии обмана злоумышленников. В этом контексте ETL (Extract, Transform, Load) и ELT (Extract, Load, Transform) становятся двумя ключевыми подходами к конвейерам данных. Грамотный выбор между ETL и ELT, а также грамотная архитектура конвейеров — залог достижения требований к скорости обновления данных, качеству данных, управлению источниками и соблюдению политики безопасности и конфиденциальности.
Определения и основные различия
- ETL: извлечение данных из источников, их преобразование в отдельном промежуточном слое и затем загрузка в целевую систему. Преимущества: хорошо управляемая трансформация, возможность сложной обработки до загрузки, меньшая нагрузка на хранилище на входе. Недостатки: задержка, необходимость мощного инфраструктурного узла для преобразований, сложность поддержки больших объемов данных.
- ELT: извлечение данных и немедленная загрузка в хранилище, затем выполнение преобразований прямо в целевой системе. Преимущества: высокая пропускная способность за счет использования возможностей СУБД/хранилищ, упрощенная архитектура, более гибкие подходы к переработке данных на поздних стадиях. Недостатки: требует мощное хранилище и сильную инфраструктуру в целевой базе, риск переработки без контроля качества на ранних этапах.
- Примерные сценарии применения: ETL актуален, когда требуется строгий контроль над трансформациями до загрузки (например, дефицит доверия к источникам или требования к секретности на стадии обработки); ELT предпочтителен в условиях большого объема данных и современных хранилищ (ClickHouse, Snowflake, BigQuery) с встроенными механиками обработки.
Архитектурные паттерны интеграции
- Битый конвейер на базе CDC (Change Data Capture): извлечение изменений из источников почти в реальном времени, доставка через брокеры сообщений (Kafka) и последующая обработка/трансформация. Эту схему часто применяют как ETL-или ELT-основанную в зависимости от места трансформации.
- Гибридные конвейеры: часть трансформаций выполняется в потоковой системе (streaming) на входе, часть — в хранилище или в аналитическом слое (например, устранение шумов и нормализация в NiFi, затем загрузка в ClickHouse, после чего dbt выполняет финальные трансформации в хранилище).
- Архитектура «источник — конвейер — целевое хранилище» с опцией «публицистских» метаданных и управления качеством данных: данные агрегируются в Data Lake или Hive-совместимое хранилище, затем совмещаются и материализуются в аналитическом хранилище.
Ключевые понятия и методологии
- Data lineage и governance: отслеживание цепочки происхождения данных, изменение источников и трансформаций. В DDP это важно для корректного анализа атак, сетевых паттернов и исторического контекста обмана.
- Data quality и validation: проверки качества данных на каждом этапе, включая согласование схем, обработку пропусков, дубликатов и неконсистентности.
- Idempotentность и повторяемость: конвейеры должны быть устойчивыми к повторной обработке, дубликатам и сетевым сбоям.
- Безопасность данных и соблюдение регуляторики: защита данных, минимизация доступа к чувствительной информации, шифрование в транзите и на диске, соответствие требованиям ФЗ-152 и другим регулятивам в разных юрисдикциях.
- Архитектура данных в DDP: учитывайте, что данные могут иметь двойную природу — для защитной разведки и для анализа. Гибридные потоки должны обеспечить как оперативность, так и точность анализа.
Практические примеры
1. Практический ETL-подход на базе открытого ПО
Архитектура: источники — MySQL/PostgreSQL; CDC через Debezium; поток сообщений через Apache Kafka; иногенерационный слой — Apache NiFi; целевое хранилище — ClickHouse; оркестрация — Apache Airflow.
Пошаговая схема:
- Debezium настроен на коннект к исходной БД, публикует изменения в Kafka в топиках по таблицам.
- NiFi потребляет версии изменений из Kafka, выполняет базовые преобразования (типизация временных меток, нормализация дат, унификация кодировок) и отправляет данные в пилотный staging-сегмент PostgreSQL.
- Затем данные из staging передаются в ClickHouse как для ELT-процесса: первоначальная загрузка (LOAD) с минимальной трансформацией; в ClickHouse выполняются финальные трансформации через материализованные представления и внешние таблицы.
- В Airflow создаются DAG’и, которые контролируют расписание, повторные запуски и качество данных, а также триггерят dbt-проекты для финальных трансформаций внутри ClickHouse. Технические детали: Debezium конфигурируется на конкретные БД и таблицы, Kafka Topics имют имена вида cam.source.table; NiFi применяет TransformRecord для приведения типов, Converts и RouteOnAttribute; ClickHouse хранит данные в партициях по дате и таблицам; мониторинг DAG’ов в Airflow, алертинг через Prometheus/Grafana.
Применение в DDP: на этом этапе данные об атакующих сигналах, логах сенсоров и действий защитных систем превращаются в аналитический набор, который можно использовать для моделирования и тестирования обманных сценариев, понимания паттернов злоумышленников и принятия решений по ответным мерам.
2. Практический ELT-подход на базе отечественных и локальных решений
Архитектура: сбор данных в промежуточном хранилище на базе PostgreSQL или локального Data Lake; целевое хранилище — ClickHouse; оркестрация — Airflow; трансформации — dbt в ClickHouse.
Пошаговая схема:
- Из источников летят данные в локальный Data Lake (Hadoop-подобное хранилище или S3-совместимое, развёрнутое в РФ), где сохраняются в формате Parquet.
- В ClickHouse через SQL-загрузку (INSERT SELECT) данные попадают в аналитическую схему; dbt-проекты применяются для трансформаций, создаются модели, которые формируют звездную схему (SCD, факт/измерения).
- Метаданные и lineage управляются через DataHub или Apache Atlas, что обеспечивает прозрачность изменений и соответствие требованиям к управлению данными.
Технические детали: dbt-проекты на русском окружении, адаптер dbt-clickhouse для трансформаций в ходе ELT; использование материализованных представлений в ClickHouse для ускорения запросов; настройка политики партиционирования и TTL в Parquet-хранилище; шифрование данных в покое и в передаче; настройка ролей в ClickHouse и в облачных/локальных сервисах для ограничения доступа.
Применение в DDP: ELT-подход позволяет быстро загружать огромные массивы телеметрических данных и логов в хранилище, затем централизованно трансформировать их в аналитические схемы, которые используются BI-дашбордами и моделями атаки/защиты.
3. Российские решения и локальные особенности
- ClickHouse: российский источник и открытое ПО, активно используется в отечественных проектах аналитики и DWH. Применение ClickHouse как хранилища для DDP позволяет строить высокоскоростные аналитические конвейеры и выполнять сложные агрегации в реальном времени.
- Яндекс.Облако и локальные развёртывания: в условиях локализации данных и требований к хранению в РФ можно использовать отечественные облачные сервисы (Яндекс.Облако) для хранения данных, конвейеров и BI-слоя. В частности, сервисы для хранения больших наборов данных, обмена сообщениями и аналитических панелей часто дополняются собственными инструментами мониторинга и защиты.
- Открытые отечественные пути: развёртывания на базе открытого ПО (NiFi, Airflow, Kafka, Debezium, dbt) в сочетании с российскими инфраструктурными решениями, которые обеспечивают локализацию данных, контроль доступа и аудит. Уточнение: при выборе российского решения следует обращать внимание на соответствие регулятивным требованиям, поддержку локализации и возможности интеграции с отечественными системами учета и безопасности.
- Практический вывод: в DDP для российского рынка целесообразно сочетать высокопроизводительные аналитические конвейеры на базе ClickHouse, инструменты CDC и оркестрации (Debezium, Kafka, Airflow/Argo) и локальные сервисы управления данными и безопасностью, чтобы обеспечить соответствие требованиям законодательства и политики безопасности.
Компоненты конвейера и их конфигурации
- Debezium: настройка коннекторов для источников (MySQL, PostgreSQL, Oracle): database.include.list, table.include.list, перекрестный превью событий, формат JSON; поддержка CDC для стриминга изменений.
- Apache Kafka: продюсеры и топики по источникам; сериализация (JSON/AVRO); настройка ретенции и репликации; безопасность через SASL/SSL.
- Apache NiFi: сбор данных, преобразование и маршрутизация. Примеры процессоров: ConsumeKafka, ConvertRecord, UpdateAttribute, PutKafka, PutFile. Настройка потоков для обработки разных источников, управление очередями и лимитами.
- Apache Airflow: оркестрация DAG’ов: задачи извлечения, транформации и загрузки; сенсоры на целевые ресурсы; планирование и повторные попытки. Примеры тасков: BashOperator, PythonOperator, SparkSubmitOperator.
- ClickHouse: архитектура хранения; партиционирование по дате; использование MergeTree-таблиц; материализованные представления для ускорения аналитических запросов; распределённые таблицы для масштабирования.
- dbt: модели в проекте dbt, источники (sources) и модели (models); тесты качества данных (schema tests); материализация (table, incremental); интеграция с ClickHouse через адаптер dbt-clickhouse.
- Data governance и lineage: DataHub/Amundsen или Apache Atlas для управления метаданными и отслеживания происхождения данных.
Пример структурной схемы конфигурации
- Источник -> DebeziumCDC -> Kafka -> NiFi -> staging PostgreSQL -> ClickHouse (LD) / Data Lake Parquet -> dbt (ELT-слой) -> аналитическая модель в ClickHouse.
- Архитектура безопасности: шифрование TLS для Kafka и NiFi, шифрование данных на диске, контроль доступа по ролям в ClickHouse и в облаке, хранение секретов через Vault или аналогичный сервис.
Концепции моделирования данных
- Star-схема vs Snowflake: для DDP часто оправдана проста структура фактов с измерениями. Однако, учитывая динамику угроз и необходимость детализации обманных сценариев, Dimensionи Snappy-архитектуры могут быть комбинированы.
- Исторические версии и SCD: управление версиями данных (SCD Type 2) полезно для отслеживания эволюции сигнала или поведения атак.
- Обогащение и внешние данные: дополнительные справочные таблицы (земельные блоки, IP-геолокация, данные об угрозах) могут обогащать аналитическую модель, но требуется контроль за сроками обновления и качеством.
Обеспечение качества, безопасности и соответствия
- Валидаторы данных на стадии ETL/ELT: проверки типа, диапазона, уникальности, согласования схем.
- Контроль версий схем и миграций: схемы и версии моделей в dbt; миграции без прерывания работы.
- Безопасность и соответствие: шифрование, аудит доступа, ограничение по ролям, соблюдение локальных правил распространения данных, минимизация чувствительной информации в журналах и дашбордах.
- Мониторинг и observability: Prometheus/Grafana для метрик конвейеров, алертинг на задержки, пропуски, ошибки; журналируемые события для аудита.
Производительность и масштабирование
- Выбор паттерна: если данные обновляются часто и нужен быстрый доступ к свежей информации, ELT на ClickHouse с параллельными загрузками и эффективной агрегацией предпочтителен.
- Масштабирование: горизонтальное масштабирование Kafka/NiFi/ClickHouse; пулы соединений и управление памятью; использование partitioning и clustering для ClickHouse.
- Оптимизация трансформаций: минимизация тяжелых трансформаций в ETL-слоях; перенос тяжёлых вычислений в ClickHouse и dbt; применение Materialized Views и предварительных агрегатов.
Риски и ограничения
1. Риск архитектурной сложности
Сложные конвейеры требуют тщательного проектирования, тестирования и мониторинга; непредвиденные изменения источников данных могут привести к задержкам и неконсистентности.
2. Задержки и задержка латентности
ETL может иметь большую задержку; ELT может обеспечить более быструю доставку, но требует мощной инфраструктуры и управления качеством данных на этапе загрузки.
3. Контроль качества и управляемость
Без должной политики качества данных могут возникнуть ошибки, которые трудно обнаружить на этапе анализа; необходимы тесты и проверки на каждом этапе.
4. Безопасность и соответствие
Обмен данными может затрагивать чувствительные данные; нужно обеспечить шифрование и строгие политики доступа; требования регуляторов (ФЗ-152, GDPR и др.) требуют документированного подхода к хранению и обработке данных.
5. Масштабирование и стоимость
Расходы на хранение и обработку крупных объемов данных могут быть значительными; следует балансировать требования к задержке и точности против затрат.
6. Зависимость от технологий
Выбор конкретных инструментов может привести к зависимостям от отдельных платформах; разумно предусмотреть гибкость и возможность миграций в будущем.
7. Риски для DDP и защитных сценариев
Неправильная конфигурация конвейера может привести к некорректной интерпретации сигналов угроз или ложным срабатываниям в рамках обманной платформы; важно тестировать сценарии на различных наборах данных и условиях.
Интеграция данных в рамках BI и DWH для Distributed Deception Platform требует баланса между скоростью обработки, качеством данных и безопасностью. ETL и ELT — это не взаимоисключающие подходы, а разные способы организации конвейеров: ETL чаще применяется там, где критично контролировать трансформации до загрузки, ELT — когда можно и нужно полагаться на мощности целевой базы и проводить вычисления внутри хранилища. В DDP особенно важно обеспечить прозрачность и прослеживаемость данных, чтобы отвлечь злоумышленников и одновременно обеспечить защиту и анализ угроз. Российские решения, такие как ClickHouse и локальные развёртывания, позволяют строить быстродействующие аналитические конвейеры в рамках локализации данных и регулятивных требований. Практические примеры показывают, что можно сочетать Open-Source инструменты (Debezium, Kafka, NiFi, Airflow, dbt) с отечественными технологиями для достижения целей BI и DWH, включая сценарии обманной защиты и мониторинга.
FAQ — Вопросы и ответы
Q1: В чем основное различие между ETL и ELT и когда применяют каждый подход в DDP?
A1: ETL выполняет преобразования в промежуточном слое перед загрузкой в хранилище, что полезно, когда требуется строгий контроль качества на ранних этапах и есть ограничение на вычисления в целевой системе. ELT загружает данные в хранилище до трансформаций и полагается на вычислительные возможности хранилища или базы данных, что подходит для больших объемов данных и современных хранилищ, где трансформации можно выполнять параллельно и эффективно. В DDP выбор зависит от требований к задержке, объему данных и доступной инфраструктуры: для быстрых трансформаций в реальном времени чаще выбирают ELT, для жесткого контроля качества — ETL.
Q2: Какие технологические компоненты чаще всего задействованы в ETL/ELT конвейерах для DDP?
A2: Типичный набор включает CDC-инструменты (Debezium), брокеры сообщений (Kafka), интеграционные платформы (Apache NiFi), оркестраторы (Apache Airflow), хранилища для аналитики (ClickHouse или другие колоночные СУБД), параллельные вычисления (Spark), а также инструментальные средства для трансформаций на этапе ELT (dbt). Метаданные и lineage часто управляются через DataHub, Amundsen или Apache Atlas.
Q3: Какие российского производства или локальные решения применимы для DDP?
A3: Российские решения включают использование ClickHouse как российского открытого хранилища для аналитики. Локальные развёртывания открытого ПО (NiFi, Airflow, Kafka, Debezium) применяются с локальными сетями и локализацией данных. Яндекс.Облако и другие отечественные сервисы предоставляют инфраструктуру для хранения, обработки и визуализации данных в РФ с учётом регулятивных требований.
Q4: Как обеспечить качество данных в условиях потока данных и изменения схем?
A4: Включайте проверки валидности данных на каждом этапе конвейера, используйте схемы и тесты в dbt (schema tests), отслеживайте данные через lineage-инструменты, применяйте версионирование схем и миграции без прерывания. Также полезны мониторинг и алертинг на пропуски, дубликаты и сдвиги схем.
Q5: Какие риски связаны с безопасностью и соответствием в DDP?
A5: Основные риски — несанкционированный доступ к данным, утечки, некорректная обработка чувствительных данных, нарушение регуляторики (локализация и хранение, требования к аудиту). Решения включают шифрование в транзите и на диске, управление доступом по ролям, аудит действий, локализацию данных и контроль за хранением секретов.
Q6: Какой подход лучше для реального времени в DDP — ETL или ELT?
A6: Для реального времени чаще применяют ELT, используя возможности хранилища (ClickHouse) для трансформаций и быстрых вычислений. Однако для некоторых критичных трансформаций до загрузки могут потребоваться ETL-подходы в отдельных фрагментах конвейера.
Q7: Какие методы мониторинга конвейеров рекомендуются в BI/DDP?
A7: Рекомендуются Prometheus/Grafana для метрик производительности и задержек, сигналы об ошибках, мониторинг очередей Kafka, статусы DAG’ов Airflow, журналирование событий в SIEM-системах, а также визуализация lineage через DataHub или Atlas.
Q8: Какой подход к моделированию данных предпочтителен для DDP?
A8: Обычно применяется звездная схема для быстрого аналитического доступа, но для детального анализа атак и обманных сценариев целесообразно поддерживать гибридную модель: факты по событиям безопасности, измерения — пользователи, устройства, источники, а также обогащение внешними справочниками и данными об угрозах.
Q9: Какие шаги следует предпринять при миграции существующего ETL-проекта в ELT-подход?
A9: Оцените текущее состояние данных, перенесите данные в целевое хранилище, адаптируйте dbt-модели под новую схему и производительность, перенастройте трансформации в хранилище, обеспечьте совместимость метаданных и lineage, проведите тестирование на согласованность и регрессию.
Q10: Какие факторы критичны для успешного внедрения ETL/ELT в DDP?
A10: Важны: четко определенная архитектура и цели интеграции, выбор инструментов, обеспечение безопасности и соответствия, наличие квалифицированной команды и план тестирования, мониторинг и поддержка инфраструктуры, а также документирование процессов и управляемость изменений.


