

Архитектура решения
Цель данной главы — дать системное видение архитектуры решения для внедрения и активного использования Process mining в компании. Мы разберем, какие слои и компоненты образуют устойчивую архитектуру, какие данные необходимы, какие инструменты можно применить — включая открытое ПО и российские решения, какие методологии стоит применять на разных стадиях проекта, где возникают риски и как их минимизировать. В современных условиях архитектура Process mining должна быть гибкой, масштабируемой и соответствовать требованиям корпоративной безопасности и законодательства о персональных данных. Мы рассмотрим не только теоретические основы, но и практику построения архитектуры на примерах реальных организаций и типичных сценариях внедрения.
Основные понятия и термины
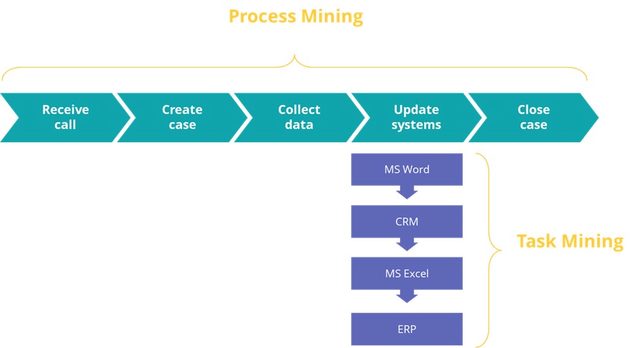
- Process mining (майнинг процессов) — это методика анализа бизнес-процессов на основе данных событий, регистрируемых в информационных системах. Цель — обнаружение реального поведения процессов, сравнение его с проектируемыми моделями, выявление отклонений и узких мест, а также предложение путей повышения эффективности.
- Event log (лог событий) — структурированная последовательность записей о событиях, которые фиксируют выполнение действий в рамках одного кейса (процесса). Типичные поля: case_id (идентификатор кейса), activity (название шага), timestamp (время выполнения), и дополнительные атрибуты (resource, cost, location и т. п.).
- Process discovery (обнаружение процесса) — создание формальной модели процесса на основе логов событий без предварительного знания о реальном процессе.
- Conformance checking (проверка конформности) — анализ совпадения поведения реального процесса с заданной моделью или нормативной схемой.
- Enhancement (улучшение) — использование дополнительной информации из логов и внешних источников для обогащения модели процесса (например, влияние ресурсов, сезонности, задержек).
- Файлы форматов: XES — стандарт для обмена логами событий; CSV/JSON — более простой, часто используемый формат для интеграции с открытым ПО.
- Методы обнаружения: Alpha Miner, Heuristics Miner, ILP-based Miner, Fitness/Precision измерения и т. д. Разные методы подходят для разных уровней сложности процессов и качества данных.
- KPI и метрики: cycle time (время цикла), throughput, bottlenecks (узкие места), variant analysis (вариантность путей), compliance (соответствие регламентам).
Архитектурные принципы
- Модульность и границы ответственности. Архитектура должна быть разделена на слои: источник данных, слой подготовки данных, движок анализа процессов, слой хранения и обработки моделей, визуализация и дашборды.
- Масштабируемость. Необходимо поддерживать рост объема данных и числа источников. Выбор технологий должен учитывать горизонтальное масштабирование (например, распределённые хранилища, параллельную обработку).
- Надежность и безопасность. Поскольку обработка включает данные операций и персональные данные, архитектура должна обеспечивать контроль доступа, шифрование, аудит и изоляцию данных.
- Гибкость интеграций. Важно иметь унифицированные коннекторы к ERP, CRM, ITSM, системам мониторинга и другим источникам событий, а также возможность подгонять логи под нужды анализа.
- Управление данными и качество данных. Включение процессов профилирования качества, очистки, стандартизации, правки времени и нормализации атрибутов.
- Учет регуляторики и локализации. В частности, требования к локализации данных, хранению персональных данных, журналированию и защите информации в рамках законодательства.
Типовая архитектура решения
- Источники данных (Data Sources): ERP (SAP, Oracle E-Business Suite, 1C:ERP), CRM (Salesforce, Microsoft Dynamics), ITSM (ServiceNow, Jira), HR-системы, лог-файлы веб-приложений, ETL/ELT-процессы, Manufacturing Execution Systems (MES).
- Слой подготовки данных (Data Ingestion и ETL/ELT): коннекторы к источникам, извлечение событий, консолидация по case_id, timestamp; очистка и верификация данных; преобразование в формат логов событий (XES/CSV); создание дополнительной информации (resources, costs).
- Хранилище данных (Data Layer): data lake (HDFS/S3/Azure Data Lake), data warehouse (Snowflake, ClickHouse, Amazon Redshift, Google BigQuery); хранение объединённых event logs и агрегатов. В российских реалиях часто применяются ClickHouse и Snowflake с локальным соблюдением политик обработки данных.
- Движок анализа процессов (Process Mining Engine): открытые инструменты (PM4Py, ProM) и коммерческие/полупрограммные решения; алгоритмы обнаружения, конформности, расширения. Этот слой может работать как локально, так и в облаке.
- Визуализация и аналитика (Presentation Layer): панели в Power BI, Tableau, Grafana; дашборды по ключевым метрикам; визуализация найденных путей, вариаций и узких мест.
- Управление данными и безопасность (Governance and Security): управление доступом (IAM, роли, SSO), шифрование (at rest, in transit), маскирование персональных данных, аудит действий, политика хранения и удаления данных.
- Инфраструктура и оркестрация: оркестрация процессов обработки и обновления моделей; управление зависимостями и расписанием через Apache Airflow или аналогичный оркестратор; мониторинг выполнения пайплайнов.
Технологические варианты и примеры реализации
- Открытое ПО (open-source): PM4Py (Python) для анализа, ProM (Java) как платформа с большим набором плагинов, Apromore (open-core) для визуализации и операций. Эти инструменты позволяют строить пайплайны: извлечение логов, применение алгоритмов обнаружения, сравнение с моделями, генерация KPI.
- Коммерческие и гибридные решения: ABBYY Timeline — российский проект, ориентированный на интеграцию с бизнес-системами, построение логов событий и визуализацию процессов; ряд крупных провайдеров BPM/BI интегрирует возможности process mining в свои платформы, что позволяет работать внутри единого экосистемы предприятия.
- Инфраструктура: для обработки больших объёмов данных часто применяют Kafka для потоковой загрузки событий, Spark или Flink для обработки и обогащения, хранение в Parquet в data lake, а затем загрузку в data warehouse для ускоренной аналитики. В качестве СУБД чаще выбирают ClickHouse (быстрые аналитические запросы в реальном времени) и облачные аналоги Snowflake/BigQuery с учётом требований локализации.
Теоретическая часть: методологии внедрения
Этапы проекта:
- Определение целей и гипотез: какие бизнес-процессы нужно исследовать, какие KPI и улучшения ожидаются.
- Сбор и подготовка данных: выбор источников, нормализация временнЫх штампов, согласование идентификаторов кейсов.
- Построение логов событий: конструкция event log в формате XES/CSV, обеспечение полноты данных.
- Аналитика процессов: применение алгоритмов обнаружения процессов, анализ конформности, выявление узких мест.
- Валидация и действия: согласование выводов с доменными экспертами, подготовка рекомендаций по улучшению.
- Мониторинг и автоматизация: создание дашбордов, настройка оповещений, повторная инжекция данных и обновление моделей. Законодательство и безопасность данных: обеспечение соответствия требованиям обработки персональных данных, минимизация доступа к чувствительным данным, аудит и журналирование операций.
Методы контроля качества данных: верификация полноты записей, согласование временных зон и временных штампов, обработка пропусков, деградация и амортизация точности.
Роли и ответственность: бизнес-аналитики, data engineers, процессные менеджеры, специалисты по информации безопасности, юридическое сопровождение.
Практические примеры
Пример 1. Обработка заявок в IT-подразделении (Incident/Service Management)
- Цель: снизить MTTR (mean time to repair) и повысить удовлетворенность клиентов.
- Источники: ServiceNow (инциденты), Jira (таски), LDAP (пользовательские профили).
- Подход: собрать лог событий по каждому инциденту (case_id = инцидент, activity = стадия, timestamp), обогатить данными о исполнителях и приоритетах. Применить Heuristics Miner для обнаружения реального потока работ, сравнить с стандартной моделью процесса обслуживания, выявить задержки на этапе назначения и эскалации. Вывести KPI: среднее время обработки, доля случаев с эскалацией, узкие места по стадии. В российской реализации можно рассмотреть интеграцию с ABBYY Timeline для визуализации и мониторинга процессов в единой панели.
Пример 2. Процесс продаж и заказа (Order-to-Cash)
- Цель: уменьшить задержки на передачу заказа в производство и повысить своевременность оплаты.
- Источники: ERP (SAP или 1C), CRM (Salesforce), MES.
- Подход: формирование event log на основе транзакций: создание заказа, утверждение, производство, отгрузка, счет, платеж. Применение Alpha Miner (для относительно чистых логов) или ILP-based Miner (для сложных процессов). Анализ узких мест: задержки на утверждении, задержки в отгрузке, несоответствия между заказом и фактическим временем выпуска. Результаты дают рекомендации по SLA, перераспределению ролей и улучшению узких мест в цепочке поставок.
Пример 3. Российские решения и локальные практики
- ABBYY Timeline: российский продукт, ориентированный на интеграцию с корпоративными системами, сбор и нормализацию логов, визуализацию путей и показателей. В кейсах ABBYY Timeline часто подчеркивают возможность работы внутри единой экосистемы, гарантию безопасности, а также поддержку локальных регуляторных требований. В рамках проекта по внедрению Process mining в российской компании Timeline может использоваться для анализа процессов в рамках финансового блока, производственных процессов и HR, с учетом локальных требований по обработке персональных данных.
- Практически в любой среде российские компании используют открытые инструменты: PM4Py и ProM для анализа, Apromore для совместной работы над процессами, а также интеграцию с локальной инфраструктурой через коннекторы к SAP, 1C, Mail и т. д. Это позволяет сохранить гибкость, снизить затраты и адаптироваться под регуляторные требования.
Архитектурное решение в деталях
Этап сборки:
- Определить ключевые источники событий и сформировать карту интеграций: какие процессы будут анализироваться, какие системы обеспечивают данные.
- Проектировать схему логов: основные поля (case_id, activity, timestamp) и дополнительные атрибуты (resource, cost, location, status, priority).
- Выбор форматов: XES для формального анализа в PM4Py/ProM; CSV/Parquet для массовой загрузки в data lake; JSON для обмена между микросервисами.
- Разработка коннекторов и пайплайнов ETL/ELT: извлечение, очистка, нормализация, обогащение.
Этап обработки:
- Построение event log и загрузка в аналитическую среду.
- Применение алгоритмов обнаружения процесса: выбор метода в зависимости от качества логов (Alpha Miner для чистых логов, Heuristics ILP для сложных).
- Проверка конформности: сравнение с эталонной моделью и вычисление показателей Fitness и Precision.
- Аналитика производительности: расчёт cycle time, bottlenecks, throughput, variant analysis.
Этап представления:
- Построение дашбордов и отчетов: KPI по процессам, карты путей, задержки, секторальную детализацию.
- Настройка оповещений: пороги на продолжительность этапов, отклонения от нормативов.
- Внедрение циклов улучшения: создание регламентов на основе выводов и внедрение изменений.
Безопасность и соответствие требованиям:
- Разграничение доступа к данным по ролям и проектам.
- Шифрование данных на уровне хранения и передачи.
- Аудит доступа и действий, журналирование событий.
- Анонимизация персональных данных и минимизация PII, если это требуется регуляторами.
Инфраструктурные варианты:
- Локальная инфраструктура: на базе корпоративного дата-центра, с использованием VM и контейнеров, надёжная сеть, VPN/Zero Trust.
- Облачные варианты: гибридный подход, где часть данных хранится локально, а анализ выполняется в приватном облаке или через облачные сервисы, соблюдающие локальные регламенты.
Технологический стек (пример):
- Источники: SAP S/4HANA, 1C:ERP, Salesforce, Jira, ServiceNow.
- Интеграция: Apache NiFi или Airbyte для извлечения данных; Kafka для потоковой передачи событий.
- Обработка и хранение: Apache Spark/Flink для обработки, Parquet в Data Lake, ClickHouse для аналитических запросов; Snowflake/BigQuery как облачная альтернатива.
- Аналитика Process mining: PM4Py (Python) и ProM (Java); Apromore как открытое решение с визуализацией и управлением процессами.
- Визуализация: Grafana, Kibana для мониторинга, Power BI/Tableau для бизнес-пользователей.
- Безопасность и управление: IAM, SSO (SAML/OAuth), LDAP, Kerberos; DLP и маскирование данных.
Производственные паттерны:
- Событые пайплайны: потоковая загрузка событий через Kafka, обработка в Spark/Flink, запись в серверный Data Lake и загрузка в Data Warehouse.
- Беклог и повторное использование: кэширование часто используемых путей и вариаций, сохранение шаблонов моделей для повторного применения.
Примеры конфигураций для типовых сценариев:
- Инцидент-менеджмент: интеграция с ServiceNow и Jira, сбор логов по инциденту, построение модели обработки и мониторинг SLA.
- Заказы и поставки: интеграция ERP и CRM, анализ цепочки Order-to-Cash, выявление задержек на этапах согласования и отгрузки, настройка алертов.
- HR-процессы: кандидаты, найм, адаптация; анализ задержек на этапе проверки, согласования и выпуска документов.
Российские особенности и локализация:
- Актуальность локальных регламентов по защите данных и кросс-юрисдикции требует правильной настройки хранения данных и контроль доступа.
- Применение отечественных решений и интеграций может облегчить соответствие требованиям локального законодательства и поддержки на рынке.
Риски и ограничения внедрения
- Неполнота и качество данных. В логах часто встречаются пропуски, неверные временные метки, дубликаты, несоответствия идентификаторов. Это может приводить к ложным выводам в моделях и неверным шагам по оптимизации.
- Сложности интеграции. Встраивание Process mining в уже существующую архитектуру требует согласования форматов, версий библиотек, совместимости коннекторов и политики безопасности между системами.
- Зависимость от инструментов. Привязка к конкретному инструменту (особенно коммерческому) несет риск зависимости от лицензий, обновлений, политики поддержки и стоимости.
- Конфиденциальность и правовые вопросы. Обработка персональных данных в рамках Process mining требует соблюдения закона, а в некоторых случаях — локализации данных и применения анонимизации.
- Недостаток компетенций. Для эффективной реализации необходимы специалисты по данным, процессному анализу и доменной сфере. Не хватает квалифицированных сотрудников может замедлить внедрение.
- Управление изменениями. Внедрение Process mining требует изменений в управлении процессами, привыкание к новым методам анализа и непрерывный цикл улучшения. Без вовлечения бизнес-заинтересованных сторон результаты окажутся недокритичными.
- Масштабируемость и стоимость. При росте объема данных может потребоваться перераспределение архитектуры, оптимизация пайплайнов и более мощное оборудование, что влечет за собой дополнительные расходы.
Архитектура решения для Process mining — это сочетание технических слоев, методологий и организационных практик. Правильно спроектированная архитектура обеспечивает сбор и обработку больших объемов данных, точную и понятную аналитику, гибкость для адаптации к изменяющимся бизнес-задачам и соответствие требованиям безопасности и регуляторики. При выборе инструментов следует учитывать сочетание открытого ПО и российских решений, чтобы обеспечить устойчивость процессов и снизить риск зависимости. Важнейшие элементы — качественные данные, интегрированные коннекторы к источникам, настраиваемые пайплайны обработки, способность генерировать и визуализировать KPI, а также надежная политика безопасности и управления доступом. В итоге Process mining становится не просто инструментом анализа, а движком, помогающим бизнесу видеть реальный путь процессов, выявлять узкие места и принимать эффективные управленческие решения.
FAQ — Вопрос–Ответ
1) Что такое Process mining и зачем нужна архитектура для него?
Process mining — это анализ бизнес-процессов на основе данных событий, которые регистрируются в информационных системах. Архитектура нужна, чтобы стабильно и безопасно собирать данные, обрабатывать их на уровне логики процесса, хранить результаты и показывать бизнес-пользователям понятные панели управления. Без четкой архитектуры риск появления «слепых зон» в данных, медленной аналитики и управленческих решений, основанных на догадках.
2) Какие данные нужны для Process mining и как их подготовить?
Основной набор: case_id, activity, timestamp и дополнительные атрибуты (resource, cost, location, status). Важны качество и полнота данных, согласованность идентификаторов и единообразие временных штампов. Подготовка включает унификацию форматов, устранение дубликатов, коррекцию временных зон и приведение данных к единым стандартам (например, по полям и кодам активности). Рекомендуется строить event log в формате XES или CSV с понятной схемой связей кейсов и действий.
3) Какие инструменты стоит рассмотреть для открытого кода и почему?
PM4Py — мощная Python-библиотека с широким набором алгоритмов обнаружения и анализа. ProM — классическая платформа с обширной экосистемой плагинов. Apromore — современная open-core платформа для совместной работы над процессами и визуализации. Они позволяют строить гибкие пайплайны обработки данных и анализировать процессы без использования платной лицензии.
4) Какие российские решения можно использовать в рамках Process mining?
ABBYY Timeline — это российский продукт, ориентированный на интеграцию с корпоративными системами, сбор и анализлогов, визуализацию путей и KPI. Он удобен для компаний, требующих локализации данных и соответствия регуляторным требованиям. В сочетании с открытым ПО можно построить полноценную архитектуру, где Timeline выступает как визуализатор и конструктор процессов, а PM4Py или ProM выполняют расчеты и анализ.
5) Какие риски обычно возникают на этапе внедрения и как их минимизировать?
Ключевые риски: плохое качество данных, нехватка квалифицированных специалистов, дорогие лицензии, сложности интеграции, вопросы безопасности данных и регуляторики. Их минимизируют через:
- раннее определение целей и вовлечение бизнес-власников;
- аудит данных и пилотный проект;
- выбор гибридной архитектуры с открытым ПО и локальными решениями;
- внедрение строгих процессов управления данными и безопасности;
- поэтапное расширение функциональности и обучение сотрудников.
6) Как выбрать архитектуру в зависимости от масштаба компании?
Для малого и среднего бизнеса достаточно локального решения с открытым ПО на одном стеке и базовым набором источников. Для крупных предприятий с большим числом источников данных и более высокими требованиями к безопасности рекомендуется гибридная архитектура: локальные узлы для критичных данных, облачные компоненты для масштабируемой аналитики, и единая платформа визуализации. В любом случае необходимо предусмотреть пайплайны ETL/ELT, консистентный формат логов и единый подход к управлению доступом.
7) Какие KPI обычно мониторят в Process mining?
Cycle time, throughput, time-to-fulfill, delay на этапах, процент вариантов процесса, доля соответствующих регламентам кейсов (compliance), частота повторяющихся ошибок, эскалации и среднее время обработки инцидентов. Дашборды должны позволять бизнес-пользователям быстро увидеть узкие места и ожидаемые эффекты от изменений в процессе.
8) Каковы шаги для начала проекта внедрения архитектуры Process mining?
- Четко определить бизнес-цели и KPI.
- Идентифицировать источники событий и координировать доступ к данным.
- Спроектировать формат логов и собрать первый набор данных.
- Выбрать набор инструментов (PM4Py/ProM/Apromore) и интегрировать их с существующей инфраструктурой.
- Построить первичные дашборды и провести пилот с узким процессом.
- Расширять анализ на другие процессы, внедрять улучшения и настраивать мониторинг.
- Обеспечить устойчивость архитектуры, безопасность и соответствие требованиям.
9) Нужно ли использовать исключительно открытое ПО?
Не обязательно. Комбинация открытого ПО и российских/локальных решений часто даёт наилучшие результаты: открытое ПО обеспечивает гибкость и прозрачность алгоритмов, в то время как российские решения, такие как ABBYY Timeline, могут предложить интеграцию с локальной инфраструктурой, соответствие регуляторике и поддержку на рынке. Выбор зависит от целей проекта, бюджета и требований к безопасности.
10) Что делать, если данные плохо структурированы или отсутствуют необходимые поля?
Начать с анализа качества данных и выявления пропусков. Возможно, потребуется внедрить дополнительные источники данных или генерацию логов событий на уровне приложений. Иногда можно обобщить данные без полного набора полей (например, использовать только case_id, activity и timestamp), но это снижает точность моделирования. В любом случае важна прозрачная коммуникация с бизнесом и доменной экспертизой по корректировке процессной модели.
Архитектура решения для внедрения Process mining в компании — это баланс между техническими возможностями, бизнес-целями и регуляторикой. При грамотном проекте она дает ясную картину реальных бизнес-процессов, позволяет обнаруживать узкие места, подсказывает, какие изменения принесут наибольшую пользу, и обеспечивает устойчивый цикл улучшения. В сочетании с открытым ПО и российскими решениями можно достичь высокой гибкости, снижения затрат и надёжности, а также соблюдения требований безопасности и локализации данных. Продуманная архитектура — это ключ к тому, чтобы Process mining стал постоянным инструментом менеджмента, а не одноразовым проектным занятием.


