

Введение в Task Mining: цели и контекст бизнеса
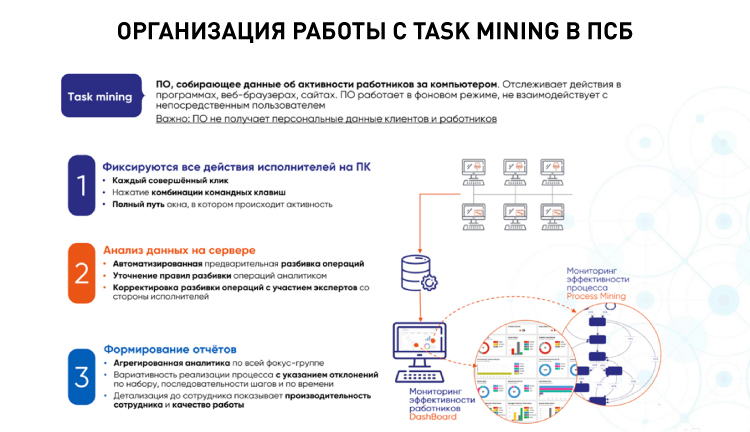
Task mining, или майнинг задач, — это направление в области анализа процессов, которое фокусируется на выявлении и описании того, какие конкретные задачи выполняют сотрудники в своей повседневной работе, какие шаги они проходят, какие инструменты используются и какие задержки возникают между действиями. В отличие от классического процессного майнинга, который чаще опирается на логи систем и бизнес-операций, task mining добавляет плотное изучение отдельных задач и ручных действий, которые иногда не попадают в системные журналы. Это позволяет увидеть не только глобальный поток процессов, но и микрозадачи, которые составляют эти потоки и которые часто являются источниками задержек и неэффективности.
Цели введения и применения task mining в компании просты и понятны. Во-первых, задача состоит в том, чтобы понять реальный, а не предполагаемый способ выполнения рабочих задач: какие шаги реально выполняются сотрудниками, в каких последовательностях, где часто происходят повторяющиеся действия, какие шаги требуют переключения между системами, какие административные или повторяющиеся действия можно автоматизировать. Во-вторых, goal-oriented применение task mining дает основу для оптимизации и автоматизации: выявление слабых звеньев, типичных «узких мест» и неэффективностей, которые при последовательной работе приводят к экономии времени, снижению ошибок и повышению удовлетворенности сотрудников. В-третьих, анализ задач помогает оценить воздействие изменений в инструментарии и процессах: как новые интерфейсы, новые шаблоны документов или новые политики влияют на рабочий ритм сотрудников и время выполнения задач.
Определения и контекст
Task mining — это сбор и анализ данных о взаимодействии человека с рабочей средой, с целью реконструировать акты деятельности на уровне задач, а не только на уровне событий в ERP или CRM. В рамках теории task mining сочетаются подходы из дисциплин: человеческо-компьютерного взаимодействия, анализа рабочих практик, процессного майнинга и data science. Главная идея — превратить фрагменты повседневной деятельности в моделируемые задачи и потоки, чтобы затем построить улучшенные сценарии работы и пути к автоматизации.
Основные термины
В рамках курса мы используем следующие определения:
- задача (task) — конкретный единичный элемент работы, который завершается одним или несколькими действиями и имеет цель, требующую использования инструментов и информационных систем.
- активность (activity) — физическое или цифровое действие сотрудника: заполнение формы, нажатие кнопки, копирование данных, создание отчета.
- путь задачи (task path) — последовательность действий, которые реализуют задачу от начала до окончания.
- поток работы (workflow) — совокупность задач, связанных между собой в рамках бизнес-процесса.
- данные о взаимодействии (interaction data) — данные, полученные из инструментов пользователя: клики, набор текста, переключения между окнами, тайминги, используемые приложения.
- event log (лог событий) — структурированная запись последовательности действий, часто используемая в процессном майнинге; в task mining может нарастать из разных источников в рамках одной задачи.
- конвейер обработки (data pipeline) — набор этапов сбора, очистки, нормализации и анализа данных, превращающих сырые данные в пригодные для моделирования форматы.
Методологии и подходы
В теории task mining существуют два базовых подхода к сбору данных:
- пассивный мониторинг взаимодействий пользователя на рабочих местах без активного вмешательства сотрудника, с соблюдением этических норм и согласий;
- активная инструментальная запись, когда пользователь соглашается на дополнительный сбор данных, например через специальные плагины или приложения-помощники, которые фиксируют клики и шаги. Сочетание этих подходов даёт более полную картину, но требует продуманной политики приватности и прозрачности по отношению к сотрудникам.
Процесс постановки задачи и цели проекта
Прежде чем начать сбор данных, необходимо определить бизнес-цели проекта:
- какие конкретно задачи мы хотим понять и оптимизировать;
- какие показатели хотим улучшить: время цикла, количество ошибок, повторяемость действий, нагрузку на сотрудников;
- какие системные ограничения и риски предусматриваются, например приватность, юридические ограничения и защита данных;
- какой уровень детализации необходим — от микро-до макроуровня задач.
Ключевые принципы анализа. В теоретическом плане стоит опираться на принципы воспроизводимости и валидности данных: использовать multiple data sources для верификации путей задач; проводить кросс-проверку выводов через интервью и наблюдения; избегать ложных выводов за счет учета контекста задач и вариативности действий в разных командах.
Практические примеры
Пример 1. Обработка заявок в сервисном центре
Цель проекта — уменьшить время обработки заявки и повысить качество обслуживания. Сбор данных осуществляется за счет активной фиксации действий оператора и взаимодействий с системами поддержки: CRM, база знаний, система тикетов. Результаты показывают, что основная задержка возникает между открытием тикета и первым ответом, когда оператор переключается между несколькими окнами и копирует данные из одного документа в другой. После анализа путей задач выявлены повторяющиеся шаги и ручные операции, которые можно автоматизировать: авто-подстановка полей, автоматическое извлечение данных из писем и документов, ускорение процесса ответов. В рамках проекта была внедрена небольшая роботизированная автоматизация на уровне RPA для автоматического заполнения шаблонов и переноса данных между системами. Эффект — сокращение общего времени обработки на 25–40% в зависимости от типа тикета и сложности.
Пример 2. Обработка счетов поставщиков (Accounts Payable)
Задача состоит в том, чтобы ускорить процесс обработки счетов, минимизировать ошибки и снизить задержки платежей. Task mining здесь выявляет, что значительную часть времени занимает документная работа: распознавание счетов, сверка реквизитов, ручной ввод данных в ERP. Практическая реализация включает сбор событий по всем этапам обработки: сканирование, распознавание, сверка соответствий, утверждения, платеж. Применение открытых инструментов и локальных решений позволило внедрить правила классификации документов и автоматическую маршрутизацию, что снизило временной цикл на 30–50% и уменьшило количество ошибок по данным до минимальных допусков. В числе практических шагов — настройка правил в OpenCV и OCR-подходах, затем интеграция с PM4Py и Apromore для обнаружения оптимизированных путей.
Пример 3. HR onboarding и административные процедуры
В рамках задачи выявить как правило, какие системные шаги и документы требуются для успешного прохождения новичком всех этапов адаптации. Анализ показал, что основная задержка связана с задержками согласования между отделами и дублированием документов. Внедрены меры по упрощению схем согласования и созданию шаблонов, автоматизации уведомлений и загрузки документов в единый контур. Результатом стал сокращенный срок адаптации сотрудника и снижение нагрузки на HR-менеджеров.
Источники данных и форматирование
Task mining опирается на несколько типов источников данных:
- локальные взаимодействия пользователя на рабочих местах: клики, набор текста, переключения окон, время активного взаимодействия;
- логи приложений и систем: ERP, CRM, HRIS, документ-обменники;
- данные из RPA-решений и журнала действий автоматизированных задач;
- метаданные документов и форм, которые обрабатываются в процессе.
На практике используются форматы и инструменты:
- форматы событий: XES (экспериментальный и общеупотребимый формат для логов процессов) или простые CSV/JSON представления событий;
- инструменты: PM4Py (Python-пакет для анализа процессов и преобразования логов), ProM (платформа с большим набором плагинов для поведения и моделирования процессов), Apromore (open-source edition и коммерческие версии), а также коммерческие решения, включая ABBYY Timeline и локальные интеграции;
- интеграция с внутренними системами и 1C:Enterprise, SAP и другими ERP-системами.
Техническая архитектура
Обычно архитектура task mining включает:
- сбор данных: агрегация данных из разных источников с учётом согласий сотрудников и требования к приватности;
- трансформация и нормализация: согласование форматов, привязка к единым идентификаторам задач и сотрудников;
- хранение и обработка: создание централизованного хранилища событий или дистрибутивной архитектуры;
- анализ и визуализация: применение алгоритмов майнинга задач и построение моделей путей задач, визуализация в виде диаграмм и карт процессов;
- корректировки и внедрение: подготовка рекомендаций, проектирование улучшений и внедрение изменений в рабочую практику.
Образцы инструментов и практических решений
Open-source и независимые решения:
- PM4Py — мощная библиотека Python для анализа процессов, включает конвертацию логов, алгоритмы майнинга пути задач, ограничения и метрики;
- ProM — рамочная платформа с большим набором плагинов для моделирования и анализа процессов, полезна для экспериментов и демонстраций;
- Apromore Community Edition — открытая версия платформы для анализа процессов, поддерживает discovery, conformance и enhancement этапы;
- Open-source решения в связке: PM4Py + Apromore для полного цикла: от логов до визуализации и оптимизации.
Российские и локальные решения и примеры внедрения:
- ABBYY Timeline — крупный коммерческий продукт с поддержкой процесса майнинга, в российской среде известен как инструмент, ориентированный на глубинный анализ операций, интеграцию с локальными системами и аудит; предоставляет функционал для отслеживания и моделирования потоков, а также элементы task mining в рамках общей экосистемы ABBYY;
- локальные внедрения и адаптации под российские СНС и регуляторику часто реализуются в рамках крупных корпораций: банки, производственные компании и госструктуры, где требуется соответствие требованиям по данности и конфиденциальности; такие внедрения обычно включают интеграцию с 1C, SAP или локальными ERP и модулями документооборота;
- в рамках курсов и практики мы предлагаем использовать ABBYY Timeline как пример коммерческого варианта и рассмотреть сценарии миграции на открытые инструменты (PM4Py, ProM, Apromore) для сравнения функциональности, стоимости и скорости внедрения.
Риски и ограничения внедрения
Этические и правовые аспекты
Сбор данных о действиях сотрудников предполагает вопросы приватности и согласия. Нужно обеспечить:
- информированное согласие и прозрачность;
- ограничение доступа к чувствительным данным и возможность ананонимизации;
- согласование with internal policies и законов о защите персональных данных;
- ограничение объема и длительности хранения данных, а также обеспечение безопасной передачи и хранения.
Точность и репрезентативность
- Task mining зависит от охвата данных и корректности интерпретации путей задач. Риск связанный с « Hawthorne effect» — поведение сотрудников может измениться из-за наблюдения, что может искажать результаты. Важно сочетать данные мониторинга с интервью и контекстуальным наблюдением.
Качество данных и интеграции
- Источники данных часто разрознены: логи приложений, локальные клики, распознавание документов, данные из RPA. Это создает сложности по синхронизации, нормализации и устранению конфликтов. Плохое качество данных приводит к неверным выводам и может обеднить планы по автоматизации.
Время и стоимость внедрения
- Внедрение task mining требует времени на настройку инфраструктуры, согласование политик доступа, выбор инструментов и пилот. В рамках проекта следует оценить общую стоимость владения, включая лицензии, инфраструктуру, квалифицированный персонал и время на обучения сотрудников.
Ограничения по техническим возможностям
- Некоторые задачи и действия не отражаются полноценно в журналах или логах, что может приводить к частичным выводам. В отдельных случаях потребуется активное участие сотрудников, интервью и наблюдение для дополняющего контекста.
Риски, связанные с изменениями в работе
- Рекомендации task mining предполагают изменения в рабочих процессах и возможную автоматизацию. Важно планировать управление изменениями, обучающие программы и поддержку сотрудников, чтобы избежать сопротивления и снижения вовлеченности.
Task mining позволяет глубже понять повседневную работу сотрудников, выявлять узкие места и потенциальные возможности для автоматизации и оптимизации. Важно сочетать тщательную техническую реализацию с этическими и управленческими аспектами: политика приватности, согласия сотрудников, прозрачность проекта и качественный сбор данных. Эффективное внедрение требует продуманной методологии: сбора данных, верификации путей задач, построения моделей и формирования плана действий, включая пилотные проекты, оценку эффекта и распространение лучших практик по всей организации. Выводы и результаты должны подтверждаться как аналитическими моделями, так и наблюдениями со стороны сотрудников, чтобы обеспечить достоверность и устойчивость изменений. Технические детали повторяются здесь в целях практической доступности. Ниже приведены конкретные шаги и рекомендации, которые можно применять на практике:
- определить набор бизнес-целей и ожидаемые улучшения (время цикла, качество, удовлетворенность клиентов, расходы на обработку);
- выбрать источники данных и согласовать политику приватности и защиты персональных данных;
- собрать и нормализовать логи и клики из разных систем;
- применить открытые инструменты (PM4Py, ProM, Apromore) для Discovery и Path Analysis;
- использовать коммерческие продукты (например ABBYY Timeline) для комплексной поддержки, если есть требования к локализации, поддержке и интеграциям;
- провести пилот на одном бизнес-подразделении, затем масштабировать на остальные;
- разработать план улучшений и автоматизации на основе полученных путей задач;
- внедрить изменения и обучить сотрудников, уделяя внимание восприятию изменений.
FAQ — Вопрос–Ответ
1) Что такое Task Mining и чем он отличается от Process Mining?
Task mining фокусируется на выявлении и анализе отдельных задач и действий сотрудников в рамках их повседневной работы, включая взаимодействия с интерфейсами и инструментами. Process mining изучает потоки и логи бизнес-процессов на уровне событий и потоков в системах. Task mining дополняет process mining, предоставляя детальные данные на уровне задач, что позволяет точнее понять причины задержек и подготовить эффективные меры для автоматизации.
2) Какие данные нужны для Task Mining и как обеспечить приватность?
Нужны данные о взаимодействии пользователя с системами: клики, набор текста, переключения окон, данные из логов приложений и документов. Приватность обеспечивается через информирование сотрудников, получение согласия, анонимизацию персональных данных, минимизацию сборов и ограничение доступа к чувствительным данным. Важно соблюдать регуляторные требования и внутренние политики компании.
3) Какие этапы проекта Task Mining и сколько времени занимает внедрение?
Типичный цикл: постановка целей, сбор согласий, выбор инструментов, создание инфраструктуры, сбор данных, обработка и нормализация, анализ путей задач, формирование рекомендаций, пилот, масштабирование. Время зависит от масштаба и готовности инфраструктуры; пилот обычно занимает 4–12 недель, полный цикл внедрения — несколько месяцев.
4) Какие преимущества можно ожидать?
Преимущества включают сокращение времени обработки задач, уменьшение ошибок, повышение эффективности сотрудников, улучшение качества обслуживания, обнаружение дублирующих действий и узких мест, а также создание основы для целенаправленной автоматизации.
5) Какие риски наиболее важны и как их минимизировать?
Важные риски: проблемы приватности, ограниченное качество данных, неточности вывода, сопротивление сотрудников, зависимость от конкретного инструмента, сложности интеграций. Минимизация достигается через четкую политику приватности, участие сотрудников, пилотирование, мультиданные источники и независимый аудит результатов.
6) Какие инструменты можно использовать (open-source и российские решения)?
Open-source: PM4Py, ProM, Apromore Community Edition. Российские решения: ABBYY Timeline как коммерческий продукт с поддержкой локализации и интеграциями; сочетание открытых инструментов с коммерческими решениями позволяет гибко управлять затратами и функциональностью. Также можно рассматривать локальные интеграции с 1C и ERP-системами для полного цикла.
7) Как интерпретировать результаты и переходить к автоматизации?
Результаты должны быть представлены в понятной форме: карты путей задач, типовые сценарии, узкие места, статистика времени по шагам. Затем формируется набор процессов для автоматизации, приоритизация на основе ROI, пилотные проекты и поэтапный переход к внедрению RPA и бот-действий, а также мониторинг эффекта после внедрения.
8) Как оценивать экономическую эффективность проекта?
Оценка должна включать прямые эффекты (сокращение времени обработки, уменьшение ошибок, снижение затрат) и косвенные эффекты (повышение удовлетворенности клиентов, снижение текучести сотрудников). Важна постановка KPI на старте, регулярная его пересмотр и сопоставление реальных результатов с целями проекта.
9) Как организовать управление изменениями и обучение сотрудников?
Необходимо заранее планировать коммуникацию, обучающие программы, поддержку и участие сотрудников в процессе изменений. Внедрять новые процессы постепенно, использовать пилоты и чек-листы, обеспечивать обратную связь, а также демонстрировать быстрые победы, чтобы создать позитивную динамику изменений.
10) Какие стандарты и метрики использовать?
Метрики могут включать: среднее время цикла задачи, долю автоматизированных шагов, долю ошибок, частоту повторяющихся действий, показатели удовлетворенности клиентов, время простоя систем и уровень соответствия нормативам. Важно обеспечить совместимость метрик с бизнес-целями и корректную интерпретацию в рамках контекста задач.
Введение в Task Mining — важный шаг на пути к более прозрачно функционирующей организации, где можно не только видеть, как работают люди, но и предложить конкретные улучшения и автоматизацию там, где они действительно необходимы. При соблюдении этических принципов и правильной методологии, task mining становится мощным инструментом для повышения эффективности, качества обслуживания и устойчивого роста бизнеса.


