

Стратегии загрузки данных: COPY, внешние таблицы, GPFDW
Добро пожаловать в главу, в которой мы детально разберём три базовых направления загрузки данных в Greenplum: COPY, внешние таблицы через gpfdist, а также использование Greenplum Foreign Data Wrapper (GPFDW) для интеграции с внешними источниками. Выходные данные этой главы пригодятся как новичку, так и специалисту, заносующему данные в крупное аналитическое хранилище. Мы начнём с теории, затем перейдём к практическим примерам и завершим разбором рисков и ограничений с рекомендациями по обходу проблем.
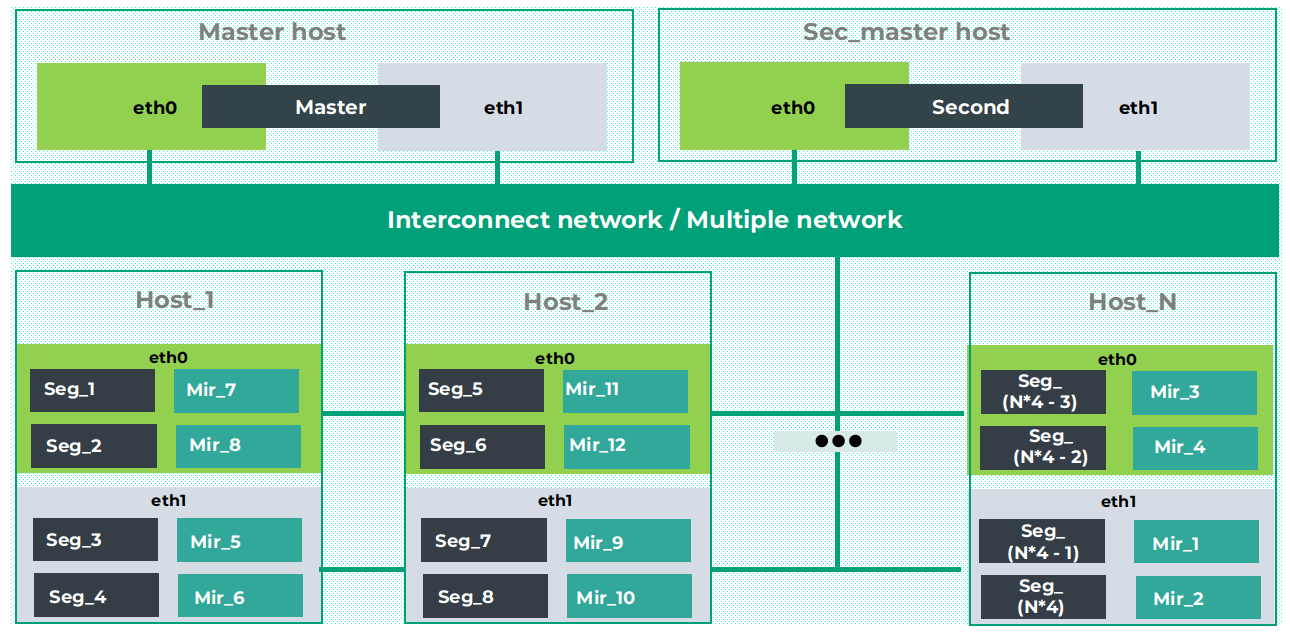
- Что мы понимаем под загрузкой данных в контексте Greenplum
- Основные подходы: COPY, внешние таблицы, GPFDW
- Когда применим каждый метод: сценарии нагрузки, частота обновления, требования к нижеуровневой обработке
Термины и концепции
- ETL vs ELT: различия в обработке на входных данных и целевой системе
- COPY: атомарная операция загрузки/выгрузки данных между файловой системой и таблицей
- Внешние таблицы (EXTERNAL TABLE): данные остаются вне базы, читаются по требованию с помощью внешних источников
- gpfdist: распределённый загрузчик файлов, входной поток для внешних таблиц в Greenplum
- GPFDW (Greenplum Foreign Data Wrapper): механизм подключения к внешним источникам данных через расширение, позволяющий выполнять запросы к удалённым источникам и подтягивать данные
- gpload: инструмент для пакетной загрузки с конфигурацией YAML
- Open-source коннекторы и российские подходы: какие инструменты применяются в индустрии
Каковы принципы производительности при загрузке
- Масштабирование через параллелизм: COPY и внешние таблицы поддерживают параллельную загрузку на сегменты
- Распределение данных: правильная настройка датапартейнинг/распределения (DISTRIBUTED BY) и strategy
- Влияние форматов файлов: CSV, DELIM, QUOTE, JSON, Parquet (через внешние инструменты)
- Валидация и консистентность: проверки на уровне файлов, валидаторы схем, тестовые выборки
- Безопасность и аудит: шифрование, хранение учётных данных, ограничение доступа
Архитектурные паттерны для загрузки
- Полная загрузка (full load) через COPY
- Инкрементальная загрузка (CDC) с использованием временных таблиц и MERGE-подобной логики
- Комбинации COPY + внешние таблицы: чтение из внешнего источника и загрузка в целевую таблицу
- Микробатчинг и шлюзы через GPFDW: объединение локальных и удалённых данных для анализа
Практические примеры
Пример 1. Загрузка локального CSV в Greenplum с помощью COPY
- Сценарий: ежедневная загрузка файла sales.csv в схему public
- Предпосылки: файл доступен на файловой системе управляющего узла (или на разделе, доступном всем сегментам)
- Команды:
COPY public.sales (id, product_id, amount, sale_date)
FROM '/data/loads/sales.csv'
WITH (FORMAT csv, HEADER true, DELIMITER ',', NULL '', QUOTE '"', ENCODING 'UTF8')
LOG ERRORS INTO public.load_errors ROWS 1000 REJECT LIMIT 10000;
Комментарии:
- COPY в Greenplum может использовать параллелизм на сегментах, что ускоряет загрузку по сравнению с обычным INSERT
- Вынос ошибок в отдельную таблицу позволяет продолжать загрузку и затем анализировать проблемные строки
- Важно гарантировать совместимость типов между CSV и целевой схемой
Пример 2. Внешние таблицы через gpfdist для чтения больших CSV
Сценарий: чтение больших файлов, хранящихся на файловой системе, без копирования целиком в базу Шаги:
- Запуск gpfdist на узлах, где лежат CSV-файлы
- Определение внешней таблицы и её формата
- Загрузка в целевую таблицу через INSERT INTO … SELECT …
Команды:
-- Создаём внешнюю таблицу, читающую CSV через gpfdist
CREATE EXTERNAL TABLE ext_sales (
  id int,
  product_id int,
  amount numeric(10,2),
  sale_date date
)
LOCATION ('gpfdist://host1:8081/sales.csv')
FORMAT 'CSV' (HEADER 'true', DELIMITER ',')
LOG ERRORS INTO public.load_errors ROWS 1000 REJECT LIMIT 5000;

-- Загружаем данные в целевую таблицу
INSERT INTO public.sales (id, product_id, amount, sale_date)
SELECT id, product_id, amount, sale_date
FROM ext_sales;
Комментарии:
- External table сохраняет данные во внешнем файле, а Greenplum читает их во время запроса
- gpfdist обеспечивает параллельную загрузку; можно масштабировать путем размещения файлов на нескольких узлах
- Внешние таблицы полезны для временной агрегации, предобработки и прямого переноса данных в целевые таблицы
Пример 3. Использование GPFDW для доступа к удалённой PostgreSQL и объединение данных
Сценарий: агрегировать данные продаж из локального Greenplum и удалённой базы PostgreSQL
Шаги:
- Установка расширения GPFDW
- Определение сервера и пользователя
- Создание внешней таблицы, соответствующей удалённой таблице
- Выполнение запроса с объединением
Команды (пример еждуёмного уровня, абстрактные параметры):
-- 1) Установка расширения
CREATE EXTENSION IF NOT EXISTS gpfdw;

-- 2) Создание сервера удалённой БД
CREATE SERVER remote_pg
  FOREIGN DATA WRAPPER gpfdw
  OPTIONS (host 'remote.example.ru', port '5432', dbname 'remote_db');

-- 3) Пользовательская сопоставление (для простоты примера)
CREATE USER MAPPING FOR current_user
  SERVER remote_pg
  OPTIONS (user 'remote_user', password 'secure_pass');

-- 4) Создание внешней таблицы, отражающей удалённую таблицу
CREATE FOREIGN TABLE remote_public.remote_sales (
  id int,
  customer_id int,
  amount numeric(12,2),
  sale_date date
)
SERVER remote_pg
OPTIONS ( schema_name 'public', table_name 'sales' );

-- 5) Объединение данных
INSERT INTO public.sales (id, customer_id, amount, sale_date)
SELECT r.id, r.customer_id, r.amount, r.sale_date
FROM remote_public.remote_sales r
JOIN local_dim.customer c ON r.customer_id = c.id;
Комментарии:
- GPFDW позволяет выполнять запросы к внешним источникам данных и подтягивать данные непосредственно в Greenplum
- Стоит внимательно настроить сетевые параметры, тайм-ауты и параметры безопасности
- Производительность зависит от удалённого источника и возможностей FDW; иногда полезно сначала выгружать частичные данные во внешнюю таблицу, затем объединять в локальной БД
Пример 4. Глянцевый сценарий с gpload (пакетная загрузка)
Сценарий: регулярная пакетная загрузка из множества файлов в одну целевую таблицу
YAML-конфигурация для gpload:
loaders:
  - name: "load_sales"
    table: "public.sales"
    action: "insert"
    source:
      - path: "/data/loads/*.csv"
        format: "csv"
        header: true
        delimiter: ","
    header_file: false
    log: "/var/log/gpload_sales.log"
    reject_limit: 10000
    max_file_size: "2G"
Команды запуска:
gpfdist? (в зависимости от конфигурации)
gpload -f /etc/gpload/load_sales.yaml
Комментарии:
- gpload позволяет централизовать управление загрузкой через один конфигурационный файл
- Параметры rechazие и размер файлов позволяют ограничить риск ошибок и быстро отклонить проблемные файлы
- В реальных сценариях можно комбинировать gpload с внешними таблицами на этапе подготовки
Производительность и настройка параллелизма
- COPY поддерживает параллелизм на уровне сегментов; размер параллелизма определяется числом сегментов и параметрами ресурсов
- Внешние таблицы через gpfdist позволяют масштабировать чтение массива файлов; можно создать несколько внешних таблиц и объединить данные
- GPFDW: производительность зависит от сети, latency и пропускной способности удалённого источника; оптимизация включает настройку параллелизма, пакетной обработки и фильтров на стороне источника
Безопасность и управление доступом
- Хранение учётных данных: использовать учетные данные в безопасном хранилище или в конфигурации FDW с ограниченным доступом
- Шифрование транспорта: TLS для сетевых соединений
- Аудит и журналирование: логирование операций COPY, загрузки через gpload, доступа к внешним источникам
Соответствие форматов и типов
- CSV и JSON: корректная обработка типов (date, timestamp, numeric)
- Переход между типами: явные приведения типов при загрузке
- Внешние таблицы: поддержка различных форматов, включая CSV, Parquet (через внешние инструменты), JSON
Мониторинг и диагностика
- Мониторинг скорости загрузки и задержек на gpfdist
- Логи gpload, логи COPY и логи внешних таблиц
- Метрики Greenplum: wal sender/receiver, GPU, CPU, disk I/O
Резервирование и миграции
- Порядок восстановления: репликация источника к Greenplum, резервные копии целевых таблиц
- Миграционные сценарии: постепенная миграция через временные внешние таблицы и этапы merged load
Риски и ограничения
Риски, связанные с данными
- Несоответствие схем, неверные типы данных при загрузке
- Потери данных при откате при параллельной загрузке
- Несогласованность между источниками при CDC
Риски производительности
- Блокировки на целевых таблицах во время больших загрузок
- Непредсказуемое влияние удалённых источников на скорость загрузки через GPFDW
- Файловые внешние таблицы зависят от сетевых задержек
Ограничения GPFDW и внешних таблиц
- Не все источники поддерживают pushdown фильтров на уровне FDW
- Внешние таблицы обычно не поддерживают транзакции в полном объёме; важно проектировать загрузку без ожидания ACID для внешних данных
- В некоторых версиях Greenplum ширина поддержки форматов и коннекторов ограничена
Безопасность и соответствие требованиям
- Хранение учетных данных в скриптах и YAML-файлах требует надёжной политики управления секретами
- Внешние источники могут иметь разные политики доступа и обновления, что требует мониторинга
Архитектурные альтернативы и компромиссы
- Эффективная стратегия: комбинирование COPY для массовой загрузки и внешних таблиц для предварительной обработки
- Включение GPFDW для удалённых источников целесообразно, если нужно минимизировать перенос данных и поддерживать консистентность между системами
- В случае необходимости строгой консистентности можно рассмотреть микроархитектуру CDC в рамках ETL/ELT
Выводы
- COPY, внешние таблицы и GPFDW — три взаимодополняющих подхода к загрузке данных в Greenplum
- COPY обеспечивает быструю пакетную загрузку и простые сценарии транзакционной загрузки
- Внешние таблицы через gpfdist дают гибкость при работе с большими файловыми источниками без полного копирования данных
- GPFDW позволяет интегрировать внешние источники данных и объединять их данные с локальными таблицами для анализа
- В реальной системе часто применяют гибридные стратегии: массовая загрузка через COPY, предварительная обработка через внешние таблицы и доступ к дополнительным источникам через GPFDW
- Важно учитывать риски: согласованность данных, требования к сетевым ресурсам, безопасность и мониторинг
- Оптимальная архитектура зависит от конкретной функциональности источников данных, требований к задержкам, объёма загрузок и уровня консистентности
FAQ (Вопрос–Ответ)
1) В чём основное отличие COPY от внешних таблиц в Greenplum?
- COPY — это внутренняя операция загрузки данных из файлового источника непосредственно в целевую таблицу или выгрузки из неё. Она очень быстра и эффективна для больших партий данных, но требует доступа к файлу на локальном или сетевом хосте. Внешние таблицы — это способ читать данные напрямую из внешних источников (файлы, gpfdist, удалённые БД) без физического копирования в таблицу; данные читаются во время запроса. Это полезно для периодических выборок и унификации источников, но может быть медленнее по сравнению с прямой загрузкой на сегменты.
2) Что такое gpfdist и как он работает в контексте внешних таблиц?
- gpfdist — это распределённый загрузчик файлов, который предоставляет данные внешним таблицам Greenplum. Он запускается на узлах, где хранятся файлы, и предоставляет данные сегментам через сетевой протокол. Внешние таблицы читают данные через gpfdist, что позволяет параллельно обрабатывать большие файлы и не копировать данные в базу.
3) Какие сценарии особенно подходят для GPFDW?
- Когда требуется интеграция с внешними источниками данных (например, удалённые PostgreSQL/Oracle/MySQL базы) и объединение их данных с локальными таблицами для анализа. GPFDW позволяет выполнять JOIN-операции между локальными и удалёнными таблицами и получать цельное представление данных, не копируя их постоянно.
4) Какие риски существуют при использовании внешних таблиц и GPFDW?
- Потоки данных зависят от сети; при сбоях соединения загрузка может быть прервана.
- Внешние источники могут не поддерживать все функции SQL или фильтры на уровне FDW; не всегда возможно pushdown-оптимизация
- Транзакционная гарантия может быть ограничена, особенно при чтении внешних источников во время параллельной загрузки
- Безопасность учетных данных и доступ к внешним источникам требует внимательного управления секретами и политиками доступа
5) Какой подход выбрать для российского рынка и интеграций с локальными источниками?
- Часто в российской практике применяется гибридная модель: массовая загрузка через COPY для локальных файлов/периодических выгрузок из отечественных систем (например, 1С) и внешние таблицы для работы с большими файлами на сетевых хранилищах. Для интеграции с удалёнными источниками можно использовать GPFDW или открытые коннекторы с локализованной настройкой безопасности. В любом случае важно обеспечить консистентность данных и тщательно тестировать сценарии восстановления.
6) Какие примеры российских решений можно использовать на практике?
- Российские компании часто экспортируют данные из локальных систем (например, 1С) в CSV/JSON и затем загружают их в Greenplum через COPY или внешние таблицы. Для интеграции с удалёнными источниками применяются открытые коннекторы PostgreSQL (postgres_fdw) или GPFDW, а также внутренние консалтинговые решения, адаптированные под требования безопасности и локальные регуляторные требования. В реальных проектах часто используется централизованный ETL/ELT-подход с пакетной загрузкой, логированием ошибок и мониторингом загрузок.
7) Какие шаги стоит предпринять для начала работы с COPY и внешними таблицами в Greenplum?
- Определите требования к задержкам и частоте загрузки
- Оцените источники данных: локальные файлы, сетевые хранилища, удалённые БД
- Настройте gpfdist и убедитесь в сетевой доступности
- Создайте внешние таблицы для чтения данных и тестируйте их на небольших выборках
- Выберите стратегию параллелизма и настройте параметры COPY
- При необходимости внедрите gpload для пакетной загрузки
- Рассмотрите возможность использования GPFDW для интеграции с удалёнными источниками и создание SQL-join запросов
- Обеспечьте безопасность и мониторинг загрузок
8) Как обеспечить безопасность учётных данных при использовании GPFDW и внешних таблиц?
- Храните креды в секрет-менеджере или использовании безопасных хранилищ, а не в явном виде в скриптах
- Используйте ограниченные роли и минимальные привилегии
- Включайте TLS для сетевых соединений
- Включайте аудит доступа и хранение логов
9) Какие книги и статьи можно порекомендовать для углубления знаний по COPY и внешним таблицам?
- Классические руководства PostgreSQL по COPY и внешним таблицам
- Документация Greenplum по GPFDW и external tables
- Обзоры по gpload и параллельной загрузке в Greenplum
- Обзоры по современным паттернам ETL/ELT в контексте больших данных
10) Где найти примеры конфигураций и кодовые примеры?
- Официальная документация Greenplum и примеры по COPY, gpfdist, external tables и GPFDW
- Репозитории с открытым исходным кодом, демонстрирующие загрузку CSV через external tables
- Примеры корпоративных проектов и открытые кейсы по интеграции с удалёнными источниками
Надеюсь, данная глава поможет вам понять концепции загрузки данных в Greenplum и выбрать оптимальные стратегии под ваши реальные задачи. Важно помнить, что конкретный выбор инструментов и параметров зависит от вашего объема данных, источников, требований к задержкам и доступности сетевых ресурсов. Экспериментируйте на тестовом окружении, постепенно добавляйте новые источники и внедряйте мониторинг, чтобы обеспечить надёжную и эффективную загрузку данных в ваше аналитическое хранилище.


