

Оркестрация пайплайнов: Airflow и альтернативы
Оркестрация пайплайнов — это glue между различными этапами обработки данных: сбором данных, их качеством, трансформациями и загрузкой в целевые хранилища. В контексте внедрения хранилища на основе Greenplum это особенно критично: Greenplum отлично справляется с хранением и обработкой больших объемов данных, но без хорошо архитектурной оркестрации конвейеры становятся «разрозненными» и трудно масштабируемыми. Эта глава посвящена тому, как выбрать подходящие инструменты и как строить устойчивые, безопасные и эффективные конвейеры для загрузки и обновления данных в Greenplum, какие альтернативы существуют помимо Airflow, какие паттерны применяются на практике, и какие риски следует учитывать.
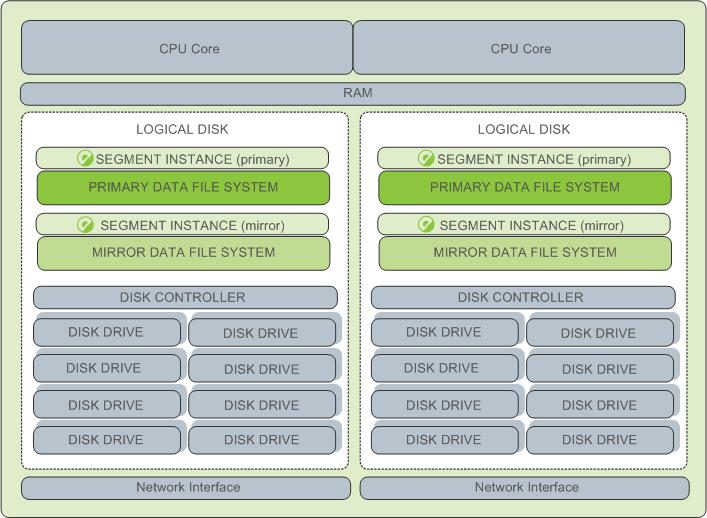
Что именно мы покроем:
- базовые концепции оркестрации пайплайнов и их связь с архитектурой Greenplum;
- ключевые термины и паттерны (DAG, таски, операторы, сенсоры, XCom и т.д.);
- обзор инструментов: Airflow и альтернативы, включая преимущественные сценарии использования;
- практические примеры: реальные DAGи и примеры кода по загрузке данных в Greenplum;
- технические детали: безопасность, мониторинг, управление версиями DAG, обработка сбоев и идемпотентность;
- риски и ограничения внедрения;
- выводы и ответы на часто задаваемые вопросы.
Что такое оркестрация пайплайнов
Оркестрация пайплайнов — это управление зависимостями между задачами, расписанием, повторяемостью и обработкой ошибок в конвейерах данных. В контексте хранилища на основе Greenplum она включает конфигурацию и управление задачами по извлечению, трансформации и загрузке данных (ETL/ELT), мониторинг исполнения и автоматическую реакцию на сбои.
Ключевые концепции:
- DAG (Directed Acyclic Graph) — направленный ациклический граф, который описывает зависимости между задачами и их порядок выполнения.
- задача/оператор (task/operator) — элемент, который выполняет конкретную операцию: выполнение SQL, запуск Python-скрипта, вызов внешнего API, перенос файла и т. п.
- сенсор (sensor) — задача-блокировщик, которая ожидает наступления определенного условия (например, доступность файла или завершение загрузки в S3).
- хук/соединение (hook/connection) — абстракция для доступа к внешним системам (базы данных, файловым хранилищам, очередям и т. д.).
- XCom — механизм обмена данными между задачами.
- SLA и мониторинг — гарантии на время выполнения и механизмы оповещения в случае нарушения.
- идемпотентность — способность повторного выполнения задачи без повышения риска повреждения данных.
Архитектуры оркестрации
Существует несколько распространённых архитектурных подходов к оркестрации Пайплайнов:
- Одноранговая централизованная оркестрация (напр. Airflow, Dagster, Prefect) — единая система планирования и выполнения конвейеров, связанная с центральной БД метаданных.
- Локальная/разнесённая оркестрация (гибридные подходы) — часть задач может исполняться локально, часть — в облаке или на отдельных сервисах, с использованием очередей и событий.
- Событийно-ориентированная оркестрация (event-driven) — реагирование на события из источников данных (например, новые файлы в S3, обновление таблиц в источниках) и триггеры задач по событиям.
Для Greenplum чаще встречаются подходы с централизованной оркестрацией, где конвейеры включают этапы извлечения из источников, подготовку и загрузку в staging- или целевые схемы Greenplum, а затем трансформации в самой БД или на уровне сервиса.
Термины и их роль в процессе
- DAG (Directed Acyclic Graph): граф зависимостей задач; определяет порядок выполнения и параллелизм.
-
Operator/Task: конкретная единица работы. В Airflow много готовых операторов, например:
- PostgresOperator: выполняет SQL в базе данных PostgreSQL/Greenplum.
- PythonOperator: запускает произвольный Python-код.
- BashOperator: запускает Bash-команды.
- FileSummaryOperator, TransferOperator — примеры из экосистемы.
- Sensor: ждёт наступления условия, например “файл появился” или “предыдущий таск завершён”.
- Hook/Connection: хранение конфигурации доступа к внешним системам (хост, порт, пользователь, пароль, TLS и пр.).
- XCom: механизм обмена данными между тасками.
- Backfill: повторный прогон DAG для пропущенных дат.
- SLA: целевые сроки исполнения задач; уведомления в случае нарушения.
- Idempotence: повторяемое повторное выполнение без побочных эффектов.
- ETL vs ELT: традиционное извлечение, трансформация и загрузка данных (ETL) против выгрузки и затем трансформаций внутри БД (ELT). Greenplum хорошо подходит для ELT-подхода: вытаскиваем данные в staging, затем используем мощности GP для трансформаций.
Обзор инструментов: Airflow и альтернативы
- Airflow: главный герой главы. Архитектура с веб-интерфейсом, планировщиком (scheduler), исполнителем (executor) и метаданными в БД. Хорошо подходит для сложных DAG-ов, поддерживает множество операторов и интеграций, заслужил широкую экосистему и документацию на русском сообществе. Поддерживает различные исполнители: LocalExecutor, CeleryExecutor, KubernetesExecutor и др. В контексте Greenplum — легко реализовать сценарии загрузки и трансформаций через PostgresOperator и PythonOperator; можно использовать цепочки задач с чтением/загрузкой в GPDB.
- Dagster: фреймворк для конвейеров, ориентированный на типовую безопасность, тестируемость и императивно-декларируемые политик слоев. Подходит для команд, которым важны строгие контракты между частями конвейера, типизация входных/выходных параметров и богатая работа с ресурсами. Примеры: solids (задачи) и pipelines (конвейеры) с явной зависимостью от ресурсов.
- Prefect: современная альтернатива с акцентом на удобство разработки и мониторинга, Flow-оригентированный подход и понятная модель задач. Prefect 2.x отличается “imperative” стилем конфигурации и упрощёнными возможностями для отображения статуса выполнения.
- Apache NiFi: ориентирован на поточные данные и интеграцию источников/приёмников через графический интерфейс. Хорошо подходит для потоков, где данные непрерывно приходят, например, из файловых систем, очередей или потоков потокового анализа. Менее удобен для сложной логики транзакций внутри Greenplum, но отличный выбор для входной/выходной загрузки.
- Oozie: устаревшее решение, чаще встречающееся в Hadoop-экосистеме. В новых проектах обычно вытесняется более современными альтернативами, но в старыx инфраструктурах можно встретить его использование.
- Российские/open-source подходы: в отечественном рынке встречаются локализованные дистрибуции и сервисы, которые базируются на открытых проектах (Airflow, Dagster, NiFi и др.) и адаптируются под требования российского регуляторного окружения, локальные репозитории, аудит и секреты на русском языке, интеграцию с отечественными решениями и облаками. В этой части важно подчеркнуть, что отечественные SI-партнёры часто предлагают готовые решения на базе популярных инструментов, адаптированные под локальные требования по безопасности, сетевой инфраструктуре и сертификации. Практически это значит: можно использовать Airflow/Dugster/Prefect с локализацией и поддержкой российского рынка, а также выбирать коммерческие продукты, которые интегрируются с отечественными системами идентификации, секьюрности и аудита.
Таблица: сравнение инструментов оркестрации
| Платформа | Тип | Язык разработки | Архитектура | Поддержка задач/операторов | Мониторинг/UI | Kubernetes/облачная поддержка |
|---|---|---|---|---|---|---|
| Airflow | Централизованный оркестратор | Python | Scheduler + Executor + Web UI | Богатый набор операторов; легко расширяется | Богатый UI, метрики и SLA | Хорошо поддерживает KubernetesExecutor и managed services |
| Dagster | Оркестрация с типизированными конвейерами | Python | Структурированный граф компонентов | Типизированные solids и ресурсы | Встроенная диагностика и тесты | Хорошо работает в Docker/Kubernetes |
| Prefect | Flow-ориентированная оркестрация | Python | Асинхронная/событийная модель | Простые паттерны для задач; динамические зависимости | Характеристики мониторинга через UI/CLI | Поддержка облачных решений и локального развёртывания |
| Apache NiFi | Потоковая обработка и интеграция | Java | Потоки данных в UI | Прямой конвейер потоков; сосредоточен на данных | Визуальный конструктор потоков | Хорошая интеграция с потоковыми источниками |
| Oozie | Hadoop-ориентированная оркестрация | XML/JVM | Планировщик задач | Традиционная интеграция с Hadoop/HDFS | Минимальный UI по сравнению с Airflow | Востребован в старых Hadoop-окружениях |
Практические примеры
Ниже представлены два практических примера: один на Airflow с загрузкой в Greenplum, второй — концептуальный конвейер на Dagster. Также приведены идеи по интеграции с российского рынка в рамках локализации и аудита.
Пример 1: DAG в Airflow для загрузки данных в Greenplum
Цель: взять файлы CSV из S3/облачного хранилища, преобразовать минимально и загрузить в staging-таблицу Greenplum, затем выполнить простое преобразование внутри GPDB и загрузить итоговую таблицу.
Ключевые моменты:
- Использование PostgresOperator для выполнения SQL в Greenplum.
- Использование PythonOperator для предварительной подготовки данных и загрузки через копирование локального файла в GPDB.
- Настройки разрешений и коннекшенов.
Код DAG (пример, упрощённый):
from datetime import timedelta, datetime
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.operators.postgres_operator import PostgresOperator
from airflow.hooks.postgres_hook import PostgresHook
import psycopg2
import pandas as pd
import io

# Конфигурация DAG
default_args = {
    'owner': 'data-eng',
    'depends_on_past': False,
    'email_on_failure': False,
    'retries': 1,
    'retry_delay': timedelta(minutes=15),
}
dag = DAG(
    'gp_load_csv_to_staging',
    default_args=default_args,
    description='Load CSV data to Greenplum staging and transform to final table',
    schedule_interval='0 2 * * *',  # ежедневное выполнение в 02:00
    start_date=datetime(2024, 1, 1),
    catchup=False,
)

# Таск: скачать файл (пример, сойдемся на локальном копировании или через Hook)
def fetch_csv_from_source(**kwargs):
    # Здесь может быть загрузка через S3Hook или аналогичный
    # Для примера – создадим локальный CSV-файл временно на таске
    df = pd.DataFrame({'id': [1,2,3], 'value': [10, 20, 30]})
    path = '/tmp/data.csv'
    df.to_csv(path, index=False)
    return path

def load_to_gp_staging(**kwargs):
    ti = kwargs['ti']
    csv_path = ti.xcom_pull(task_ids='fetch_csv')
    # Соединение с Greenplum
    gp_hook = PostgresHook(postgres_conn_id='gp_connection')
    conn = gp_hook.get_conn()
    cur = conn.cursor()
    # Создаем staging-таблицу, если нужно
    cur.execute("""
        CREATE TABLE IF NOT EXISTS staging.public.source_data (
            id int,
            value int
        )
    """)
    conn.commit()
    # Вставляем данные через COPY (путь к локальному файлу виден_gp-серверам)
    with open(csv_path, 'r') as f:
        cur.copy_expert("COPY staging.public.source_data FROM STDIN WITH (FORMAT csv, HEADER true)", f)
    conn.commit()

fetch_task = PythonOperator(
    task_id='fetch_csv',
    python_callable=fetch_csv_from_source,
    dag=dag,
)

load_task = PythonOperator(
    task_id='load_to_staging',
    python_callable=load_to_gp_staging,
    dag=dag,
)

transform_task = PostgresOperator(
    task_id='transform_to_final',
    postgres_conn_id='gp_connection',
    sql="""
        INSERT INTO analytics.public.final_table (id, value_sum)
        SELECT id, SUM(value) as value_sum
        FROM staging.public.source_data
        GROUP BY id
        ON CONFLICT (id) DO UPDATE SET value_sum = EXCLUDED.value_sum;
    """,
    autocommit=True,
    dag=dag,
)

# Зависимости
fetch_task >> load_task >> transform_task
Ключевые моменты кода:
- Коннекшн 'gp_connection' следует определить в Airflow через Admin/Connections (host, port, dbname, user, password).
- Таск fetch_csv может заменить реальную загрузку данных из источника (S3, HTTP, FTP).
- Таск load_to_gp_staging использует PostgreHook и copy_expert для загрузки в staging. Это требует, чтобы файл был доступен нодам Greenplum (например, через сетевую шару или gpfdist).
- Таск transform_to_final выполняет SQL в GPDB для агрегации и загрузки в финальную таблицу.
Советы по практическому внедрению:
- Отложенная загрузка и идемпотентность: если DAG повторно запустится, дублирования можно избежать с помощью уникальных ключей и устранив повторные вставки через UPSERT.
- Мониторинг: используйте SLA, уведомления в Slack/Email; записывайте детальные логи в XCom.
- Безопасность: храните подключения в зашифрованном виде; используйте Secrets Backend (HashiCorp Vault, AWS Secrets Manager и пр.).
Пример 2: Dagster-пайплайн для той же задачи
Dagster позволяет декларативно объявлять задачи и ресурсы, с тестируемостью и выводом с контекстной информацией. Ниже — упрощённый пример.
from dagster import job, op, In, Out, Field
import pandas as pd
import psycopg2

@op(out={"rows": Out(pd.DataFrame)})
def fetch_source(context) -> pd.DataFrame:
    df = pd.DataFrame({"id":[1,2,3],"value":[10,20,30]})
    return df

@op(ins={"df": In(pd.DataFrame)})
def stage_to_gp(context, df: pd.DataFrame) -> None:
    with psycopg2.connect(host="gp_host", dbname="gpdb", user="gp_user", password="gp_pwd") as conn:
        df.to_csv('/tmp/df.csv', index=False)
        with open('/tmp/df.csv', 'r') as f:
            cur = conn.cursor()
            cur.copy_expert("COPY staging.public.source_data FROM STDIN WITH (FORMAT csv, HEADER true)", f)
            conn.commit()

@op
def transform_gp(context) -> pd.DataFrame:
    # В этом примере можно вернуть данные для дальнейшей загрузки или записать напрямую
    return pd.DataFrame({"id":[1,2,3], "value_sum":[10,20,30]})

@job
def gp_etl_job():
    df = fetch_source()
    stage_to_gp(df)
    transform_gp()

# Чтобы запустить: dagster run
На практике Dagster позволяет:
- писать тесты для каждого шага;
- определять ресурсы (соединение к GPDB и к облачному хранилищу);
- отслеживать статусы и артефакты;
- визуализировать графики выполнения.
Пример 3: краткий обзор интеграции и российских решений
- Open-source инструменты: Airflow, Dagster, Prefect — имеют продвинутые сообщества и обширную документацию на русском языке (сообщества в Telegram, в чате StackOverflow на русском, статьи на Хабрахабре и др.).
-
Российские решения: в отечественном рынке часто встречаются локализованные версии практик оркестрации, готовые к развёртыванию в частном облаке или на отечественном оборудовании, с усиленными функциями аудита и соответствием требованиям регуляторов. Это включает:
- локализацию UI/документации;
- локальные механизмы секретов и идентификации;
- аудит действий и журналирование;
- интеграцию с отечественными облачными и сетевыми сервисами. Практически это означает, что можно выбрать Airflow или Dagster и задействовать российского вендора/консультанта для адаптации под требования аудитных и регуляторных практик.
Архитектура развёртывания и конфигурации
-
Один из ключевых выборов — тип Executor в Airflow:
- LocalExecutor: простой, подходит для небольших окружений.
- CeleryExecutor: масштабируемость через воркеры, подходит для больших конвейеров.
- KubernetesExecutor: динамическое масштабирование под нагрузку в Kubernetes.
- В контексте Greenplum разумно использовать Celery или Kubernetes Executor для параллельной загрузки и обработки.
- База метаданных: Airflow хранит метаданные DAG и состояния в БД (PostgreSQL, MySQL и т. п.). Для высокой доступности стоит рассмотреть репликацию БД и резервное копирование.
Безопасность и управляемость
- RBAC в Airflow 2.x позволяет ограничить доступ к DAG-у и задачам на уровне пользователей и ролей.
- Secrets backends: интеграция с Vault, AWS Secrets Manager, Azure Key Vault — для безопасного хранения учетных данных и ключей.
- Шифрование соединений и секретов: стоит использовать TLS/SSL для соединений с GPDB; ограничивать сетевой доступ к GPDB через VPC/VPN.
- Контроль доступа к данным: настройка политик на уровне RBAC и ограничение доступа к чувствительным данным в рамках конкретных DAG.
Мониторинг и observability
- Метрики: используйте Prometheus для сбора метрик из Airflow (COALESCE, scheduler, executor, DAG runs). Grafana — для визуализации.
- Логи: централизованный сбор логов (ELK/EFK стэк или Loki) для анализа ошибок и аудита.
- SLA/оповещение: настройка уведомлений при превышении SLA по задачам, через Slack, Teams или Email.
- Трассировка: при сложной обработке — добавляйте в задачи явные логи и попытки повторов, чтобы быстро локализовать проблемы.
Управление версиями DAG и миграциями
- Хранение DAG-скриптов в системе контроля версий (Git) и автоматический деплой новых версий в окружение.
- В Airflow: поддержка “Safe mode” и Rollback через версионирование DAG-файлов.
- В Dagster можно тестировать конвейеры локально, использовать локальные ресурсы, и затем деплоить в прод.
Работа с Greenplum
- Greenplum совместим с PostgreSQL API, поэтому большинство операторов PostgreSQL (PostgresOperator) и функций psycopg2 работают без изменений.
-
Оптимизация загрузки:
- Разделение больших файлов на части (partitioning) и параллельная загрузка в staging.
- Использование COPY FROM STDIN для больших объёмов.
- Учет параллелизма для GPDB, чтобы не перегружать сегменты.
- Трансформации: часть логики выполняется внутри GPDB, используя возможности распределённой обработки, чтобы минимизировать передачу данных между системами.
Риски и ограничения
- Сложность поддержания больших DAG: множество зависимостей может сделать код непредсказуемым и сложным для отладки. Практика: модульность DAG, разделение задач по типам; тестирование на уровне unit/integration.
- Неидеальная идемпотентность: повторные запуски могут создавать дубликаты данных. Решение: использовать уникальные ключи, UPSERT-логика, вести версионность данных.
- Зависимость от внешних сервисов: если источник данных перестал отвечать или сеть недоступна — конвейер может застрять. Решение: сенсоры с тайм-аутами, повторные попытки, стратегии backoff.
- Стоимость поддержания инфраструктуры: вычислительные ресурсы, хранение логов, мониторы и резервное копирование требуют бюджета и команды.
- Безопасность и соответствие требованиям: необходимо прочное управление секретами, аудит действий пользователей, соответствие регуляторным требованиям (GDPR, локальные требования к архивам и т. д.).
- Тенденции в экосистеме: переход на облачные managed-сервисы (Cloud Composer, Dagster Cloud, Prefect Cloud) может снизить операционные расходы, но потребовать миграции существующих DAG и адаптации к новой модели.
- Русификация и локализация: поддержка документации на русском языке может быть ограничена по сравнению с англоязычными материалами; важно иметь локального консультанта или команду, которая сможет адаптировать инструкции под локальные правила.
Выводы
- Оркестрация пайплайнов — ключевой элемент устойчивой инфраструктуры данных, особенно в контексте Greenplum, где ресурсы БД можно максимально эффективно использовать именно через ELT-подход: загружаем данные в GPDB и выполняем трансформации внутри самой базы.
- Airflow остаётся одним из самых важных инструментов на рынке за счёт богатой экосистемы, активного сообщества и гибкости. Однако альтернативы, такие как Dagster и Prefect, предлагают другие подходы к разработке, тестированию и мониторингу пайплайнов.
- Практическая реализация требует внимания к безопасности, мониторингу, версионированию DAG и устойчивости к сбоям. В рамках российских реалий целесообразно рассмотреть локализацию и поддержку отечественными партнёрами и сервис-провайдерами, чтобы обеспечить соответствие требованиям регуляторов и локальной инфраструктуры.
- Внедряя оркестрацию, важно держать в фокусе дизайн-решения, которое позволяет масштабироваться по объему данных и числу источников, оставаясь управляемым и безопасным.
FAQ (Вопросы и ответы)
1) Что такое DAG и зачем он нужен в оркестрации пайплайнов?
- DAG — Directed Acyclic Graph, то есть граф зависимостей без циклов. Он описывает, какие таски выполняются в каком порядке, какие зависимости существуют между ними и сколько параллельно может быть обработано. Это позволяет планировать сложные конвейеры и обеспечивать устойчивость к сбоям.
2) Какие преимущества даёт использование Airflow для Greenplum?
- Airflow предоставляет богатую экосистему операторов и сенсоров, гибкую архитектуру, инструментальные средства для мониторинга и управления версиями DAG, а также возможность легко масштабировать выполнение через Celery/Kubernetes. Для Greenplum это означает удобную интеграцию через PostgresOperator и возможность переносить логику трансформаций внутрь GPDB (ELT).
3) В чем основные различия между Airflow, Dagster и Prefect?
- Airflow фокусируется на планировании и выполнении DAG и имеет широкую экосистему операторов. Dagster делает упор на типизированные конвейеры, тестируемость и детерминированность. Prefect ориентирован на удобство разработки и мониторинга, часто предлагая более простой старт и современный UX. Выбор зависит от команды, требований к тестированию и желаемой модели разработки.
4) Как организовать безопасность и управление доступом в оркестрации?
- Используйте RBAC в Airflow, Secrets Backend (Vault, AWS Secrets Manager), TLS/SSL для соединений с GPDB, ограничение сетевого доступа. В Dagster и Prefect также можно настроить роли и доступ на уровне пользователей и ресурсов. Важна политика минимальных привилегий и аудит действий.
5) Какие риски есть при внедрении оркестрации?
- Сложность поддержания больших DAG, риск дублирования данных при повторном запуске, зависимость от внешних сервисов, операционные затраты и вопросы безопасности. Рекомендации: разделение DAG на модульные части, обеспечение идемпотентности, настройка SLA и мониторинга, использование резервного копирования и аудита.
6) Какие практические советы по загрузке в Greenplum через оркестратор?
- Разделяйте конвейер на staging и final-загрузку, используйте COPY FROM STDIN для больших файлов, применяйте UPSERT в GPDB, публикуйте данные в GPDB локально или через gpfdist, чтобы минимизировать сетевые проблемы. Мониторьте выполненные задачи и правильно настраивайте retry/backoff.
7) Каковы плюсы использования российской локализации или отечественных решений?
- Локализация документации и интерфейса под русский язык, поддержка локальных регламентов по аудиту и безопасности, интеграция с отечественными системами идентификации и секретов, соответствие требованиям к хранению данных в рамках локальных облаков. Это снижает риски соответствия и упрощает внедрение для крупных российских организаций.
8) Как выбрать между Airflow и NiFi для конкретного проекта?
- Если задача требует сложной логики транзакций, больших DAG и возможной поддержки кода на Python — Airflow. Для непрерывной потоковой передачи и интеграции с большим количеством источников через визуальный конструктор и потоки данных — NiFi. Некоторые проекты пользуются комбинацией: NiFi для входной/выходной потоков и Airflow для планирования и бизнес-логики.
9) Как обеспечить устойчивость конвейера к сбоям?
- Включайте повторные запуски с экспоненциальным backoff, используйте сенсоры для ожидания внешних условий, применяйте идемпотентные операции, храните критический статус в БД, используйте SLA и уведомления, тестируйте DAG на тестовых данных.
10) Нужно ли использовать облачные управляемые сервисы для оркестрации?
- Не обязательно. Управляемые сервисы упрощают эксплуатацию, обеспечивают автошкалу и быстрое внедрение, но могут иметь ограничения по гибкости и стоимости. В крупных организациях часто применяется гибридный подход: часть конвейеров — в управляемых сервисах, часть — на собственном стеке с полной настройкой под регуляторные требования.
Вышеизложенное предоставляет как теоретическую базу, так и практические примеры с открытыми инструментами и подходами к локализации в отечественных условиях. Это поможет обучающимся и сотрудникам понять, как эффективно строить и поддерживать оркестрацию пайплайнов для Greenplum, минимизируя риски и максимизируя производительность конвейеров.


