

Определение формата ИИ‑ассистента и роли
Современная практика внедрения ИИ‑ассистентов в бизнес‑процессы строится на четком понимании того, какой формат взаимодействия и какие роли должен выполнять такой ассистент. Это касается не только технической реализации, но и организационных аспектов: какие задачи возглавляет ИИ, как он взаимодействует с сотрудниками, какими данными оперирует, как обеспечивается безопасность и соответствие регламентам. В этой главе мы определим концепцию формата ИИ‑ассистента и его роли в компании, опишем теоретическую базу и предложим практические примеры реализации на open‑source и российских платформах, а также рассмотрим риски и ограничения внедрения.
Мы разберём следующие вопросы:
- Что именно называют ИИ‑ассистентом в корпоративной среде?
- Какие форматы взаимодействия существуют и чем они отличаются?
- Какие роли может занимать ИИ‑ассистент в отделах и бизнес‑процессах?
- Какие архитектуры и паттерны применяются для реализации эффективного и безопасного ИИ‑ассистента?
- Каковы практические примеры реализации на открытых и российских решениях?
- Какие риски и ограничения нужно учитывать на разных стадиях проекта?
Во вводной части обозначим ключевые концепции и термины, чтобы читатель мог без труда перейти к практическим примерам и деталям внедрения.
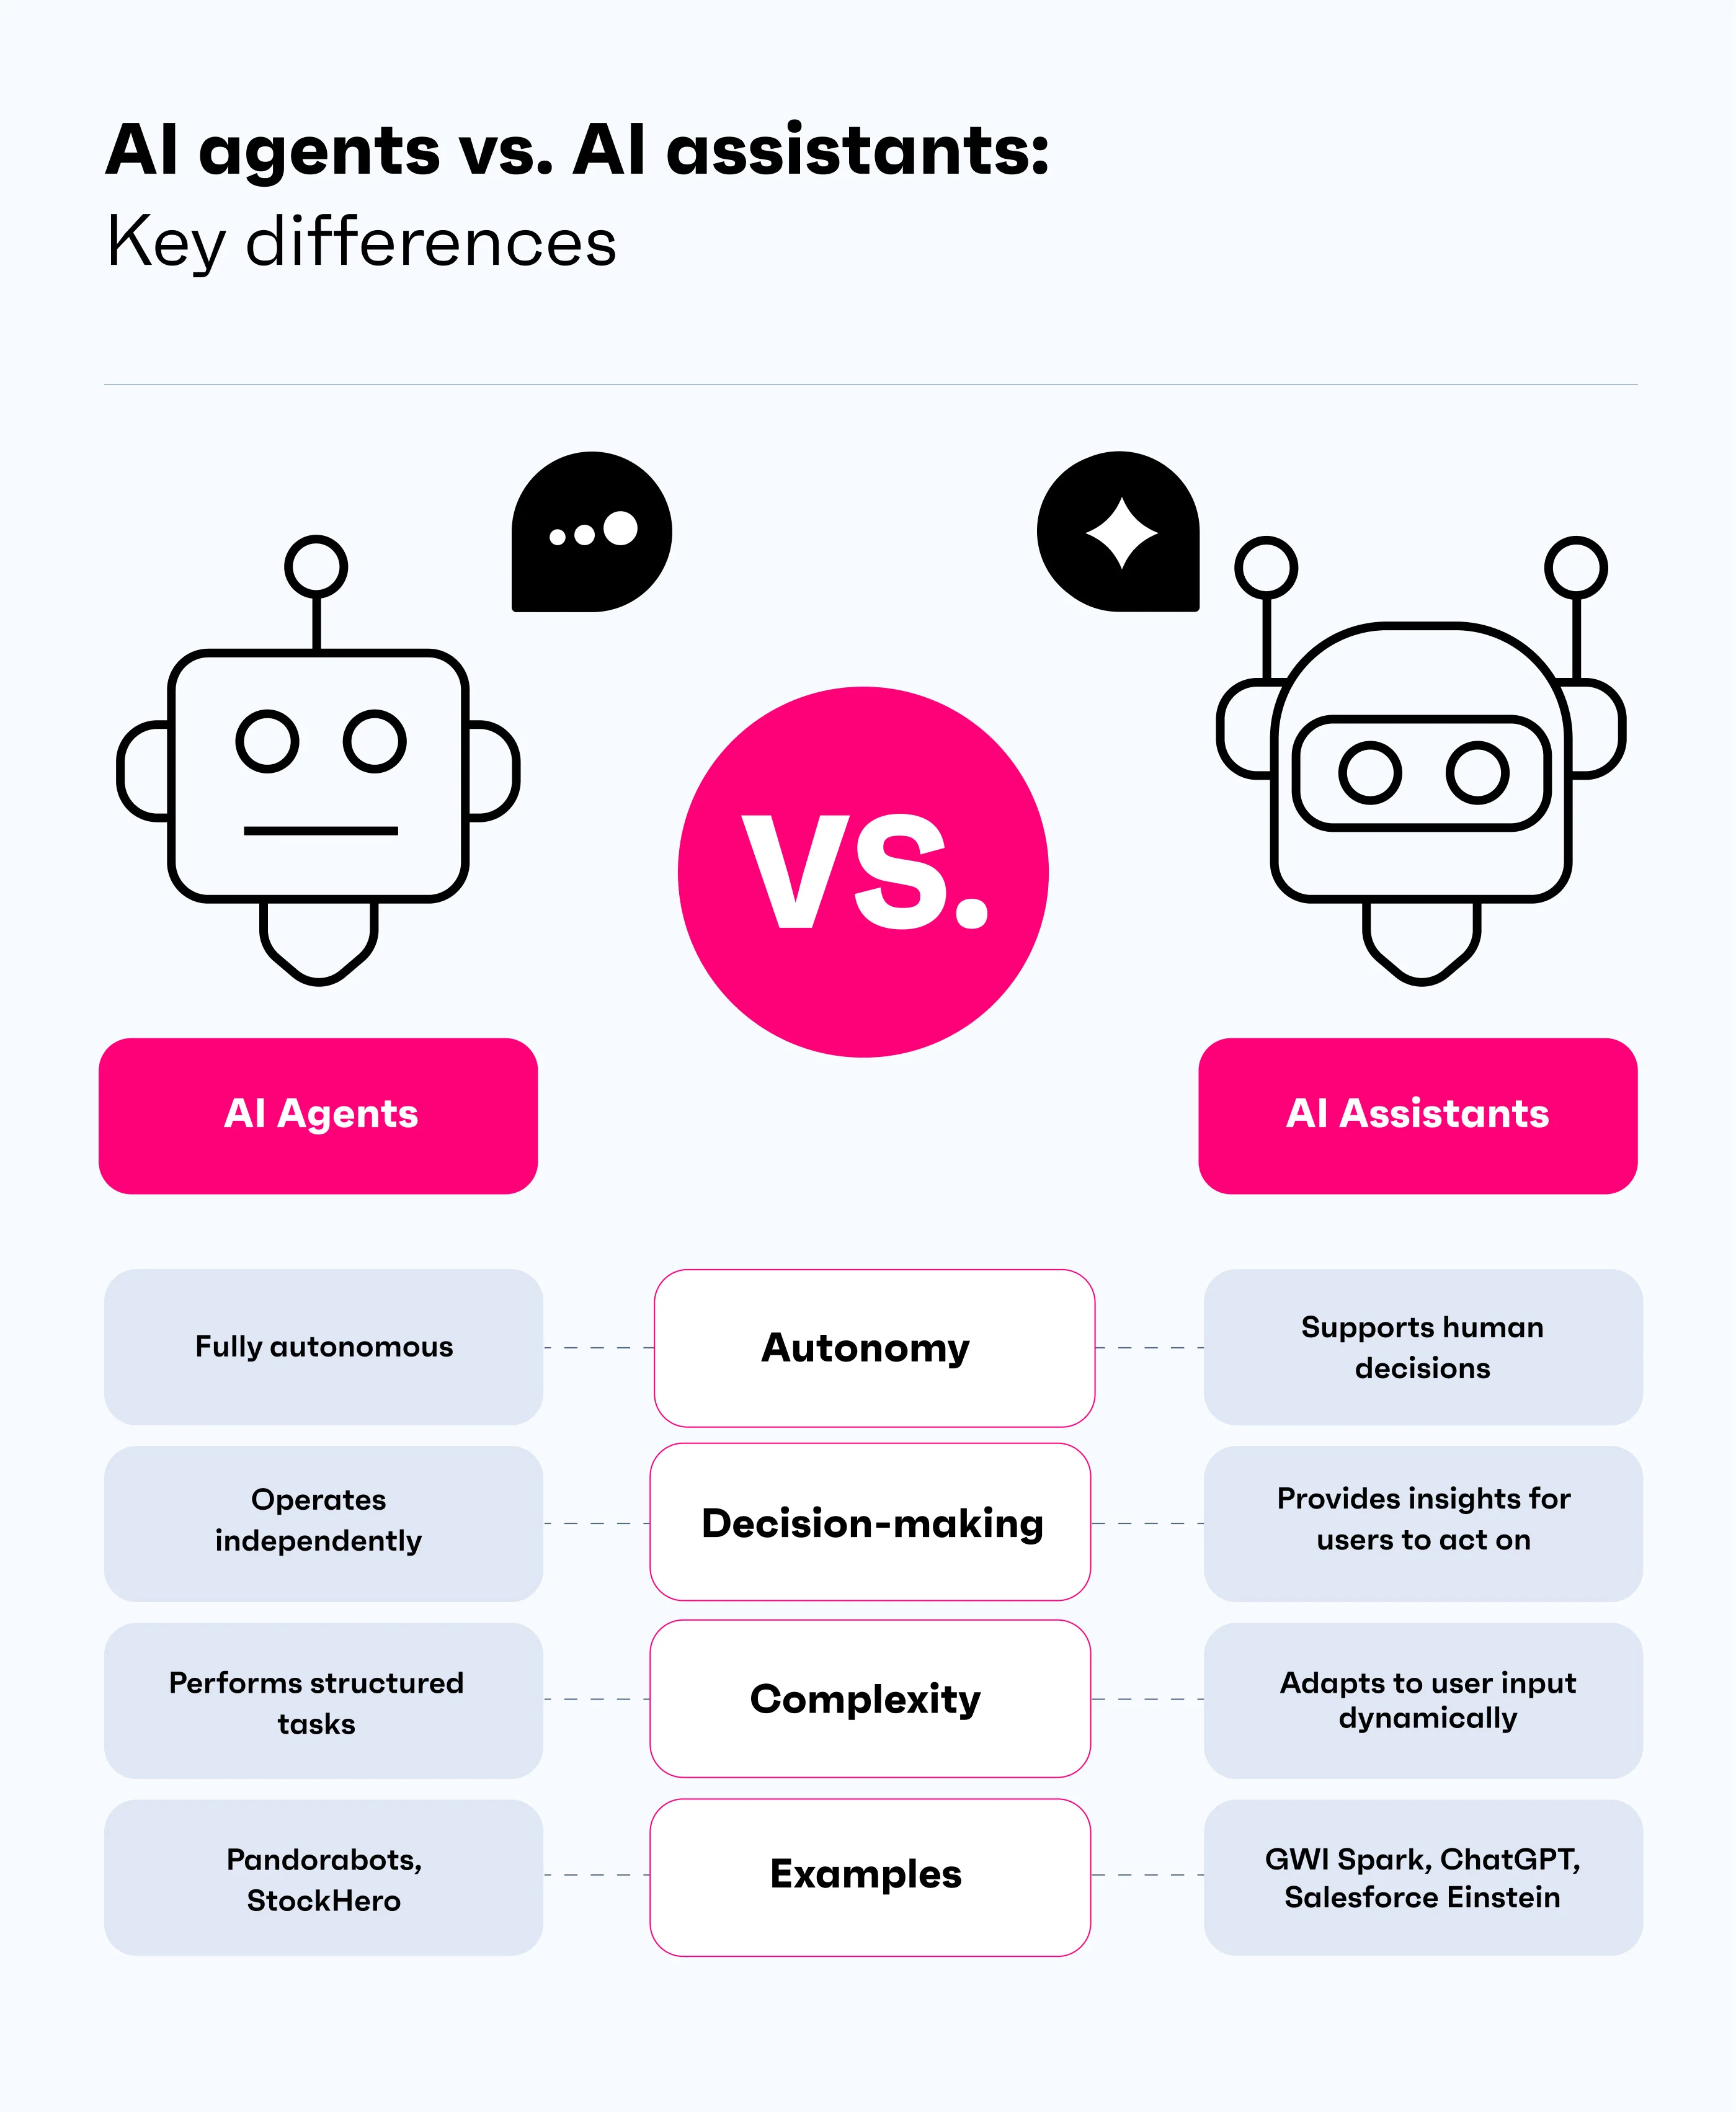
Что такое ИИ‑ассистент и чем он отличается от чат‑бота
- ИИ‑ассистент — это системная единица, которая может не только отвечать на вопросы, но и помогать сотруднику в выполнении рабочих действий, в интеграции с бизнес‑процессами, управлять контекстами и выполнять последовательности задач. Он может оперировать как естественным языком, так и структурированными данными, вызывать внешние сервисы, манипулировать документами и данными в корпоративных источниках.
- Чат‑бот — чаще ограничен разговорной формой коммуникации, может быть тесно связан с конкретной темой или отделом, но не обязательно обладает полноценных возможностями по интеграции и orchestrations. В реальных системах граница между чат‑ботом и ассистентом стирается: современные решения используют «модели‑ассистента» в связке с оркестраторами и базами знаний, чтобы работать как единое целое.
Форматы взаимодействия (форматы ИИ‑ассистента)
Диалоговый формат (чат‑интерфейс)
- Пользователь общается с ИИ в виде серии сообщений.
- Преимущества: простота восприятия, естественный стиль взаимодействия, возможность поддерживать контекст.
- Ограничения: возможно ограничение по функциональности без интеграции с системами.
Командный формат с контекстной подстройкой
- ИИ принимает команды/запросы, которыми можно управлять через кнопки, выпадающие меню и функции.
- Преимущества: ясность задач, сниженная вероятность некорректной интерпретации, удобство автоматизации конкретных рабочих процессов.
- Ограничения: нужно четко определить список допустимых команд и проверить совместимости.
Мультимодальный формат
- Включает текст, документы, таблицы, графику, возможно голосовую коммуникацию.
- Преимущества: расширение применимости, возможность работы с большими объемами информации.
- Ограничения: сложность разработки и инфраструктуры.
Интегрированный формат
- Ассистент тесно встроен в корпоративные сервисы: CRM, системами документооборота, ERP, BI‑платформами.
- Преимущества: максимальная полезность и экономия времени; возможность автоматизации процессов «от начала и до конца».
- Ограничения: требования к интеграции, безопасность данных, сопровождение.
Роли ИИ‑ассистента в компании
- Помощник сотрудника (personal assistant): ускорение подготовки писем, расписаний, резюме встреч, заметок и т. п.
- Поиск и обогатитель знаний (knowledge assistant): быстрый доступ к внутренним документам, политикам, шаблонам, FAQ.
- Аналитический помощник (analytical assistant): сбор и агрегация данных, подготовка отчетов, секций аналитических материалов.
- Поддержка внутренних процессов (operational assistant): автоматизация рутинных задач, маршрутизация обращений, контроль задач.
- Поддержка клиентов и сотрудников (service desk): ответы на частые вопросы, эскалация проблем, интеграции с сервис‑коверами.
- Ассистент по разработке и СУП (developer/tech assistant): помощь в коде, документации, сборке задач и CI/CD‑операций.
- Комплаенс‑и безопасность (compliance and risk assistant): мониторинг расхождений с политиками, обнаружение подозрительных действий, аудит действий пользователей.
Архитектурные паттерны и концепции
- Архитектура «модульного» типа: UX/UI – Orchestrator – LLM – Векторное хранилище – База знаний – Внешние API – Логи и безопасность.
- Оркестрация (Orchestration): координация нескольких моделей и сервисов, выбор адаптеров к конкретной задаче, маршрутизация запросов.
-
Промптинг и промпты‑архитектура:
- System prompt (роль модели, контекст, границы).
- User prompt (ввод пользователя).
- Function calling prompts (вызов функций API или плагинов).
- Резюмирование контекста и обновление цепочки контекста.
- Retrieval‑Augmented Generation (RAG): поиск релевантной информации в корпоративных источниках и включение её в ответы модели.
- Контроли и guardrails: политики, фильтрация, аудит, журналирование, безопасность данных, ограничение по доступу.
Терминология и методологии
- LLM (Large Language Model): крупная языковая модель, обученная на большом массиве данных.
- Prompt engineering: проектирование запросов к модели, чтобы добиться нужного поведения и качества ответа.
- Vector store: база векторных эмбеддингов для быстрых похожих документов (FAISS, Milvus, Weaviate и пр.).
- Embeddings: векторное представление текста для семантического поиска.
- MLOps: инженерия машинного обучения в жизненном цикле (развертывание, мониторинг, обновление моделей).
- Data governance и privacy: управление данными, соответствие законам и политике обработки персональных данных.
- Explainability и auditability: способность объяснить решения ИИ и сохранить логи для аудита.
Безопасность, этика и соответствие требованиям
- Защита персональных данных (PII) и чувствительных данных; локализация данных по требованиям регуляторов.
- Мониторинг и аудит операций ИИ‑ассистента.
- Управление доступом: роль‑ориентированный доступ, SSO, двухфакторная аутентификация.
- Ограничение доступа к внешним ресурсам и внешним API без проверки контекста.
Метрики эффективности и критерии успеха
- Точность/качество ответов, полнота охвата задач, сниженная доля ошибок.
- Время отклика и латентность.
- Уровень использования и вовлеченность сотрудников.
- Уровень удовлетворенности пользователя (NPS/CSAT).
- Экономический эффект: экономия времени, сокращение затрат, ROI внедрения.
- Уровень соответствия требованиям и регуляциям.
Практические примеры
Ниже приведены два подхода к реализации формата ИИ‑ассистента в бизнес‑среде: один ориентирован на open‑source стеки, другой — на российские решения. Примеры иллюстрируют архитектуру, выбор инструментов и примеры рабочих сценариев.
Пример 1. Open‑source стек: RAG‑асистент на Haystack с локальным LLM
Идея: собрать корпоративный ассистент, который может отвечать на вопросы сотрудников, опираясь на внутренние документы и базы знаний, используя Retrieval Augmented Generation.
Компоненты:
- Векторное хранилище: FAISS или Milvus.
- Документы: корпоративные политики, шаблоны, инструкции, отчеты.
- Retriever: Dense Passage Retriever или аналогичный.
- Reader: модели для детального извлечения ответа.
- Оркестратор: Haystack Pipeline.
- Взаимодействие: REST API или веб‑интерфейс.
- Модели: локальная LLM‑модель (например, LLaMA‑2/3, Mistral) или удалённый доступ к открытым API.
- Безопасность: контроль доступа, журналы запросов, шифрование.
Архитектура (упрощённо):
- Пользователь → UI → Pipeline Haystack → Retriever + Reader → Векторное хранилище и база знаний → Ответ → Пользователь
- Логи и мониторинг: Prometheus/Grafana; аудиты доступа.
Пример кода (упрощённо) для иллюстрации концепции:
# Пример настройки простого RAG‑помощника с Haystack (псевдо код)
from haystack.document_stores import FAISSDocumentStore
from haystack.nodes import DensePassageRetriever
from haystack.pipelines import ExtractiveQAPipeline

# инициализация хранилища и retriever
document_store = FAISSDocumentStore(similarity="cosine", embedding_dim=768)
retriever = DensePassageRetriever(document_store=document_store, query_embedding_model="dpr-questionEncoder-multiset-base",
                                  passage_embedding_model="dpr-ctx_encoder-multiset-base", use_gpu=True)

pipe = ExtractiveQAPipeline(reader=None, retriever=retriever)

# загрузим документы (пример)
# document_store.write_documents([Document(content="..."), ...])

# запрос
query = "Каковы требования к отпуску сотрудников?"
result = pipe.run(query=query, params={"Retriever": {"top_k": 5}})
print(result["answers"][0].answer)
Примечания:
- В реальной конфигурации add reader (Reader) для более точных ответов.
- Модели embeddings и retriever должны быть совместимы с выбранной моделью LLM.
- Размещение на локальном сервере обеспечивает контроль над данными.
Практический сценарий:
- В компании есть Политика по отпуску, регламенты по согласованию и шаблоны заявлений. Ассистент может быстро найти релевантные разделы документов и на их основе сформировать рекомендованное письмо сотруднику.
Пример 2. Российские решения и локальные варианты
-
Российские и локальные решения чаще ориентированы на соответствие требованиям локализации данных, поддержки русского языка и интеграции с отечественными сервисами. Примеры направления:
- YaLM (Яндекс): крупномасштабная языковая модель на русском языке, ориентированная на корпоративные сценарии; доступ к моделям и интерфейсы через инфраструктуру Яндекса и сторонних поставщиков.
- SberGPT / Сбер AI: линейка решений, предлагающая интеграцию в бизнес‑сценарии, сотрудничество с системами банка, а также инструменты мониторинга и управления безопасностью.
- DeepPavlov: открытая платформа для построения чат‑ботов и ассистентов на русском языке; поддерживает пайплайны NLU/NLP и интеграцию с внешними системами через API.
- Встроенные инструменты корпоративной инфраструктуры: корпоративные сервисы, CRM и ERP, связка с российскими облачными провайдерами и локальными дата‑центрами.
-
Пример интеграции на YaLM/Сбер GPT (концепция):
- Интерфейс: чат‑интерфейс через веб‑портал внутри компании.
- Интеграции: доступ к документам в локальном хранилище, подключение к внутренним API (CRM, ERP, билетные системы).
- Безопасность: локализация данных, контроль доступа, аудит действий.
- Архитектура: LLM (YaLM/Сбер GPT) + векторное хранилище (прикладной слой) + внутренняя документация + аудит и мониторинг.
-
Практический сценарий:
- Поддержка сотрудников: ассистент на русском языке, умеющий искать инструкции, формировать письма, просчитывать расчеты на основе внутренних политик и отправлять готовые документы в нужные службы.
Таблица сравнения форматов и ролей
| Формат | Роли ИИ‑ассистента | Примеры задач | Преимущества | Риски/ограничения |
|---|---|---|---|---|
| Диалоговый | Помощник сотрудника | поиск информации, редактура, ответы на вопросы | естественность, гибкость | риск неверной интерпретации без контекста |
| Командный | Команды/функции | запуск процессов, переход в режим «автоматизация» | точность, управляемость | ограниченность команд |
| Мультимодальный | Поддержка документов, таблиц, графики | анализ документов, подготовка материалов | широкая функциональность | сложность реализации |
| Интегрированный | Инструмент в рабочих процессах | взаимодействие с CRM/ERP/BI | максимальная полезность | потребность в глубокой интеграции, безопасность |
Архитектура и стек
Архитектура:
- Интерфейс пользователя (Web/Slack/Teams/etc.)
- Оркестратор задач (посредник между запросами и сервисами)
- Модели LLM (локальные/облачные)
- Векторное хранилище и база знаний
- Внешние API и сервисы (ERP/CRM/Документооборот)
- Безопасность, аудит и мониторинг
Стек и инструменты (open‑source):
- Модели: LLaMA/LLama‑2, Mistral, GPT‑NeoX, Falcon и т. п. (на выбор по лицензии и возможности локального развёртывания)
- Векторные хранилища: FAISS, Milvus, Weaviate, Vespa
- Редакторы и фреймворки: Haystack, LangChain (Python), DeepPavlov
- Embeddings: HuggingFace sentence transformers, русские модели embeddings (RuBERT, RuGPT‑3 embeddings и пр.)
- Операционная инфраструктура: Docker, Kubernetes, CI/CD для моделей
- Безопасность и управление доступом: OAuth2.0, SSO, Vault, криптография
Стек и решения (российские/локальные):
- YaLM/YaLM‑2.x и другие российские языковые модели, ориентированные на русский язык
- Сбер AI продукты (SberGPT и др.) с интеграциями в бизнес‑сервисы
- DeepPavlov и локальные модули для NLU/NLP, которые можно адаптировать под корпоративные данные
- Инструменты локального развёртывания и контроля доступа, соответствующие требованиям локализации
Примеры технических задач и конфигураций
Реализация RAG‑потока на основе Haystack:
- Подготовка документов и индексация в FAISS/Milvus
- Настройка retriever'а и reader'а
- Внедрение политик доступа и журналирования
Интеграция с внутренними системами:
- Подключение к CRM через REST API
- Подключение к системе документооборота через API
Безопасность и соответствие:
- Шифрование данных на покое и в транзите
- Аудит действий пользователей
- Ограничение модели — только разрешённые действия
Пример кода для вызова локальной или удалённой модели:
import requests

# Пример вызова локального сервиса LLM через REST API
API_URL = "http://localhost:8000/v1/chat/completions"
headers = {"Authorization": "Bearer YOUR_TOKEN"}

payload = {
    "model": "llama-2-70b",
    "messages": [
        {"role": "system", "content": "You are an internal corporate assistant."},
        {"role": "user", "content": "Как оформить заявку на отпуск?"}
    ],
    "temperature": 0.2,
    "max_tokens": 512
}

resp = requests.post(API_URL, json=payload, headers=headers)
print(resp.json()["choices"][0]["message"]["content"])
Примечание: адаптируйте URL, модель и параметры под свою инфраструктуру и лицензионные требования.
Практические выводы по технике
- Локализация данных может быть критичной для большинства крупных компаний. Выбор локального развёртывания или политики «data residency» должен быть частью архитектурного решения.
- Важно устанавливать границы функций для ИИ‑ассистента: какие задачи он может выполнять самостоятельно, какие требуют проверки человека.
- Эффективная интеграция с источниками знаний (документы, политики, регламенты) существенно повышает точность и ценность ассистента.
- Мониторинг и аудит — обязательные элементы. Нужно регистрировать обращения, решения и результаты, чтобы обеспечить прослеживаемость и улучшение.
Риски и ограничения внедрения
- Точность и «галлюцинации» (hallucination): ЛLM может давать непризнанные или неверные ответы; необходимы механизмы верификации и человеческий контроль в критических сценариях.
- Безопасность данных и регуляторика: обработка персональных данных, работоспособность локальной инфраструктуры, аудит и журналы доступа, соответствие требованиям локального законодательства.
- Стоимость и масштабируемость: затраты на вычислительную инфраструктуру и лицензии, рост требований при увеличении числа пользователей и источников данных.
- Внедрение и интеграция: сложность подключения к существующим системам (CRM, ERP, документооборот, BI); зависимости от API версий и стабильности сервисов.
- Сопротивление сотрудников и культурные факторы: необходимость обучения персонала, доверие к ИИ, прозрачность поведения ассистента.
- Этические и юридические аспекты: ответственность за решения, обработку данных, возможности «переноса» и ограничение вредоносных действий.
- Устойчивость и обслуживание: обновления моделей, мониторинг деградации качества, поддержка безопасности.
Определение формата ИИ‑ассистента и его роли в компании требует комплексного подхода. Нужно определить формат взаимодействия, роли и задачи, архитектуру, требования к безопасности и комплаенсу, а также выбрать подходящие инструменты — open‑source или российские решения — в зависимости от регуляторных и бизнес‑требований. Важная часть — план внедрения: понять целевые кейсы, определить KPI и внедрить RAG‑потоки для обеспечения точности и актуальности ответов. В итоге ИИ‑ассистент должен стать инструментом, который освобождает сотрудников от повторяющихся задач, ускоряет принятие решений и повышает качество знаний, оставаясь под контролем бизнес‑процессов и регламентов.
FAQ (часто задаваемые вопросы)
1) Что именно представляет собой «формат» ИИ‑ассистента в корпоративной среде?
- Формат описывает, как именно ассистент взаимодействует с пользователями и как он встроен в бизнес‑процессы. Это может быть диалоговый чат, командные интерфейсы, мультимодальные взаимодействия или полностью интегрированные модули в CRM/ERP. Формат задаёт границы задач, взаимодействий и способа получения данных.
2) Какие роли может выполнять ИИ‑ассистент в компании?
- Возможные роли включают помощника сотрудника (редактирование писем, графики, заметки), поиска знаний (быстрый доступ к политике и документам), аналитического помощника (отчёты и анализ), операционного помощника (автоматизация процессов), службы поддержки сотрудников и клиентов, разработчика/инженера (помощь в коде) и комплаенс‑ассистента (мониторинг соответствия политикам).
3) Какие форматы взаимодействия наиболее эффективны в случае большого числа пользователей?
- Обычно в крупных организациях применяют смешанные форматы: диалоговый для повседневного общения и командный/интегрированный для автоматизации процессов и вызовов API. Мультимодальные решения полезны для обработки документов и графиков, но требуют более сложной инфраструктуры.
4) Какие open‑source решения наиболее подходят для реализации ИИ‑ассистента?
-
Популярные стековые решения включают:
- Haystack (для RAG‑потоков и интеграции с векторными хранилищами).
- Фреймворки для LLM и промптинга на базе PyTorch/TensorFlow.
- FAISS, Milvus, Weaviate как векторные базы.
- LangChain как инструмент оркестрации.
- DeepPavlov для российской NLU/NLP.
- Локальные модели (LLaMA‑2/3, Mistral, GPT‑NeoX) с локальным развёртыванием.
5) Какие российские решения можно использовать для ИИ‑ассистента?
- Яндекс YaLM и сопутствующие сервисы, ориентированные на русский язык, а также решения от Сбера (SberGPT и associated tools). DeepPavlov — открытая платформа на русском языке. Важно учитывать лицензии и требования к локализации данных.
6) Какие ключевые технические шаги при внедрении?
- Определить задачи и KPI, выбрать формат взаимодействия, сформировать архитектуру (UI/UX, оркестратор, LLM, векторное хранилище, источники знаний, безопасность). Подготовить данные (индексацию документов), настроить RAG‑потоки, реализовать политики доступа и мониторинга, провести пилот и затем масштабировать.
7) Какие основные риски и как их минимизировать?
- Галлюцинации и неточности — внедрить проверки и верификацию, ограничить устойчивая к рискам контекст. Безопасность и конфиденциальность — локализация данных и аудит. Логистика внедрения — обеспечить интеграцию в существующие сервисы. Стоимость — взять на вооружение гибридный подход (локальные и облачные мощности) и четко определить TCO и ROI.
8) Как оценивать эффективность внедрения?
- Метрики: качество ответов, охват знаний, время отклика, удовлетворенность пользователей, экономия времени, рост продуктивности, сокращение затрат, соблюдение регуляторной политики. Важно сопровождать внедрение регулярной ретроспективой и улучшением.
9) Какой путь внедрения подходит для малых и крупных компаний?
- Для малых компаний часто достаточно пилотного проекта с ограниченным набором источников знаний и локальным LLM, чтобы проверить ценность и окупаемость. Для крупных предприятий — многоэтапная дорожная карта: пилот в одном департаменте, расширение на бизнес‑единицы, соблюдение регуляторных требований, расширение функциональности и интеграций.
10) Какие аспекты важны для устойчивого внедрения в российской среде?
- Локализация данных, соответствие требованиям регуляторов, выбор решений с поддержкой отечественных сервисов, всесторонняя безопасность и аудит, прозрачность для сотрудников и управление изменениями в культуре организации.


