

Выбор моделей: генеративные модели, локальные и гибридные решения
Современные корпоративные AI-агенты строятся на различных типах моделей и инфраструктурных подходах. В этом разделе мы разберём, чем отличается генеративная модель, чем полезны локальные решения, и как их сочетать в гибридной архитектуре, чтобы обеспечить требуемый баланс между качеством ответа, задержкой, стоимостью и безопасностью данных.
Зачем нужен выбор? Для разных сценариев корпоративной эксплуатации могут потребоваться разные режимы:
- полноценно обучаемый или адаптируемый под специфическую предметную область генеративный агент;
- решение, способное работать полностью локально без выхода в интернет;
- гибридная схема, где конфиденциальные данные обрабатываются локально, а обобщённые знания и вычислительно тяжёлые операции выполняются в облаке или на выделенных серверах;
- система, в которой внедряются векторные базы данных и конструируются Retrieval-Augmented Generation (RAG) пайплайны для повышения точности и фактологической надёжности.
В рамках этой главы мы охватим теоретические основы и дадим практические примеры, как подбирать модели под задачи сотрудников и бизнес-процессов, какие технические детали учитывать на этапе внедрения и какие риски нужно управлять.
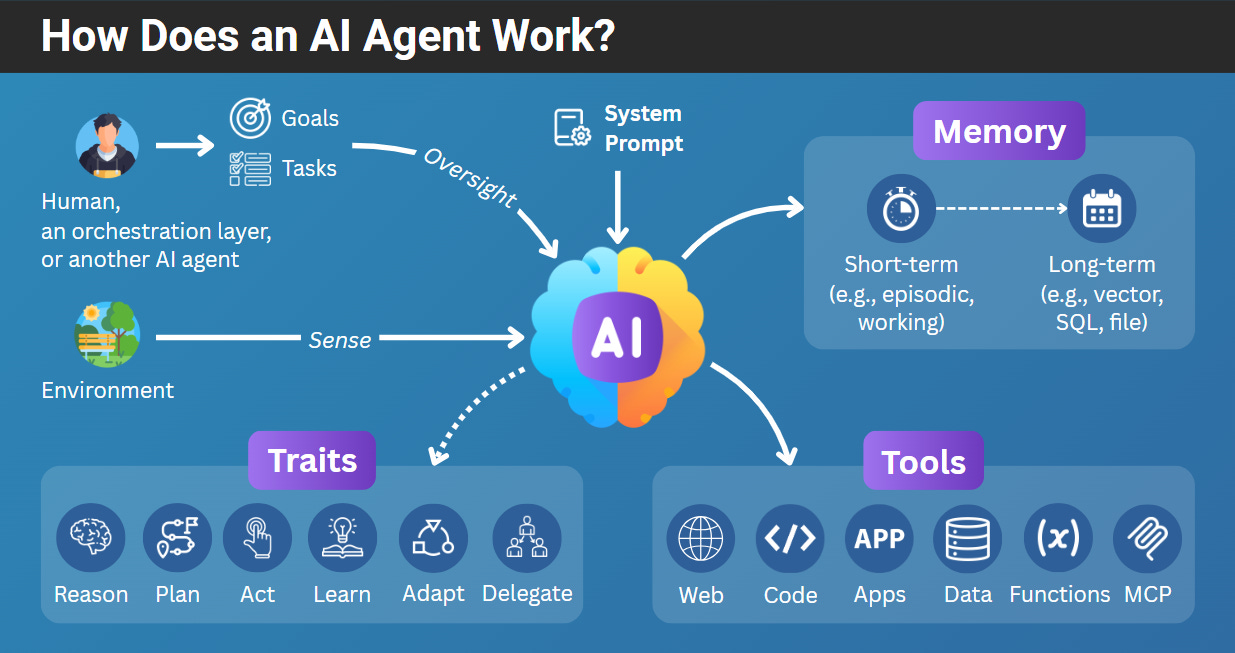
Основные типы моделей
-
Генеративные модели (LLMs): это большие языковые модели, обученные на больших корпусах текстов. Они способны генерировать текст, отвечать на вопросы, резюмировать материалы, писать код и т.д. В корпоративной среде часто используются модельные семействa различной величины: от 7–13 миллиардов параметров до десятков триллионов (для глобальных задач). Преимущества: гибкость, способность к перенастройке под доменную область; ограничения: потребность в вычислительных ресурсах, риск ошибок/галлюцинаций, вопросы приватности и соответствия требованиям.
-
Локальные/локально-развёртываемые модели: модели, которые можно разместить на инфраструктуре компании без доступа к внешним сервисам. Ключевые преимущества: приватность данных, контроль над обновлениями, низкая задержка в закрытой сети, возможность полной изоляции от интернета. Вызовы: потребность в дорогостоящем оборудовании, управление обновлениями и безопасностью, ограничения по размеру модели и скорости вывода.
-
Гибридные решения (RAG и др.): комбинация генеративной модели и внешних источников знаний через векторные базы данных и механизмы поиска. Идея: агент не хранит в памяти весь корпус знаний, а динамически извлекает релевантную информацию и дополняет её сгенерированными ответами. Это часто позволяет снизить риск «галлюцинаций» и повысить точность по узким тематикам.
Архитектурные подходы
-
Monolithic/одноканальная генеративная модель: вся логика приглашения контекста, генерации и постобработки идёт через одну модель. Прост в развертывании, но может оказаться неэффективным для задач, требующих частого обращения к внешним данным.
-
RAG (Retrieval-Augmented Generation): архитектура, в которой применяется векторное хранилище (vector DB) с embedding-мерами для поиска релевантной информации, которая затем подается в генеративную модель как контекст. Преимущества: выше точность, лучшее соответствие доменной области, возможность использования обновляемых источников знаний.
-
Adapter- и fine-tuning-подходы: вместо полного обучения большой модели применяются адаптеры, префикс-тонкие настройки (prefix tuning) или fine-tuning на доменном корпусе. Это уменьшает требования к вычислительным ресурсам и позволяет адаптировать модель под конкретные задачи.
-
Quantization и оптимизация скорости: уменьшение размера моделей за счёт квантования (например, 8-bit/4-bit) и использование специализированных форматов (GGUF, ggml) для ускорения inference на CPU/GPU и снижения требований к памяти.
Терминология, важные понятия и метрики
-
Контекстное окно (context window): максимальная длина входного текста, который модель может учитывать. Для больших моделей это тысячи токенов, для меньших — меньше. В реальных задачах важно учитывать состав контекста (источник документов, история диалога).
-
RLHF (Reinforcement Learning from Human Feedback): метод улучшения качества генерации через обучение с использованием оценок людей.
-
Fine-tuning / адаптация: дообучение модели на доменном корпусе или конкретной задаче, часто с использованием меньших наборов данных.
-
Adapters / Prefix-tuning: методы локального дообучения, которые требуют меньше вычислительных ресурсов, позволяют гибко адаптировать модель под конкретные сценарии.
-
Vector-based поиск: использование embedding-репрезентаций текстов и векторных баз данных для быстрого поиска релевантной информации. Часто применяется в RAG.
-
Метрики качества: perplexity — мерило языковой правдоподобности, но в прикладных задачах важнее человеческая оценка релевантности, точности фактов, удобочитаемости и полезности в контексте бизнес-задач.
-
Безопасность и приватность: защита данных, соответствие требованиям регуляторов (GDPR, локальные нормы), управление доступом, аудит активности.
Критерии выбора модели под задачу
- Тип задачи: генерация ответов, резюмирование политик, составление документов, помощь сотрудникам и пр.
- График задержки и доступность сервиса: оффлайн/локальное развёртывание vs облако.
- Приватность и конфиденциальность: какие данные обрабатываются и где они хранятся.
- Объем знаний: насколько требуется обновлять знания в реальном времени.
- Бюджет и инфраструктура: стоимость лицензий, аппаратные требования, поддержка.
Практические примеры
Пример 1. Локальная 7–13B модель для корпоративного помощника
Задача: построить внутреннего помощника по кадровым политикам и внутренним процессам, доступного в локальном сетевом сегменте.
Выбор модели: Llama 2 7B/13B или Mistral 7B — баланс между скоростью и качеством. Для строгой приватности можно рассмотреть YaLM 2.x (российская серия) или DeepPavlov-обученные варианты для диалогов на русском.
Архитектура: локальная инференс-среда на нескольких узлах – GPU-NVIDIA A100/A800, с использованием Torch Distributed для параллелизма.
Подход: без попыток «выкрикивать» всё знание из облака; для узких доменов применяем fine-tuning или адаптеры на корпусе внутренних документов.
Пример кода (упрощённый, локальная инференс-сессия):
from transformers import AutoTokenizer, AutoModelForCausalLM

model_id = "meta-llama/Llama-2-7b-hf"  # пример локальной модели; скачайте и разместите локально
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)

def generate(prompt, max_new_tokens=256, temperature=0.3):
    inputs = tokenizer(prompt, return_tensors="pt")
    outputs = model.generate(**inputs, max_new_tokens=max_new_tokens, temperature=temperature)
    return tokenizer.decode(outputs[0], skip_special_tokens=True)

prompt = "Опиши политку отпуска на корпоративном языке для сотрудников отдела кадров."
print(generate(prompt))
Комментарий: в реальном проекте добавляют предобработку контекста, контроль содержания, фильтры и постобработку для соответствия регламентам компании. Также можно применить адаптеры и префикс-тюнинг для доменной адаптации.
Пример 2. Гибридная архитектура: RAG с векторной базой данных
Задача: агент, который отвечает на вопросы о регламенте и политики компании, используя релевантные документы, сохранённые в корпоративной Хранилище знаний.
Архитектура: генеративная модель (например, Llama 2/Falcon/Mistral) + векторное хранилище (Qdrant или Milvus) для поиска документов по запросу.
Этапы:
- Токенизация и эмбеддинг входного запроса.
- Поиск наиболее релевантных документов в векторной БД.
- Формирование контекста из найденных документов.
- Генерация ответа с учётом контекста и вопроса.
Пример кода (упрощённый, с использованием Qdrant и transformers):
from transformers import AutoTokenizer, AutoModelForCausalLM
from qdrant_client import QdrantClient
from qdrant_client.models import PointStruct
import numpy as np

# Инициализация модели
model_id = "mistralai/Mistral-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)

# Инициализация векторной базы
client = QdrantClient(host="localhost", port=6333)

# Функция эмбеддинга документа
def embed(text, model=None, tokenizer=None):
    # Предполагается наличие embedder; здесь упрощённо возвращаем вектор через специальный сервис
    return np.random.rand(768)  # замените на реальный эмбеддинг

def rag_answer(question, top_k=3):
    q_vec = embed(question)
    # поиск по вектору
    hits = client.search(collection_name="corporate_kb", query_vector=q_vec, top=top_k)
    context = "\n".join([hit.payload.get("text", "") for hit in hits])
    prompt = f"Контекст: {context}\nВопрос: {question}\nОтвет:"
    inputs = tokenizer(prompt, return_tensors="pt")
    outputs = model.generate(**inputs, max_new_tokens=256, temperature=0.2)
    return tokenizer.decode(outputs[0], skip_special_tokens=True)

print(rag_answer("Какая политика отпуска в случае болезни?")
)
Комментарий: реальный код потребует корректной реализации embedder, надёжного подключения к векторной БД и обработки фактов. В качестве векторной БД часто применяют Qdrant, Milvus или Weaviate. Для русскоязычных сценариев полезно использовать модели, обученные на русском языке и специализированные доменные корпуса.
Пример 3. Российские и открытые решения
Российские и локальные варианты:
- YaLM (Yandex Large Language Model) — серия больших моделей на русском языке.
- DeepPavlov — русскоязычный набор инструментов для НЛП и диалоговых систем с открытым исходным кодом.
- Системы корпоративной интеграции от крупных российских компаний, часто предоставляющие локальные версии ИИ-агентов и безопасное взаимодействие с данными.
Open-source альтернативы:
- Llama 2 / Llama 3 (Meta), Mistral, Falcon, GPT-NeoX и т.д.
- Векторные базы данных: Qdrant, Milvus, Weaviate — платформа для хранения эмбеддингов и быстрого поиска.
Аппаратные требования и инфраструктура
- Для 7B–13B моделей чаще всего требуется GPU с 16–40 ГБ VRAM на модель (для одного экземпляра в зависимости от оптимизации). При использовании 4–8-битного квантования реально снизить требования существенно, но возможны ограничения по качеству.
- Для гибридных решений с RAG важны мощности для инференса плюс отдельные узлы для векторной БД и инфраструктура для безопасной интеграции.
- Локальное развёртывание: рекомендуется использовать Docker/Кубернетес с поддержкой NVIDIA GPU и драйверами CUDA, а также менеджеры контекста и очередей (RabbitMQ, Kafka) для взаимодействия с другими системами.
Форматы и инструменты оптимизации
- GGUF/ggml: форматы и инструменты для локального инференса на CPU/GPU; позволяют эффективнее работать с небольшими моделями и смягчать требования к памяти.
- 8-bit и 4-bit квантование через библиотеки bitsandbytes, bitsandbytes-llm и аналогичные: позволяют уменьшить потребление памяти и ускорить инференс.
- Инфраструктура обслуживания: Triton Inference Server, Hugging Face Inference Endpoints, ONNX Runtime, NVIDIA TensorRT — позволяют масштабировать и управлять нагрузками.
Безопасность и соответствие
- Контроль доступа: RBAC, аудит, мониторинг доступа к модели и данным.
- Приватность данных: использование изолированных сред, шифрование в покое и в движении, хранение эмбеддингов и документов в зашифрованном виде.
- Управление данными: политика retention, удаление данных и журналирование событий.
- Этические и регуляторные вопросы: фильтрация контента, предотвращение дискриминации, отслеживание ошибок.
Пример пайплайна развёртывания
- Этап планирования: выбор модели, архитектурной схемы, инфраструктуры и политики безопасности.
- Этап подготовки данных: сбор доменных документов, их препроцессинг, создание эмбеддингов.
- Этап обучения/адаптации: фокус на доменный корпус, адаптеры или префикс-тюнинг.
- Этап развёртывания: развёртывание сервиса инференса, интеграция через API, мониторинг метрик.
- Этап эксплуатации: мониторинг latency, ошибок, обновления моделей, аудит активности.
Риски и ограничения внедрения
- Галлюцинации и неточности: модели могут генерировать неверные факты или вводить неверные данные. В гибридной архитектуре RAG этот риск снижается за счёт привязки к фактам из документов.
- Приватность и соответствие требованиям: данные сотрудников и процессов должны оставаться в рамках корпоративной инфраструктуры; облачная обработка должна соответствовать регуляторным требованиям.
- Затраты на инфраструктуру: крупные локальные модели требуют вычислительных мощностей, лицензий и поддержки.
- Сложности поддержки и обновления: необходимость регулярных обновлений моделей, мониторинга этических и правовых аспектов.
- Проблемы стабильности и latency: при большом объёме данных время отклика может возрастать; гибридные решения часто помогают компенсировать это.
- Обучение персонала: необходимость обучения сотрудников в части понимания возможностей и ограничений ИИ-агентов, корректного формулирования запросов и безопасного использования.
Выводы
- Выбор модели зависит от задач, требований к приватности, задержке и бюджету. Генеративные модели дают мощную гибкость, локальные решения обеспечивают приватность и контроль, гибридные подходы позволяют сочетать преимущества и компенсировать ограничения.
- Архитектуры на базе RAG, векторных БД и адаптеров — эффективный путь для корпоративных сценариев, где важны точность и соответствие документам.
- Практические решения на базе YaLM, DeepPavlov и других российских инструментов позволяют создавать локальные корпоративные сервисы без зависимости от внешних облаков, при этом можно использовать открытые модели мирового уровня.
- Внедрение требует системного подхода: предварительный аудит данных, выбор модели и инфраструктуры, безопасная интеграция, тестирование на реальных кейсах, а затем развёртывание с мониторингом и управлением рисками.
FAQ (Вопросы и ответы)
1) Какие типы моделей лучше выбирать для корпоративного AI-агента?
- Это зависит от задачи: для высококачественной генерации с ограниченными доменными знаниями — генеративная модель; для приватности и контроля над данными — локальная модель; для получения точной информации из документов — гибридная архитектура (RAG). В большинстве случаев оптимально сочетать RAG-подход с локальной модульной инференс-системой и адаптацией под домен.
2) Какие open-source и российские решения можно использовать?
- Open-source: Llama 2/3, Mistral, Falcon, GPT-NeoX, BLOOM и т.д.; векторные БД: Qdrant, Milvus; фреймворки: Hugging Face Transformers, LangChain (для построения агентов).
- Российские/локальные: YaLM (Yandex), DeepPavlov (российский NLP-стек), локальные развёртывания на внутрирегиональной инфраструктуре; интеграционные решения от крупных держателей инфраструктуры могут предоставлять локальные сервисы ИИ.
3) Что такое RAG и зачем он нужен?
- RAG — Retrieval-Augmented Generation. Модель получает контекст из внеших документов (через векторное пространство) и использует его для генерации ответа. Это повышает точность и снижает риск ошибок, особенно для регламентных и юридических вопросов.
4) Как выбрать между локальным и облачным вариантом?
- Локальное развертывание предпочтительно при требованиях к приватности и устойчивости к сетевым задержкам, если есть мощные локальные ресурсы. Облачные решения подойдут для быстрого прототипирования, масштабирования и снижения капитальных затрат на инфраструктуру, если данные допускают размещение в облаке и есть порядок регуляторной оценки.
5) Какие технологические риски обычно встречаются?
- Галлюцинации и ошибки фактов, задержки при больших запросах, проблемы с безопасностью данных, регуляторные риски и ответственность за контент, сложности в поддержке и обновлениях.
6) Какие параметры помогают снизить риск ошибок в генерациях?
- Используйте RAG для привязки к документам, применяйте ограничение на длинный контекст, добавляйте фильтры и контроль содержания, применяйте постобработку и верификацию источников, а также тестируйте ответы на кейсах с экспертами.
7) Как начинается пилот проекта по внедрению AI-агента?
- Определите бизнес-задачу и требования к данным, выберите пилотную модель (локальная/гибридная), подготовьте доменный корпус и эмбеддинги, настройте инфраструктуру и безопасные каналы доступа, реализуйте базовую интеграцию в рабочие процессы, проведите тестирование на ограниченной группе пользователей и измеряйте KPI.
8) Какие индикаторы эффективности использовать?
- SLA по задержке ответа, точность фактов, качество резюме и полезность в бизнес-процессе, доля точных фактов, удовлетворённость сотрудников, частота возникновения ошибок и необходимость ручной коррекции.
9) Как обеспечить приватность и соответствие требованиям?
- Развертывайте локально, используйте шифрование данных, ограничивайте доступ через RBAC, сохраняйте аудит логов, используйте политики хранения данных и соответствуйте регуляторным требованиям.
10) Что дальше изучать после этой главы?
- Углубитесь в конкретику домена (политики компании, юридический отдел, HR и т.д.), изучите техники адаптации моделей (adapter-based fine-tuning, prefix-tuning), экспериментируйте с различными векторными БД и форматами инфраструктуры, настройте мониторинг и governance для устойчивого внедрения AI-агентов.


