

Управление данными и качество: принципы, процессы, ответственность
Данные лежат в основе современных моделей зрелости AI. Их качество напрямую влияет на точность моделей, устойчивость к деградациям, способность к воспроизводимости экспериментов и доверие стейкхолдеров. Грамотное управление данными — это не просто техничная задача: это организация ответственности, процессов и технологий, которые позволяют бизнесу и AI-командам работать с данными как с продуктом. В рамках модели зрелости AI данные проходят путь от сбора и хранения до использования в обучении, валидации и мониторинге моделей. Поэтому в разделе Управление данными и качество мы изучим: как строится система управления данными, какие качества данных критичны для ML, какие роли задействованы, какие процессы и технологические решения применяются, и какие риски сопровождают внедрение.
Ключевые идеи:
- Данные — актив продукта, требующий управления на протяжении всего жизненного цикла.
- Качество данных — это множество измеримых параметров (точность, полнота, согласованность, своевременность и пр.), которые нужно регулярно измерять и поддерживать.
- Эффективное управление данными требует ясной роли владельца данных, сторителей (data stewards), политики, процедур контроля качества и инструментов для каталога данных, lineage и тестирования.
- Модели зрелости AI требуют интеграции работы с данными в чек-листы, KPI и бенчмаркинг по культуре организации и качеству инфраструктуры.
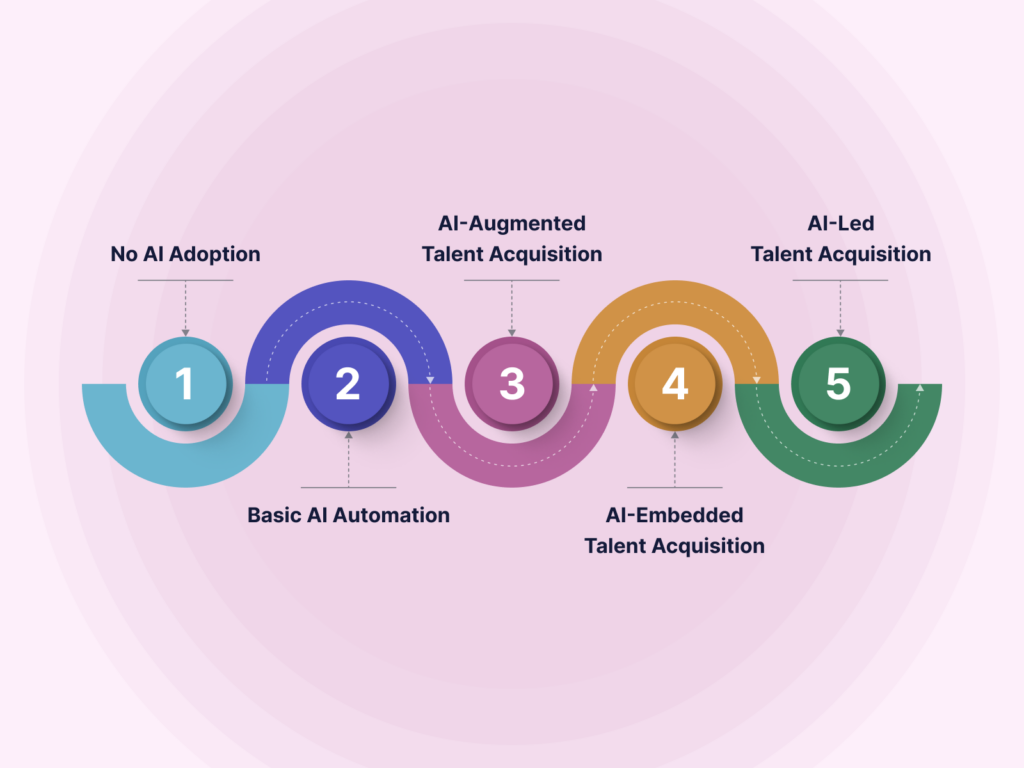
Основы управления данными (data governance)
- Что такое data governance: набор политик, ролей, стандартов и процессов, направленных на обеспечение доступности, целостности, конфиденциальности и защиты данных при их использовании для бизнес-решений и AI.
- Цели: обеспечение соответствия требованиям регуляторов, минимизация рисков утечки и ошибок, повышение воспроизводимости экспериментов и доверия к данным как к активу.
-
Роли:
- Владелец данных (Data Owner): бизнес-юнит, отвечающий за качество и доступность данных в своей области.
- Стейкхолдер данных (Data Steward): отвечает за реализацию политики на практике, качество и документацию.
- Custodian (Хранитель/Кeeper): техническая команда, которая обеспечивает доступ, безопасность и инфраструктуру.
-
Политики и артефакты:
- Политики доступа и приватности (PII, GDPR-аналоги, локальные требования).
- Ревизия и аудит изменений данных.
- Стандарты именования, единые словари и онтологии.
- Метаданные, которые описывают происхождение, качество, контекст и использование данных.
Качество данных как системная характеристика
Что такое качество данных: способность данных удовлетворять требованиям бизнеса в конкретном контексте и на конкретном этапе жизненного цикла.
Измеримые качества (data quality dimensions):
- Точность (Accuracy): соответствие данным истинному состоянию.
- Полнота (Completeness): доля отсутствующих значений и пропусков.
- Своевременность (Timeliness): задержка между событием и его доступностью для анализа.
- Согласованность (Consistency): отсутствие противоречий между связанными данными в разных источниках.
- Валидность (Validity): соответствие форматам и бизнес-огрничениям.
- Уникальность (Uniqueness): отсутствие дубликатов.
- Достоверность (Reliability): степень доверия к источнику и процессу.
Принципы измерения: профилинг данных, наборы правил и пороговые значения, мониторинг изменений, автоматические тесты и ручные обзоры.
Связь с ML: плохое качество входных данных ведёт к деградации моделей, смещениям и нестабильности вывода.
Метаданные, каталог и lineage
- Метаданные: описания источников данных, форматов, методов обработки, связей между данными и версий.
- Каталог данных: централизованное хранилище описаний данных, облегчающее поиск, понимание и повторное использование наборов данных.
- Линейность (data lineage): отслеживание полного пути данных — от источника к данным, которые используются в моделях и аналитике, включая промежуточные преобразования.
-
Важные концепции:
- Глоссарий бизнес-терминов и технических терминов.
- Теги и контекст для облегчения поиска.
- Версионирование схем и данных.
Платформенная архитектура управления данными
Типовая стековая архитектура:
- Источники данных: базы данных, логи, файлы, события.
- Хранилище: датасеты в Data Lake/хранилища (S3, HDFS, Hudi/Delta Lake).
- Каталог и метаданные: Amundsen, Apache Atlas, DataHub или аналогичные решения.
- Контроль качества: Great Expectations, Deequ (первично на JVM), собственные правила.
- Оркестрация и трансформации: Apache Airflow, Dagster, Prefect, dbt.
- Мониторинг и безопасность: мониторинг качества, мониторинг инфраструктуры, разграничение доступа.
Взаимосвязь компонентов:
- lineage связывает источники и таргеты преобразований.
- качество проверяется как часть ETL/ELT процессов.
- каталог обеспечивает поиск и понимание данных для исследователей и ML-инженеров.
Роли и ответственность в контексте AI maturity
- Data Owner: несёт ответственность за соответствие данным бизнес-целям, определяет требования к качеству.
- Data Steward: реализует политики, консолидирует требования к данным, отвечает за документацию и качество на практике.
- Data Custodian: отвечает за инфраструктуру, безопасность, доступ и техническую поддержку.
- Команды ML/AI: потребляют данные, должны учитывать качество данных при подготовке датасетов и при аудите моделей.
Связь между качеством данных и KPI/чек-листами
KPI по данным могут включать:
- % полноты полей критичных датасетов для обучения.
- Время обнаружения и исправления критических аномалий.
- Доля наборов данных с подтверждённой линейностью и происхождением.
- Время цикла исправления дефектов данных.
Чек-листы: на уровне проекта ML можно включать проверки качества входных данных, требования к описанию источников, требований к lineage и т. д.
Риски и ограничения в управлении данными
- Риск недопонимания бизнес-требований данными: несоответствие качества ожиданиям бизнес-подразделений.
- Внедрение без достаточной поддержки руководства и культуры ответственности.
- Затраты на инфраструктуру, стоимость хранения и вычислений для каталогов и тестов.
- Проблемы с соответствием регуляторным требованиям (локальные законы о персональных данных, хранении и трансграничной передаче).
- Сложности с устойчивостью инструментов к росту данных и изменению источников.
- Риски некорректной автоматизации качества (ложные срабатывания, пропуск важных проблем).
Практические примеры
Ниже приведены реальные подходы к реализации управления данными и качества данных, с акцентом на практическую сторону: архитектуру, конкретные инструменты и конфигурации. Раздел разделён на две части: open-source стек и российские решения/практики.
Open-source стек: как собрать рабочую систему контроля качества данных
Цель: Непрерывная проверка качества на этапе подготовки данных для обучения и использования в конвейерах.
Компоненты:
- Каталог данных и метаданные: Amundsen или DataHub (выбор зависит от инфраструктуры и предпочтений по интеграции).
- Контроль качества данных: Great Expectations (GE) — набор тестов на уровне столбцов и таблиц.
- Оркестрация и ELT: Apache Airflow или Dagster.
- Линейность и мониторинг: OpenLineage для lineage, Prometheus/Grafana для мониторинга.
- Трансформации и модели: dbt для SQL-уровня трансформаций, MLflow для реестра моделей.
Пример архитектуры:
- Источник данных (PostgreSQL, Kafka) → Data Lake (S3) → Каталог данных (Amundsen) + GE тесты → ETL/ELT (Airflow + dbt) → Модели ML (MLflow) → Мониторинг и аудит.
Пример рабочего кода:
-
Пример конфигурации Great Expectations (yaml) для проверки качества столбца age в таблице users.
# great_expectations.yml
datasource:
  name: my_postgres
  class_name: Datasource
  connector_path: connectors/postgres.py
suites:
  - name: users_age_suite
    expectations:
      - expect_column_values_to_be_of_type:
          column: age
          type_: "INTEGER"
      - expect_column_values_to_be_greater_than:
          column: age
          min_value: 0
      - expect_column_values_to_be_between:
          column: age
          min_value: 0
          max_value: 120
Пример Airflow DAG, запускающий GE тесты после загрузки данных в PostgreSQL: ``` from airflow import DAG from airflow.operators.bash import BashOperator from datetime import datetime
with DAG('data_quality_pipeline', start_date=datetime(2025,1,1), schedule_interval='@daily') as dag:
    load_data = BashOperator(task_id='load_data', bash_command='python3 scripts/load_data.py')
    run_ge_tests = BashOperator(task_id='run_ge_tests', bash_command='great_expectations --config /path/to/gx_config.json test --suite users_age_suite')

    load_data >> run_ge_tests
```
Пример̆ OpenLineage интеграции (конфигурация фрагмента вашего конвейера):
    {
      "name": "data_ingest",
      "inputs": ["postgresql://db/schema.users"],
      "outputs": ["s3://bucket/processed/users"],
      "facets": {
        "data_source": {"type": "postgres"},
        "tags": ["etl", "quality"]
      }
    }
Что это даёт:
- Автоматизация контроля качества на каждом этапе конвейера.
- Непрерывная проверка данных для обучения и анализа.
- Удобная навигация по данным через каталог и линейность.
Какие показатели KPI можно отслеживать:
- Процент наборов данных с валидными тестами GE.
- Время прохождения тестов качества.
- Доля ошибок данных, требующих ручного вмешательства.
- Время от появления дефекта до его исправления.
Российские подходы и практики
Важно подчеркнуть, что в РФ многие организации комбинируют зарубежные open-source инструменты и отечественные решения/практики. Ниже приведены типовые варианты реализации, которые часто встречаются в крупных компаниях и проектах:
Архитектура на отечественной инфраструктуре с интеграцией популярных инструментов:
- Хранилище данных: PostgreSQL, ClickHouse, Hadoop/EMR-подобные и локальные облачные решения в рамках Яндекс.Облако или СберОблако.
- Каталог и метаданные: локальный развертываемый каталог на базе Amundsen/DataHub, который разворачивают внутри отечекого облака, интегрированный с корпоративной аутентификацией (OIDC/SAML).
- Контроль качества: Great Expectations, адаптированная под локальные требования к хранению тестов и логированию.
- Оркестрация: Airflow или альтернативы, развёрнутые в российском дата-цехе.
- Линейность и мониторинг: OpenLineage + корпоративные мониторинговые панели, которые собирают данные об исполнения конвейеров и качестве.
Пример типовой задачи:
- Источник: локальная СУБД PostgreSQL в облаке.
- Цель: подготовить обучающий набор данных для модели рекомендательной системы.
- Действия: профилинг таблиц, фиксация линейности через lineage, проверка качества через GE-тесты, логирование результатов в каталог данных.
- Хранение и аудит: все версии метаданных и тестов сохраняются внутри отечественного дата-репозитория.
Практические соображения по безопасности и соответствию:
- Привязка к локальным политикам обработки персональных данных (ПД) и локализации хранения.
- Механизмы маскирирования и минимизации данных в обучении.
- Контроль доступа на уровне ролей и аудит изменений.
Примеры задач и конфигураций:
- Создание локального каталога для бизнес-терминов и ключевых метаданных по данным, используемым в ML-проектах.
- Настройка тестов GE для ключевых наборов данных, необходимых для обучения, с порогами приемлемости и уведомлениями в случае превышения пределов.
Прежде чем приводить конкретные примеры кода, важно подчеркнуть, что в российских проектах часто встречаются адаптации зарубежных инструментов под регуляторные требования и локальные политики безопасности. В качестве референса можно рассмотреть гибкую архитектуру, которая допускает переход между локальной инфраструктурой и облачными решениями, сохраняя общий процесс контроля качества и линейности.
Пример реализации в контексте российских облаков
Архитектура:
- Хранилище данных: ClickHouse для аналитических запросов и PostgreSQL для транзакционных источников.
- Каталог и метаданные: локальная инсталляция Amundsen/DataHub с поддержкой SSO через корпоративный IdP.
- Качество данных: GE-тесты, запускаемые из локального агентского окружения, адаптированные под локальные форматы данных.
- Оркестрация: Airflow, развёрнутый внутри российского облака (Яндекс.Облако/СберОблако) с учётом сетевых ограничений.
Пример конфигурации (псевдоконфигурация, адаптированная под локальные требования):
- Great Expectations — тесты по критическим наборам данных.
- dbt — преобразования в PostgreSQL/ClickHouse.
- OpenLineage — сбор lineage для дальнейшего аудита.
Вопросы безопасности:
- Хранение ключей и секретов в секретном менеджере облака (KMS/Secret Manager), ограничение доступа по ролям.
- Аудит действий пользователей и модификаций схем/данных.
- Механизмы маскирования персональных данных при подготовке обучающих наборов.
Что это даёт организациям в РФ:
- Возможность применения лучших практик data governance внутри отечественной инфраструктуры.
- Гибкость в выборе облака и сценариев миграции без потери согласованности политики управления данными.
- Соответствие требованиям регуляторов и внутренним политикам по безопасности.
Инструментальные детали: таблички и формулы качества
Таблица: Пример метрик качества данных
- Дазоваемая метрика | Определение | Методы расчета | Целевая величина
- Точность (Accuracy) | Соответствие данным «истинного» источника | Сравнение выборки с источником | ≥ 98%
- Полнота (Completeness) | Доля заполненных значений | 1 - пропуски / общее число | ≥ 95%
- Своевременность (Timeliness) | Задержка появления данных | Тайм-луна/временная метрика | ≤ 1 час
- Согласованность (Consistency) | Отсутствие противоречий между источниками | SQL-запросы на согласованность | 0 ошибок
- Валидность (Validity) | Соответствие формату и бизнес-правилам | Правила валидации | 100% валидных записей
- Уникальность (Uniqueness) | Отсутствие дубликатов | Проверка уникальности по ключам | 0 дубликатов
Пример формулы в SQL (проверка полноты и уникальности):
SELECT
  COUNT(*) AS total,
  SUM(CASE WHEN email IS NOT NULL AND email <> '' THEN 1 ELSE 0 END) AS non_null_emails,
  SUM(CASE WHEN user_id IS NULL THEN 1 ELSE 0 END) AS missing_user_id,
  SUM( CASE WHEN email IS NOT NULL THEN 1 ELSE 0 END ) - COUNT(DISTINCT email) AS duplicate_emails
FROM users;
Примеры конфигураций в коде
Пример конфигурации dbt (models/schema.yml):
version: 2

models:
  - name: users
    columns:
      - name: user_id
        tests:
          - not_null
          - unique
      - name: email
        tests:
          - relationships:
              to: ref('users')
              field: user_id
Пример конфигурации Dolt/Amundsen/DataHub:
- Описание источников, схем, и таблиц с метаданными.
Пример потоков данных и контроля качества
Логика конвейера:
- Извлечение данных (Единичные потоки).
- Промежуточная обработка (Light transform).
- Проверка качества через GE.
- Загрузка в целевые хранилища и создание линейности для дальнейшего анализа.
- Логирование результатов и уведомления.
Мониторинг и оповещение:
- Интеграция GE/ Airflow для уведомлений по Slack/Telegram/электронной почте.
- Пороговые значения и автоматическое эскалирование в случае падения качества данных.
Риски и ограничения внедрения
- Риск культурного сопротивления: сотрудники могут считать, что проверки качества «мешают» работе; необходима поддержка руководства и обучение.
- Стоимость владения инфраструктурой: каталог данных и тесты требуют вычислительных ресурсов, хранения и поддержки.
- Риск ложных срабатываний: слишком строгие пороги могут приводить к потере времени; нужно настраивать пороги разумно и проводить периодическую калибровку.
- Сложности линейки и актуализации метаданных: линейность требует постоянного обновления метаданных и тестов по мере изменений источников.
- Приватность и регуляторика: требования по локализации данных и обработке ПД должны быть учтены на уровне архитектуры и политики.
- Масштабирование и производительность: при росте объёмов данных и числа тестов нужно поддерживать баланс между качеством и скоростью обработки.
- Зависимость от инструментов: при выборе инструментов важно учитывать экосистему, поддержку, совместимость с бизнес-процессами и требования к безопасности.
Выводы
- Эффективное управление данными и поддержание качества — ключ к устойчивой AI-деятельности и доверию к моделям. Это не разовая акция, а системная дисциплина, включающая политики, роли, процессы и технологии.
- В реальности успешное внедрение основано на сочетании открытых инструментов (для прозрачности и гибкости) и отечественных практик/решений (для соответствия регуляторике и локализации данных).
- Важнейшие шаги к зрелости в управлении данными: определить роли, сформировать политики, внедрить каталог и линейность, запустить автоматические тесты качества, связать данные с бизнес-целями и KPI, обучить команды и поддерживать культуру ответственного использования данных.
FAQ (Вопрос–Ответ)
1) Что такое data governance и зачем он нужен в AI-проектах?
- data governance — это система политик, ролей и процессов, обеспечивающая доступность, качество, безопасность и прослеживаемость данных. В AI-проектах это критично для воспроизводимости моделей, уменьшения рисков, соответствия требованиям регуляторов и бизнес-целей.
2) Какие ключевые метрики качества данных стоит отслеживать?
- Основные: точность, полнота, своевременность, согласованность, валидность, уникальность, достоверность. Для ML особенно важно качество входных данных, так как на него напрямую опираются обучающие модели.
3) Что такое каталог данных и линейность ( lineage ) и зачем они нужны?
- Каталог данных — централизованное хранилище описаний источников данных, их контекстов и правил использования. Линейность — карта пути данных от источника до результата анализа и моделей; помогает понять происхождение данных и их преобразования, что критично для аудита и воспроизводимости.
4) Какие инструменты можно использовать в open-source стекe?
- Amundsen или DataHub для каталога, Great Expectations для тестирования качества, Apache Airflow/ Dagster/ Prefect для оркестрации, OpenLineage для lineage, dbt для трансформаций, ClickHouse/PostgreSQL как хранилище, MLflow для моделирования и реестра моделей.
5) Какие примеры практических сценариев можно привести?
- Пример 1: конвейер обучения — источники данных -> GE тесты -> линейность -> хранение в каталоге -> модели ML.
- Пример 2: продвинутый мониторинг в реальном времени — тесты качества на потоках Kafka, оповещения об отклонениях, автоматическая коррекция.
6) Какие есть риски при внедрении управления данными?
- Культурные, финансовые, регуляторные, технические риски. Неправильная настройка порогов качества, недостаточная поддержка руководства, сложности миграции и интеграции между инструментами.
7) Что означает российская реализация управления данными?
- Во многих российских проектах применяется гибридный подход: используют открытые инструменты, адаптируемые под регуляторику и политику безопасности, развернуты внутри отечественной инфраструктуры (облака) и интегрированы с локальными политиками доступа и аудитом.
8) Как связать управление данными с KPI и бизнес-целями в рамках AI maturity?
- Определяются конкретные метрики качества данных, сроки исправления дефектов, скорость развёртывания тестов, доля наборов данных, удовлетворяющих критериям, и время восстановления после инцидентов. Эти KPI напрямую коррелируют с эффективностью обучающих кампаний и стабильностью моделей.
9) Какие ограничения могут возникнуть при масштабировании?
- Рост объёмов данных и количество тестов может перегрузить инфраструктуру. Необходимо планировать вычислительные ресурсы, хранение и эффективную архитектуру каталога, а также оптимизировать пороги качества и частоту тестирования.
10) Какие шаги начать прямо сейчас?
- Определите роли в вашей организации (data owner, data steward, custodian).
- Опишите политики доступа и требования к качеству.
- Разверните базовый каталог данных и линейность (минимум Amundsen/DataHub + OpenLineage).
- Настройте простые GE-тесты для важных датасетов и интегрируйте их в ETL/ELT.
- Введите KPI по данным и начните регулярные обзоры результатов.
Если вы рассматриваете AI как часть цифровой трансформации компании, мы поможем сформировать дорожную карту, оценить риски и запустить пилот с понятными метриками эффективности.


