

Организационная модель AI: цели, принципы и роли
В современном бизнесе искусственный интеллект перестал быть «экзотикой» и стал нормой операционной деятельности. Но запуск отдельных моделей без единой организационной модели редко приносит устойчивые бизнес-результаты. Именно поэтому в этой главе мы поговорим о целостной organisational AI-модели: какие цели ставят перед AI-инициативами, какие принципы управляют работой команд, какие роли и центры компетенций создают основу для повторяемых результатов, как применяется продуктовый подход к разработке и развёртыванию моделей, и как масштабировать успешные инициативы.
Мы разберём концепции на двух уровнях: стратегическом и операционном. Стратегический уровень отвечает на вопросы «Зачем AI в бизнесе? Какие ценности и цели мы вкладываем в AI-инициативы?» Операционный уровень — «Как мы организуем команду, процессы, инфраструктуру и платформу, чтобы эти цели регулярно достигались?». В тексте найдутся теоретические основы, практические примеры (open-source и российские решения), а также технические детали, которые помогут новым сотрудникам быстро влиться в реальный рабочий процесс.
Основной посыл этой главы: эффективная организационная модель AI строится на сочетании четко определённых ролей, устойчивых процессов, повторяемых паттернов разработки и надёжной инфраструктуры. Без этого данные не превращаются в инсайты, а модели не даются бизнес-результаты без риска и хаоса.
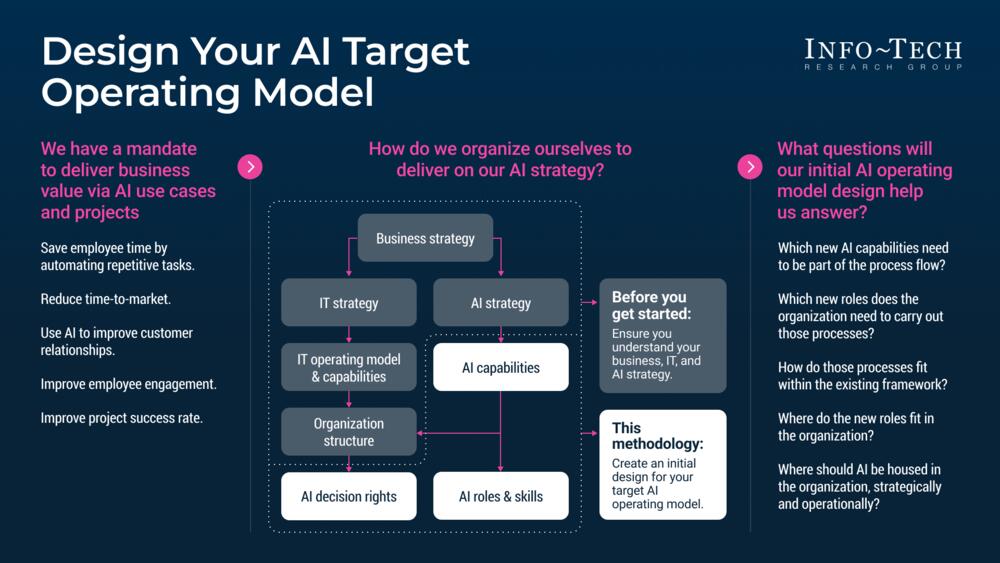
Цели организационной модели AI
- Стратегические цели: увеличить долю прибыли за счёт интеллектуальных решений, повысить скорость принятия решений, улучшить управляемость данными, снизить операционные издержки через автоматизацию и самообслуживание.
- Тактические цели: создание повторяемого процесса от идеи до внедрения модели, формирование единой базы знаний и опыта, снижение времени цикла разработки.
- Операционные цели: обеспечение прозрачности и управляемости проектов, соответствие нормативным требованиям, защита персональных данных и корпоративной информации, мониторинг качества моделей в реальном времени.
Ключевое понятие: AI как продукт. Каждая модель, пайплайн, компонент должны рассматриваться как продукт с владельцем, дорожной картой, метриками успеха и поддержкой на протяжении жизненного цикла.
Принципы организации AI
- Прозрачность и подотчётность: регламентированные процессы принятия решений, доступ к данным, журналирование действий и изменений.
- Повторяемость: воспроизводимые пайплайны, версионирование данных и моделей, детальная документация.
- Безопасность и этика: защита данных, предотвращение утечек, учётBias и справедливость, мониторинг непреднамеренных последствий.
- Эффективность использования данных: качественные данные, управление качеством на входе, обработка пропусков и аномалий.
- Управляемость и контроль качества: чек-листы на разных стадиях жизненного цикла, автоматизированные тесты качества данных и моделей.
- Гибкость и масштабируемость: архитектура, позволяющая добавлять новые домены, источники данных, новые модели без критического переработки инфраструктуры.
- Сосредоточенность на бизнес-ценности: связь целей проекта с конкретными KPI и ROI.
Архитектура, роли и связь между ними
Организационная модель AI строится вокруг нескольких слоёв: бизнес-контекст, управленческие органы, технологическая платформа, данные и модели. Важная идея — роли должны быть четко разделены, но тесно взаимосвязаны через общие процессы и артефакты.
- Chief AI Officer (CAIO) / Руководитель AI-направления: стратегическое видение, баланс интересов бизнеса и технологий, формирование дорожной карты AI.
- Chief Data Officer (CDO) / Руководитель данных: стратегическое управление данными, архитектура данных, качество и доступность данных, соответствие нормативам.
- AI Product Manager: владелец продукта искусственного интеллекта, отвечает за формулировку проблемы, требования, метрики и приоритеты.
- ML Engineer / ML-инженер: проектирование и реализация моделей, пайплайнов обучения и развёртывания, оптимизация производительности.
- Data Scientist: исследовательская работа, прототипирование, экспериментальный цикл.
- Platform/ML Ops Lead: платформа и инфраструктура для разработки, развёртывания и мониторинга моделей; управление CICD для ML, мониторинг, безопасность.
- Data Steward / Data Owner: ответственность за качество и целостность данных в конкретном домене.
- QA for AI / тестировщик моделей: валидация работоспособности моделей, мониторинг поведения и проверка на дрейф.
- Security & Compliance Officer: контроль за безопасностью, защитой данных и соблюдением норм.
- Сотрудники по эксплуатации и мониторингу (SRE для AI): поддержка работоспособности систем, управление инцидентами, SLA.
Таблица: Роли и их основные обязанности
| Роль | Основная задача | KPI | Взаимодействие |
|---|---|---|---|
| CAIO | Виденье AI-стратегии, приоритеты | доля AI в бюджете, ROI по AI | CDO, AI Product Manager, Platform Lead |
| CDO | Управление данными, качество, доступ | качество данных, соответствие | CAIO, Data Stewards, ML Engineers |
| AI Product Manager | Формулировка продукта, требования | скорость выпуска функций, клиентов | CAIO, ML Engineer, Data Scientist |
| ML Engineer | Реализация и развёртывание моделей | время цикла, производительность | Platform Lead, Data Scientist, QA |
| Data Scientist | Разведка, прототипы, эксперименты | количество валидных прототипов | ML Engineer, PM, Data Steward |
| Platform/ML Ops Lead | Платформа, CICD, мониторинг | доступность платформы, MTTR | SRE, Security, ML Engineers |
| Data Steward | Качество и управление данными | точность датасетов, линейка изменений | CDO, ML Engineer, QA |
| Security/Compliance | Безопасность и регуляторика | соответствие MLOps-политикам | CAIO, Platform Lead, Data Steward |
| SRE AI | Поддержка эксплуатации | время отклика, стабильность | Platform Lead, QA, Security |
Центры компетенций (CoE) и жизненный цикл AI-проекта
CoE — это мозговой центр, который аккумулирует экспертизу, устанавливает стандарты и обеспечивает повторяемость лучших практик. В типичной организационной модели CoE AI выполняет следующие функции:
- Нормативно-методологическое обеспечение: стандартный набор методик, шаблоны пайплайнов, политики качества.
- Обмен знаниями: библиотека паттернов, репозитории кода, обучающие программы.
- Управление портфелем проектов: отбор проектов, мониторинг прогресса, ретроспектива.
- Обеспечение инфраструктуры и инструментов: единая платформа, контроль версий, пайплайны.
- Этический и регуляторный надзор: аудит моделей, управление данными, соответствие требованиям.
Жизненный цикл проекта в рамках CoE часто состоит из следующих стадий:
- Идея и формулировка проблемы: определить бизнес-цели, критерии успеха.
- Исследование и прототип: сбор данных, экспериментальная модель, быстрые спринты.
- Проверка жизнеспособности (POC/MVP): демонстрация ценности, ограниченные риски.
- Продукт и развёртывание: индустриализация, доставку в продакшн, мониторинг.
- Масштабирование: развёртывание в другие домены, расширение набора функций.
- Эксплуатация и совершенствование: непрерывное улучшение, управление данными и моделями.
Продуктовый подход к AI и связь с бизнес-ценностью
AI-проект не заканчивается обучением модели. Он начинается с понимания проблемы клиента и формирования бизнес-цели. Продуктовый подход включает:
- Продуктовый backlog для моделей и функций: формирования в виде историй пользователей, с критериями готовности и метриками.
- Оценку экономической ценности (ROI) и рисков: какие данные требуются, какие затраты на инфраструктуру и обслуживание.
- Управление версиями и релизами: контроль версий данных и моделей, откаты.
- Метрики и мониторы: выбор KPI, которые реально отражают бизнес-ценность (например, точность в контексте бизнеса, снижение времени обработки, рост конверсии).
- Этапы развёртывания: от экспериментального пилота до масштаба на уровне предприятия.
Масштабирование AI-инициатив
Масштабирование требует системной инфраструктуры и процессов:
- Архитектура платформы, поддерживающая несколько проектов и команд.
- Политики управления данными и безопасностью, которые работают на уровне всей организации.
- Стандарты для развёртывания и эксплуатации моделей (CICD для ML, мониторинг, тестирование).
- Переход от индивидуальных пилотов к устойчивой операционной модели.
- Учет регуляторных и отраслевых требований в различных доменах.
Практические примеры
1) Пример структуры команды и процессов (практический сценарий)
- Цель проекта: улучшить персонализацию рекомендаций в ecommerce-платформе.
- Команда: CAIO, CDO, AI Product Manager, ML Engineer, Data Scientist, Data Steward, Platform/ML Ops Lead, SRE, QA.
- Путь проекта: идея → прототип → MVP → продакшн → масштабирование на новые сегменты.
- Инфраструктура: Kubernetes-кластер, Kubeflow как оркестратор экспериментов и пайплайнов, MLflow для трекинга экспериментов, DVC для контроль версий данных, Great Expectations для валидации данных.
- Метрики: рост конверсии на 5–7%, уменьшение времени отклика системы рекомендаций на 30%, доля автоматизированных обновлений моделей.
2) Технические примеры (open-source)
- Управление экспериментами и версиями: MLflow + DVC.
- Оркестрация пайплайнов: Kubeflow Pipelines (на Kubernetes).
- Валидация данных: Great Expectations.
- Мониторинг моделей: Prometheus + Grafana + OpenTelemetry.
- Хранилище признаков: Feast (feature store) или локальные альтернативы.
- Управление данными и качеством: Delta Lake / Apache Hudi (для data lake/годности накопления).
Пример пайплайна на Python (упрощённый):
# Простой пример пайплайна обучения с использованием MLflow
import mlflow
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from data_processing import load_data, preprocess

# загрузка и предобработка
X, y = load_data()
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

with mlflow.start_run():
    model = RandomForestClassifier(n_estimators=100, random_state=42)
    model.fit(X_train, y_train)
    preds = model.predict(X_test)
    acc = accuracy_score(y_test, preds)
    mlflow.log_metric("accuracy", acc)
    mlflow.sklearn.log_model(model, "rf_model")
Пример конфигурации Kubernetes для развёртывания модели ( YAML-описание сервиса Seldon Core):
apiVersion: machinelearning.seldon.io/v1
kind: SeldonDeployment
metadata:
  name: rf-model
spec:
  predictors:
  - name: rf-predictor
    replicas: 2
    graph:
      name: rf-model
      implementation: SKLEARN_SERVER
      modelUri: gs://my-bucket/models/rf_model
    annotations:
      caBundle: ""
3) Практические примеры российского контекста
- Российские решения и сервисы для AI/ML: Яндекс.Облако и СберОблако предлагают инфраструктуру, инструменты для управления данными и развёртывания моделей в рамках локальных облаков и гибридных конфигураций. Примерно такие сервисы включают: хранение и обработку данных, управление экспериментами, мониторинг моделей и безопасность данных. В рамках курса стоит рассмотреть интеграцию с локальной инфраструктурой в рамках нормы и регуляторики страны: хранение персональных данных внутри страны, контроль доступа, аудит и шифрование.
- Практический подход к локализации: при внедрении в российских условиях особенно важно обеспечить соответствие FZ-152 и локальным требованиям к обработке персональных данных, а также настройку географической привязки данных и ограничение доступа к данным по сегментам.
4) Примеры процессов и регламентов
- Регламент анализа данных: какие источники данных можно использовать, как проводится подготовка данных, какие преобразования допускаются, какие переменные считаются защищёнными.
- Регламент управления моделями: как регистрируются модели, версии данных и моделей, кто имеет право на развёртывание в продакшн, как отслеживается качество и рассогласование.
- Регламент мониторинга: какие метрики отслеживаются, пороги для тревог, сроки реакции на инциденты, как осуществляется откат.
Управление данными и соответствие требованиям
- Законодательство: в рамках РФ — защита персональных данных, регуляторные требования и правила обработки данных. Практики включают минимизацию данных, псевдонимизацию/анонимизацию, аудит доступа, контроль изменений.
- Инструменты: data catalog (описание источников данных, владельцев, качества), data lineage (откуда данные пришли и как преобразованы), data validation (проверки качества).
- Примеры инструментов: DataHub, Amundsen (open-source), Great Expectations, Delta Lake или Apache Hudi для управления данным.
Архитектура ML-платформы
- Слой данных: источники, данные в реальном времени, хранение и качество данных.
- Обучение и эксперименты: окружения, пайплайны, версии кода и данных.
- Развёртывание и эксплуатация: сервисы, API, мониторинг, безопасность.
- Мониторинг и операционная устойчивость: алертинг, метрики, журналирование.
Безопасность и комплаенс
- Доступ по ролям (RBAC) в Kubernetes, управление секретами (KMS, Vault), шифрование данных в покое и в транзите.
- Мониторинг доступа и аудиты: кто, когда, какие данные и модели использовал.
- Защита моделей: обнаружение утечки инференса, защита от атак типа adversarial, контроль доступа к моделям и сервисам.
Мониторинг и качества
- Метрики для моделей: точность, F1, ROC-AUC, drift по данным и по поведению модели, latency.
- Мониторинг инфраструктуры: доступность сервисов, использование ресурсов, MTTR.
- Инструменты: Prometheus, Grafana, OpenTelemetry, ELK/EFK-стек.
Пример конфигурации политики управления данными (пример YAML)
data_governance:
  data_catalog:
    enabled: true
  lineage:
    enabled: true
  validation:
    enabled: true
    framework: "GreatExpectations"
  privacy:
    k_anonymity: 5
    pseudonymization: true
  access_control:
    rbac:
      roles:
        - DataOwner
        - DataEngineer
        - DataScientist
        - AIProductManager
Практические принципы интеграции и DevOps для AI
- CICD для ML: автоматизация тренировки, тестирования, верификации качества, развёртывания в продакшн.
- Ведение версий: коды, данные, модели, конфигурации — все версии должны храниться и быть воспроизводимыми.
- Откат и безопасность: стратегии для быстрого отката при drift’е, падении качества, регуляторных или юридических проблемах.
Риски и ограничения внедрения
- Неполная доступность качественных данных: проблема верификации данных, пропуски, дубликаты.
- Сдвиг концепций (drift): данные и ситуация меняются, модели требуют дообучения и переработки пайплайнов.
- Этические и юридические риски: предвзятость, дискриминация, нарушение приватности, нарушение регуляторики.
- Внедрение и приемлемость культуры: сопротивление изменений, нехватка квалифицированных кадров, нехватка времени и ресурсов.
- Технические риски: зависимость от конкретных инструментов (vendor lock-in), сложность интеграции между различными системами, производственные задержки.
- Экономические риски: неэффективное использование бюджета на инфраструктуру и лицензии.
Меры смягчения:
- Продуктовый подход и эксперименты: начинать с MVP и маленьких пилотов, чтобы проверить ценность.
- Центры компетенций и обучение: создание координационного центра знаний, развитие навыков сотрудников.
- Стандарты и регламенты: внедрять регламенты по управлению данными, безопасности и качеству.
- Архитектурная гибкость: модульная архитектура, поддерживающая гибкое добавление новых доменов и функций.
- Мониторинг и аудит: постоянный мониторинг качества и доверия, комплексные аудиты на предмет соответствия.
Выводы
- Эффективная организация AI начинается с ясного понимания целей и бизнес-ценности, формулирования роли и ответственности каждого участника процесса, а также с созданием центра компетенций, который обеспечивает повторяемость, безопасность и качество.
- Продуктовый подход к AI — ключ к устойчивому успеху: продуктовый менеджер, инженерная команда, данные и платформа работают как единый конвейер, ориентированный на бизнес-результаты и масштабируемость.
- Масштабирование требует сильной инфраструктуры и процессов: управляемых пайплайнов, политики данных, мониторинга и SRE-поддержки, а также культуры, которая поощряет экспериментирование и ответственность.
- В контексте российского рынка важно учитывать локальные регуляторные требования и доступность отечественных решений, включая российские провайдеры облачных услуг и локальные инструменты безопасности, которые помогают соответствовать регуляторике.
Теоретическая часть представлена здесь как опора для внедрения и практические примеры — как ориентир для реальных проектов. В дальнейшем каждый проект может адаптировать эти принципы под свои бизнес-кейсы и конкретные технологические условия.
Вопрос–Ответ (FAQ)
Q1: Что такое организационная модель AI и зачем она нужна?
A: Это системный набор ролей, центров компетенций, процессов и инфраструктуры для планирования, разработки, внедрения и поддержки AI-инициатив. Она нужна для повышения повторяемости результатов, снижения рисков и обеспечения бизнес-ценности через управляемость и масштабируемость.
Q2: Какие основные роли важны в AI-организации?
A: Ключевые роли включают CAIO (руководителя AI-направления), CDO (руководителя данных), AI Product Manager, ML Engineer, Data Scientist, Platform/ML Ops Lead, Data Steward, QA for AI, Security & Compliance и SRE для AI. Эти роли разделены по ответственности, но тесно взаимодействуют через процессы и артефакты.
Q3: Что такое Центр компетенций (CoE) AI и зачем он нужен?
A: CoE AI — это мозговой центр, который устанавливает стандарты, лучшие практики, управляет портфелем проектов и обеспечивает единый подход к инфраструктуре, данным и безопасности. Он помогает переводить знания в повторяемые процессы и ускоряет масштабирование.
Q4: Как работает продуктовый подход к AI?
A: В продуктовом подходе AI-проекты рассматриваются как продукты, имеющие владельца, дорожную карту, бизнес-метрики и платёжеспособность. Это помогает согласовать AI-инициативы с бизнес-целями и обеспечить устойчивую ценность.
Q5: Какие технологии и инструменты часто используются для ML-операций?
A: Часто применяют MLflow (эксперименты и артефакты), DVC (версионирование данных), Kubeflow (пайплайны и оркестрация), Great Expectations (валидацию данных), Delta Lake / Apache Hudi (управление данными), Prometheus/Grafana (мониторинг), Kubernetes (развёртывание и управление инфраструктурой), Seldon Core (развёртывание моделей). В российском контексте возможна интеграция с Яндекс.Облако или СберОблако для локального развёртывания и соответствия регуляторике.
Q6: Какой путь к масштабированию AI-проектов?
A: Обычно путь идёт от пилота/POC к MVP, затем — к промышленному развёртыванию в рамках нескольких доменов, затем к масштабированию на предприятие. Важны единые стандарты, платформа, управление данными и мониторинг.
Q7: Какие риски следует учитывать и как их снижать?
A: Основные риски — качество данных, дрейф моделей, предвзятость, регуляторные требования, безопасность, затраты. Их можно снизить через CoE, регламенты, тестирование, мониторинг качества, контроль доступа, а также через поэтапное масштабирование и управление портфелем проектов.
Q8: Что значит «AI как продукт» в контексте бизнес-ценности?
A: Это означает, что каждая модель и пайплайн рассматриваются как продукт с конкретной ценностью для бизнеса, установленной дорожной картой, метриками успеха и планом поддержки — а не как единичный эксперимент без долгосрочных обязательств.
Q9: Какие примеры российских решений стоит рассмотреть в инфраструктуре AI?
A: В российском контексте стоит обратить внимание на локальные облачные сервисы и решения в рамках Яндекс.Облако и СберОблако для хранения данных, управления экспериментами, развёртывания и мониторинга. В рамках открытого стека можно рассмотреть совместную работу с отечественными партнёрами и локальными решениями, обеспечивающими соответствие требованиям регуляторики.
Q10: Какие шаги могут сделать новые сотрудники для быстрого включения в проект AI?
A: Изучать принципы организации AI и регламенты CoE, познакомиться с основными инструментами (MLflow, Kubeflow, DVC, Great Expectations), понять бизнес-цели проекта и KPIs, пройти базовую тренировку по данным и безопасности, и сопровождаться наставником в рамках вашего отдела.
Мы проектируем AI-решения корпоративного уровня с учетом требований к безопасности, интеграции и масштабируемости: on-premise, приватные облака, RAG, векторные базы данных. Поможем подобрать архитектуру под ваши задачи и ограничения.


