

Политики, стандарты и управляемые процессы DG
Data Governance (DG) — это системная дисциплина, которая устанавливает правила, ответственности и механизмы контроля за управлением данными. Она обеспечивает единое определение терминов, согласованные политики, качество данных, защиту конфиденциальной информации и возможность прослеживаемости данных на протяжении всего их жизненного цикла. В условиях цифровой трансформации DG становится неотъемлемой частью operating model любой современной организации: от банковской сферы до промышленности и телекоммуникаций.
Цель данной главы — дать новичку или стажеру прочное представление о том, как строятся политики, стандарты и управляемые процессы в рамках DG, как они взаимодействуют с бизнес‑процессами, и как реализовать их на практике с применением реальных инструментов — как open‑source, так и российских решений. Мы рассмотрим концептуальные основы (термины, методологии, жизненный цикл политики DG), дадим практические примеры внедрения и настройки, разберем риски и ограничения, а также предложим готовые шаблоны документов и кодовые примеры, которые можно адаптировать под конкретную организацию.
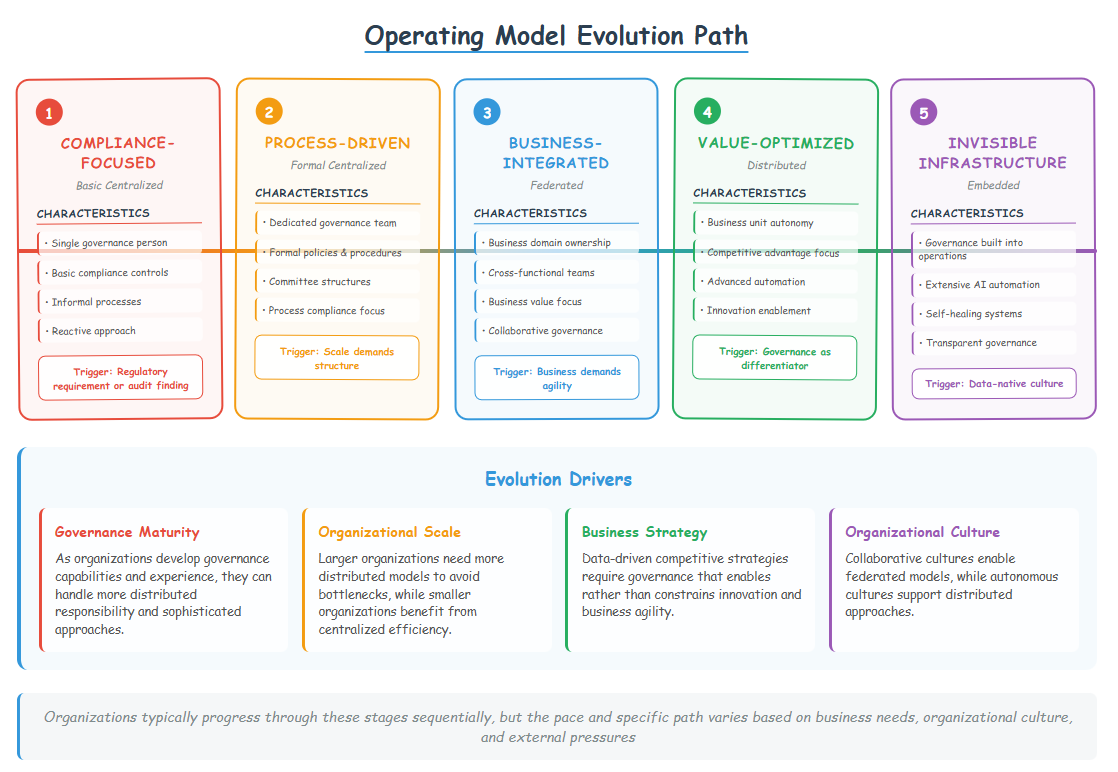
Что такое политика, стандарты и управляемые процессы DG
- Политика DG (Data Governance Policy) — формальный документ, который устанавливает принципы, цели, области охвата, требования к ответственностям и правила поведения при работе с данными. Политика задает рамки для последующих стандартов и процедур.
- Стандарты DG — конкретные требования к управлению данными: именование данных, метаданные, классификация, форматирование, хранение и архивирование, контроль доступа, качество данных, защитa персональных данных и др. Стандарты объясняют, «как именно» реализовать политики на практике.
- Управляемые процессы DG — повторяемые процедуры, связанные с жизненным циклом данных: создание данных, их обновление, качество и мониторинг, доступ к данным, изменение метаданных, аудит и аудит‑следы, управление инцидентами, риск‑менеджмент данных.
Основные термины
- Data Owner (владелец данных) — лицо или роль, ответственные за набор данных, его корректность, соответствие требованиям и пригодность для бизнес‑потребителей.
- Data Steward (стейкхолдер данных) — operador данных, ответственный за операционное управление данными, корректность метаданных, качество, каталогизацию и доступность для пользователей.
- Data Custodian (хранитель данных) — техническая роль, соответствующая реализационной части: хранение, резервирование, защита и технические меры по обработке данных.
- Master Data / Reference Data — системно значимые данные (например, справочники клиентов, продукций), которые требуют строгого управления и согласованных правил.
- Metadata (метаданные) — данные о данных: происхождение, формат, схемы, качество, политика доступа, lineage (прослеживаемость).
- Data Lineage (линейность данных) — поток данных от источников до потребителей, включая трансформации и агрегации.
- Data Classification (классификация данных) — категоризация данных по чувствительности, критичности и соответствию нормам.
- Data Quality (качество данных) — совокупность параметров и метрик, отражающих полноту, точность, консистентность и своевременность данных.
- Policy Lifecycle (жизненный цикл политики) — создание, согласование, внедрение, мониторинг, ревизия и устаревание политики.

Методологии и подходы
- DAMA-DMBOK (Data Management Body of Knowledge) — базовый справочник для разработки и внедрения DG, охватывающий области: управление данными, архитектуру данных, качество данных, безопасность, соответствие требованиям и др.
- DCAM (Data Management Capability Assessment Model) — фреймворк для оценки зрелости управления данными и инфраструктуры.
- Управление по жизненному циклу (Policy Lifecycle, PDCA) — Plan-Do-Check-Act: планирование политики, реализация, проверка соответствия и корректирующие действия.
- Управление данными как продуктом (Data as a Product) — взгляд на данные как на актив с владельцами продукта, определёнными потребителями и дорожной картой развития.
- Роль аудитора и контролей (controls and governance cadence) — периодические аудиты, контрольные точки, управление рисками данных.
Структура operating model DG
- Стратегический уровень — формулировка миссии DG, политики на уровне корпорации, регуляторные требования.
- Тактический уровень — стандарты по метаданным, классификациям и качеству, архитетуры каталогов, роли и RACI.
- Операционный уровень — внедрение в бизнес‑процессы, интеграция в рабочие процессы и IT‑платформы, автоматизация политик и мониторинг.
- Коммуникации и обучение — обучение сотрудников, доступ к документации, канал уведомлений, создание «одного языка» в рамках DG.
Роли и RACI в DG
- R (Responsible) — ответственный за выполнение задачи.
- A (Accountable) — единственный лицо, ответственное за итоговый результат.
- C (Consulted) — консультируемый эксперт.
- I (Informed) — информируемый участник. Типичные роли:
- Data Owner — A или R по соответствующим доменам.
- Data Steward — R или C по качеству, каталогу и метаданным.
- Data Custodian — R по инфраструктурным и техническим аспектам.
- DG Council / Governance Board — A по политике, стратегическому подходу и重大 изменениям.
- Legal / Compliance — C/I для соответствия требованиям языка и регуляций.
- IT / Security — C/I по техническим контролям, доступам, защите.
Жизненный цикл политики DG
- Инициация: выявление потребностей, цели политики, поддержка руководства.
- Разработка: формулировки, критерии, принципы, перечни данных, классификация.
- Согласование: юридическая, бизнес‑экспертиза, согласование со стейкхолдерами.
- Внедрение: публикация политики, внедрение стандартов, настройка инструментов.
- Мониторинг и аудит: отслеживание соответствия, качество и использование.
- Ревизия: обновление на основе фидбека, изменений регуляторики, технологических изменений.
- Архивирование/Устаревание: снятие политики с активной эксплуатации, хранение истории версий.
Архитектура и взаимодействие инструментов DG
- Каталог метаданных (Data Catalog) — хранение описаний данных, lineage, классификаций, доступов. Примеры: Amundsen, OpenMetadata, Apache Atlas.
- Рамки контроля доступа и политики (Policy & Access Control) — управление доступом к данным, маскирование, санкционирование запросов.
- Инструменты обеспечения качества данных (Data Quality) — набор правил проверки, тесты, автоматизированные проверки.
- Среда для политики и конфигурации (Policy as Code) — хранение политик в виде конфигураций (YAML/JSON) и автоматический разворот через CI/CD.
- Мониторинг и аудит (Observability & Audit) — журналы доступа, lineage, события изменений.
- Интеграционная платформа (Data Integration) — ETL/ELT, трансформации, согласование с политиками.
- Сообщение и обучение пользователей — документация, обучение, FAQ, бизнес‑термины.
Практические примеры
Пример 1: Open‑source стек дляDG в среде корпоративной аналитики
Цель: создать каталог данных и базовую политику управления данными для набора Customer360 с личными данными.
Инструменты:
- Apache Atlas — каталог метаданных и линейность данных.
- Apache Ranger — политика доступа и маскирование.
- Amundsen или OpenMetadata — каталог потребителей и поиска данных.
- Great Expectations (GE) — контроль качества данных.
- dbt — управление трансформациями и тестами качества данных.
- Kubernetes + Helm — оркестрация и развёртывание.
Как разворачивать:
- Развернуть Atlas как источник метаданных и линейности: регистрации источников данных (базы, файлы, события).
- Определить политики доступа в Ranger: кто имеет доступ к каким классам данных (PII, секреты, открытые данные) и какие операции разрешены.
- Включить каталог целевых потребителей: Amundsen/OpenMetadata, связать с Atlas для единообразной терминологии.
- Ввести политики качества через GE: базовые проверки на полноту, уникальность, форматы дат и уникальные идентификаторы.
- Настроить policy‑as‑code: политики доступа и качества описаны YAML/JSON, развёртываются через CI/CD.
- Обеспечить линейность данных: задекларировать источник, трансформации, целевой темплейт.
- Внедрить governance‑процедуры: ежеквартальные ревизии, уведомления, аудит изменений.
Пример политики (YAML) — базовая политика классификации и доступа:
  - name: customer_pii_access_policy
    description: "Политика доступа к персональным данным клиентов"
    scope: data_domain: customer
    classification: PII
    access_controls:
      - role: data_analyst
        access: read
      - role: data_scientist
        access: read
      - role: data_owner
        access: all
    masking:
      - apply_on_views: true
        masking_type: partial
        fields: [email, phone_number]
Ролевая схема (RACI) для этого домена:
- Data Owner: Accountable за полноту и корректность данных
- Data Steward: Responsible за метаданные, каталог и качество
- Data Custodian: Responsible за инфраструктуру, доступы и безопасность
- IT/Security: Consulted для политики доступа и соответствия
- DG Council: Approves policy, monitors ее изменения
- Business User: Informed о изменениях
Как это работает на практике:
- Источник данных: транзакционная база клиентов
- Atlas создаёт метаданные и lineage
- Ranger обеспечивает доступ на уровне таблиц/колонок, применяя маскирование
- Amundsen/OpenMetadata позволяют пользователю искать данные и видеть источники и lineage
- GE проверяет качество данных в пайплайне
- Политика хранится как код и разворачивается через CI/CD
Что следует учесть:
- Не перегружайте политики изначально. Начните с критичных областей (PII, финансовые данные, регуляторные требования).
- Обеспечьте связь политики с бизнес‑целями: зачем нужен доступ, какие данные критичны для клиента, какие требования по сохранению.
Пример 2: Российский контекст — адаптация открытых инструментов под регуляторику
Цель: обеспечить соответствие Федеральному закону о персональных данных (ФЗ-152), требования Федерального закона 243‑ФЗ и локальные регуляторные требования в российской компании.
Используемые подходы:
- Open-source компоненты (Atlas, Ranger, OpenMetadata/Amundsen) как базовый каркас.
- Локализация и конфигурации под российские правила: хранение журналов доступа в локальном дата‑центре, применение маскирования для PII, поддержка локализации форматов данных, аудит изменений.
- Интеграция с внутренними каталогами и справочниками терминов на русском языке.
Пример практической реализации:
- Реестр данных делится на домены: Клиенты, Финансы, Операции.
- Для домена Клиенты определяется политика классификации: PII, Sensitive, Public.
- Политика доступа на уровне групп пользователей внутри российского дата‑центра.
- Маскирование данных для внешних отчетов: частичное маскирование, псевдонимизация там, где возможно.
- Журналы аудита и политика хранения: хранение логов доступа в агрегации на локальном кластере, краткосрочная архивация в соответствии с регуляторными требованиями.
- Метаданные и линейность данных ведутся в Atlas с локальной репликацией и локализацией языковых терминов.
Примеры документов:
- Политика доступа к данным клиентов (Code‑policy.yaml) и карта соответствия ФЗ-152.
- Стандарт именования полей и метаданных на русском языке.
Важно: при внедрении в российской компании необходимо обеспечить надлежащее хранение данных, региональные копии журналов аудита и соответствие требованиям резервного копирования и обработки персональных данных.
Рекомендации по внедрению политики DG в бизнес‑процессы
- Привязка DG к бизнес‑процессам начинается с концепции «данные как продукт»: назначение владельцев и потребителей, дорожная карта качества, требования к доступу как часть бизнес‑правил.
- Включение DG в план развития: включение затрат на политики, обучение персонала, настройку инструментов в бюджет проектов.
- Обеспечение прозрачности: единый язык терминов, понятные руководителям трактовки политики, а также четкая коммуникация изменений.
- Инструменты как среда поддержки, а не узкое узконаправленное решение: DG должно дополнять существующие процессы разработки, QA, безопасности, аналитики.
Архитектура, инфраструктура и интеграции
- Архитектура DG обычно строится над тремя слоями: метаданные/каталог (Data Catalog), правила доступа и политики (Policy & Access), и контроль качества данных (Data Quality).
- Архитектура может быть реализована как микросервисная (контейнеры) в Kubernetes, с внешними источниками данных и локальной инфраструктурой для журналирования.
- Авторизация и аутентификация: OAuth2/OIDC, Kerberos для локальных систем, сервис‑аккаунты.
- Хранение журналов аудита и метаданных: распределенный файловой системе или база данных, с резервированием и безопасностью.
- Безопасность: шифрование at rest and in transit, управление ключами (KMS), роль‑ориентированное доступа, аудит изменений.
Пример конфигурации и кода
Ниже приводится пример конфигурации политики доступа в формате YAML и пример таблицы RACI. Это не полный код, а шаблоны, предназначенные для адаптации под конкретную инфраструктуру.
Пример политики доступа (policy-access.yaml):
  - policy_name: pii_access_control
    description: "Доступ к данным PII ограничен"
    data_domain: customers
    classification: PII
    owners:
      - data_owner: "CIO"
        contact: cio@example.com
    access_controls:
      - role: data_analyst
        access: read
        allowed_sources: ["warehouse", "landing_zone"]
      - role: data_scientist
        access: read
        allowed_sources: ["analysis_db"]
      - role: data_engineer
        access: write
        allowed_sources: ["raw_data_lake"]
    masking:
      enabled: true
      fields:
        - field: email
          type: partial
        - field: phone
          type: partial
Пример RACI для домена Customer Data:
| Процесс | Data Owner | Data Steward | Data Custodian | IT/Security | DG Council | Бизнес-пользователь |
|---|---|---|---|---|---|---|
| Определение классификации данных | A | C | I | C | A | I |
| Поддержка каталога метаданных | C | R | R | C | C | I |
| Мониторинг качества данных | C | R | A | C | I | R |
| Управление доступом | A | C | R | R | I | I |
| Аудит и соответствие | C | C | C | A | A | I |
Пример кода для регистрации источника данных в Atlas (псевдокод, Python):
  from atlasclient import AtlasClient
  client = AtlasClient(url="https://atlas.example.com", token="TOKEN")
  # Регистрация источника
  source = {
      "name": "crm_transactions",
      "type": "database",
      "connection": {
          "host": "db.example.com",
          "database": "crm",
          "user": "atlas_user"
      },
      "ownership": {"owners": ["data_owner"]},
      "integration": {"lineage": True, "classification": ["PII", "Financial"]}
  }
  client.create_entity("data_source", source)
Пример интеграции с Great Expectations (псевдокод):
  # GE конфигурация для набора данных клиентов
  expectations_store = "expectations/customer.yaml"
  suite = {
      "dataset": "customer_dataset",
      "expectations": [
          {"expect_table_row_count_to_be_between": {"min_value": 1000, "max_value": 100000}},
          {"expect_column_values_to_not_be_null": {"column": "customer_id"}},
          {"expect_column_values_to_be_unique": {"column": "customer_id"}}
      ]
  }
  # Запуск проверки
  run_ge_validation(suite, dataset="customer_dataset")
Технические требования и инфраструктура
- Инфраструктура: Kubernetes/опционально закрытая сеть/DataCenter для российских клиентов; контейнеризованные сервисы Atlas, Ranger, OpenMetadata/Amundsen, GE.
- Безопасность: политики шифрования, аудит, хранение ключей в HSM или KMS, роли и доступ по минимальным необходимым правам.
- Контроль версий и развёртывание: GitOps‑практики, CI/CD пайплайны, тестирование политик на staging‑окружении перед выпуском в прод.
- Масштабирование: горизонтальное масштабирование для каталога метаданных, линейности данных и организации журналов.
Риски и ограничения внедрения
Основные риски
- Хаос в данных и избыточная политизация: слишком большой набор политик может усложнить внедрение и снизить скорость предоставления данных.
- Неполное участие бизнеса: без вовлечения владельцев доменов, стейкхолдеров и аналитиков DG может остаться теоретическим.
- Проблемы совместимости инструментов: разные версии инструментов (Atlas, Ranger, OpenMetadata) могут иметь несовместимости, что приведет к задержкам.
- Узкие компетенции сотрудников: нехватка специалистов по DG, метаданным и качеству данных.
- Временная задержка и стоимость внедрения: начальная стоимость внедрения, обучение и настройка критических процессов.
- Неполное соответствие регуляторике: необходимость адаптации под местные требования, особенно в случае ФЗ-152 и локального хранения данных.
- Производительность и масштабирование: мониторинг и линейность данных могут вызвать нагрузку на систему.
Ограничения и предупреждения
- Политикам DG не место без соответствующей культуры данных и поддержки руководства. Необходимо обеспечить видение и поддерживать активное участие бизнес‑единиц.
- В большинстве организаций DG требует времени на рост зрелости: сначала — базовый набор данных и минимально необходимый набор политик, далее — расширение.
- Архитектура DG должна быть встроена в существующие процессы и платформы, чтобы не создавать «дорожки с зайцами» — лишнюю работу и дублирование.
- В некоторых отраслях (ФИНТЕХ, здравоохранение) требования к аудитам и хранению журналов обособлены и требуют дополнительных затрат.
Управление рисками
- Установите пилотные проекты: выбрать один или два домена (например, Клиенты и Продукты) для старта.
- Назначьте ответственных: Data Owner, Data Steward, Data Custodian и DG Council для домена.
- Разработайте минимальный набор политик и стандартов, соответствующих самым существенным требованиям регуляторов.
- Применяйте принцип «молодые политики, эволюционные изменения»: постепенно расширяйте набор политик и формализуйте их.
- Обеспечьте обучение и коммуникацию: регулярные семинары, справочные материалы и документацию.
Выводы
- Политики, стандарты и управляемые процессы DG образуют основу для устойчивого и безопасного обращения с данными в организации. Важность заключается в ясности ответственности, единых терминах и прозрачности действий.
- Внедрение DG — это не только выбор инструментов, но и изменение культуры, процессов и ролей в компании.
- Реализация DG должна начинаться с небольших, критичных доменов, с понятными KPI и эволюционной дорожной карты. Важно обеспечить участие бизнеса, техническую совместимость инструментов и соответствие регуляторным требованиям.
- Применение современных open‑source решений (Atlas, Ranger, Amundsen/OpenMetadata, GE) позволяет быстро построить функциональность каталогизации, контроля доступа и качества, а российским компаниям — адаптировать эти решения под локальные регуляторные требования и локальные инфраструктуры.
FAQ — Вопросы и ответы
1) Что такое DG и зачем он нужен в компании?
- DG — это набор политик, стандартов и процессов, направленных на управление данными как активом. Он обеспечивает прозрачность, качество, соответствие требованиям и безопасный доступ к данным. Внедрение DG позволяет бизнесу быстрее принимать решения на основе достоверной информации, снижает риски нарушения регуляторики и увеличивает доверие к данным.
2) Какие основные роли участвуют в DG и чем они занимаются?
- Data Owner: отвечает за корректность и полноту данных в домене.
- Data Steward: отвечает за метаданные, каталог, качество и комфорт использования данных.
- Data Custodian: отвечает за техническую реализацию хранения и доступ к данным.
- DG Council: управляет политиками и стратегиями DG.
- IT/Security и Legal/Compliance: консультируют по техническим и правовым требованиям.
- Бизнес‑пользователь: потребитель данных, информируемый о изменениях.
3) Какие инструменты лучше использовать для DG — open‑source или коммерческие решения?
- Open‑source: Atlas (метаданные/линейность), Ranger (политики доступа), Amundsen/OpenMetadata (каталог), Great Expectations (качество). Они позволяют быстро начать и адаптироваться под требования.
- Коммерческие решения: обычно предлагают готовые решения, поддержку, интеграцию и UX‑интерфейсы. Важно оценивать стоимость, совместимость и требования к регуляторике.
- Часто эффективна гибридная модель: базовые компоненты на open‑source и коммерческий слой для управления, безопасного доступа и поддержки.
4) Что такое «policy as code» и зачем он нужен?
- Policy as Code — это хранение политик в виде конфигураций (YAML/JSON), которые можно версионировать, тестировать и разворачивать через CI/CD. Это обеспечивает прозрачность, повторяемость и автоматизацию внедрения политик.
5) Что такое RACI в DG и как его применяют?
- RACI — методика распределения ролей: Who is Responsible, Accountable, Consulted и Informed по конкретной задаче. В DG RACI помогает чётко определить роли для управляемых процессов: классификация, каталогизация, доступ, качество и аудит.
6) Какие риски стоит учитывать при внедрении DG?
- Сложность и перегрузка политиками, недостаток бизнес‑поддержки, несовместимости инструментов, недостаток компетенций в DG, регуляторные требования и производственные задержки. Важно управлять рисками через пилотные проекты и эволюционную стратегию.
7) Какую роль играет DG в бизнес‑процессах?
- DG интегрируется в процессы «данные как продукт», где данные имеют владельца и потребителя, договоры на использование, метаданные, lineage и качество данных. Это обеспечивает более прозрачную работу аналитики, маркетинга, финансов и операционных подразделений.
8) Какую архитектуру выбрать для DG?
- Типичная архитектура: Data Catalog (метаданные) + Policy & Access (контроль доступа) + Data Quality (качество). Встраивается в инфраструктуру через API, поддерживает интеграцию с источниками данных и инструментами ETL/ELT.
9) Какие примеры документов можно использовать как шаблоны?
- Политика доступа к данным (policy-access.yaml), карта ответственных RACI для домена, описание принципов классификации, регламенты аудита и архивирования, инструкции по работе с регуляторной документацией (ФЗ‑152 и пр.).
10) Какие шаги можно предпринять в первые 90 дней внедрения DG?
- Определить критичные домены и владельцев; сформировать DG‑команду и правила; выбрать стек инструментов; внедрить первую политику и базовый каталог; настроить мониторинг и аудит; обучить сотрудников. Постепенно расширять набор политик и доменов, внедрять Quality и Lineage в пилотных проектах.


