

Компоненты OpenMetadata: архитектура и взаимодействия
OpenMetadata выступает как модульная платформа для создания единого data-каталога и управления метаданными на уровне предприятия. Глава посвящена архитектурным принципам, ключевым компонентам и их взаимодествиям, а также практикам интеграции и эксплуатации в условиях корпоративной цифровой трансформации. Рассматриваются как технические детали реализации, так и сценарии внедрения в рамках устойчивой архитектуры данных.
OpenMetadata строится вокруг идей централизованного хранилища метаданных, безопасной и управляемой инфраструктуры обмена данными между системами источников и потребителями, а также инфраструктуры для обеспечения видимости, контроля качества и соответствия требованиям регуляторов. В этой главе будут подробно рассмотрены взаимодействия между сервисами, протоколы обмена, модели данных и практические шаги по развёртыванию и масштабированию.
- Архитектура как основа для расширяемости: микросервисы, контрактное взаимодействие и плуггируемые коннекторы.
- Взаимодействие источников данных с каталогом через коннекторы и конвейеры ingestion.
- Безопасность, аудит и контроль доступа в распределённой среде.
- Эволюция данных и линии происхождения как часть операционной дисциплины.
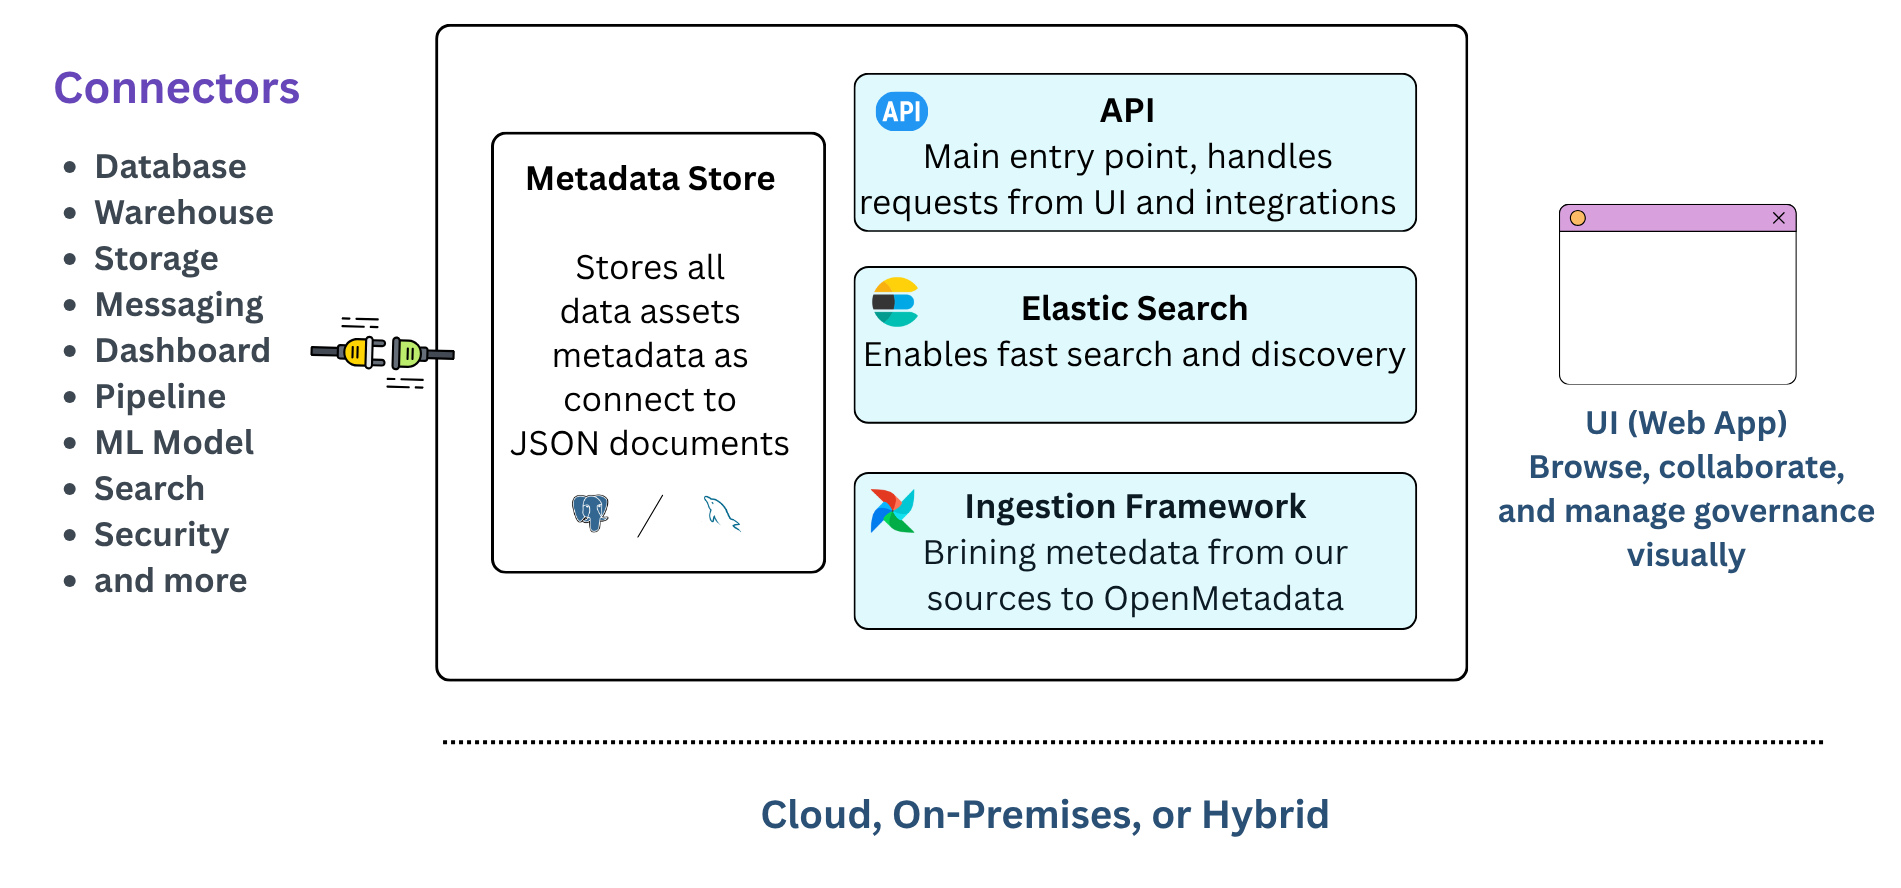
Архитектура OpenMetadata
OpenMetadata строится как совокупность взаимосвязанных сервисов, каждый из которых отвечает за конкретную функциональность в рамках единого цикла создания, обновления и использования метаданных. В базовом варианте выделяются следующие блоки:
- Метаданное хранилище (Metadata Store) — центральная база данных, в которой хранятся сущности каталога: базы данных, схемы, таблицы, колонки, пайплайны, дэшборды, задачи, владельцы, теги и другие типы объектов. Реализация опирается на устойчивые реляционные СУБД и обеспечивает целостность связей, версионирование схем и поддержку сложных запросов.
- API для метаданных (Metadata API) — слой доступа к данным каталога. Обеспечивает CRUD-операции над метаданными, бизнес-правила и встраиваемую валидацию. API выступает как контракт для остальных сервисов и внешних потребителей, поддерживая RESTful принципы и версии API.
- Интеграционная подсистема (Ingestion framework) — механизм загрузки метаданных из источников данных. Включает коннекторы к источникам (БД, хранилища данных, пайплайны, платформы BI/аналитики) и оркестрацию конвейеров. Коннекторы могут быть готовыми и настраиваемыми, а данные проходят нормализацию к единой модели OpenMetadata.
- Пользовательский интерфейс (UI) — клиентская часть, предоставляющая пользователю видимый каталог, инструменты поиска, фильтрации, управления тегами, обзора lineage и мониторинга качества. UI обеспечивает удобство навигации по объектам, роли и ограничениям доступа.
- Поиск и индексирование (Search) — подсистема индексирования, обеспечивающая быстрый поиск по всем сущностям каталога и их свойствам. Обычно реализуется через встроенный или интегрируемый движок полнотекстного поиска.
- Модуль безопасности и доступа (Security & Access) — реализация аутентификации, авторизации и управление ролями. Поддерживает внешние провайдеры идентификации (OIDC, SAML) и внутренние токены, политики RBAC/ABAC.
- Эвент-брокер и асинхронная обработка (Event Bus & Workers) — обмен сообщениями между сервисами; обработка событий изменений метаданных, уведомления и триггеры для ingestion-процессов.
- Обогащение качества данных (Data Quality & Profiling) — сервисы для анализа качества данных, профилирования и мониторинга соответствия. Включает инструменты проверки правил, создание lineage и уведомления о нарушениях.
- Линия происхождения и связь объектов (Lineage & Relationships) — моделирование взаимосвязей между источниками данных, пайплайнами, моделями данных и потребителями. Визуализация lineage позволяет проследить путь данных и влияние изменений.
- Сервис уведомлений и интеграций (Notifications & Integrations) — механизм оповещений, интеграции с внешними системами (Slack, email, Jira) и автоматизированные действия на основе событий.
Эти компоненты взаимодействуют как единая система через четко определённые контракты. В качестве примера типовой поток данных может выглядеть так: источник данных генерирует событие об изменении схемы; ingestion-подсистема получает это событие, извлекает обновлённую метаданные модель объекта и публикует обновление в Metadata API; UI обновляет представление, а lineage-сервис корректирует связи между объектами и визуализирует новый маршрут данных. Важной характеристикой архитектуры является асинхронность и масштабируемость: ingestion-процессы могут работать независимо от операций в API, а события об изменениях распределяются через шину сообщений, обеспечивая слабую связанность между сервисами.
Чтобы обеспечить надёжность и управляемость, архитектура OpenMetadata опирается на следующие принципы:
- Разделение ответственности: каждый сервис отвечает за ограниченный набор функций и имеет свой жизненный цикл выпуска.
- Контракты между сервисами: строго определённые форматы сообщений и API-версии, позволяющие обновлять компоненты без прерывания работы.
- Расширяемость: поддержка плагинов и коннекторов, которые можно добавлять без изменения базовой инфраструктуры.
- Безопасность по умолчанию: принципы минимальных прав, обязательное логирование доступа и аудита, поддержка внешнего управления идентификацией.
- Надёжность и отказоустойчивость: ретрай-логика, очереди задач, dead-letter очереди и мониторинг состояния.
Компоненты и их роли
- Metadata Store — центральное хранилище, где моделируются сущности каталога, их свойства и взаимосвязи. Важна версия схемы и целостность связей: изменение одного элемента может требовать корректировки зависимых объектов.
- Metadata API — единый входной пункт для манипуляций с метаданными, логики валидации и политики доступа. API обеспечивает согласованный доступ к данным независимо от того, какой источник был источником данных и какой коннектор и ingestion-пайплайн использовались.
- Ingestion framework — набор коннекторов и конвейеров для извлечения метаданных из систем источников: реляционных баз данных, хранилищ данных, потоковых систем, BI-инструментов. Конвейеры обрабатывают данные последовательно: обнаружение источника, извлечение схемы, маппинг к общей модели OpenMetadata, загрузка в Metadata Store.
- Connectors и конвейеры — модульная часть ingestion, позволяющая добавлять новые источники без изменения базовой системы. Хорошая практика — держать коннекторы в отдельном пакетe, внедрять тесты на совместимость и поддерживать обратную совместимость схем.
- UI — интуитивная панель для пользователей: поиск по метаданным, просмотр lineage, управление тегами и владельцами, настройка политик доступа. UI должна оставаться независимой от внутренней реализации, чтобы можно было обновлять фронтенд без влияния на бизнес-логику.
- Search и индексация — инфраструктура, которая обеспечивает быстродействующий поиск по огромному объёму метаданных. В реальных условиях индексирование должно быть инкрементальным и поддерживать обновления в реальном времени или near real-time режиме.
- Security & Access — реализует политики доступа, аутентификацию и авторизацию. Поддерживаются внешние провайдеры идентификации, многоарендность и разграничение прав доступа на уровне объектов и операций.
- Lineage & Relationships — хранение и визуализация связи между объектами: кто владелец источника, какие пайплайны транслируют данные, какие таблицы задействованы в конкретном дэшборде и т. д. Это критически важно для влияния изменений и аудита.
- Data Quality & Profiling — анализ качества данных, профилирование колонок, выявление аномалий и отклонений от норм, а также настройка правил контроля.
- Event Bus и оркестрация — передача уведомлений и команд между сервисами, обеспечение асинхронной работы ingestion-процессов и реакцию на события изменений.
Общая схема взаимодействий между этими компонентами выглядит следующим образом: UI запрашивает данные через Metadata API; ingestion-процессы извлекают данные из источников и отправляют обновления в Metadata Store; события публикуются в Event Bus для уведомления других сервисов; Lineage и Search используют Metadata Store для формирования визуальных и функциональных представлений. Такая архитектура облегчает добавление новых коннекторов, ускоряет реакции на изменения и улучшает прозрачность процессов.
Взаимодействия между компонентами
Возможности OpenMetadata опираются на сочетание синхронных и асинхронных взаимодействий. Взаимодействие между пользователем и системой реализуется через UI, который обращается к Metadata API. Взаимодействие между ingestion-подсистемами и Metadata API основано на событиях: коннектор обнаруживает изменение в источнике, возвращает структурированные данные в стандартной форме, которые затем нормализуются и сохраняются в Metadata Store. При этом события распространяются через Event Bus, что позволяет независимо масштабировать ingestion и запросы пользователей.
- В реальном сценарии ingestion-процессы работают как отдельные задачи (jobs), которые запускаются по расписанию или при наступлении триггера. Их задача — привести представление внешней системы к единой модели в OpenMetadata: привести названия сущностей к общему стандарту, согласовать типы данных, сохранить их в Metadata Store и обновить lineage.
- Взаимодействие с внешними системами реализуется через коннекторы, которые включают адаптацию форматов, сопоставление полей и обработку особенностей источника. Коннекторы должны быть модульными: новые источники легко подключаются, а существующие — остаются стабильными. Это позволяет поддерживать широкую экосистему и не создавать один монолитный конструкт.
- Поиск и визуализация lineage работают в связке с Metadata Store: поиск предоставляет быстрые результаты по всем сущностям, а lineage помогает понять зависимые объекты и влияние изменений. В реальности этот дуэт критически важен для анализа воздействия обновлений схем, миграций и регуляторных изменений.
- Политики безопасности должны быть реализованы как на уровне API, так и на уровне UI. Аудит изменений, журналирования и мониторинга доступа — необходимая часть операционной дисциплины. Это обеспечивает соответствие требованиям регуляторов и внутренним политикам контроля качества.
Технические детали реализации протоколов обмена:
- Взаимодействие между сервисами чаще всего строится поверх REST API с безопасной аутентификацией через OAuth2/OIDC и использованием токенов. Это обеспечивает масштабируемую и безопасную схему авторизации и контроля доступа.
- Для асинхронной коммуникации применяется брокер сообщений; события об изменениях метаданных публикуются в очереди и обрабатываются потребителями. Это позволяет ingestion-процессам и аналитическим сервисам реагировать на обновления независимо друг от друга.
- Форматы данных работают в основном по JSON-уровню: JSON-пayloads используются в REST-вызовах и сообщениях между сервисами. При необходимости возможна интеграция форматов сериализации на уровне коннекторов, но единая модель данных OpenMetadata требует согласованных схем и верифицируемых трансформаций.
Протоколы, форматы данных и обмен сообщениями
OpenMetadata опирается на стандартные протоколы и строгую контрактную архитектуру. Основные принципы:
- RESTful взаимодействие через Metadata API: обращения к каталогу происходят посредством защищённых HTTP(S)-запросов. Это облегчает интеграцию с существующими инструментами и сервисами, включая визуальные интерфейсы и скрипты автоматизации.
- Аутентификация и управление доступом: поддерживаются внешние провайдеры идентификации через OIDC и SAML, а также внутренние механизмы выдачи токенов. Политики доступа — на уровне объектов и операций над ними, с возможностью определения ролей и атрибутов пользователя.
- Обмен сообщениями через Event Bus: события изменений метаданных распространяются между компонентами через брокер сообщений. Это обеспечивает асинхронность, масштабируемость и устойчивость к сбоям. Внутренние сообщения обычно структурированы в JSON-формате с обеспечением обратной совместимости версий схем.
- Форматы данных и сопоставление схем: единая модель OpenMetadata требует трансформации данных из источников в общий набор сущностей и атрибутов. Коннекторы должны поддерживать сопоставление полей и типов, а также нормализацию на уровне маппинга, чтобы сохранить единообразие данных в Metadata Store.
- Взаимодействие с внешними системами: для интеграций с BI- и аналитическими инструментами часто реализуется прокси-слой, который позволяет безопасно демонстрировать данные каталога, пробрасывать требования к безопасности и уведомления на внешние сервисы.
Важной характеристикой является версионирование схем и контрактов. Обновления API или моделей данных должны сопровождаться версионированием, чтобы клиенты могли продолжать работу без сбоев, пока мигрируют на новую версию. В целях совместной эволюции архитектуры необходимо поддерживать обратную совместимость, а также предоставлять миграционные инструкции и автоматизированные скрипты для обновления схем.
Интеграции и сценарии внедрения
OpenMetadata поддерживает широкую гамму интеграций с источниками данных, инструментами визуализации и системами обеспечения качества. В реальных проектах наиболее характерны следующие сценарии внедрения:
- Интеграция с облачными хранилищами и базами данных: в первую очередь подключаются ключевые источники данных (PostgreSQL, Snowflake, BigQuery, Redshift, Google Cloud Storage, Amazon S3 и т. п.). Коннекторы извлекают метаданные об объектах, схемах и зависимостях, которые затем консолидируются в едином каталоге.
- Интеграция с инструментами BI/аналитики: OpenMetadata обеспечивает видимость таких объектов, как дэшборды, панели и источники данных, и позволяет связывать их с соответствующими сущностями в каталоге. Это облегчает управление доступом и отслеживание использования данных.
- Интеграция с системами управления качеством: профилирование и правила качества данных позволяют отслеживать качество данных на протяжении цикла жизни данных, связывая результаты с конкретными источниками и пайплайнами.
- Интеграции с системами мониторинга и аудита: журналы событий, соблюдение требований регуляторов и аудит изменений метаданных становятся частью операционной дисциплины и встроенной функциональности.
Практические сценарии внедрения:
- Быстрое развёртывание в Kubernetes/облаке с использованием готовых образов и минимально необходимого набора коннекторов.
- Пошаговое добавление новых источников через модульные коннекторы и настройку метаданных для них.
- Включение lineage и визуализации для критически важных пайплайнов, что облегчает влияние изменений и ускоряет аудит.
- Настройка политики доступа на уровне объектов и выполнение мониторинга в связке с SIEM и системами уведомлений.
Примеры открытых решений-конкурентов (для сопоставления и выбора подхода):
- Amundsen — открытая платформа каталогизации данных, предлагающая схожие концепции источников, метаданных и lineage.
- DataHub — платформа для управления метаданными с сильной акцентуацией на линейное отображение зависимостей и интеграции с источниками. В контексте OpenMetadata эти решения служат ориентиром в вопросах архитектуры и практик внедрения, но сами по себе не должны заменять специфику вашей корпоративной стратегии и требований к безопасностью и регулятивности.
Сценарии внедрения требуют последовательности действий и соблюдения принципов минимизации риска:
- Этап 1. Идентификация и инвентаризация источников: определить ключевые системы, владельцев данных и регулятивные требования.
- Этап 2. Архитектура целевого каталога: определить набор сущностей, необходимые атрибуты и правила связи между объектами.
- Этап 3. Развёртывание инфраструктуры и базовых коннекторов: построение репозитория метаданных, API, UI и безопасного доступа.
- Этап 4. Настройка ingestion-процессов и валидация моделей: прогон тестовой загрузки, проверка соответствия, настройка правила качества.
- Этап 5. Визуализация lineage и внедрение политик: настройка отображения зависимостей и роли доступа для ключевых групп пользователей.
- Этап 6. Мониторинг, аудит и непрерывное улучшение: организация наблюдаемости, регламентов изменений и процессов обновления данных.
Для устойчивой эксплуатации целесообразно развивать инфраструктуру по шаблону DevOps: управление конфигурациями как код, CI/CD для обновлений модулей и плавные релизы версий коннекторов.
Эволюция архитектуры и расширяемость
OpenMetadata ориентирован на расширяемость и адаптивность. Важными практиками являются:
- Модульность и pluggability — добавление новых коннекторов и функций без изменения существующей инфраструктуры. Плагины могут внедряться как независимые модули, обеспечивая совместимость через общие контракты.
- Версионирование моделей—возможность поддержки нескольких версий схем объектов, что упрощает миграции и совместную работу разных команд.
- Гибкая безопасность — внедрение расширяемых политик доступа, поддержка распределённых сценариев многопользовательской среды, конфигурации RBAC и ABAC в различных контекстах использования.
- Расширяемость lineage — возможность добавлять новые типы объектов и зависимостей, а также визуализации, адаптированные под бизнес-контекст.
- Инструменты мониторинга и наблюдаемости — сбор метрик по каждому компоненту, трассировка запросов, журналирование и наглядные дашборды. Это критично для устойчивости и быстрого реагирования на инциденты.
Практический подход к эволюции архитектуры должен включать:
- Планирование миграций и миграционных стратегий: как обновлять модель данных, не прерывая работу пользователей.
- Архитектурные ревью и управляемые релизы: контроль изменений, тестирование совместимости и rollback-планы.
- Внедрение практик устойчивой эксплуатации: автоматизированные тесты нагрузок, резервное копирование, мониторинг доступности и производительности.
- Обучение и компетенции команд: развитие экспертизы по данным, безопасностям и управлению изменениями в контексте OpenMetadata.
Key takeaways
- OpenMetadata реализует модульную архитектуру, где Metadata Store, API, UI, ingestion-подсистема и сервисы безопасности образуют единое целое, позволяя масштабировать и адаптировать каталог под нужды организации.
- Концепции коннекторов и конвейеров ingestion обеспечивают единообразие модели данных и упрощают добавление новых источников без потрясения существующей инфраструктуры.
- Асинхронность через Event Bus и согласованные контракты между сервисами позволяют эффективно реагировать на изменения, обеспечивая устойчивость и ускорение процессов эксплуатации.
- Безопасность и аудит — фундаментальные элементы, обязательные к реализации на всех уровнях: от запросов к API до визуализации и аудита изменений.
- Эволюция архитектуры должна идти через модульность, версионирование схем и расширяемость политик доступа, что облегчает интеграцию новых источников и сценариев использования.
FAQ
1) Какие основные компоненты у OpenMetadata и какую роль они играют в архитектуре?
OpenMetadata основывается на Metadata Store (хранилище метаданных), Metadata API (интерфейс доступа к данным каталога), UI (веб-интерфейс для пользователей), Ingestion framework (коннекторы и конвейеры для загрузки метаданных), а также неявно связанных компонентах как Search, Lineage, Security & Access и Event Bus. Каждая часть выполняет специфическую функцию: от хранения и доступа к данным до визуализации, контроля доступа и асинхронной обработки изменений. Разделение ответственности упрощает масштабирование и внедрение новых источников.
2) Как обеспечивается согласованность данных в OpenMetadata при добавлении новых источников?
Согласованность достигается через единую модель данных и нормализацию в процессе ingestion. Коннекторы приводят данные источника к общей схеме, затем данные загружаются в Metadata Store через Metadata API. Контракты между сервисами и версионирование схем помогают избегать несовместимостей и позволяют постепенно переходить к новым версиям моделей без остановки работы пользователей.
3) Что такое lineage и зачем он нужен в OpenMetadata?
Lineage — это отображение взаимосвязей между объектами данных: источники, пайплайны, таблицы, дэшборды и потребители. Он необходим для оценки влияния изменений, аудита, обеспечения прозрачности процессов обработки данных и для соблюдения требований регуляторов. Визуализация lineage помогает аналитикам и инженерам быстро идентифицировать зависимости и потенциальные риски.
4) Какие протоколы и форматы используются для взаимодействий между компонентами?
Основные принципы — REST API для доступа к метаданным и управления ими, безопасная аутентификация через OIDC/SAML, а асинхронное взаимодействие реализуется через Event Bus (брокер сообщений). Формат сообщений обычно JSON; возможно использование схем валидации и контрактов версионности, чтобы обеспечить совместимость между обновлениями сервисов.
5) Как организована безопасность и контроль доступа в OpenMetadata?
Безопасность реализуется через аутентификацию пользователей (OIDC/SAML), авторизационные политики (RBAC/ABAC), а также аудит действий и журналирование доступа. В корпоративной среде особенно важно иметь возможность централизованного управления ролями и условий доступа к данным. Взаимодействие через API обеспечивает единый контроль и отслеживание изменений.
6) Какие сценарии интеграции источников данных наиболее распространены?
Наиболее распространены сценарии интеграции с реляционными СУБД, облачными хранилищами, потоковыми платформами и BI-инструментами. Интеграционные конвейеры позволяют извлекать структуры объектов, маппировать их к единой модели, сохранять в каталоге и обновлять lineage. В рамках внедрения важно определить ключевые источники, владельцев и требования к качеству данных.
7) Как OpenMetadata справляется с масштабированием и устойчивостью?
Масштабирование достигается через модульность и независимые сервисы, которые можно разворачивать горизонтально. Очереди и Event Bus позволяют асинхронно обрабатывать изменения, снижая давление на центральное хранилище. Мониторинг, логирование и резервирование критически важны для устойчивости, особенно в условиях высокого объёма метаданных и частых обновлений.
8) Какие практики рекомендуются для внедрения OpenMetadata в крупной организации?
Рекомендуется начать с инвентаризации источников и определения ответственных, затем разворачивать базовый набор компонентов (API, UI, Metadata Store) и постепенно подключать коннекторы. Важно установить политики доступа и аудит на раннем этапе, настроить линейность и качество данных, а также обеспечить CI/CD для обновления модулей. Наконец, следует внедрить мониторинг и механизмы уведомлений для оперативной эксплуатации.
9) Какие ограничения или риски следует учитывать при внедрении?
Сложности интеграции с многочисленными источниками, необходимость строгой архитектурной дисциплины и обеспечения безопасности. Риск несоответствия версий API или моделей данных может привести к временным перебоям в доступе к каталогу. Необходимо планировать миграции, иметь rollback-планы и регулярно обновлять тестовую инфраструктуру.
10) Какие перспективы развития архитектуры OpenMetadata?
Перспективы включают расширение возможностей коннекторов, улучшение поддержки многомерной и многопроцессной обработки, углубление функциональности lineage и управления качеством данных, а также усиление интеграций с внешними системами мониторинга, SIEM и корпоративной аналитикой. Важна поддержка гибкого управления политиками доступа и адаптация к требованиям регуляторов в различных юрисдикциях.


