

Стандарты, протоколы и форматы для наблюдаемости данных
Наблюдаемость данных становится ключевым элементом цифровой трансформации предприятий: она обеспечивает не только качество и доступность данных, но и доверие к принятым на их основе решениям. В условиях роста объёмов данных, разнообразия источников и эксплуатации сложных пайплайнов наблюдаемость должна опираться на четко зафиксированные стандарты, согласованные протоколы и единые форматы обмена сигналами. Эта глава освещает архитектуру наблюдаемости, описывает применяемые форматы и протоколы, формулирует требования к контрактам данных и инцидентам качества, а также предлагает практические принципы внедрения с учётом современных инструментов и тенденций.
Ниже приведён краткий план смысла и содержания главы:
-
Определение архитектурных слоёв наблюдаемости и роли сигналов качества, доступности и доверия.
-
Обзор форматов данных и протоколов передачи наблюдаемости: OTLP/OpenTelemetry, CloudEvents, JSON/Avro/Parquet, схемы и контракты.
-
Контракты данных и управление схемами: версии, эволюция, тестирование качества на ранних этапах и проверки в пайплайнах.
-
Метрики наблюдаемости и принципы их использования для SLI/SLO и предупреждений.
-
Интеграции и архитектурные паттерны: централизацию, контракт-центричность и обеспечение масштабируемости.
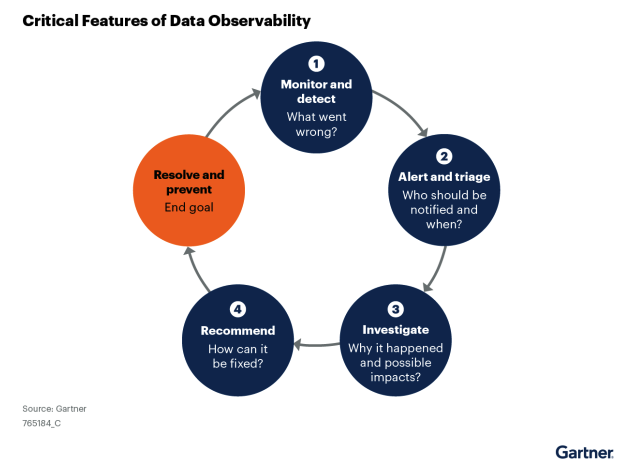
Архитектура наблюдаемости данных: стандарты и слои
Наблюдаемость базируется на трёх взаимодополняющих сигналах: качество данных, доступность данных и доверие к данным. Эти сигналы отображаются в архитектуре через несколько слоёв: источники сигналов, транспорт и интеграцию, обработку и нормализацию, хранение и потребление. В основе лежит идея контрактов между производителями данных и потребителями: сигналы оформляются в единообразной форме и проходят через единый набор интерфейсов.
- Источники сигналов. Источники сигнала могут быть структурированными и неструктурированными: логи потоковых пайплайнов, метрики качества, события об изменении схем, уведомления об инцидентах, та же информация о lineage. Важно, чтобы сигналы имели единый смысл и семантику: например, freshness измеряется в секундах или минутах, completeness — в процентах, drift — в виде отклонения распределений.
- Транспорт и интеграция. Архитектура должна поддерживать гибкость в выборе транспортного протокола: REST/gRPC для команд и конфигураций, Kafka или другой брокер для асинхронной передачи сигналов, OTLP для телеметрии и CloudEvents для унифицированного формального описания событий. В частности OpenTelemetry и OTLP выступают стандартами передачи телеметрических данных: traces, metrics и logs могут передаваться через OTLP в формате Protobuf или JSON.
- Нормализация и обогащение. На этапе преобразования сигналы приводят к общей схеме данных (универсальным схемам, ontology сигналов) и обогащают метаданными: версия контракта, источник, окружение, временная зона, контекст данных. Важно обеспечить совместимость версий сигнатур и минимизировать накладные расходы на преобразование.
- Хранение и доступ. Центральный репозиторий сигнальных данных может включать хранилища времени (“metrics store”), озерные слои для полнотекстовой и гибридной аналитики, каталоги метаданных и индексы для быстрого поиска. Потребители — dashboards, алерты, аналитические сервисы и пайплайны тестирования данных — работают с этим хранилищем через стандартные API и запросы.
- Контракты и управление версиями. Контракты должны быть версионированы, поддерживать мягкую эволюцию схем и безопасное откатывание. В идеале — поддерживать механизмы совместимости «левый префикс» (backward/forward compatibility) и тестовую среду, где новые сигналы проходят прогонку до внедрения в прод.
Фокус на архитектурных принципах: повторяемость, партнёрство между командами данных и инженерии DevOps, и прозрачность. Реализация должна быть ориентирована на минимизацию задержек между событием и его потребителями, на обеспечение устойчивости к сбоям и на контроль изменений в сигналах. Важны также политика управления критическими данными и принципы минимизации использования чувствительных данных в сигналах наблюдаемости с учётом требований регуляторов.
Форматы данных и протоколы передачи наблюдаемости
Чтобы наблюдаемость была эффективной и устойчивой к изменениям инфраструктуры, необходимо единое понимание форматов и протоколов обмена сигналами. В данной секции рассмотрены базовые форматы, стандарты обмена и выбор инструментов, обеспечивающих совместимость между системами.
-
Форматы сигнала. Для сигнальных данных применяют структурные форматы, позволяющие валидировать, сериализовать и десериализовать данные без потери семантики:
- JSON и JSON Schema как лёгкий и широко поддерживаемый формат для сигнальных сообщений, меток и атрибутов. Он хорошо сочетается с гибкими моделями данных и позволяет быстро разворачивать новые сигналы.
- Avro и Parquet — для структурированных и колонно-ориентированных данных в больших объёмах. Они эффективны для пайплайнов, где требуется компрессия, схема-эволюция и встроенная валидация, особенно в рамках data lakehouse.
- Протоколы сериализации для телеметрии: Protobuf (QB) и JSON в OTLP формате, в рамках OpenTelemetry. OTLP поддерживает передачу телеметрии (metrics, traces, logs) и обеспечивает единый контракт между агентами instrumentation и сборщиком.
-
Протоколы передачи и обмена. Эффективная передача сигналов требует унифицированного набора протоколов:
- OTLP (OpenTelemetry Protocol) для телеметрии. OTLP обеспечивает единую модель данных и обеспечивает совместимость между инструментами мониторинга, трассировкой и качеством данных.
- CloudEvents как стандарт описания событий; помогает приводить события из разных систем к единому формату и упрощает маршрутизацию и обработку в потоках.
- REST и gRPC как базовые варианты API для запросов и управления сигнала кластерами наблюдаемости.
- Kafka и другие брокеры сообщений как механизмы асинхронной передачи сигналов, которые позволяют строить масштабируемые и устойчивые к сбоям пайплайны. Важно наличие согласованных схем сообщений и версий.
-
Контракты и схемы. В больших системах сигналы должны сопровождаться описанием схемы и требований к данным:
- JSON Schema и Protobuf/Avro-схемы для сигнатур сигналов. Это обеспечивает валидацию на входе и упрощает миграцию между версиями.
- Конвенции на именование и единицы измерения. Рекомендуется единообразие по именованию сигнатур (например, data_quality_score, freshness_seconds) и единицам измерения (секунды, проценты).
- Контракты данных в виде спецификаций, которые проходят ревью между командами производителей и потребителей. Контракты должны поддерживать версионирование и минимальные требования к обратной совместимости.
-
Примеры форматов. Рассмотрим несколько распространённых сценариев:
- Метрика качества сигнала в OTLP/JSON:
{ "resource": {"service": "orders-service"}, "instrumentation": [{"name": "data-quality"}, {"name": "latency"}], "metrics": [ {"name": "quality_score", "value": 0.97, "unit": "score", "timestamp": "2025-11-01T12:34:56Z"} ] } - Событие об инциденте через CloudEvents:
{ "specversion": "1.0", "type": "com.example.datapipeline.incident", "source": "/data/pipeline/orders", "id": "evt-1234", "time": "2026-01-26T12:34:56Z", "data": { "severity": "critical", "description": "data freshness exceeded threshold", "signal": "freshness", "value": 3600 } } - Контракт качества через YAML Great Expectations (упрощённый фрагмент):
version: 0.13
expectation_suite_name: data_quality_suite
expectations:
- Метрика качества сигнала в OTLP/JSON:
-
expectation_type: expect_column_values_to_be_unique kwargs: column: id
-
expectation_type: expect_column_values_to_not_be_null kwargs: column: order_id
-
Взаимодействие форматов и протоколов. Архитектура наблюдаемости должна обеспечивать:
- возможность конвертации сигналов между форматами без существенных потерь семантики;
- автоматическое верифицирование соответствия сигнала контрактам;
- маршрутизацию сигналов к нужным потребителям в зависимости от типа сигнала и уровня критичности.
-
Выбор технологий. При выборе форматов и протоколов следует учитывать:
- совместимость с существующей экосистемой (облачная платформа, сервисы BI, хранилища);
- требования к задержке, объёму и надёжности передачи;
- потребность в схематизированной эволюции и верификации на уровне схем.
В качестве типичных ориентиров можно упомянуть OTLP/OpenTelemetry в качестве базового стандартa телеметрии, CloudEvents для событий и Apache Kafka как транспорт, когда нужна масштабируемость и устойчивость к сбоям.
Контракты данных: стандарты и эволюция
Контракты данных — это соглашение между производителями и потребителями данных о том, какие сигналы и в каком формате они будут предоставляться. Контракты обеспечивают предсказуемость, снижают риск несовместимости и ускоряют внедрение наблюдаемости. Основные принципы:
- Версионирование контрактов. Каждый сигнал и формат сигнала имеют версию. Потребители должны иметь возможность выбирать, какую версию поддерживает их пайплайн. Производители обязаны сохранять обратную совместимость в рамках текущей версии в течение достаточного времени, чтобы потребители могли обновиться.
- Эволюция схем. При добавлении новых атрибутов или изменении типов следует применять мягкую эволюцию: опциональные поля, дефолтные значения, явное явное указание единиц измерения. При несовместимых изменениях вводится новая версия контракта, а старые версии продолжают работу в устоявшихся пайплайнах.
- Контракты качества. Помимо структуры сигнала, контракт должен описывать ожидаемое качество сигнала: минимальные пороги качества, лимиты задержек, требования к полноте и точности. Это облегчает раннюю инцидент-менеджмент и автоматические проверки.
- Тестирование контрактов. Включение контрактов в CI/CD и в тестовые окружения. Примеры: сигнальные тесты на предмет валидности формата и согласованности значений, тесты на эволюцию схем, тесты на соответствие SLA по задержкам.
- Инструменты и примеры. В реальных условиях полезно использовать существующие инструменты:
- OpenTelemetry/OTLP для телеметрических сигналов, где контракт определяется через схему и метаданные;
- Confluent Schema Registry или аналогичный сервис для управления схемами Avro/Protobuf и их версионирования;
- Great Expectations для формального описания ожиданий к данным и их автоматического прогона в пайплайнах.
Эти принципы позволяют добиться устойчивости наблюдаемости к изменениям инфраструктуры и позволяют бизнесу оперативно реагировать на изменения в данных, не разрушая рабочие потоки аналитики и мониторинга.
Метрики наблюдаемости и управление качеством данных
Эффективная наблюдаемость требует конкретных, легко измеримых и управляемых метрик. Их следует сопоставлять с бизнес-целями через SLIs/SLOs. Основные группы метрик:
- Скорость и задержка. Latency и throughput для сигналов наблюдаемости; время обработки сигнала от момента генерации до попадания в хранилище или до уведомления потребителю.
- Полнота и точность. Completeness и accuracy сигналов. Оценки полноты на уровне источников данных, таблиц и колонок, а также проверка корректности значений.
- Свежесть данных. Data freshness, измеряемая временем жизни сигнала до того, как он становится доступным для потребителя; важна для операций и принятия решений в реальном времени.
- Доверие и согласованность. Drift и consistency checks между источниками и целевыми схемами. Контроль за несовпадениями распределения значений и частотой возникновения отклонений.
- Эффективность пайплайна наблюдаемости. Coverage сигналов и частота срабатывания алертов, точность предупреждений и время восстановления после инцидентов.
- Контекст и качество метаданных. Наличие и полнота метаданных: источник, окружение, версия, контракт, время вставки и т.д. Без контекста сигналы теряют ценность для расследования инцидентов.
Назначение SLI/SLO для данных требует соответствия целям бизнеса. Например, SLO по freshness может быть установлен на 95-й перцентили сигнала об обновлении данных в пределах 5 минут, в то время как SLO по drift может быть задано как минимизация отклонений распределений на уровне ключевых признаков.
Норматив и практический подход: устанавливайте показатели и пороги в рамках конкретного контекста домена (финансы, ритейл, производство) и согласуйте их между командами DevOps, Data и бизнес-аналитиками. Регулярно проводите ревизии целевых уровней сервиса, чтобы учитывать эволюцию пайплайнов, изменений в источниках данных и новые требования регуляторов.
Интеграции и архитектурные паттерны
Для эффективной реализации наблюдаемости необходимы принципы интеграции и единые паттерны, которые обеспечивают масштабируемость и управляемость:
- Контракт-центричный подход. Основной принцип — сначала определить контракт сигнала, затем реализовывать сбор и передачу сигналов. Это снижает риск несовместимостей и упрощает прогонку тестов в продакшене. Контракты должны поддерживать версионирование и тестирование в CI/CD.
- Централизованный observability fabric. Создание центральной платформы наблюдаемости, которая агрегирует сигналы из всех пайплайнов и предоставляет единый вид на качество, доступность и доверие. Такая платформа должна поддерживать хранение, поиск, алерты и визуализацию, а также потребовать минимальные задержки для передачи сигналов.
- Интеграция с инструментами экспертизы данных. Включение инструментов в пайплайны — от тестирования данных (Great Expectations, dbt tests) до lineage (OpenLineage) и мониторинга инфраструктуры. Это обеспечивает закрытие цикла наблюдаемости: от сигнала к контексту инцидента и обратно к бизнес-решению.
- Эвристика контроля изменений. При изменении схем или контракта включать автоматическую миграцию, откат и регрессионные тесты. Встроенный механизм уведомления команд об изменениях в контрактах и схемах.
- Безопасность и управление доступом. Контроль доступа к сигнальным данным, настройка прав на чтение/изменение контрактов, журналирование действий и привязка к политике соответствия (пищевые/персональные данные, регуляторные требования). Наблюдаемость не должна становиться уязвимостью для конфиденциальности.
- Примеры инструментов.
- OpenTelemetry и OTLP — для инструментирования и передачи телеметрии; они формируют широкий стандарт для сигналов и их передачи.
- OpenLineage — для линий данных и зависимостей между операциями в пайплайнах.
- Great Expectations — для декларативных тестов качества данных и автоматизированной проверки сигнальных данных на этапах обработки.
- dbt и его тесты качества — для проверки качественных аспектов данных в трансформациях и связанности контрактов.
Эти паттерны совместимы с облачными и локальными инфраструктурами. Важно поддерживать разумный уровень абстракций: избегать избыточной связанности, чтобы платформу можно было разворачивать и масштабировать в зависимости от потребностей бизнеса.
Внедрение и примеры реализации
Реализация стандартов, форматов и протоколов наблюдаемости требует системного подхода. Ключевые шаги:
- Определение набора сигналов и контрактов. Совместная работа команд Data, Platform и Business для выбора сигнальных метрик, определений полноты, времени задержки и доверия. В контракт нужно включить версии, схему, единицы измерения и инструкции по тестированию сигнала.
- Выбор технологий и архитектурных решений. Определение набора инструментов: OTLP/OpenTelemetry для телеметрии, CloudEvents для событий, JSON/Avro/Parquet для форматов, Confluent Schema Registry или аналог — для управления схемами. Подключение через Kafka для асинхронной передачи и гибких пайплайнов, а также REST/gRPC для управляющих сигналов и запросов.
- Инструментация и пилот. Начать с пилотного набора источников и контрактов в одном домене. В рамках пилота внедрить базовые метрики и алерты, проверить работу сценариев эскалации и устранение инцидентов.
- Управление эволюцией контракта. Разработать процесс согласования изменений в контракте, включая тесты регрессии, миграционные планы и план отката.
- Обеспечение безопасности. Установить политики доступа к сигналам, журналы изменений контрактов и аудит потребления сигналов. Учитывайте требования регуляторов и корпоративной политики по защите данных.
- Мониторинг эффективности. Регулярно анализируйте SLI/SLO по сигналам наблюдаемости, работоспособность инфраструктуры и уровни алертов. Проводите периодическую переоценку форматов и протоколов, чтобы обеспечить соответствие текущим требованиям бизнеса и технологий.
Пример практического сценария внедрения может включать:
- Определение набора сигналов: freshness, completeness, quality_score.
- Внедрение OTLP-совместимого агента на сервисах источников и сборщика в централизованный хранилище.
- Использование CloudEvents для инцидентов и отклонений в сигналах, транспортируемых через Kafka.
- Проверка сигнала через YAML-Expectations (Great Expectations) и JSON Schema для сериализованных сообщений.
- Мониторинг и алерты через единый дашборд, который агрегирует сигналы и SLA по каждому домену.
Key takeaways
- Наблюдаемость данных требует четко зафиксированных стандартов форматов, протоколов и контрактов между производителями и потребителями.
- OTLP/OpenTelemetry и CloudEvents формируют базовую инфраструктуру передачи сигналов, обеспечивая единый язык для сигналов качества, доступности и доверия.
- Форматы данных (JSON, Avro, Parquet) и схемы (JSON Schema, Protobuf) позволяют валидировать сигналы, обеспечивая эволюцию без разрушения потребителей.
- Контракты данных и тестирование контрактов повышают устойчивость пайплайна к изменениям и уменьшают инциденты качества.
- Метрики наблюдаемости должны быть связаны с бизнес-целями через SLI/SLO и управляться через процессы уведомлений и реагирования.
- Интеграции и архитектурные паттерны (контракт-центричный подход, централизованная платформа, lineage) обеспечивают масштабируемость и управляемость в условиях роста данных.
- Практическая реализация требует поэтапного внедрения, управления изменениями в контрактах и внимания к безопасности и соответствию требованиям.
FAQ
-
Что такое наблюдаемость данных и чем она отличается от мониторинга?
Наблюдаемость данных — это способность понять состояние данных и их поведение в системе, основываясь на сигналах качества, доступности и доверия. Мониторинг же чаще фокусируется на конкретных инфраструктурных метриках и alert-генерации. Наблюдаемость объединяет сигналы данных, их контексты и взаимоотношения между источниками, сигналами и потребителями, чтобы можно было не только обнаруживать инциденты, но и быстро расследовать причины и принимать корректирующие решения. -
Какие сигналы следует включать в базовый набор наблюдаемости данных?
Базовый набор включает freshness (свежесть данных), completeness (полнота), quality_score (общая оценка качества), drift (сдвиг распределения признаков) и latency (задержка). Важно также наличие контекстной информации: источник данных, версия контракта, окружение и идентификаторы сигнала. В зависимости от домена можно добавлять сигналы по специфике бизнеса (например, финансовые ограничения, регуляторные требования). -
Как выбрать форматы и протоколы для передачи сигналов?
Выбор зависит от целей: OTLP/OpenTelemetry удобен для телеметрии и даёт единый стандарт для сигнальных данных; CloudEvents полезен для унифицированного описания событий в пайплайне. Для хранения и передачи больших объёмов данных применяют Avro/Parquet с соответствующими схемами. Для асинхронной передачи — Kafka или другой брокер сообщений. Важно обеспечить совместимость форматов между производителями и потребителями и версионирование контрактов. -
Как управлять эволюцией контракта без риска поломки потребителей?
Следует применить версионирование контрактов и поддерживать совместимость в рамках активной версии. По мере необходимости вводить новые версии контрактов и осуществлять миграцию потребителей через тестовую среду. Внести контрактные тесты в CI/CD: валидировать схемы, проверки на полноту и корректность данных. -
Какие метрики использовать для SLI/SLO в контексте наблюдаемости?
Ключевые метрики: latency (время передачи сигнала), freshness (время до доступности сигнала), completeness (процент заполненных полей), drift (степень отклонения распределения сигнала), quality_score (оценка качества). Связать SLA с конкретными доменами: например, для новых пайплайнов в течение первых 30 дней — более строгие пороги, затем их можно адаптировать. -
Какие инструменты рекомендуется использовать в открытом исходнике?
OpenTelemetry (OTLP) и OpenTelemetry Collector выступают базой для телеметрии и передачи сигналов. Great Expectations — для декларативного описания ожиданий к данным и их автоматической проверки. OpenLineage — для отображения зависимостей между операциями в пайплайнах. Дополнительно можно использовать Confluent Schema Registry для управления схемами и обеспечения совместимости. -
Как начать пилот по внедрению наблюдаемости данных?
Начните с двух-трёх критически важных доменов, определите контрактные сигналы, подключите OTLP-агентов на источниках и централизованный сбор сигналов. Внедрите базовые метрики и алерты, настройте CloudEvents для инцидентов и запустите тестовую валидацию через YAML- expectations. Постепенно расширяйте сигналы, схемы и потребителей, поддерживая стабильность и корректный отклик на инциденты. -
Как обеспечить безопасность сигнальных данных и соблюдение регуляторных требований?
Разграничение доступа к сигнальным данным, аудит доступа, маскирование чувствительных полей в сигналах, применение политик удаления и ретенции. Обеспечение соответствия требует документировать политики управления данными и проверять их в рамках CI/CD и аудиторских процессов. -
Нужно ли оставлять возможность отката изменений в контрактах?
Да. В любых изменениях контракта следует обеспечить откат к предыдущей версии без потери данных и с минимальным влиянием на потребителей. Откаты удобнее всего реализовать через хранение версий контрактов и возможность переключения потребителей на конкретную версию контракта. -
Какие риски существуют при внедрении стандартов наблюдаемости и как их минимизировать?
Основные риски: задержки в сборе сигналов, избыточная сложность контрактов, несогласованность между командами, чрезмерная зависимость от конкретных инструментов. Минимизировать можно через поэтапное внедрение, чёткую политику версий контрактов, тестирование изменений и регулярное обучение команд. Проактивное управление изменениями и прозрачная коммуникация помогут снизить риск.
Глава завершает обзор основных стандартов, протоколов и форматов, которые обеспечивают эффективную наблюдаемость данных в современных пайплайнах. Применение этих принципов позволяет добиваться предсказуемого качества данных, надёжности доступности и доверия к данным как к критическому активу бизнеса.
Data Observability — это не техническая инициатива, а инструмент снижения стратегических рисков и повышения прозрачности управления бизнесом. Если вы отвечаете за устойчивость процессов, соответствие требованиям и доверие к аналитике, важно рассматривать наблюдаемость данных в связке с практиками Data Governance — как единую систему контроля, ответственности и измеримых бизнес-результатов.
Перейдите к разделу Data Governance, чтобы понять, как выстроить управляемую модель владения данными, закрепить зоны ответственности и превратить качество и прозрачность данных в конкурентное преимущество.


