

Архитектура Trino: coordinator и workers, кластерные паттерны
Trino занимает особое место в стекe Data Lakehouse: он обеспечивает федеративные запросы к данным разного типа и хранению, включая Iceberg-разделы в разных облаках. Эффективная архитектура Trino строится вокруг четко разделённых ролей узлов — координатора и воркеров — и паттернов развёртывания, которые обеспечивают масштабируемость, отказоустойчивость и управляемость. В данной главе мы детально рассмотрим принципы взаимодействия координатора и воркеров, принципы планирования и выполнения запросов, а также паттерны развёртывания в контексте федеративных запросов к Iceberg-хранилищам в Data Lakehouse.
Trino реализует архитектуру, где координирующий узел отвечает за анализ и планирование запроса, распределение задач между воркерами и сбор результатов. Воркеры исполняют фрагменты выполнения, чтение данных, обмен результатами и локальное кэширование. Такой подход позволяет обрабатывать большие объемы данных, предоставляя единый логический слой над разнородными источниками — объектными хранилищами, Hive-метастором Iceberg и другими каталогами. В контексте Iceberg и federated queries особое внимание уделяется тому, как координация обеспечивает эффективный обмен между узлами, минимизацию shuffle-операций и поддерживает консистентность по времени у читаемых объектов Iceberg.
Данная глава структурирована так, чтобы от теории переходить к практическим аспектам развёртывания и эксплуатации. Вначале освещаются концепции координации и взаимодействия узлов, после — паттерны кластеров и HA, затем — особенности интеграции с Iceberg, включая конфигурации каталогов и метаданные. В конце представлены практические рекомендации по настройке и управлению, а также раздел FAQ с типовыми вопросами и ответами.
- Архитектура Trino: роль coordinator и workers, принципы распределённого выполнения запросов.
- Кластерные паттерны и HA: как выбирать между единственным коорд и несколькими, какие паттерны обеспечивают доступность.
- Интеграция с Iceberg: каталоги, метаданные, версии схем, time travel и кросс-каталоговые запросы.
- Практические конфигурации: параметры памяти, конвейеры выполнения, сетевые настройки и безопасность.
- Технические детали взаимодействий: протоколы, обмен задачами, контроль версий и мониторинг.
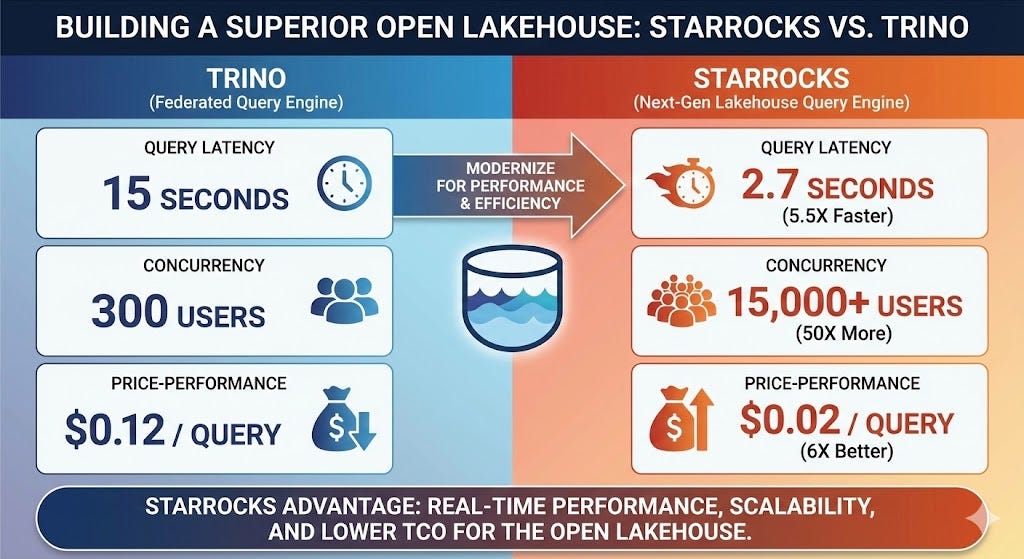
Архитектура и базовые принципы взаимодействия
Trino строится вокруг двух типов узлов: координатора (Coordinator) и воркеров (Workers). Координатор выполняет роль менеджера запроса: получает SQL, парсит и семантизирует его, формирует физический план выполнения и распределяет задачи между воркерами. Воркеры осуществляют чтение данных, выполнение операций над фрагментами наборов данных и передачу промежуточных результатов к другим узлам. Весь обмен данными между узлами реализуется через внутренний RPC-слой, который поддерживает передачу потоков данных, контроль над прогрессом и обработку ошибок. В рамках одной и той же задачи происходит координация по этапам: получение данных из источников, применения операторов фильтрации и проекции, соединения и агрегации, а затем возвращение окончательного результата клиенту.
Ключевые особенности архитектуры:
- Централизованный планировщик: координационный узел осуществляет глобальное планирование и отвечает за составление эффективного плана выполнения, учитывая распределённость данных и доступные ресурсы.
- Распределённая выпоняемость: воркеры исполняют операции в параллельном режиме, обмениваясь статусами и промежуточными результатами через внутреннюю шину сообщений.
- Независимая шкалируемость: кластеры можно масштабировать горизонтально путём добавления воркеров без изменения логики планирования.
- Гибкая маршрутизация запросов: координация может направлять задачи к узлам, ближайшим к данным или с наименьшей загрузкой, что снижает задержки и улучшает пропускную способность.
Эта архитектура обеспечивает практически линейную масштабируемость и позволяет поддерживать федеративные запросы к Iceberg-таблицам и другим источникам, объединяя данные в единый логический слой. В процессе выполнения запросов важна оптимизация траекторий данных и минимизация shuffle-операций, особенно в сценариях, где данные размещены в разных контурах Iceberg, Hive Catalogue или внешних хранилищах.
Уровни взаимодействия между координационным узлом и воркерами можно рассмотреть как три компонента: режим планирования, режим исполнения и режим координации состояния. Планирование отвечает за формирование плана выполнения и разрезание задачи на токены (fragment-сплит), исполнение — за передачу фрагментов на воркеры и сбор результатов, а координация состояния — за мониторинг прогресса, повторную попытку неудачных задач и сброс состояний в случае сбоев. Соблюдение этих уровней критично в интеграциях с Iceberg, где чтение из файловых форматов и обработка транзакций Iceberg требуют согласованности на уровне всего плана выполнения.
# Пример конфигурации для координационного узла (часть конфигурации)
# Файл: etc/config.properties
node.environment=coordinator
http-server.http.port=8080
query.max-memory=50GB
query.max-memory-per-node=8GB
discovery-server.enabled=true
# Пример конфигурации для воркеров
# Файл: etc/config.properties
node.environment=worker
http-server.http.port=8080
query.max-memory=16GB
query.max-memory-per-node=4GB
Такие настройки позволяют обеспечить управляемую среду: коордиратор держит высокоуровневый план и координацию, воркеры — распределённую исполнение. В промышленной эксплуатации важна консистентность конфигураций между узлами, чтобы избежать непредсказуемого поведения в процессе выполнения запросов и предотвращать перегрузку отдельных узлов.
Протоколы взаимодействия и алгоритмы планирования
В Trino коммуникация между узлами основана на последовательной линеаризованной схеме обмена сообщениями. Входящие запросы проходят через последовательность фаз: синтаксический разбор, семантическая проверка, оптимизация и создание физического плана. Далее план разбивается на фрагменты и распределяется по воркерам; каждый фрагмент выполняется локально или удалённо, после чего результаты собираются на координационном узле и формируют итоговый ответ.
Алгоритмы планирования в Trino опираются на современные подходы к распределённому выполнению:
- Разделение полнофункционального запроса на независимые или зависимые фрагменты, которые можно исполнять параллельно на воркерах.
- Привязка к источникам данных с учётом их географического положения и пропускной способности канала.
- Оптимизация соединений и операторов: фильтрация на ранних стадиях, проекции, агрегации, сортировка.
- Управление ресурсами: планировщик учитывает лимиты памяти и вычислительных мощностей на узел, чтобы избежать перегрузки и перегрузки очередей.
- Обработка ошибок и повторные попытки: неудачные фрагменты перезапускаются, а планы адаптируются под текущую загрузку кластера.
Применительно к Iceberg особое внимание уделяется работе с метаданными Iceberg: кэширование списков файлов, чтение манифестов и версиях, а также поддержка времени путешествий (time travel). Хорошее выполнение таких задач требует минимизации чтения из хранилища и эффективной обработки снимков Iceberg, чтобы не растягивать зоны слабой доступности. В контексте федеративных запросов важно обеспечить согласованность между несколькими каталогами данных: IcebergCatalog через HiveCatalog или REST Catalog, и возможно, другие источники (например, Hive/metastore). Планировщик должен учитывать кросс-каталоговый план и возможные различия в моделях данных, чтобы избежать неоптимальных операций перемещения данных между источниками.
Паттерны кластерных развёртываний и High Availability
Развёртывание Trino может быть реализовано в разных паттернах, которые зависят от требований к доступности, стоимости и управляемости. Рассмотрим наиболее распространённые варианты.
- Единый координационный узел, горизонтально масштабируемые воркеры. Этот базовый паттерн обеспечивает простоту настройки и устойчивость к максимальном объёму данных за счёт добавления воркеров. В таком случае коордиратор остаётся «точкой принятия решений», а воркеры расширяются по мере роста нагрузки. Этот подход хорошо подходит для тестовых окружений или небольших продакшн-сред.
- Несколько координационных узлов за балансировщиком. В рамках этого паттерна несколько координационных узлов работают «за одним виртуальным IP» или за нагрузочным балансировщиком. Включение HA-каталога и согласованных стратегий переключения минимизирует время простоя при выходе из строя одного из координационных узлов. Важно обеспечить согласованность конфигураций и единый источник конфигурации каталога.
- Разделение контрольной и вычислительной плоскости с управляемым обменом данными. Иногда применяется более явное разделение: отдельный контроль-плац и независимый набор воркеров, что позволяет масштабировать вычислительную мощность без изменений в управляющей логике, повысить безопасность и упростить аудит.
- Распределённый Discovery и сервис-деградация. В рамках кластерной архитектуры ключевым является наличие надёжного механизма обнаружения узлов и обновления списка доступных воркеров и координационных узлов. В Trino это обычно достигается через сервис-дискавери или внешние системы координации (например, Consul, ZooKeeper), а также через внешние балансировщики нагрузки.
Механизмы HA требуют учёта особенностей Iceberg: каталоги и метаданные Iceberg должны быть доступны независимо от активного координационного узла, чтобы не возникало «слепых» зон на этапе планирования. Одним из практических подходов является использование внешнего метаданного хранилища и обеспечения устойчивости метаданных Iceberg к сбоям через правильную настройку Hive Metastore и consistent read/write.
Мониторинг и управление кластером — неотъемлемая часть эксплуатации. Необходимо реализовать:
- Прозрачный мониторинг загрузки узлов, времени отклика, частоты ошибок и задержек между узлами.
- Тщательный контроль памяти и корректную настройку параметров планирования, включая параллелизм и ограничение памяти.
- Регламентированные процедуры обновления версий и миграций конфигураций без прерывания обслуживания.
Интеграция с Iceberg: каталоги, метаданные и федеративные запросы
Iceberg является одной из наиболее важных форматов таблиц в Data Lakehouse благодаря своей схемной эволюции, управляемым снимкам и поддержке времени путешествий. Trino предоставляет Iceberg‑коннектор, который может работать с несколькими каталогами Iceberg и интегрировать их в один единый слой запросов.
Ключевые аспекты интеграции:
- Каталоги и конфигурации: Iceberg может использовать HiveCatalog, RESTCatalog или иной механизм каталогизации. В зависимости от выбранного каталога, Trino взаимодействует с Iceberg через соответствующий протокол метаданных и файловых систем.
- Метаданные Iceberg: планировщик учитывает снимки таблиц Iceberg, манифесты и версии файлов. Это обеспечивает точность и консистентность запросов, даже если таблицы переживают эволюцию схемы или добавление файлов.
- Time travel и версияция: Iceberg поддерживает временные точки чтения. Trino может выполнять запросы по точке времени или по конкретной версии таблицы, сочетая это с федеративной логикой для кросс-каталоговых сценариев.
- Кросс-каталоговые запросы: через Trino возможно выполнить объединённые запросы между Iceberg-таблицами и другими источниками данных (например, Hive, JDBC‑таблицами или внешними источниками). Это важно в Data Lakehouse, где данные часто находятся в разных реестрах и хранилищах, но должны предоставляться как единый набор.
В практике это означает, что администратор должен обеспечить согласованные конфигурации каталогов Iceberg и каталогов других источников, правильно настроить бумаги безопасности, и учесть влияние времени путешествий Iceberg на распределение выполнения. При работе в федеративной среде проблемой может стать различная задержка чтения из разных хранилищ; оптимизация планирования должна учитывать такие различия, чтобы избежать затратных shuffle-операций.
Пример конфигурации Iceberg catalog:
# Файл: etc/catalog/iceberg.properties
connector.name=iceberg
iceberg.catalog.type=hive
hive.metastore.uri=thrift://metastore-host:9083
Пример конфигурации Hive Catalog (если используется):
# Файл: etc/catalog/hive.properties
connector.name=hive-hadoop
hive.metastore.uri=thrift://metastore-host:9083
Практическое значение Iceberg в контексте федеративных запросов очевидно: упрощение работы с большим числом файловых форматов, поддержка параллельного чтения и чтение из разных версий таблиц. Однако это требует тонкой настройки безопасного доступа к каталогу, согласованных политик авторизации и умелого контроля латентности. Важно также обеспечить корректные схемы для которые поддерживаются Iceberg-телами и привести их в соответствие с общими принципами данных в lakehouse.
Практические паттерны конфигурации и эксплуатационные рекомендуемые решения
Успешная эксплуатация Trino в контексте Data Lakehouse с Iceberg опирается на практические решения, которые включают настройку памяти, параллелизма и сетевых параметров, а также мониторинг и безопасные операции. Ниже приведены ориентиры, которые применимы к большинству продакшн-сценариев.
- Ресурсное моделирование: задавайте разумные пределы памяти для координационного узла и воркеров. Не перегружайте координирующий узел чтением больших объемов данных; усиливайте воркеры, чтобы они могли обрабатывать фрагменты параллельно.
- Конфигурация параллелизма: контролируйте размер разделов (splits) и максимальный уровень параллелизма в зависимости от данных, характера запросов и географической распределённости источников Iceberg.
- Контроль качества данных: используйте проверки метаданных Iceberg и валидаторы schema evolution, чтобы не допускать неожиданных ошибок во время выполнения.
- Безопасность и доступ: управляйте политиками доступа, аудитом и шифрованием на уровне каталога и хранилища, учитывая федеративные сценарии, где данные могут принадлежать различным подразделениям организации.
- Мониторинг производительности: внедрите трассировку запросов, метрики исполнения, и журналирование для выявления узких мест на стадии планирования и исполнения.
- Обновления и миграции: при обновлениях версии Trino и Iceberg следуйте последовательной миграции, тестируя критические сценарии: сложные join’ы, время путешествий Iceberg, большие выгрузки из нескольких источников.
Понимание того, как координационный узел принимает решения и как воркеры исполняют фрагменты запроса, критично для эффективной работы federation в Iceberg. В реальной среде важна обратная связь между планировщиком и исполнителями: задержки в чтении из одного источника следует компенсировать перераспределением плана, обеспечения баланса между узлами и перенастройкой параметров.
Key takeaways
- Координатор и воркеры образуют базовый паттерн архитектуры Trino, обеспечивая эффективное планирование и параллельное выполнение запросов.
- В рамках federation по Iceberg ключевыми являются управление каталогами, метаданными Iceberg и поддержка time travel, что требует аккуратной конфигурации и мониторинга.
- Выбор кластерного паттерна зависит от требований к доступности, объёму данных и географической распределённости источников.
- HA в Trino достигается через конфигурацию координационных узлов за балансировщиком или через несколько координационных узлов с корректной синхронизацией конфигураций и каталогов.
- Оптимизация выполнения требует контроля за параллелизмом, размером фрагментов и стратегиями shuffle, особенно при объединении данных из Iceberg и других каталогов.
- Практическая эксплуатация Iceberg в Trino требует надёжной настройки Hive Metastore и правильной конфигурации каталогов для стабильного чтения и обновления метаданных.
- Безопасность и аудит должны быть встроены в процесс развёртывания: контроль доступа на уровне каталогов, шифрование и мониторинг доступа к данным.
- Подход к конфигурации должен быть документирован и воспроизводим, чтобы обеспечить предсказуемость поведения кластера при изменении нагрузки.
FAQ
Что такое Coordinator и Worker в архитектуре Trino и какие задачи они выполняют?
Ответ: Coordinator — центральный узел управления запросами: принимает SQL, парсит, оптимизирует и распределяет задачи между Worker-узлами. Worker исполняет фрагменты задач, читает данные из источников, выполняет операции и возвращает результаты координирующему узлу. Разделение ролей обеспечивает масштабируемость и устойчивость к сбоям, а также позволяет централизованно управлять планированием и мониторингом.
Как организовать HA в кластере Trino?
Ответ: На практике HA достигается путём развёртывания нескольких координационных узлов, находящихся за балансировщиком нагрузки, и поддерживания согласованных конфигураций каталогов. В случае сбоя одного координационного узла другие продолжают обслуживать запросы. Важно синхронизировать версии и параметры планирования между узлами и обеспечить доступность каталога Iceberg и Hive Metastore.
Какие паттерны кластеров наиболее продуктивны для федеративных запросов?
Ответ: Наиболее распространены паттерны с одним координационным узлом и горизонтально масштабируемыми воркерами, а также паттерн с несколькими координационными узлами за балансировщиком. Выбор зависит от требований к доступности, бюджетам и географическому распределению источников. Для больших федеративных сценариев с высокой нагрузкой рекомендуется паттерн с HA координацией и оптимизированной маршрутизацией данных.
Какие ключевые аспекты стоит учитывать при работе с Iceberg в контексте Trino?
Ответ: Важна правильная настройка каталога Iceberg (HiveCatalog, RESTCatalog и т. п.), доступ к Hive Metastore, поддержка времени путешествий и версии схем Iceberg, а также корректная интеграция с остальными источниками данных. Необходимо обеспечить согласованный доступ к метаданным и минимизацию задержек чтения файлов Iceberg.
Как минимизировать shuffle-операции при федеративных запросах?
Ответ: Эффективная маршрутизация задач к узлам, близким к данным, ранняя фильтрация, уменьшение количества стадий агрегации и агрегация на ранних этапах помогают снизить shuffle. В контексте Iceberg особенно важно учитывать локальные снимки и манифесты, чтобы избежать чтения лишних файлов и перераспределения данных между узлами.
Какие параметры конфигурации критичны для производительности?
Ответ: Параметры памяти на координационном узле и воркерах (query.max-memory, query.max-memory-per-node), лимиты по параллелизму и лимиты по времени выполнения. Также важны параметры сети и конфигурации каталога Iceberg (hive.metastore.uri, iceberg.catalog.type). Правильная настройка балансирует нагрузку и снижает задержки.
Как правильно организовать мониторинг и диагностику?
Ответ: Необходимо внедрить мониторинг загрузки узлов, времени выполнения стадий, частоты ошибок и задержек в коммуникации между узлами. Логи запросов и трассировка выполнения позволяют выявлять узкие места и оптимизировать планирование. Важно также иметь видимые метрики Iceberg (снимки, версии таблиц) и корректно собирать данные об accessed-таблицах.
Как связать Iceberg с другими источниками данных в федеративном запросе?
Ответ: В Trino можно создать несколько каталогов (Iceberg, Hive, JDBC и т. п.) и писать запросы, которые сшивают данные из разных источников. В таких случаях планировщик должен учитывать различия в схемах и типах данных, а также возможные различия в производительности чтения между источниками. Включение корректных конвертаций типов и явных названий схем помогает избежать ошибок на этапе выполнения.
Что важно проверить перед миграцией на новую версию Trino?
Ответ: Совместимость конфигураций каталогов и метаданных Iceberg, изменения в планировщике и исполнителях, новые параметры безопасности и корректная работа с метаданными. Рекомендуется провести регрессионное тестирование на копиях данных и проверить критические сценарии федеративных запросов.
Какие шаги предпринять для безопасной эксплуатации кластера?
Ответ: Прежде всего — внедрить политики контроля доступа к данным на уровне каталога и таблиц, настроить аудит действий пользователей, обеспечить шифрование в хранилище и в каналах связи, а также внедрить мониторинг изменений конфигураций и событий безопасности. Безопасность должна быть встроена в процесс развёртывания и операционного обслуживания.


