

Мониторинг и observability: метрики, логи, трассировка
Об observability в контексте Trino как распределённого движка анализа данных следует говорить системно: наблюдаемость объединяет метрики, логи и трассировку, позволяя не только фиксировать текущее состояние системы, но и диагностировать причины проблем, восстанавливать путь выполнения запроса и формировать данные для управляемого улучшения архитектуры. В условиях разнотипного стека (координатор, воркеры, коннекторы, внешние источники данных) ключевыми становятся единый контекст и стандартизация форматов данных, чтобы любые события и задержки можно было связать между собой. В этом разделе рассматриваются архитектурные решения, выбор технологий и конкретные реализации, позволяющие перейти от концепций к повторяемым сценариям внедрения.
Observability в Trino строится вокруг трёх столпов: метрики дают оперативную картину производительности и загрузки системных компонентов; логи обеспечивают детализированное поведение отдельных узлов и операций; трассировка позволяет отслеживать полный путь запроса по всем этапам выполнения. В сочетании эти элементы дают возможность не только реагировать на инциденты, но и проводить регламентированное профилактическое обслуживание, выявлять узкие места и проводить аудит производительности.
- В этом разделе приводятся архитектурные принципы, типовые стеки наблюдаемости и практические настройки для реального окружения: от локального стенда до продакшн-кластеров Trino в рамках промышленной инфраструктуры.
- Основной акцент сделан на интеграциях с открытыми инструментами: Prometheus для метрик, Loki/ELK для логов и OpenTelemetry с OTLP-экспортёрами для трассировки. Рассматриваются сценарии сбора, агрегации и алертинга, а также принципы корреляции trace_id и контекстов выполнения по всему конвейеру запросов.
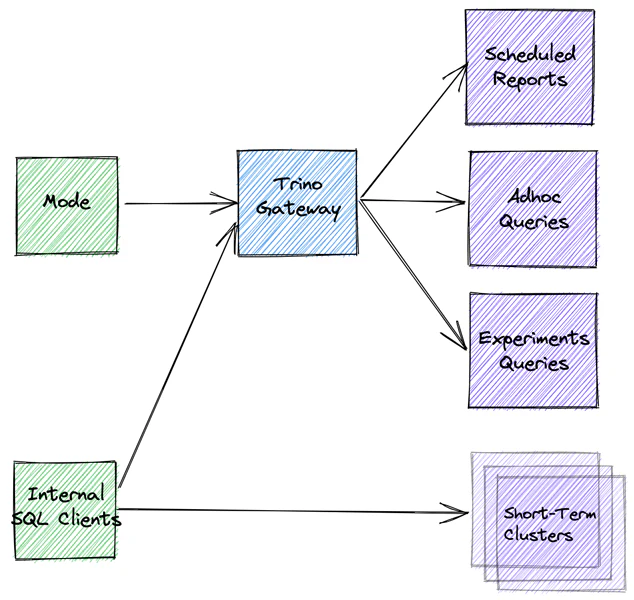
Краткое содержание главы
- Архитектура observability в Trino: принципы, контекст и распределённая природа запросов.
- Метрики: источники, сбор, хранение и использование для производительности и аварийного реагирования.
- Логи: стандарты форматов, структурированность, ротация и поиск по контексту трассировки.
- Трассировка: instrumentation, экспортёры и сценарии end-to-end трассирования запросов.
- Интеграции и процессы внедрения: путь от пилота к продакшн-стеку, роли команд, управление изменениями.
- Практические рекомендации и алертинг: SLIs/SLOs, Alertmanager, политики эскалации и диагностика ядерных проблем.
Введение в observability в контексте Trino
Trino — это распределённая система с координацией между координатором и множеством воркеров. В таком окружении задержки и ошибки могут возникать на любом участке конвейера: планирование запроса, чтение внешних источников, преобразование данных, пересылка результатов. Наблюдаемость должна охватывать все эти слои и поддерживать корреляцию между ними. Архитектурно observability строится вокруг трёх взаимодополняющих аспектов:
- Метрики обеспечивают количественные характеристики: latency, throughput, error rate, очередь планирования, использование процессора и памяти, загрузку коннекторов и источников.
- Логи фиксируют последовательность действий, события, исключения и контекст выполнения. Они позволяют реконструировать поведение узла в shard-рынке или в рамках конкретного запроса.
- Трассировка делает видимым путь запроса через компоненты: от клиента к координации, к воркерам, к источникам данных и обратно. Это критично для сложных запросов с многокаскадной логикой и конвейерами соединений.
Построение единого контекста требует согласованной модели идентификаторов: trace_id и span_id должны сохраняться на всем пути запроса, включая коннекторы к внешним системам. Это позволяет автоматически связывать данные из трёх столпов наблюдаемости и упрощает диагностику.
- Для продакшн-окружения рекомендуются централизованные сборщики метрик, один источник логов и единая трассировочная система. Это минимизирует дублирование и позволяет масштабировать мониторинг без снижения эффективности.
- Важной практикой является минимизация нагрузки на сами узлы Trino за счёт выборочной выборки трасс и разумной политики логирования, чтобы не увеличить задержки в критических путях выполнения запросов.
Метрики: архитектура, источники и сбор
Метрики в Trino включают в себя показатели самой системы выполнения запросов, JVM-метрики, а также сторонних компонентов, таких как кэширование, коннекторы и хранилища. Подход к архитектуре метрик строится на трёх принципах: достоверность и полнота данных, минимальная нагрузка на производительность, и возможность корреляции с логами и трассировкой.
- Архитектура и источники
- Метрики уровня ядра: количество выполненных запросов, среднее и p95 очередей планирования, длительность выполнения этапов (позиции, merge, shuffle), пропускная способность узлов.
- Метрики JVM: использование памяти, garbage collection, thread pools, heap- и non-heap- метрики, которые влияют на задержки и устойчивость.
- Метрики коннекторов и источников данных: задержки чтения, число ошибок подключения, пропускная способность к источникам (HDFS, Hive Metastore, S3, JDBC-источники).
- Метрики кэширования: hit/mallback-частота, размер кэшей и их евентуальные ограничения.
- Сбор и агрегация
- На стороне Trino метрики экспонируются через механизм, совместимый с Prometheus/OpenMetrics или через OpenTelemetry. В продакшн-окружении чаще всего выбирают Prometheus как основной проект по сбору и хранению временных рядов.
- Метрики должны быть агрегированы и нормализованы по единым именам и префиксам, например, trino_query_duration_seconds, trino_executor_queue_size, trino_connector_read_latency_milliseconds и т.д. Это упрощает выборки и алертинг.
- Хранение и алертинг
- Хранение: Prometheus обеспечивает хранение временных рядов с конфигурируемым retention-периодом; для долгосрочного анализа можно использовать хранение на внешних системах (object storage) и экспортеры вниз по стеку.
- Алерты: через Alertmanager на основе пороговых значений p95/p99 задержек, уровня ошибок, задержки к источникам. Важна настройка приоритизации алертов и предотвращение ложных тревог за счёт снижения объёма выборок трассируемых запросов.
- Пример конфигурации (упрощённый)
- В файле config.properties Trino включаются базовые метрики и репортер Prometheus (упрощённые имена свойств для иллюстрации):
metrics.enabled=true
metrics.reporter.prometheus.enabled=true
metrics.reporter.prometheus.port=9090
- Пример конфигурации Prometheus для скрапинга метрик Trino:
scrape_configs:
- job_name: "trino"
static_configs:
- targets: ["trino-coordinator:9090"]
- Пример конфигурации для экспорта JVM-метрик через Prometheus JMX- или OpenTelemetry-экспортер может выглядеть так:
# пример для OTLP экспортера через OpenTelemetry
otel.exporter.otlp.endpoint=http://otlp-collector:4317
otel.metrics.exporter=otlp
- В файле config.properties Trino включаются базовые метрики и репортер Prometheus (упрощённые имена свойств для иллюстрации):
- Важные практики
- Разделяйте глобальные метрики сервиса и специфические для контекста (пул запросов, планировщик, коннекторы). Это ускоряет диагностику в случае регрессов.
- Обеспечьте более детальные метрики для медленных путей; например, отдельные лимитированные наборы метрик по тяжёлым операциям (join, sort, растворение больших таблиц).
- Включайте поверхностные JVM-метрики по умолчанию и настраивайте грамотное хранение логов и трассировок отдельно от метрик, чтобы не перегружать плотность данных.
Логи: стандарты, ротация, хранение и поиск
Логи Trino должны обеспечивать не только сообщение об ошибки, но и контекст выполнения: идентификатор запроса, пользователя, catalog, schema, клиентскую информацию и детальные шаги исполнения. В условиях распределённости это означает внедрение структурированного формата и единых схем трассировки.
- Стандарты и контекст
- Стратегия структурированных логов: ключевые поля должны быть всегда присутствующими, включая trace_id, span_id, query_id, user, catalog, schema, source, и статус выполнения.
- Логи должны поддерживать детальную информацию об этапах выполнения запроса: планирование, чтение данных, переработка, агрегации, shuffle, отправка результатов. Это позволяет реконструировать путь запроса в случае задержек.
- Форматы и ротация
- Рекомендуется использовать структурированные форматы, предпочтительно JSON или компактный, но читаемый бинарный формат через внешний конвертор, чтобы облегчить дешифрование и индексирование.
- Ротация логов должна происходить по времени и размеру файла, с сохранением достаточного количества архивов для аудита. Важен баланс между хранением и скоростью доступа к индексам.
- Поиск и корреляция
- Логи должны легко коррелироваться с метриками и трассировкой. Один и тот же trace_id должен попадать в логи, относящиеся к конкретному запросу, чтобы можно было синхронно проследить влияние различных узлов.
- Инструменты агрегации и поиска, такие как Loki или ELK, хорошо поддерживают структурированные логи и способны индексировать поля, необходимые для фильтрации по trace_id и query_id.
- Пример конфигурации логирования (упрощённый)
- Для логирования в Trino возможно изменение конфигурационных файлов и использование log4j2.xml. Пример конфигурации, обеспечивающей структурированное логирование и включение trace_id в MDC:
<Configuration>
<Appenders>
<File name="LOGFILE" fileName="/var/log/trino/trino.log">
  <PatternLayout pattern="{"time":"${json:time}","trace_id":"%X{trace_id}","span_id":"%X{span_id}","level":"%level","message":"%msg"}"/>
</File>
</Appenders>
<Loggers>
<Root level="INFO">
  <AppenderRef ref="LOGFILE"/>
</Root>
</Loggers>
</Configuration>
- Для логирования в Trino возможно изменение конфигурационных файлов и использование log4j2.xml. Пример конфигурации, обеспечивающей структурированное логирование и включение trace_id в MDC:
- Интеграция логов в стек наблюдаемости
- Loki — удобное решение для структурированных логов, поддерживает быстрый поиск по полям trace_id, query_id и пользователю. ELK-стек хорошо подходит для сложной трансформации и продвинутого анализа, но требует больше администрирования.
- Встраивание логов в контекст трассировки или запроса упрощает диагностику проблем, особенно в многопользовательской среде, где запросы могут идти через несколько каталогов и источников данных.
Трассировка: instrumentation, экспортёры и сценарии end-to-end трассирования
Трассировка позволяет увидеть экстремальные задержки внутри сложного конвейера Trino и связывает работу между координацией, воркерами и внешними источниками. Эффективная трассировка требует не только добавления instrumentation в код, но и правильной настройки экспортёров и политики выборки.
-
Инструментирование и контекст
- Включение OpenTelemetry-ориентированной instrumentation в ключевые точки выполнения: подготовка запроса, планирование, обмен данными между координирующим узлом и воркерами, операции чтения данных в коннекторах.
- Важной задачей является распространение trace_id через все вызовы и контексты, включая внешние источники (HDFS, S3, JDBC-источники и т. д.). Контекст обеспечивает связь между внутренними операциями Trino и внешними системами.
-
Экспортёры и хранение трасс
- OTLP-экспортёры направляют трассировочные данные в единый сборщик (OTLP-приёмник в OpenTelemetry Collector, Jaeger или Tempo). Это обеспечивает центральное хранилище и упрощает анализ.
- Популярные сценарии: Jaeger или Tempo как хранилища трасс, OpenTelemetry Collector как общий брокер и фильтр. В зависимости от требований к задержке и объему данных можно использовать sampling для ограничений объёма трасс.
-
Архитектура и сценарии внедрения
- End-to-end трассировка в Trino предполагает связку клиента — координатора — воркеров — коннекторов — внешних систем. В идеале каждое звено должно передавать trace_id и span_id, чтобы итоговый trace зафиксировал всю последовательность действий.
- Практикой является создание базового набора трасс по типовым запросам: простые сканирования без соединений с внешними источниками, агрегации больших объёмов данных и сложные join-операции. Это позволяет понять, какие участки конвейера являются узкими местами.
-
Пример конфигурации OTLP экспортера (упрощённый)
# Псевдоконфигурация для OpenTelemetry
telemetry.enabled=true
telemetry.exporter.otlp.endpoint=http://otlp-collector:4317
telemetry.exporter.otlp.compression=gzip
telemetry.sampling.ratio=0.25
-
Пример конфигурации OpenTelemetry Collector (упрощённый)
receivers: otlp: protocols: grpc: {} http: {} exporters: jaeger: endpoint: "jaeger:14250" service: pipelines: traces: receivers: [otlp] exporters: [jaeger] -
Роль корреляции trace_id
- Корреляция обеспечивает единую картину исполнения: trace_id может быть включён в лог-сообщения и быть частью метрик. Это критично для быстрого перехода от инцидента к конкретному запросу и контексту его исполнения.
Интеграции и сценарии внедрения
Развертывание observability в Trino требует согласованного подхода между командами DevOps, SRE и аналитиками. Рассматривая сценарии внедрения, следует учитывать масштаб, требования к безопасности и регуляторные ограничения.
- Архитектурные варианты
- Единый кластер наблюдаемости: единая Prometheus + Alertmanager + Loki/ELK + OpenTelemetry Collector. Такой подход упрощает обслуживание, но требует надёжного сетевого доступа между компонентами.
- Разделённые стеки: Prometheus для метрик внутри кластера, Loki/ELK — для логов, OTLP-коллектор, Jaeger/Tempo — для трассировки. Такой подход повышает модульность, но повышает сложность управления связями контекстов.
- Внедрение по шагам
- Этап 1: сбор базовых метрик и логов с минимальным объёмом информации; внедрение trace_id в контекст выполнения запроса.
- Этап 2: подключение OTLP-экспортёров и интеграция с OpenTelemetry Collector; создание первых трасс по типичным запросам.
- Этап 3: настройка алертинга и SLI/SLO; обратная связь с бизнес-аналитикой и защитой от перегрузок.
- Этап 4: аудит и безопасность: ограничение доступа к журналам, шифрование данных в передаче и хранении, политика хранения данных.
- Организационные изменения
- Внедрению observability должны сопутствовать процессы по документированию инцидентов, определению ответственности за обслуживание стеков инструментов и регулярной тренировки команд.
- Введение единого наименования метрик и стандартов логирования упрощает совместную работу и снижает пороги вхождения новых сотрудников.
Практические рекомендации и настройка алертинга
Эффективный мониторинг требует не только сбора данных, но и умелого реагирования. Рекомендуется строить алертинг на уровне бизнес-тангенций и технических указателей.
- SLIs и SLOs
- Определите критические SLA для задержки выполнения типовых запросов (например, p95 latency для крупных запросов не более 2–5 секунд в течение 95% времени) и долю ошибок.
- Включите задержку планирования и время ответа координации: это поможет отделить проблемы планирования от проблем чтения данных.
- Алерты и маршрутизация
- Настройте Alertmanager с политиками эскалации по уровням: оперативная реакция для критических инцидентов (первичные каналы оповещений), менее критичные — в заметке на день.
- Избегайте шумных алертов. Используйте дельта-оповещения и основывайтесь на устойчивых паттернах в данных.
- Диагностика и сценарии реакции
- При задержке запроса сначала смотрите метрики планирования и очередности задач, затем логи на соответствующих узлах и, при необходимости, трассировку для детального анализа.
- Корреляция trace_id с логами и метриками позволяет быстро локализовать узкие места и определить, влияет ли проблема на конкретный коннектор или источник данных.
- Безопасность observability
- Защита данных в трассировке и логах: минимизация объёма чувствительной информации, маскирование полей и шифрование данных при передаче.
- Контроль доступа к инструментам мониторинга и журналам: разграничение прав по ролям и аудит доступа к данным наблюдаемости.
Key takeaways
- Observability в Trino строится на взаимодополняющих слоях: метрики, логи и трассировка, которые должны работать в едином контексте через trace_id и span_id.
- Метрики позволяют мониторить производительность и нагрузку, логи — детально реконструировать поведение узлов, трассировка — видеть путь запроса через весь конвейер.
- Реализация обычно предполагает Prometheus для метрик, Loki/ELK для логов и OTLP- OpenTelemetry-семантику для трассировки, с централизованной агрегацией и алертингом через Alertmanager.
- Внедрение должно происходить по шагам: от базовых метрик и логирования к end-to-end трассировке и формированию SLA/OLAs, с последовательной настройкой алертинга и процедур реагирования.
- Важно обеспечить корреляцию контекстов между всеми компонентами и поддерживать единые форматы данных, чтобы диагностика инцидентов и аудит изменений проходили быстро и надёжно.
- Организационные изменения: моделируйте процессы отвечающие за наблюдаемость, выстраивайте сотрудничество между командами, внедряйте принципы документирования и обучения.
- Безопасность — критична: ограничение доступа, маскирование чувствительных данных и надлежащие политики хранения данных в логах, метриках и трассировке.
FAQ
Какие основные метрики важны для Trino в контексте observability?
- Важны как системные, так и бизнес-метрики: latency по p95/p99 для выполнения запросов, время планирования, очереди на координации, загрузка CPU и памяти на координаторе и воркерах, задержки чтения из коннекторов, частота ошибок и пропускная способность. Кроме того, полезны метрики JVM, такие как GC-паузы и использование памяти, которые напрямую влияют на задержки исполнения.
Как связать трассировку с логами в Trino?
- Встраивайте trace_id и span_id в все логи через структурированные форматы и MDC/глобальные контексты исполнения. Это позволяет сопоставлять конкретный запрос с соответствующими логами и трассировкой. Практически это достигается через единый контекст выполнения запроса, который прокидывается через все слои: координированный поток, воркеры, коннекторы и внешние службы.
Что выбрать для стека метрик: Prometheus vs OpenTelemetry?
- Prometheus хорошо подходит для скриптов и краткосрочного хранения временных рядов, а также для простых алертинг-процессов. OpenTelemetry полезен, когда требуется единый подход к трассировке и метрикам во всём стеке, включая экспорт в OTLP-приёмники и поддержка гибких схем корреляции. В большинстве случаев целесообразна связка: Prometheus для метрик и OTLP/OpenTelemetry для трассировки и расширенных метрик через единый экспортёр.
Как минимизировать нагрузку логирования на производительность?
- Устанавливайте адаптивный уровень логирования, используйте структурированные логи с ограничением объёма полей, применяйте фильтры к логам в зависимости от уровня опасности. Кроме того, логирование не должно влиять на критические пути исполнения. Разграничивайте контекст для траекторий исполнения и избегайте детального логирования в горячих путях.
Что такое correlation_id и как он применяется в Observability?
- Correlation ID — уникальный идентификатор, который передаётся через все компоненты выполнения запроса. Он позволяет связать логи, метрики и трассировки по одной единице выполнения. В системе это обычно trace_id, который распространяется от клиента через клиентские библиотеки, координацию, воркеры и коннекторы.
Как настроить OTLP экспортёр для трассировки в Trino?
- Необходимо включить OpenTelemetry instrumentation и указать OTLP-эндпоинт приёмника трассировок. Пример конфигурации включает активацию telemetry, указание endpoint OTLP, и настройку лимитов выборки. Затем OTLP-пакеты трассировок отправляются в сборщик (OpenTelemetry Collector) или в Jaeger/Tempo, где они хранятся и анализируются.
Как анализировать медленные запросы в Trino?
- Начните с метрик задержек p95/p99 и времени планирования. Затем используйте трассировку, чтобы определить узкие места: время на этапе планирования, задержки при чтении данных из коннекторов, время shuffle и передачу результатов. Логи помогут увидеть конкретные операции и ошибки. В случае повторяющихся медленных запросов рассмотрите оптимизацию источников данных, индексов и конфигураций коннекторов.
Какие практики безопасности важны для observability?
- Шифрование передачи данных между компонентами наблюдаемости, контроль доступа к данным лога и трассировок, маскирование конфиденциальной информации и ограничение объёмов данных, собираемых в метриках и логах. Важно соблюдать политику хранения и удаления данных в соответствии с требованиями.
Какой подход к алертингу предпочтителен в масштабе?
- Используйте многоуровневый подход: оперативные алерты для критических ситуаций, детальные сигналы для инженеров по поддержке и аналитиков, а также периодические синты (snooze) для предотвращения перегрузки команд. Придерживайтесь политики минимальной необходимой информации и устойчивой эвристики на основе SLO/SLI.
Как организовать процесс внедрения observability в крупном кластере Trino?
- Начните с пилота на одном участке кластера, внедрите базовые метрики и логи, затем расширяйте трассировку на более широкий набор запросов. Включите обучение команд по работе с наблюдаемостью, скоординируйте работу DevOps, SRE и data-science команд, чтобы выработать единые стандарты именования и структуры данных. Регулярно проводите ретроспективы инцидентов и обновляйте политики хранения данных и алертинга.
Глава охватывает принципы архитектуры наблюдаемости в среде Trino, конкретные технологии и рекомендации по внедрению. Важно помнить, что цель observability — не просто сбор данных, а создание управляемого знания о поведении системы и возможностях быстрого улучшения её производительности и устойчивости.


