

Планирование запросов: статистика, селекторы и выбор плана
В условиях Open Data Lakehouse подходы к планированию запросов становятся критически важными для обеспечения предсказуемой производительности и эластичной обработки больших данных. В StarRocks механизм планирования объединяет сбор и использование статистики, предикатную фильтрацию на уровне селекторов и детальный выбор физического плана через продвинутый cost-based оптимизатор. Цель главы — разобрать, как эти элементы работают вместе на архитектурном уровне, какие алгоритмы применяются на практике и какие практики внедрения позволяют стабильно достигать низкой задержки и высокой пропускной способности в реальных сценариях.
В современных архитектурах StarRocks выступает связующее звено между хранилищем данных в формате колоночных файлов и исполнительной средой, которая читает данные, применяет предикаты и формирует эффективные планы выполнения запросов. Правильная работа этого звена обеспечивает минимизацию объема данных, считываемых с data lake, и ускорение бизнес-аналитики за счет точной оценки селективности и адаптивной оптимизации на основе статистики и фидбека во время выполнения.
- Архитектура планирования и роль статистики
- Сбор, обновление и использование статистики
- Селекторы и предикатная фильтрация для минимизации данных
- Выбор плана: модели затрат, enumerate и адаптивная оптимизация
Архитектура планирования запросов в StarRocks
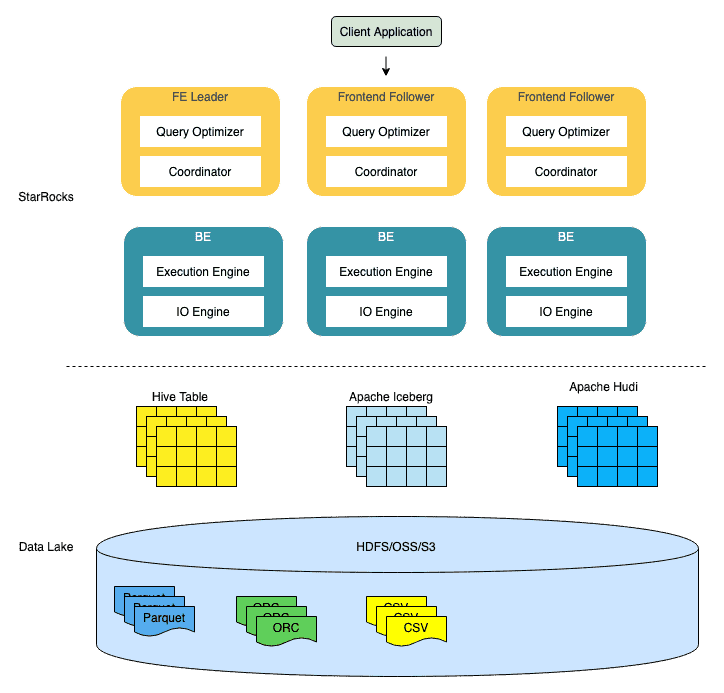
Процесс планирования запросов начинается с разбора SQL и конструирования логического плана, который затем конвертируется в физический план Executable Plan. В StarRocks ключевые компоненты включают парадигму Cost-Based Optimizer (CBO), правила преобразования планов, модули очередей и кэширования планов, а также исполнительный движок, который реально выполняет операторы над данными.
В рамках архитектуры планирования выделяются следующие функциональные блоки:
- Преобразователь запросов: синтаксический разбор, построение абстрактного синтаксического дерева и переход к логическому плану (Relational Algebra). На этом этапе формируются базовые операции выборки, проекции, агрегации и объединения.
- Логический план к физическому: здесь применяется правило- и стоимость-ориентированная оптимизация. Логический план преобразуется в набор физических операторов (сканирование, фильтрация, джойны, агрегации, сортировки). Выбор конкретной реализации операторов зависит от структуры данных, форматов файлов и статистических данных.
- Модель затрат: базируется на оценках стоимости сканирования I/O, CPU-цены на вычисления и память. Важную роль играет точность оценок размера результирующего множества, которое будет обработано на следующем этапе.
- Селекторная часть: механизм, который выбирает, какие части данных и какие источники сканирования будут задействованы. Здесь учитываются статистика столбцов, распознавание предикатов и структура хранения (например, зона-пути, bloom-фильтры, словарное кодирование).
- План-исполнение и адаптация: после формирования физического плана он передается в исполнительный движок. В некоторых сценариях доступна адаптивная оптимизация, когда план может быть доработан во время выполнения на основе динамической информации о размере выборки и реальной селективности.
Почему именно такая архитектура важна в контексте Open Data Lakehouse? Потому что данные хранятся в гигантских колонно-ориентированных файлах (Parquet, ORC), штаты статистики меняются со временем, а предикаты могут быть очень разнородными. Применение CBO с актуальными статистическими данными позволяет StarRocks не только выбирать наиболее эффективный план, но и снижать избыточное чтение данных за счет раннего прогона через предикаты и селекторы.
- Предикатная фильтрация на уровне планирования обеспечивает раннее исключение нерелевантных данных.
- Статистика и селекторы формируют доверительную оценку селективности, необходимую для корректного выбора плана.
- Адаптивная оптимизация и фидбэк-пути позволяют корректировать планы во время выполнения, когда предположения обойдены или статистика устарела.
Пример использования статистики в плане:
ANALYZE TABLE sales PARTITION(dt='2024-01-01');
Сбор и использование статистики
Ключ к эффективному планированию лежит в качестве и своевременности статистики. StarRocks поддерживает различные типы статистических данных, которые в сочетании с продвинутыми методами селектора позволяют точно предсказывать стоимость сканирования и фильтрацию данных.
- Типы статистики:
- Табличная статистика: количество строк, распределение по партициям, размер файлов и общие характеристики набора данных.
- Столбцовая статистика: минимум, максимум, количество NULL-значений, уникальные значения (NDV), приблизительное распределение и гистограммы. Они служат для оценки селективности предикатов по каждому столбцу.
- Гистограммы и зональные карты (zone maps): позволяют раннее пропускание больших сегментов данных на уровне файлов и блоков, если диапазоны значений не пересекаются с предикатами.
- Статистики по распределению частотности словарей и словарные энкодинги: ускоряют фильтрацию через прямые сопоставления и предикаты на кодированных значениях.
- Статистики по партиционности: распределение строк по разделам и файловым блокам, что критично для фильтрации на уровне partitions.
- Сбор статистики:
- Автоматический сбор: система периодически запускает анализ на активных таблицах, поддерживая актуальность статистики в условиях постоянной загрузки.
- Ручной и целевой сбор: администраторы могут инициировать анализ на конкретных столбцах, разделах или таблицах, когда ожидается изменение данных.
- Инкрементальные обновления: по мере добавления новых данных статистика может обновляться частично, чтобы не перегружать систему анализом всей таблицы.
- Использование статистики в планировании:
- Оценка селективности предикатов и выбор оптимального источника данных (сканирование одного или нескольких файлов, части partition).
- Выбор типа сканирования (полный скан vs частичное чтение) и применение предикат-пушдауна на уровне файлов.
- Оптимизация агрегаций и джойнов на основании предполагаемого размера входных данных.
В интеграции со внешними каталогами и форматами данных статистика также играет роль в кросс-слое планировании. Например, при работе с Parquet-данными StarRocks может использовать метаданными из каталога для раннего определения файлового распределения и структурирования фаворитных путей чтения. В Open Data Lakehouse поддержка синхронизации статистики между каталогами и хранилищами упрощает кросс-проекты и обеспечивает единый базис для планирования.
- Частота обновления статистики должна соответствовать характеру нагрузок: высокодинамичные таблицы требуют более частого анализа; статичные или редко обновляющиеся наборы — менее частый анализ.
- Управление устареванием статистики: мониторинг точности оценок и периодическая калибровка моделей помогают сохранить качество планирования.
- Инструменты мониторинга: просмотр Explain Plan, сравнение фактической и прогнозируемой селективности, анализ узких мест выполнения через APQ (Adaptive Query Processing) и анализ ICP (Index-like Cardinality Profiling).
Пример команды анализа столбцов и частей таблицы:
ANALYZE TABLE orders PARTITION(dt='2024-01-01') COLUMNS(customer_id, order_amount);
Селекторы и предикаты: принципы и реализация
Селекторы в контексте планирования — это механизмы, позволяющие определить, какие подмножества данных будут прочитаны и обработаны. Они работают на стыке статистики и структуры хранения данных, обеспечивая эффективную фильтрацию и минимизацию объема ввода-вывода.
- Предикатная фильтрация и фильтрация на уровне чтения:
- Predicate pushdown: предикаты применяются как можно раньше, на уровне сканирования файлов, что ограничивает количество читаемых данных.
- Запросы с несколькими условиями приводят к комбинированной селективности, где точная оценка зависит от статистики по каждому столбцу и их корреляциям.
- Селекторы на уровне данных:
- Zone maps (min-max зональные карты): позволяют пропускать файлы или блоки внутри файлов, если их диапазоны значений не удовлетворяют предикатам.
- Bloom-фильтры: применяются к столбцам с высокой кардинальностью, чтобы исключить целевые файлы без чтения их содержимого.
- Словарная кодировка и фильтры по словарю: ускоряют соответствие предикатов на закодированных значениях.
- Разделение и партиционирование:
- Продуктивная фильтрация достигается за счет эффективнойPartition Pruning: только релевантные разделы читаются на основе значений предикатов по партиционным столбцам.
- Динамическая фильтрация во время выполнения: динамические фильтры, получаемые на одной задаче, могут применяться в последующих стадиях выполнения для дальнейшего сокращения объема данных.
- Применение селекторов в реальном времени:
- В сценариях аналитики с большим количеством агрегаций и группировок селекторы помогают избежать повторного чтения одного и того же набора данных, что особенно важно для многопользовательских сред и ETL-пайплайнов.
Почему селекторы так эффективны? Они основаны на достоверной статистике и структурных особенностях хранения: читая только те блоки, которые действительно могут содержать удовлетворяющие предикаты значения, система существенно снижает I/O и задержки. Встроенная адаптация к характеристикам данных (кардинальность столбцов, распределение значений, частота NULL-последовательностей) дополняет точность предикатов. В результате планировщик может формировать более компактные планы выполнения, а выполнение — идти с меньшими входными объемами.
Пример пояснения предиката с использованием зоны и фильтра Bloom:
SELECT * FROM events WHERE event_date BETWEEN '2024-01-01' AND '2024-01-31' AND country = 'RU';
Выбор плана: модели затрат, enumeration и адаптивная оптимизация
Ключевым элементом в StarRocks является выбор физического плана на основе модели затрат и актуальной информации о данных. Процесс планирования включает в себя несколько этапов:
- Фаза построения альтернативных физических планов: для сложных запросов возможно несколько вариантов реализации операций чтения и обработки данных (различные виды сканирования, соединения, агрегации). Оптимизатор формирует набор кандидатов.
- Оценка затрат: каждый кандидат оценивается по совокупности факторов: IO-стоимость, вычислительная нагрузка, потребление памяти, сетевые расходы, локальность данных и наличие предикатов.
- Выбор на основе минимального бюджета: план с наименьшей суммарной стоимостью считается оптимальным. В реальности часто применяется множественный критерий, учитывающий задержку выполнения и ресурсную устойчивость.
- Роль статистики в оценке: точность статистических данных по столбцам, гистограммам и зонам напрямую влияет на корректность оценок селективности и ширину возможных планов.
- Адаптивная оптимизация: современные запросы могут претерпевать изменения в ходе выполнения. StarRocks поддерживает механизмы динамических фильтров, переформулировку планов и перерасчет прогнозов, если фактические данные существенно отличаются от оценочных ожиданий.
- Планирование на стадии выполнения и объяснение: механизм Explain Plan позволяет аналитикам и администраторам увидеть выбор конкретных операторов и причин выбора того или иного пути выполнения, что упрощает диагностику и настройку.
В контексте Open Data Lakehouse особое внимание уделяется динамике нагрузки и скорости ответа на запросы: планировщик должен адаптироваться к изменяющимся паттернам запросов, к обновлениям в статистике и к изменчивым условиям кэширования. Этим достигается баланс между устойчивостью планирования и гибкостью в условиях эластичной инфраструктуры.
- Практики повышения эффективности:
- Регулярное обновление статистики: настройка частоты и объема анализа в зависимости от данных и требований SLA.
- Мониторинг точности предикатов: сравнение прогнозируемой селективности с фактической, настройка порогов и повторная калибровка моделей.
- Контроль над количеством планов-набора: разумное ограничение числа кандидатов, чтобы не перегружать планировщик и не растягивать время компиляции.
- Внедрение Explain Plan в регламенте миграций и изменений схемы: позволяет заранее оценить влияние изменений на выбор плана.
Ключевым моментом является прозрачность и управляемость моделей затрат. В условиях больших данных и многообразных форматов файлов точность оценки становится критической для устойчивых результатов в реальной эксплуатации. Встроенная поддержка адаптивной оптимизации и фидбека от выполнения запросов позволяет снизить риск ошибок планирования и улучшает предсказуемость исполнения.
Инструменты и практики внедрения
- Параметры настройки планирования: пороги селективности и допустимый диапазон для выбора конкретных стратегий сканирования; режимы экспериментирования (например, включение/отключение динамического прогона).
- Разделение планирования и исполнения: независимое тестирование новых стратегий планирования в тестовых средах, затем постепенное разворачивание в продакшн.
- Валидация планов через explain-планы и ложные противоречия: регулярная проверка соответствия выбранного плана ожидаемому результату и производительности.
- Мониторинг и сигналы тревоги: сбор показателей времени планирования, количества кандидатов, точности оценок селективности и влияния статистики на план.
Пример использования Explain Plan для анализа плана:
EXPLAIN SELECT customer_id, SUM(amount) FROM orders WHERE order_date >= '2024-01-01' GROUP BY customer_id;
Интеграция и эксплуатационные аспекты
В Open Data Lakehouse критически важно, чтобы планирование работало в тесной связке с каталогами метаданных, форматами файлов и процессами загрузки данных. StarRocks обеспечивает интеграцию со стандартными форматами и механизмами каталога, что позволяет корректно рассчитывать и поддерживать статистику в реальном времени.
- Форматы хранения: Parquet и ORC — широко используемые форматы в data lake, которые поддерживают колоночную организацию и эффективное считывание. Планирование учитывает данные форматы и их специфические особенности (разбиение по колоночам, статистики, разделение файлов).
- Каталоги и метаданные: интеграция с Hive Metastore и подобными каталогами позволяет обмениваться схемами и статистикой между системами, что уменьшает дублирование работы и повышает согласованность планирования.
- Эволюция схем: поддержка изменений схемы с минимальным воздействием на существующие планы. При добавлении столбцов или изменении типов StarRocks адаптирует план и статистику.
- Мониторинг и операционная устойчивость: сбор метрик по времени планирования, точности статистики, коэффициента фильтрации и влияния селективности на время выполнения. Эти данные используются для улучшения процессов обновления статистики и настройки планирования.
Чтобы обеспечить эффективное внедрение, рекомендуется:
- Определить политики обновления статистики исходя из скорости изменений данных и требований SLA.
- Организовать процессы тестирования изменений в нюансах планирования в рамках CI/CD сценарием, чтобы минимизировать риск регрессий.
- Включить регулярные проверки Explain Plan как часть аудита производительности и эксплуатации.
- Внедрить мониторинг по ключевым индикаторам качества планирования: точность прогнозов селективности, время компиляции плана, частота использования выбранного плана и влияние на латентность запросов.
Key takeaways
- Планирование запросов в StarRocks строится на триаде: статистика, селекторы и выбор плана, где каждый элемент дополняет другой.
- Точность статистики критически важна для качественного планирования; регулярное обновление статистики и учет данных о распределении значений повышают точность оценок.
- Селекторы — первичное средство уменьшения объема данных за счет зоны карт, Bloom-фильтров и партиционирования, что снижает I/O и ускоряет выполнение.
- Модель затрат в составе CBO обеспечивает выбор оптимального плана с учетом IO, CPU и памяти, а адаптивная оптимизация снижает риск ошибок из-за устаревшей статистики.
- Интеграция с форматами Parquet/ORC и каталогами данных обеспечивает единый подход к планированию и статистике в разных источниках данных.
- Практическая дисциплина внедрения: настройка частоты обновления статистики, мониторинг точности предикатов и регламент Explain Plan помогают поддерживать устойчивость и предсказуемость выполнения.
- Экспериментирование с планами на тестовых средах и четкое отделение планирования от исполнения ускоряют внедрение инноваций и минимизируют регрессию.
FAQ
Как часто следует обновлять статистику и какие факторы на это влияют?
Обновление статистики должно зависеть от скорости изменений данных и требований к точности планирования. Для сильно динамичных таблиц полезна регулярная актуализация (например, еженедельно или по мере загрузок), для статичных наборов — реже. Важно сочетать автоматический сбор статистики с целевым обновлением по ключевым столбцам и разделам, которые чаще всего участвуют в запросах.
Какие типы статистики наиболее влияют на планирование?
Ключевые — столбцовая статистика (min, max, NULL-значения, NDV, гистограммы) и зональные карты. Они определяют селективность предикатов, эффективность предикатного пушдауна и возможность пропускать блоки данных. Также важна партиционная статистика для эффективной фильтрации на уровне partitions.
Что лучше использовать: разделение данных по партициям или динамическую фильтрацию?
Партиционирование полезно, когда запросы часто ограничивают данные по конкретным частям набора. Это позволяет планировать сканирование только релевантных разделов. Динамическая фильтрация дополняет это за счет фильтров на уровне выполнения, используя информации, полученную во время работы запроса, что особенно ценно при неопределенной селективности.
Как селекторы влияют на выбор плана?
Селекторы определяют, какие части данных будут прочитаны, и какие файлы и блоки будут задействованы. Это влияет на выбор сканирования (полный скан vs целенаправленное чтение), вид операторов агрегации и стратегии соединений. Эффективное использование zone maps и Bloom-фильтров может радикально снизить объем обработки.
Что такое адаптивная оптимизация и как она применяется в StarRocks?
Адаптивная оптимизация — это механизм корректировки плана во время выполнения на основе реальной информации о данных и выполнении запроса. Примеры: перерасчет cardinality, применение динамических фильтров, перерасчёт выражений и выбор альтернативных стратегий сканирования. Она уменьшает риск плохих планов из-за устаревшей статистики.
Как планировщик взаимодействует с внешними каталогами и форматами данных?
Каталоги и форматы играют роль в определении структуры данных и метаданных. Характеристики Parquet/ORC и доступ к Hive Metastore формируют корректные предположения о распределении файлов и их статистике. Интеграция каталогов снижает задержки и повышает точность планирования за счет единообразной оценки статистики.
Какие практики мониторинга планирования рекомендуется внедрить?
Рекомендуются: регулярный просмотр Explain Plan и сопоставление с фактическими планами выполнения; мониторинг точности предикатов и реальной селективности; отслеживание времени компиляции планов; регламентированная регрессия тестирования новых стратегий планирования в тестовой среде; документирование изменений и их влияния на SLA.
Какие примеры кода можно привести для иллюстрации обновления статистики?
Типовые команды можно использовать в тестовых и production средах. Например:
ANALYZE TABLE orders PARTITION(dt='2024-01-01') COLUMNS(customer_id, order_amount);
Эти команды демонстрируют как целевые обновления статистики по конкретным столбцам и разделам позволяют точнее прогнозировать селективность и выбрать оптимальный план.
Какую роль играет объяснение планов (Explain Plan) в процессе оптимизации?
Explain Plan позволяет аналитикам увидеть, какие операторы планируются, почему выбран конкретный путь выполнения и какие источники данных используются. Это важный инструмент для диагностики, обучения и итеративного улучшения планирования, особенно после изменений в статистике или форматах данных.
Как изменится подход к планированию при росте объема данных и числа параллельных запросов?
При росте данных и уровне параллелизма необходима более точная статистика и гибкая адаптивная оптимизация. В таких условиях возрастает значимость эффективного селектора и качественного доступа к данным, а также контроля за временем компиляции планов и стабильностью ресурсного профиля. Важна настройка политики параллелизма, раннее планирование и мониторинг узких мест, чтобы сохранить SLA и обеспечивать предсказуемую производительность.


