

Практическая разработка переходного плана для внедрения S3
В условиях современной цифровой трансформации S3 становится не просто хранилищем объектов, но фундаментом для аналитических платформ, управления данными и операционной устойчивости бизнес-процессов. Глава посвящена практическим аспектам перехода к S3: как выстроить архитектуру, какие протоколы и интеграции применить, какие этапы миграции выполнить и как обеспечить эксплуатацию в условиях постоянного изменений бизнес-требований и регуляторной среды.
Соблюдая принципы технической глубины, в главе освещаются архитектурные выборы, схемы интеграций, алгоритмы перемещения данных, а также практики обеспечения доступности, безопасности и мониторинга. Представленные подходы базируются на опыте реализации крупных переходов к S3-ориентированным решениям в среде с высокой ответственностью за данные.
- Что именно изменяется в архитектуре и как минимизировать бизнес-риски перехода.
- Какие этапы миграции позволяют обеспечить безостановочную эксплуатацию и корректную валидацию данных.
- Какие паттерны интеграции с пайплайнами, каталогами и системами аутентификации применяются на практике.
- Как обосновать экономическую эффективность перехода и обеспечить управляемость изменений.
Краткое содержание главы
- Архитектурные принципы переходного плана и целевые архитектуры S3-ориентированных решений.
- Этапы миграции: инвентаризация, выбор стратегий переноса данных, валидация и cutover.
- Интеграции и протоколы: IAM, политики доступа, конвейеры данных, события S3 и триггеры.
- Эксплуатационные аспекты: безопасность, управление данными, мониторинг, стоимость и соблюдение требований.
- Примеры реализации: минимальные конфигурации, подходы к управлению конфигурациями и реальные паттерны.
Контекст и цели переходного плана
Переход к S3 базируется на потребности объединить разрозненные данные в едином слое хранения, обеспечив высокий уровень доступности и масштабируемость. В операционном контексте переход должен обеспечить:
- беспрерывную работу бизнес-процессов в период миграции;
- сохранение целостности и согласованности данных;
- соответствие требованиям безопасности, аудита и регуляторным нормам;
- экономическую эффективность за счет применения оптимальных классов хранения и автоматизации управления жизненным циклом.
Цели переходного плана формулируются на уровне архитектуры, данных и процессов управления. Архитектурно планируемый целевой стек должен обеспечивать:
- устойчивую многорегиональную доступность и репликацию данных;
- единый доступ по стандартам S3 и, при необходимости, совместимость с открытыми протоколами и инструментами;
- интеграцию с инфраструктурой каталогов и контроля версий схем (ETL/ELT-пайплайны, Spark/dbt‑партнёры);
- управляемость за счет видимости в метаданных, контроля изменений и мониторинга.
Ключевые принципы включают: модульность, автономность компонентов, минимизацию риска совместимости на каждом этапе миграции и обеспечение возможности отката. В рамках переходного плана целевые состояния фиксируются в виде архитектурных чертежей, наборов требований по безопасности и бизнес-метрик, которые служат базой для планирования ресурсов и графика работ.
Архитектура S3 как ядра хранилища: принципы и выбор концепций
S3 раскрывается здесь как слой объектного хранения с богатым набором функций, который должен работать как единый интерфейс ко всем данным организации. Основные принципы архитектуры:
- Сilemентальность данных: бакеты (buckets) разделяются по доменам данных, напр. блобы машинного обучения, логи, банки транзакций, медиа-архивы. Ключи объектов проектируются так, чтобы поддерживать предсказуемые паттерны доступа и эффективную компоновку (партирования) при аналитике.
- Безопасность и доступ: управление доступом реализуется через IAM-политики, bucket-полисы и временные креденшелы. Принцип наименьших привилегий обязателен для всех субъектов — пользователей, сервисов и интеграций.
- Управление данными и форматами: поддержка фильтров, схем и форматов данных (Parquet, ORC, Delta Lake). Важна совместимость с каталогом метаданных и систему версионности для обеспечения детерминированной реконструкции данных.
- Механизмы защиты и соответствия: версияция объектов, политики хранения, жизненный цикл и, при необходимости, объектные замки (WORM) для регуляторного соответствия.
- Репликация и приводимость к отказам: многорегиональная репликация с контролируемым временем до восстановления (RTC) и стратегиями синхронизации, которые соответствуют критериям RPO/RTO.
В контексте выбора концепции важно отделять данные по слоям: «сырые», «полуобработанные» и «обработанные» данные. Это упрощает управление стоимостью хранения и позволяет устанавливать разные политики жизненного цикла и форматов в зависимости от класса данных. Кроме того, организация должна предусмотреть связь с каталогами и би—-метаданными, чтобы пользователи и приложения могли легко находить и использовать данные.
Информационные потоки и интеграционные точки:
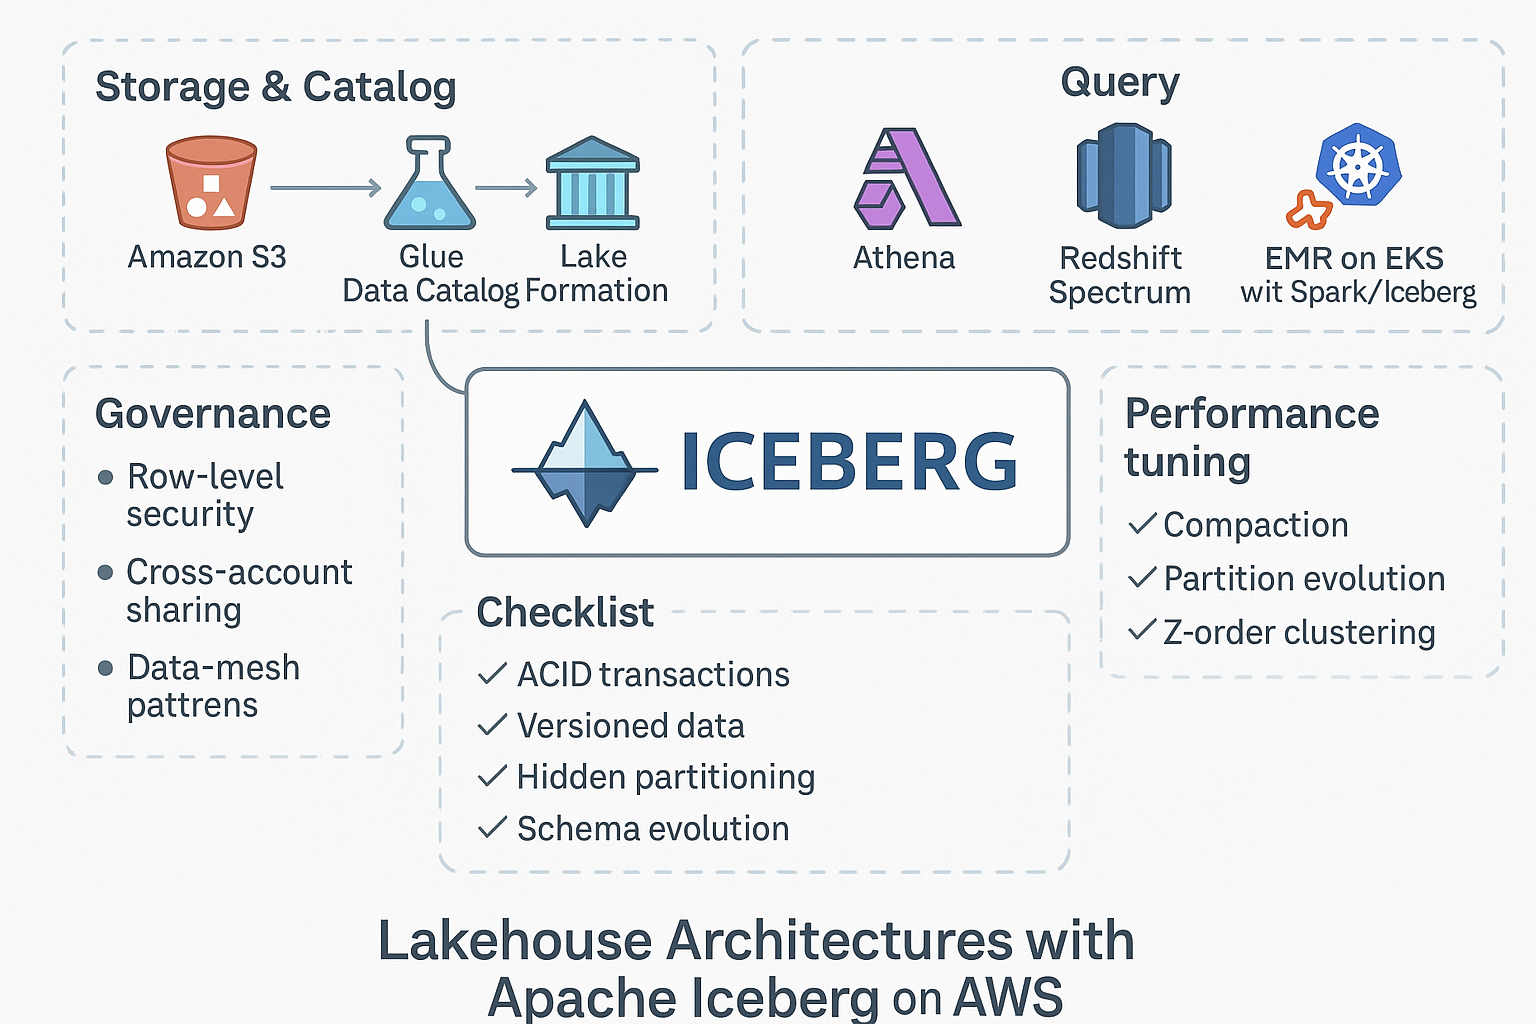
- Интеграция с каталогами (AWS Glue, Apache Atlas, OpenLineage) для поиска и аудита наборов данных.
- Интеграция с конвейерами данных (Airflow, Prefect, dbt), которые запускаются на события и читают данные из соответствующих бакетов.
- Протоколы доступа и аутентификация: S3 API, совместимость с S3-совместимыми сервисами и, при необходимости, мосты для существующих систем Spring/Kerberos-авторизации.
- Механизмы событий: уведомления S3 (Event Notifications) для триггеров в Lambda, Kinesis, Apache Spark, Snowflake и др.
Особое внимание уделяется разделению зависимостей: инфраструктурные сервисы, безопасность и каталоги должны управляться независимо, чтобы изменение на уровне одного слоя не приводило к неблагоприятным последствиям на другом. В рамках перехода следует рассмотреть возможность использования S3-совместимых решений (например, MinIO для стендов разработки) в сочетании с AWS S3 в проде, чтобы снизить сроки тестирования и стоимость экспериментов.
Пример архитектурной конфигурации на уровне высокого уровня:
- Бакеты данных: сырые, полуобработанные, подготовленные к аналитике.
- Каталог метаданных: единая реестрная подсистема (Glue Catalog или Atlas).
- Конвейеры обработки: ETL/ELT-пайплайны с независимым управлением версиями кода и данными.
- Безопасность: IAM, политики bucket, SSE-KMS, логирование доступа, аудит изменений.
- Мониторинг: сбор метрик и событий, алерты по SLA и экологической эффективности.
Технологические элементы, часто применяемые на практике, включают партиционирование по бизнес-властям и временным признакам, применение форматов столбчатой структуры (Parquet, ORC) для эффективной аналитики и поддержки схем на уровне каталога. В зависимости от зрелости данных и требований к скорости доступа можно сочетать S3 с Data Lakehouse-подходами: Delta Lake или Apache Iceberg для обеспечения транзакционной совместимости и поддержки схемной эволюции.
Этапы перехода: миграция, интеграции, управление изменениями
Построение переходного плана начинается с детального анализа текущего состояния:
- Инвентаризация активов данных: какие данные существуют, в каких форматах, какие потребители и какие требования к доступу. Включаются также внешние сервисы, которые зависят от текущего хранилища.
- Классификация данных: критичность, регуляторные требования, требования к откатам и хранению.
- Оценка техник переноса: перепаковывание форматов, изменение схем, миграция индексов и метаданных.
Переход может осуществляться через несколько сценариев, синергия которых обеспечивает безостановочную работу:
- Lift-and-shift с минимальной трансформацией данных: переезд объектов в S3 с сохранением исходной структуры и API. Такой подход эффективен на старте, когда требуется быстрый переход, но требует впоследствии оптимизаций форматов и структур.
- Этапная миграция с конвертацией форматов и переработкой пайплайнов: перенос в пары, перевыпуск пайплайнов, изменение форматов на Parquet/ORC для аналитических задач. Часто применяется для сценариев Data Lakehouse.
- Переход через промежуточные слои: миграция в staging-бакеты, где данные проходят очистку, нормализацию и валидацию перед попаданием в целевые хранилища.
Каждый этап сопровождается набором критериев приемки:
- Контрольные суммы и сверка количества объектов.
- Сопоставление мигрированных данных с каталогами и метаданными.
- Валидность бизнес-метрик: доля данных, доступность и задержки.
- Безопасность: корректная работа политик доступа, аудит и журналы операций.
Ключевые процессы на стадии перехода:
- Инфраструктура как код (IaC): весь конфигируемый стек хранится в репозитории контроля версий; изменения проходят через процесс ревью и тестирования.
- CI/CD для конвейеров данных: автоматизация тестирования пайплайнов, проверка качества данных и регрессионное тестирование на целевых средах.
- Управление изменениями: планирование перехода, коммуникации с бизнес-единицами, управление ролям и ответственностями, кризисный план на случай недоступности.
- Контроль версий схем: эволюция схем и форматов должна происходить через совместимые механизмы с каталогами и пайплайнами.
Примеры архитектурных комбинирований в рамках переходного плана:
- Фаза 1: перенос существующих объектов в S3 без изменений бизнес-логики, включение версионности и базовых политик безопасности.
- Фаза 2: конвертация форматов в Parquet/ORC, настройка перцептивных слоев (staging, curated) и внедрение Data Catalog.
- Фаза 3: внедрение продвинутых механизмов безопасности, аудита и мониторинга, настройка репликации и состава SLA.
Интеграции и протоколы доступа:
- Обеспечение доступа к данным через S3 API и совместимые клиенты, переход на роли и временные креденшелы (STS) для сервисов.
- Настройка событий и триггеров: S3 Event Notifications для запуска функций Lambda, последующей обработки и передачи данных в аналитические системы.
- Связь с конвейерами данных: организация пайплайнов, которые с одного источника формируют готовые наборы данных в целевых бакетах, поддерживая эволюцию схем без потери воспроизводимости.
Ключевые риски и меры управления:
- Риск несоответствия форматов и схем: применяются стратегии этапной миграции и каталогизация; внедряются тесты на совместимость.
- Риск потери данных в процессе миграции: применяются контрольные суммы, фиксация версий и периодические аудиты.
- Риск сбоев в доступности: репликация между регионами, резервный план и детальные процедуры отката.
Пример реализации паттерна интеграции
- Интеграция с каталогом и пайплайнами
- Создается единый набор данных в каталоге, связывающий наборы в S3 с конкретными пайплайнами и отчётами.
- Устанавливаются политики доступа на уровне каталога и бакета, чтобы обеспечить единообразие доступа к данным независимо от инструмента.
- Настраиваются проверки качества данных и мониторинг на этапе загрузки.
# Пример конфигурации Terraform для базовой S3-базы данных
provider "aws" {
  region = "eu-west-1"
}
resource "aws_s3_bucket" "data_lake" {
bucket = "corp-data-lake-2026"
acl    = "private"
}
resource "aws_s3_bucket_versioning" "versioning" {
bucket = aws_s3_bucket.data_lake.id
versioning_configuration {
status = "Enabled"
}
}
resource "aws_s3_bucket_server_side_encryption_configuration" "sse" {
bucket = aws_s3_bucket.data_lake.id
rule {
apply_server_side_encryption_by_default {
sse_algorithm     = "aws:kms"
kms_master_key_id = "alias/aws/s3"
}
}
}
# Пример CLI для базовой миграции и проверки
aws s3 mb s3://corp-data-lake-2026 --region eu-west-1
aws s3 cp s3://legacy-data-bucket /tmp/legacy-data --recursive
aws s3 cp /tmp/legacy-data s3://corp-data-lake-2026 --recursive --storage-class STANDARD_IA
aws s3api put-bucket-versioning --bucket corp-data-lake-2026 --versioning-configuration Status=Enabled
- Пример интеграции с каталогом и пайплайнами
- После загрузки данных формируется запись в каталог (Glue/Athena) с указанием полей, источника и версии.
- Пайплайн запускается по событию загрузки объектов или по расписанию, обрабатывая данные и записывая результаты в следующий слой бакетов.
Важно помнить, что кодовые примеры должен сопровождаться контекстом: они демонстрируют конкретные шаги в рамках выбранной архитектуры и не являются универсальным рецептом для всех организаций. В реальных условиях следует адаптировать примеры под конкретные требования безопасности, регуляторные нормы и технологическую экосистему компании.
Эксплуатационные аспекты: безопасность, доступ, мониторинг, управляемость
Безопасность и соответствие требованиям — краеугольный камень эксплуатации S3 как ядра хранилища данных. Основные направления:
- Управление доступом: least privilege и многоуровневая аутентификация через IAM, bucket-политики, политики ролей и временные креденшелы. Не допускается «широкий» доступ к бакетам; каждая роль имеет ограниченный набор операций и срок действия.
- Шифрование на стороне сервера: поддержка SSE-S3, SSE-KMS и, при определённых сценариях, SSE-C. Включение ключей KMS обеспечивает централизованный контроль над ключами и аудит.
- Контроль версий и хранение данных: включение версий объектов, настройка политики жизненного цикла (перемещение в более дешёвые классы хранения и удаление устаревших версий) и возможность восстановления данных после удаления.
- Защита от несогласованности данных: механизмы аудита через серверные логи и интеграцию с SIEM, мониторинг событий из бакетов, чтобы оперативно выявлять аномалии и попытки несанкционированного доступа.
- Репликация и резервирование: настройка Cross-Region Replication (CRR) и регулируемая RTC для минимизации RPO и RTO в случае региональных сбоев.
- Мониторинг и наблюдаемость: сбор метрик через CloudWatch или альтернативные инструменты (Prometheus/OpenTelemetry), использование Inventory и S3-Inventory для аудита содержимого, оповещения о событиях.
- Управляемость и операционные процедуры: регламенты по инцидентам, периодический аудит политик и роль доступа, политики обновления зависимостей и инструментов, регламенты по обороту ключей KMS и их ротации.
Доступность и производительность также зависят от правильной организации структур данных и паттернов доступа:
- Партиционирование и каталогизация для ускорения запросов и снижения затрат на чтение.
- Выбор классов хранения в зависимости от срока доступности и частоты запросов (Standard, IA, Glacier) с автоматизацией переходов по жизненному циклу.
- Оптимизация параллелизма при загрузке и извлечении больших объёмов данных посредством многопоточной передачи и параллельной обработки.
Соблюдение регуляторных требований и аудит являются частью архитектуры на протяжении всего цикла проекта. В рамках переходного плана следует определить, какие данные подпадают под конкретные нормы (например, хранение персональных данных, регуляторные требования в индустрии финансов, здравоохранения). Внедряются политики сохранения журналов операций и событий доступа, а также механизм контроля версий и изменения форматов.
Примеры реализации и паттерны внедрения
- Паттерн 1: миграция сырых данных без изменения потребительских процессов, затем этапная эволюция.
- Паттерн 2: единый каталог и единая цепочка пайплайнов, поддерживающая разные форматы и ступени обработки.
- Паттерн 3: интеграция с инструментами BI/Аналитики через каталоги и прозрачную доступность наборов данных.
Практические замечания:
- Внедрение S3 не должно происходить в вакууме. Важно синхронизировать переход с изменениями в BI-инструментах, операционных системах и процессах управления данными.
- Резервы на тестирование и пилоты критически важны:-stage окружение должно позволять повторно использовать результаты пилотных проектов.
- В отношении затрат необходимо заранее оценить стоимость хранения, унифицировать политику жизненного цикла и внедрить автоматизированные механизмы оптимизации.
Key takeaways
- S3 выступает как фундамент современного хранилища данных, требующий продуманной архитектуры, скоординированных миграционных стратегий и эффективной эксплуатации.
- Этапы перехода включают инвентаризацию, выбор миграционных сценариев, валидацию и последовательный cutover с минимальным влиянием на бизнес.
- Безопасность, контроль доступа и аудит должны быть встроены в архитектуру с самого старта, с применением версионности и ключей шифрования.
- Интеграции с каталогами и пайплайнами позволяют обеспечить управляемость данными, прозрачность доступов и повторяемость процессов.
- Эксплуатационные практики требуют активного мониторинга, управления жизненным циклом данных и оптимизации затрат через выбор подходящих классов хранения и политики резервного копирования.
- Примеры кода и конфигураций должны применяться там, где они реально упрощают процесс миграции и управления инфраструктурой, а не ради демонстрации.
- В рамках перехода необходимо обеспечить ясную рольовую модель, регламенты и процессы изменения, чтобы минимизировать сопротивление и ускорить принятие новой архитектуры.
FAQ
Какие критерии использовать для определения целевого состояния перехода к S3?
- В рамках целевого состояния следует определить: единый набор бакетов по доменам данных, политики доступа с минимальным уровнем привилегий, требования к шифрованию и аудитам, механизм жизненного цикла и классификацию данных. Также важно определить целевые форматы данных (Parquet/ORC) и каталог, связывающий данные с пайплайнами и потребителями. Критериями успеха являются доступность данных, предсказуемые издержки, корректная репликация и соответствие регуляторным требованиям.
Как выбрать стратегию миграции и минимизировать простой?
- Выбор стратегии основан на критичности данных и допустимых задержках. Lift-and-shift полезен в начале перехода для быстрого обезличивания платформы, затем переход к конвертации форматов и оптимизации пайплайнов. Этапная миграция с параллельной работой старого и нового хранилищ позволяет проверить совместимость и обеспечить корректный cutover. В любом случае следует планировать тестовые миграции, верификацию целостности и повторяемые откаты.
Какие протоколы и интеграции критичны для успешного внедрения?
- Критичны: единая аутентификация и авторизация через IAM, политики доступа на уровне бакетов, интеграция с каталогами метаданных (Glue/Atlas), конвейеры данных (Airflow/Prefect/dbt), а также события S3, которые инициируют обработку и обновления в системе аналитики. Важно обеспечить совместимость с существующими инструментами BI/ETL и возможность перехода между S3-совместимыми средами без потери функциональности.
Как обеспечить безопасность и соответствие требованиям в ходе перехода?
- Необходимо внедрить строгие политики доступа, шифрование на уровне бакетов (SSE-KMS), версионность и аудит доступа, а также логику хранения и удаления в соответствии с регуляторными требованиями. Репликацию между регионами следует настраивать заранее и в рамках регламента по DR. Важно обеспечить детальный план реагирования на инциденты и тестирования процессов восстановления.
Какие паттерны управления данными и каталогами применимы к S3?
- Паттерны включают единый реестр наборов данных в каталоге, связывание данных с конвейерами и потребителями, сохранение метаданных об источниках и качестве данных. Каталоги позволяют управлять схемами и версиями, ускоряя поиск и повторное использование данных. Валидация качества данных на каждом этапе миграции обеспечивает устойчивость аналитических процессов.
Как минимизировать стоимость перехода к S3?
- Оптимизация затрат достигается через грамотный выбор классов хранения, автоматизацию Lifecycle Rules, шифрование и аудит, а также эффективное использование параллелизма и конвейеров. Резервирование и планирование ресурсов позволяют снизить пиковую стоимость. Важна прозрачная финансовая модель и регулярный мониторинг расходов.
Какие риски наиболее критичны и как их управлять?
- Основные риски включают потерю данных, несоответствие регуляторным требованиям, недостаточную совместимость инструментов и непрогнозируемые задержки миграции. Роль планирования, тестирования, аудита и регулярных проверок особенно велика. Риск нейтрализуется посредством детального чек-листа миграции, staged rollout и наличия откатных сценариев.
Как обеспечить устойчивую эксплуатацию после перехода?
- После перехода следует внедрить: постоянный мониторинг, регулярное обновление политики доступа, управление жизненным циклом, аудит и регулярные проверки соответствия. Важно поддерживать документацию по архитектуре и операционной деятельности, а также поддерживать компетенции команды через обучение и практикум по управлению данными в S3.
Какие сценарии интеграции с бизнес-подразделениями наиболее распространены?
- Наиболее характерные сценарии: анализ больших массивов логов, хранение файлов и медиа-контента, финансовые и регуляторные архивы, машинное обучение и хранение датасетов для обучения моделей. Все эти сценарии требуют единых стандартов доступа, согласованных форматов данных и конвейеров обработки, что достигается через стратегическую интеграцию с каталогами и пайплайнами.
Какие шаги предпринять на первых 90 днях после начала перехода?
- Пройти через этапы инвентаризации, определить целевые конфигурации бакетов и каталога, запустить пилотную миграцию на части данных, внедрить базовые уровни безопасности и мониторинга, провести первую аттестацию данных, закладывать план расширения и внедрить процессы управления изменениями. По мере продвижения следует расширять паттерны интеграций и оптимизировать затраты, опираясь на полученную обратную связь от бизнес-единиц и пользователей.
Глава завершается систематизированной картой перехода к S3, охватывающей архитектурные принципы, этапы миграции, механизмы интеграции и эксплуатационные практики. В этом контексте ключевым является не только «как перенести данные», но и «как управлять данными» в рамках новой технологической парадигмы, чтобы обеспечить устойчивость, гибкость и конкурентное преимущество компании в цифровой эре.


