

Data drift: виды дрейфа и методы обнаружения
Краткое введение
Дрейф данных остается одной из ключевых причин деградации пригодности ML-моделей к продакшен-среде. В рамках курса «Мониторинг ML-моделей в продакшене контроль качества прогнозов, data drift, model drift и бизнес-метрик» мы систематизируем понятия, виды дрейфа и методы их обнаружения, а также предлагаем архитектурные подходы к автоматизации мониторинга. Цель главы — дать инженерам, архитекторам и руководителям ясный набор инструментов: как дрейф выявлять, как реагировать на него и как встроить обнаружение дрейфа в процессы обеспечения качества прогнозов и бизнес-метрик.
Введение
Дрейф данных описывает изменение распределений входных признаков, целевой переменной или идущих в модель сценариев использования со временем. Под этим скрываются не только статистические сдвиги, но и последствия для точности, устойчивости и полезности прогноза. В продакшен-средах дрейф может происходить постепенно или резко, охватывать как отдельные признаки, так и целые поддомены данных, влиять на разные целевые метрики и вести к ложным сигналам тревоги или, наоборот, к запоздалым реакциям. Именно поэтому задача мониторинга дрейфа должна быть не разовым анализом, а частью автоматизированной инфраструктуры наблюдения за моделью и данными.
Теоретические основы и терминология
- Data drift (дрейф данных) — изменение распределения входных данных или признаков во времени. Это может включать сдвиги в распределении отдельных признаков (mutual drift), а также изменение корреляций между признаками.
- Concept drift (дрейф концепции) — изменение отношения между входами и целевой переменной, когда истинная функция по мере времени меняется.
- Model drift (дрейф модели) — деградация качества модели в продакшене вследствие дрейфа данных, а также из-за обновления данных, гиперпараметров или окружения.
- Covariate shift — частный случай data drift, когдаDistribution of features изменяется, но условное распределение целевой переменной при данных не изменяется.
- Target shift — изменение распределения целевой переменной при статистически одинаковых признаках.
- Drift detection vs monitoring — дрейф-детекторы пытаются определить, есть ли существенные изменения в распределениях, тогда как мониторинг может оценивать влияние этих изменений на бизнес-метрики и качество прогнозов.
- Типы дрейфа:
- Признаки (feature drift) — изменение распределения отдельных признаков.
- Распределение совместных признаков (joint drift) — изменение зависимостей между признаками.
- Целевая переменная (label drift) — изменение распределения целевой переменной в реальном мире.
- Дрейф вариации по группам (group drift) — различия между сегментами пользователей, регионов или устройств.
- Влияние дрейфа на бизнес-метрики — снижение точности прогнозов может приводить к неверным решениям, увеличению расходов, ухудшению клиентского опыта и штрафам за недостоверные прогнозы.
Методологии и подходы
- Статистические тесты двух образцов:
- Kolmogorov–Smirnov (KS) тест для непрерывных признаков.
- тесты Хи-квадрат для категориальных признаков.
- Вычисление расстояний между распределениями: Wasserstein (Earth Mover’s), Jensen–Shannon divergence, KL-divergence.
- Индексы и меры дрейфа:
- Population Stability Index (PSI) — показатель стабильности распределения признаков между двумя периодами; пороговые значения для тревоги (0.1 — слабый, 0.2 — заметный, >0.3 — критический в зависимости от контекста).
- Earth Mover’s Distance (Wasserstein) — более чувствителен к изменениям в распределении по всем точкам.
- Jensen–Shannon divergence — симметричная мера различий между двумя распределениями.
- Дрейф-детекторы и онлайн-алгоритмы:
- ADWIN (Adaptive Windowing) — адаптивное окно, которое обнаруживает резкие изменения среднего значения в потоках.
- DDM и EDDM (Early Drift Detection Method, Early Drift Detection Method) — чувствительны к изменению ошибок и частоты ошибок.
- Page-Hinkley — тест на изменение среднего значения сигнала.
- ADS/Drift detectors основанные на вероятностной постановке задач (Bayesian drift detection).
- Методы для мониторинга модели:
- Контроль точности и бизнес-метрик в реальном времени (AUC, µRMSE, log loss, F1, precision/recall) и их отклонения от baseline.
- Сравнение распределений входной выборки и актуальных предсказаний между периодами времени.
- Мониторинг стабилизации данных через PSI на входах и таргете.
- Практические подходы:
- Выделение "первых признаков" дрейфа: определение самых изменившихся признаков и влияния на качество модели.
- Разделение мониторинга на слои: данные, признаки, предсказания, результаты.
- Валидационные тесты с повторной калиброкацией (recalibration) при обнаружении дрейфа.
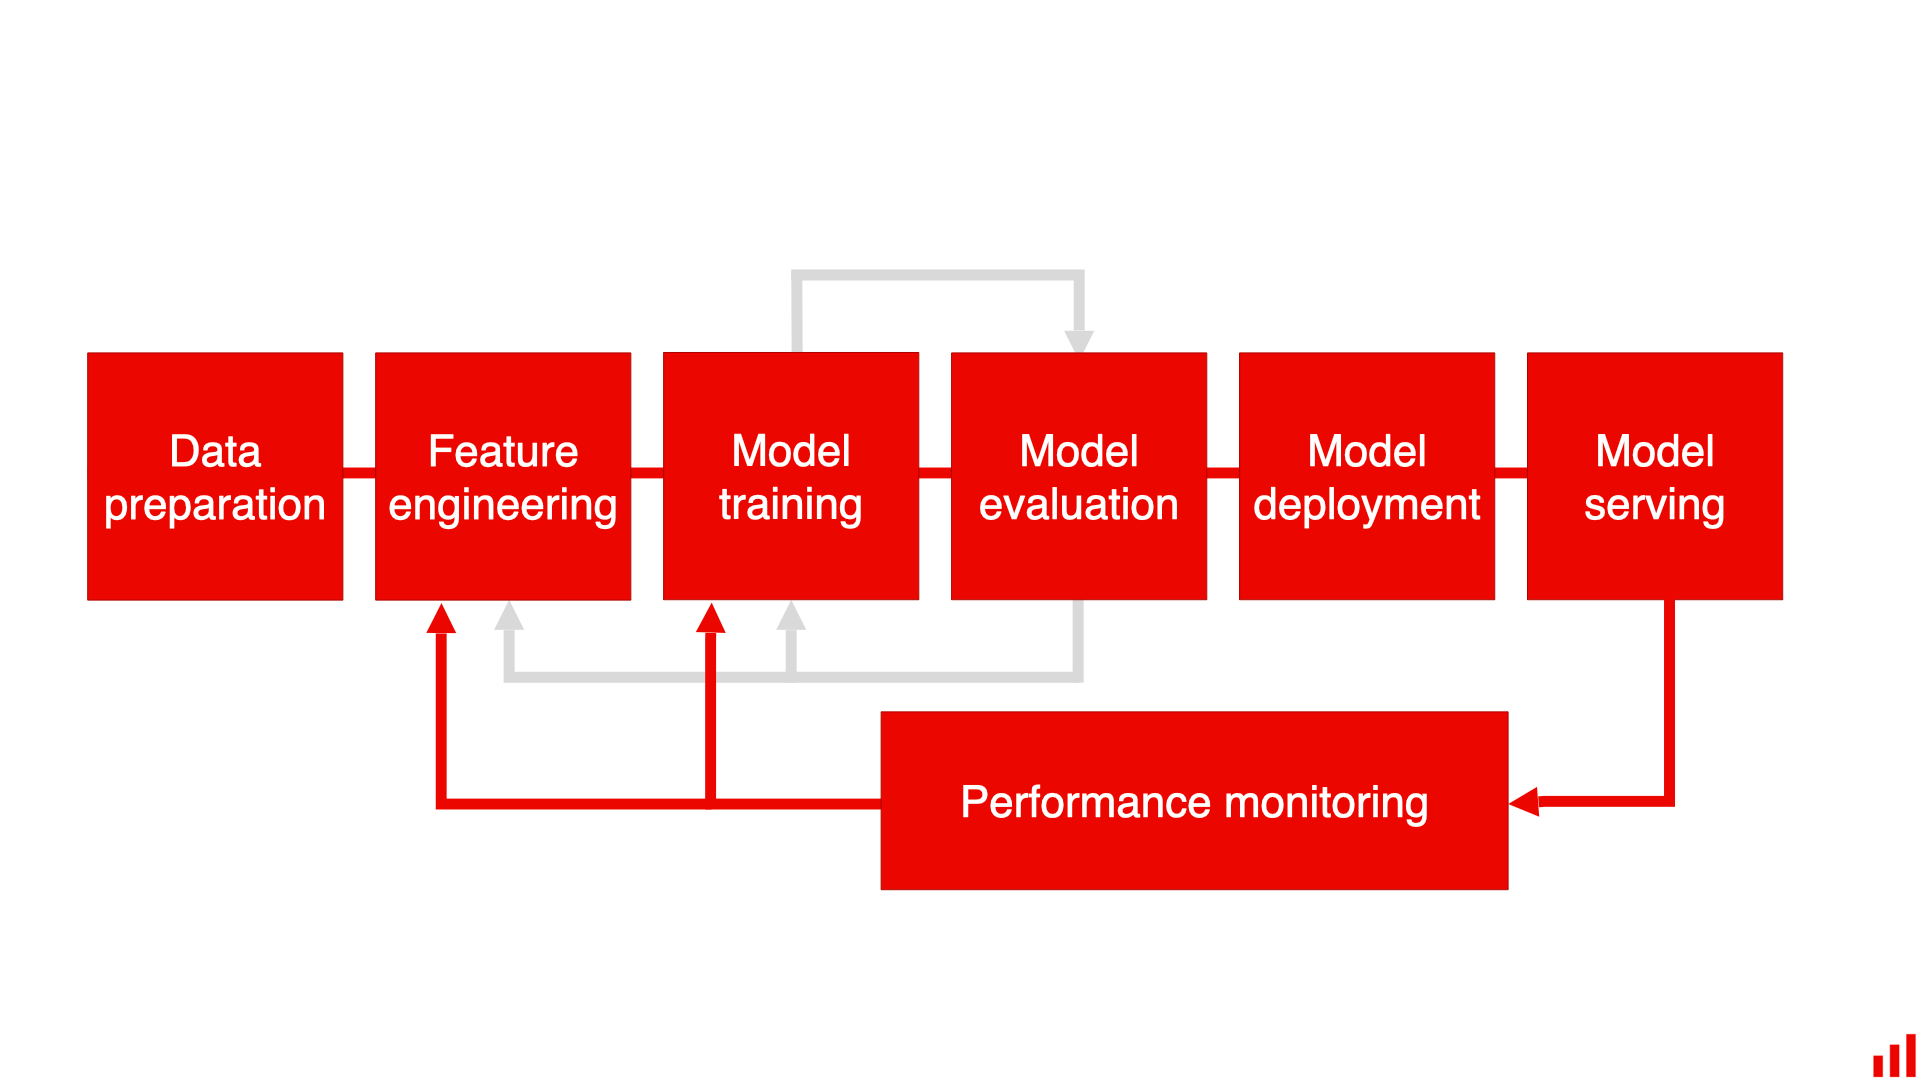
Архитектура и технологическая реализация
- Общий стек:
- Источники данных: потоковые (Kafka, Kinesis) и пакетные (Spark, Hadoop) источники.
- Платформа обработки: PySpark, Apache Flink, Faust или Apache Beam для реального времени.
- Модуль дрейф-детекции: отдельный сервис или микросервис, интегрированный с пайплайнами данных и моделями.
- хранилища и регистры: метаданные о данных и моделях (feature store, model registry), хранилища артефактов.
- Панель мониторинга: Prometheus + Grafana, ELK/Elastic, а также фирменные дашборды для бизнес-метрик.
- Архитектурный шаблон microservices:
- Data Drift Service: принимает поток признаков, рассчитывает статистические метрики и уведомляет об изменениях.
- Model Quality Service: сравнивает текущие прогнозы с историческими, регистрирует деградацию.
- Alerting and Orchestration: правила тревог, автоматические триггеры в пайплайны обновления модели.
- Встроенный feature store и lineage:
- хранение и версионирование признаков, контроль версий данных.
- связь между входами, предсказанием и бизнес-метриками.
- Интеграции и протоколы:
- REST/GRPC API для экспорта метрик дрейфа и статусов.
- событийный подход: публикация событий о дрейфе в очередь (Kafka) для последующей обработки.
- согласование частоты обновления: периодический режим (daily/shift-based) и онлайн режим (streaming).
- Примеры реализаций и инструментов:
- Open-source: Alibi Detect (дрейф по входным признакам, на основе статистических тестов и адаптивных окон); Evidently AI (модуль мониторинга качества, дрейф по данным и моделям; PSI и дрейф-метрики в дашбордах); NannyML (оценка влияния дрейфа на качество модели и воспроизводимость). Для реализации можно использовать также scikit-learn, SciPy, Apache Commons.
- Российские решения и экосистемы: Яндекс DataSphere и платформа MLOps в нескольких крупных компаниях — инструменты мониторинга моделей и данных, интеграционные конвейеры для сбора метрик дрейфа и бизнес-метрик, а также внутренние сервисы банков и телекомов. В рамках курса можно рассмотреть примеры использования подобных платформ в реальных кейсах, а также локальные решения от отечественных поставщиков, ориентированные на требования к безопасности и регуляторике.
- Пример инфраструктуры на уровне кода (псевдореализация):
- сбор данных и расчёт PSI для номинальных признаков;
- оценка распределений признаков и метрик модели на каждой итерации;
- триггер уведомления при выходе за пороговые значения.
Пример кода вышеописанных задач представлен в разделе «Технические детали реализации».
- Навигация по типовым сценариям:
- DDL-дрейф (data drift) в большинстве случаев — проводится анализ распределения входных признаков и их совместных зависимостей.
- Drift в целевой переменной (target drift) — требует отдельного внимания, так как влияет на пороги отклика и калибровку.
- Групповой дрейф — выявление региональных, демографических или продуктовых различий, влияющих на качество предсказания.
Организационные и процессные аспекты
- Встроенные процессы управления дрейфом:
- SLAs по времени обнаружения дрейфа и времени реакции на сигнал тревоги.
- Data quality gates — пороги качества данных, которые должны быть соблюдены перед запуском новой версии модели.
- Change management: процедура обновления моделей с учетом результатов дрейф-анализа; откат в случае ухудшения бизнес-метрик.
- Роли и ответственности:
- Data Engineer: обеспечение качества входных данных, поддержка feature store и lineage.
- ML Engineer/ML Ops: настройка drift-детекторов, мониторинга, алертинга и автоматического/полуавтоматического обновления моделей.
- Data Scientist: интерпретация причин дрейфа, анализ влияния на целевые метрики, подбор корректирующих действий.
- Product Owner и бизнес-аналитик: трансляция изменений в бизнес-контекст, оценка влияния на KPI и пороги для бизнес-инстанций.
- Процессы управления инцидентами:
- Регистрация инцидента дрейфа с контекстом и примерами.
- Временные рамки для анализа и принятия решения: обновление модели, перекалибровка порогов, изменение данных.
- Документация и постмортем: разбор причин дрейфа, произошедших обновлений и их влияния на метрики.
- Политика хранения и использования данных:
- Регламент по хранению версий данных, признаков и моделей.
- Соблюдение регуляторики: персональные данные, журналы доступа, аудируемые события.
Практические примеры и кейсы (open-source и российские решения)
- Примеры open-source проектов:
- Alibi Detect: детекция дрейфа в онлайн и офлайн режимах, поддержка нескольких тестов для признаков и распределений, инструмент для валидаций на проде.
- Evidently AI: модуль мониторинга для Data Drift, Model Drift и качества данных, готовые дэшборды и отчеты; позволяет сравнивать данные между периодами и визуализировать влияние на бизнес-метрики.
- NannyML: оценка влияния дрейфа на предсказательную способность модели, анализ ошибок и точности на выборке тестирования, поддержка сценариев на продуктивной инфраструктуре.
- Российские решения и кейсы:
- Яндекс DataSphere (платформа для MLOps, мониторинга и аналитики, включая инструменты контроля качества данных и наблюдения за дрейфом). Применение в организациях для отслеживания стабильности данных и корректной эксплуатации моделей в проде.
- В рамках банковской и телеком-инфраструктуры внедряются внутренние решения по мониторингу дрейфа на основе стека инфраструктурной безопасности, интегрированные с регламентами регуляторов и внутренними стандартами обработки данных.
- Примеры внедрений в отраслевых кейсах: обнаружение сдвигов в регионах обслуживания, в сегментах клиентов, а также своевременная адаптация моделей ценообразования и рекомендаций.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Пример архитектуры дрейф-детектора:
- Источник данных → Data Drift Service → Alarm Engine → Alerting + Visualization
- Data Drift Service: расчёт PSI, KS тест, JSD, W-distance по заданной конфигурации признаков; поддерживает пакетную и потоковую обработку.
- Alarm Engine: пороговые значения и эвристики, формирование уведомлений в Slack, email или тревожные каналы в job-management системах.
- Пример алгоритмической реализации на Python (упрощённо):
- Расчёт PSI для набора признаков:
- Пример кода:
- Импорт: from sklearn.preprocessing import KBinsDiscretizer
- Вычисление PSI для признака: сравнение частот по интервалам
- Пример кода:
- KS-тест для непрерывных признаков: ks_2samp из scipy.stats
- Расчёт Wasserstein距: scipy.stats.wasserstein_distance
- Расчёт Jensen–Shannon divergence: реализуется через sklearn.metrics.pairwise_distances или через собственную функцию на основе распределений.
- Мониторинг распределения целевой переменной (label drift): сравнение распределений целевой переменной в разных периодах.
- Расчёт PSI для набора признаков:
- Пример потока данных:
- Периодический пакетный батч данных из Data Lake → Feature Store → Drift Detector → Model Evaluation → В случае тревоги: банк обновляет пороги, инициирует повторное обучение.
- Потоковые данные через Kafka/Kinesis → Drift Detector онлайн → Аларты → оперативная коррекция или переобучение.
- Схема интеграций:
- REST API или GRPC endpoints: /drift_summary, /drift_alerts
- Метрики в Prometheus: drift_psideci, drift_ks_pvalue, drift_wd
- Визуализация в Grafana: панель PSI по признакам, графики AUC/LogLoss, задержка обновления.
- Включение drift-детекции в CI/CD:
- Периодическая регрессия дрейфа и качество данных как часть регрессионного тестирования.
- Автообучение при стабилизации или значимом дрейфе, с безопасной стратегией отката.
- Примеры типов интеграций:
- Интеграция с ML-платформами: автогенерация документации о дрейфе, вывод в Model Registry, регламенты обновления моделей.
- Интеграция с бизнес-процессами: триггер на изменение порогов бизнес-метрик после дрейфа.
Риски, ограничения и типовые ошибки
- Виды ошибок:
- Перекос в тестах: выборки не репрезентативны; тест может не уловить скрытые изменения.
- Ложные срабатывания при сезонности: праздничные периоды и выходные влияют на распределения.
- Игнорирование причин дрейфа: дрейф может быть следствием изменений во внешних факторах (рыночной конъюнктуры, политики).
- Ограничения методов:
- Различия между тестами и практическими эффектами: статистические сигналы не всегда совпадают с влиянием на бизнес-метрики.
- Быстрое обучение модели может скрывать дрейф временно, но позже вернуть деградацию.
- Риск утечки данных: при расчётах распределений необходимо обеспечить корректную отнесённость к периодам и защиту конфиденциальности.
- Типичные ошибки внедрения:
- Игнорирование доверительных интервалов и неопределённости.
- Недостаточное тестирование на разных подгруппах (регион, устройство, версия клиента).
- Неправильная настройка порогов тревог: слишком чувствительные или слишком медленные реакции.
- Практические уроки:
- Дрейф не однозначно означает деградацию модели: важно сопоставлять дрейф с изменением бизнес-метрик.
- Необходимо сочетать несколько методов: статистические тесты + онлайн-метрики + контекстная аналитика.
- Регулярная валидация и повторная калибровка: настройка порогов и правок в обучающих конвейерах.
Перспективы развития направления
- Технологический тренд:
- Более глубокая интеграция drift-детекторов в конвейеры MLOps: автономное управление версиями и автоматический выбор стратегии обновления.
- Улучшение интерпретируемости дрейфа: объяснение причин изменений, выделение ключевых признаков-детекторов.
- Расширение поддержки «метрик бизнес-эффективности» как части мониторинга дрейфа.
- Эволюция инструментов:
- Расширение библиотек для онлайн-дрифтов в реальном времени, улучшение скорости вычислений и влияния на задержки.
- Пространственные и тематические drift-детекторы — анализ распределения признаков в географическом смысле и по сегментам пользователей.
- Регуляторика и безопасность:
- Соответствие требованиям по аудиту и прозрачности моделей, особенно в финсекторе и здравоохранении.
- Поддержка многоуровневых моделей репликации и локализации обработки данных в рамках разных регионов.
Заключение
Data drift — это не единичная проблема, а непрерывный процесс, который требует системного подхода: от теории дрейфа и статистических методов до архитектуры мониторинга и организационных процессов. В рамках продакшена дрейф становится индикатором устойчивости данных, точности прогнозов и доверия к бизнес-решениям. Эффективная стратегия обнаружения и реагирования на дрейф требует сочетания теории, практических инструментов и инфраструктурной дисциплины: от PSI, KS и Wasserstein до ADWIN и онлайн-алгоритмов, от открытых решений (Alibi Detect, Evidently AI, NannyML) до российских экосистем (Яндекс DataSphere и локальные платформы MLOps). Только интегрированная система мониторинга данных, моделей и бизнес-метрик обеспечивает долгосрочное качество прогнозов и соответствие бизнес-целям.
Вопрос–Ответ (FAQ)
Чем дрейф данных отличается от дрейфа модели?
Дрейф данных относится к изменениям в распределении входных признаков или целевой переменной со временем. Дрейф модели — это деградация точности и качества предсказаний, которая может возникнуть даже при отсутствии резких изменений характеристик данных, если модель больше не соответствует текущим условиям. Разделение поможет понять, где нужен ремоделинг, а где — корректировка порогов и данных.
Какие первые признаки дрейфа стоит мониторить?
Распределения по признакам ( PSI, KS, W distance ), изменение распределения целевой переменной, корректность калибровки, а также отклонения в бизнес-метриках и в точности модели (AUC, RMSE, F1).
Когда следует обновлять модель после обнаружения дрейфа?
Обычно реагируют в три шага: временный откат к предыдущей версии, обновление обучающей выборки и повторное обучение, интеграция в конвейер с валидацией на holdout-данных. Важно иметь заранее прописанные пороги тревоги и план отката.
Какие инструменты можно использовать для дрейф-детекции?
Open-source: Alibi Detect, Evidently AI, NannyML. Российские решения: Яндекс DataSphere и локальные MLOps-платформы, адаптированные под требования безопасности и регуляторики.
Как дрейф влияет на бизнес-метрики?
Дрейф может снизить точность прогнозов и ухудшить качество решений, что влияет на конверсию, прогнозируемые затраты, удовлетворенность клиентов и риск-аппетит. Важно связывать технические сигналы с бизнес-метриками и проводить кросс-метрики.
Какую роль играет данные lineage в дрейфе?
Важно фиксировать происхождение данных, версии признаков и целевой переменной, чтобы понять, где именно произошел дрейф и какие изменения нужно повторно обучать. Это критически важно для аудита и регуляторной прозрачности.
Почему важно разделять drift-детекцию и объяснение причин дрейфа?
Детекция показывает, что дрейф произошел, но не объясняет, почему. Объяснение причин помогает целенаправленно корректировать пайплайн, определить источники изменений и принимать решения об обновлении данных или модели.
Как учитывать сезонность и длинные периоды в анализе дрейфа?
Необходимо учитывать сезонность, разделять анализ на периодические окна и соседние окна с учётом календаря и использования. В противном случае сезонные колебания могут восприниматься как дрейф.
Какие риски связаны с автоматическим обновлением моделей после дрейфа?
Возможные риски: неправильная версия данных, переобучение на неверной целевой переменной или недопонимание причин дрейфа. Важно предусмотреть периодический аудит и ручную проверку при автоматическом обновлении.
Каковы перспективы и горизонты внедрения дрейф-детекции в крупных организациях?
Ожидается рост состояний MLOps, где дрейф будет интегрирован в CI/CD и BI-пайплайны, в связке с автокалибровкой и авторегулированием моделей. Это повысит устойчивость систем к изменениям внешних и внутренних факторов и ускорит принятие решений на основе данных.
Конструктивные примеры практического внедрения
Пример реализации в реальном проекте: сбор признаков из потока, вычисление PSI и KS-теста, формирование панели в Grafana, оповещения через Slack и E-mail, запуск механизма обновления моделей по схеме “поменялись пороги -> проверить -> обновить” с автоматической репликацией в staging.
Пример реализации на базе открытых инструментов:
- Alibi Detect: детекция дрейфа по признакам в онлайн-режиме, поддержка нескольких тестов и адаптивных критериев.
- Evidently AI: мониторинг data drift, model drift, а также автоматическая визуализация влияния изменений на метрики.
- NannyML: анализ влияния дрейфа на точность и воспроизводимость оценок.
Российские кейсы:
- Яндекс DataSphere как платформа для мониторинга данных, контроля качества данных, отслеживания дрейфа и интеграции с существующими бизнес-процессами.
- В крупных банках и телеком-компаниях внедряются локальные конвейеры мониторинга дрейфа в рамках регуляторной и корпоративной дисциплины, с учетом требований к аудиту, логированию и защите данных.
Приведём схему типичного пайплайна мониторинга дрейфа на продакшене:
Источник данных → Drift detector (PSI, KS, JSD, W-distance) → Alerting (Prometheus/Grafana/Slack) → Business metrics comparison → Decision: обновление модели/переобучение/калибровка.
Важным является наличие feature store, model registry, а также линейдж и документирование изменений — чтобы можно было воспроизвести процесс и показать регуляторам, что ответственность за изменения зафиксирована.
Итоговые рекомендации
- Стратегия внедрения дрейф-детекции должна быть тестируемой, повторяемой и незаманчивой для бизнес-операций.
- Не перегружайте систему дрейф-детекторами — начните с ключевых признаков и целевой переменной, настройте PSI и KS, затем расширяйте coverage.
- Совмещайте статистические и бизнес-метрики: дайте сигнал не только об изменении распределений, но и об реальном влиянии на прогнозы и бизнес-метрики.
- Включайте российские решения и локальные платформы для соответствия требованиям регуляторов и безопасности, а также для интеграции в существующую архитектуру.
Выводы главы
Глубокое понимание видов дрейфа и методов обнаружения является фундаментом для устойчивого мониторинга ML-моделей в продакшене. Эффективная архитектура дрейф-детекции сочетает статистические методы, онлайн-алгоритмы, управляемые процессы и понятные бизнес-метрики. Важно, чтобы мониторинг дрейфа был встроен в организационную культуру и техническую инфраструктуру: от регламентов и ролей до инструментов мониторинга и процессов обновления моделей. Правильно спроектированная система обнаружения дрейфа не только позволяет выявлять проблемы раньше, чем они станут заметны пользователям, но и обеспечивает надёжное объяснение изменений для стейкхолдеров и регуляторов.
Эффективный мониторинг ML-моделей лишь один из элементов зрелой AI-инфраструктуры. Чтобы модели приносили устойчивую бизнес-ценность, необходим комплексный подход: стратегия внедрения, подготовка данных, архитектура платформы и интеграция AI-решений в реальные бизнес-процессы.
Узнайте, как реализовать искусственный интеллект в бизнесе от стратегии до промышленного внедрения: от оценки готовности компании и разработки AI-дорожной карты до создания AI-ассистентов, корпоративных AI-агентов и систем на базе генеративного AI, интегрированных в CRM, ERP и другие корпоративные системы.


