

Сайзинг серверной инфраструктуры для Trino
Проектирование вычислительной платформы для распределённой аналитики
Эффективная работа распределённых аналитических систем напрямую зависит от правильно спроектированной инфраструктуры. Для платформы Trinoэто особенно критично, поскольку система выполняет сложные SQL-запросы поверх больших объёмов данных, распределённых между различными источниками - корпоративными хранилищами данных, аналитическими базами, data lake и потоковыми системами.
Неправильный сайзинг серверов может привести к:
- деградации производительности аналитических запросов
- перегрузке систем хранения данных
- нестабильности BI-инструментов
- росту времени выполнения отчётов
- увеличению затрат на инфраструктуру
Поэтому при внедрении Trino важно правильно определить требования к вычислительным ресурсам, сети и системам хранения.
Наша компания выполняет полный цикл сайзинга инфраструктуры для Trino, включая анализ нагрузки, проектирование архитектуры кластера и подготовку рекомендаций по оборудованию.
Роль инфраструктуры в архитектуре Trino
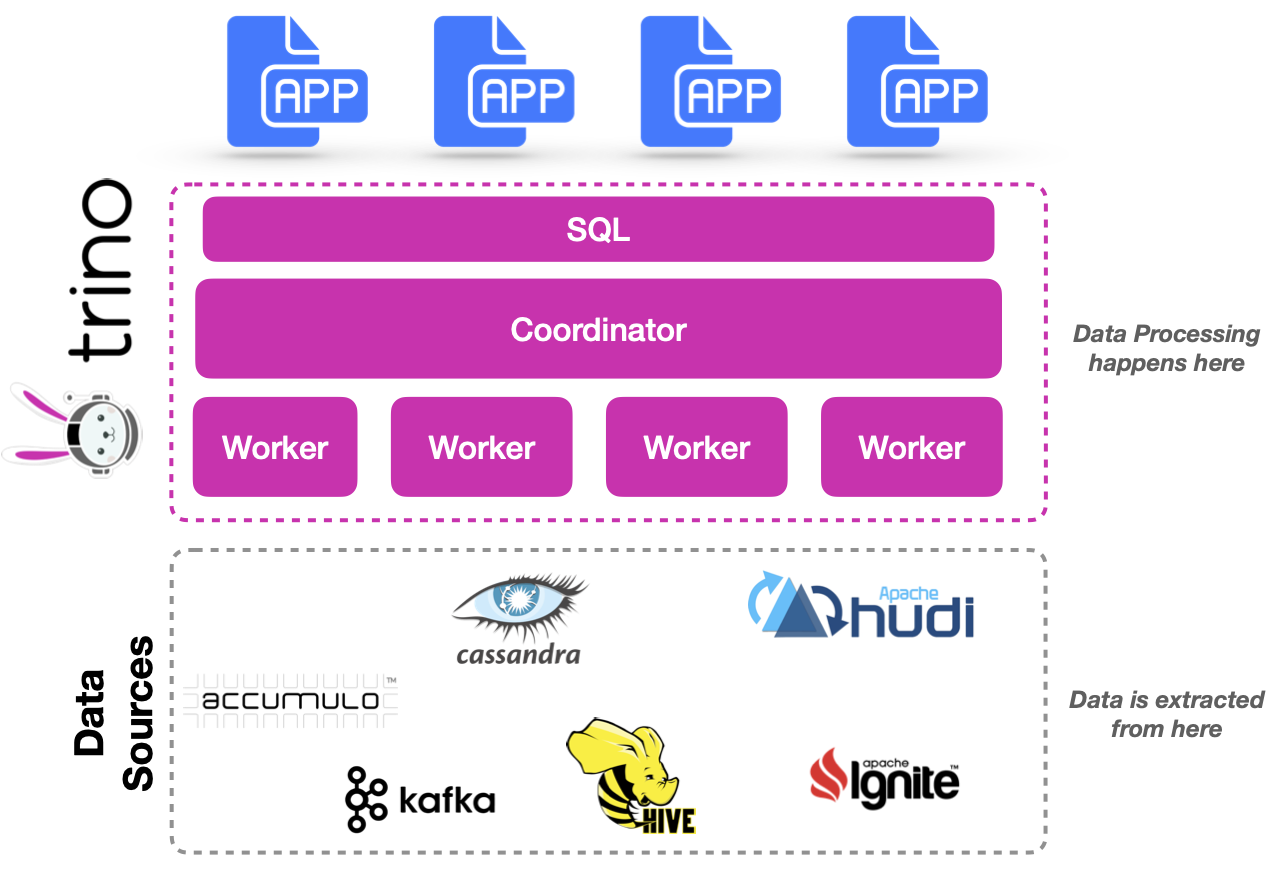
Trino является распределённым SQL-движком, который выполняет аналитические запросы параллельно на множестве серверов.
В архитектуре платформы выделяются два типа узлов:
- Coordinator** - управление запросами и планирование выполнения
- Worker nodes** - выполнение вычислений
Coordinator распределяет задачи между worker-узлами, а workers выполняют операции:
- сканирование данных
- join-операции
- агрегации
- сортировки
- оконные функции
Таким образом производительность системы напрямую зависит от:
- количества worker-узлов
- CPU
- объёма оперативной памяти
- пропускной способности сети
Факторы, влияющие на сайзинг Trino
Перед проектированием инфраструктуры проводится анализ нескольких ключевых факторов.
Объём данных
Размер аналитических данных, с которыми работает система:
| Категория | Объём |
|---|---|
| Малые системы | до 10 ТБ |
| Средние платформы | 10-100 ТБ |
| Крупные платформы | 100-1000 ТБ |
| Enterprise | более 1 ПБ |
Trino не хранит данные напрямую, однако объём данных влияет на:
- сложность запросов
- объём сканируемых таблиц
- количество параллельных вычислений
Тип аналитической нагрузки
Существует несколько типов нагрузки:
| Тип нагрузки | Характеристика |
|---|---|
| BI-аналитика | короткие интерактивные запросы |
| Data Science | сложные аналитические вычисления |
| ETL-аналитика | обработка больших наборов данных |
| Ad-hoc аналитика | нестандартные аналитические запросы |
Каждый тип нагрузки предъявляет разные требования к инфраструктуре.
Количество пользователей
Число пользователей влияет на количество одновременно выполняемых запросов.
| Категория | Пользователи |
|---|---|
| Небольшая команда | до 20 |
| Средний отдел аналитики | 20-100 |
| Крупная компания | 100-500 |
| Enterprise | более 500 |
Интенсивность запросов
Важно учитывать:
- среднее время выполнения запросов
- частоту запуска запросов
- количество параллельных пользователей
Типовая конфигурация серверов
В большинстве проектов используется кластерная архитектура.
Coordinator node
Coordinator выполняет планирование запросов и управление кластером.
Рекомендуемая конфигурация:
| Параметр | Значение |
|---|---|
| CPU | 8-16 ядер |
| RAM | 32-64 GB |
| Storage | SSD |
| Network | 10 Gbit |
Coordinator не выполняет тяжёлых вычислений, поэтому требования к CPU умеренные.
Worker nodes
Worker-узлы выполняют основные вычисления.
Рекомендуемая конфигурация:
| Параметр | Значение |
|---|---|
| CPU | 32-96 ядер |
| RAM | 128-512 GB |
| Storage | NVMe SSD |
| Network | 10-25 Gbit |
Worker nodes должны обеспечивать:
- высокую параллельность вычислений
- быструю обработку данных
- быстрый обмен данными между узлами
Масштабирование кластера
Trino масштабируется горизонтально.
Это означает, что производительность увеличивается за счёт добавления новых worker-узлов.
| Размер платформы | Workers |
|---|---|
| Пилотный проект | 3-5 |
| Средняя компания | 5-20 |
| Крупная организация | 20-100 |
| Enterprise Data Platform | 100+ |
Сетевые требования
Trino активно использует сеть для обмена данными между узлами.
Поэтому важно обеспечить высокую пропускную способность сети.
Рекомендуемые параметры:
| Параметр | Рекомендация |
|---|---|
| Скорость сети | 10-25 Gbit |
| Latency | минимальная |
| Network topology | high-speed cluster network |
При большом количестве worker-узлов может использоваться:
- выделенная сеть
- RDMA
- high-performance interconnect
Требования к системам хранения
Trino выполняет запросы поверх различных систем хранения данных.
Наиболее распространённые источники данных:
| Система | Назначение |
|---|---|
| Greenplum | корпоративное хранилище данных |
| ClickHouse | аналитическая база |
| Object Storage | data lake |
| Kafka | потоковые данные |
Производительность Trino во многом зависит от производительности этих систем.
Сайзинг для различных сценариев
Пилотный проект
Используется для проверки архитектуры и тестирования аналитических задач.
Рекомендуемая конфигурация:
| Компонент | Конфигурация |
|---|---|
| Coordinator | 8 CPU / 32 GB RAM |
| Workers | 3-4 узла по 16 CPU / 64 GB RAM |
Средняя аналитическая платформа
Используется в компаниях с активной BI-аналитикой.
| Компонент | Конфигурация |
|---|---|
| Coordinator | 16 CPU / 64 GB RAM |
| Workers | 8-12 узлов по 32 CPU / 128 GB RAM |
Крупная корпоративная платформа
Используется в организациях с десятками аналитических систем.
| Компонент | Конфигурация |
|---|---|
| Coordinator | 16-32 CPU / 128 GB RAM |
| Workers | 20-40 узлов по 64 CPU / 256 GB RAM |
Оптимизация использования ресурсов
Для эффективного использования инфраструктуры необходимо правильно настроить параметры Trino.
Основные настройки
| Параметр | Назначение |
|---|---|
| query.max-memory | ограничение памяти запроса |
| query.max-total-memory | общий лимит памяти |
| task.concurrency | параллелизм выполнения |
| exchange.max-buffer-size | управление сетевыми буферами |
Правильная настройка позволяет:
- повысить стабильность системы
- предотвратить перегрузку узлов
- улучшить производительность
Сайзинг для интеграции с ClickHouse и Greenplum
Во многих архитектурах Trino работает поверх аналитических СУБД ClickHouse Greenplum.
Особенности сайзинга:
- ClickHouse оптимизирован для агрегаций
- Greenplum используется для сложных аналитических вычислений
- Trino выполняет federated SQL-запросы
Важно обеспечить баланс ресурсов между системами.
Методология сайзинга
Наша компания применяет структурированный подход к определению требований к инфраструктуре.
Этапы сайзинга
- Анализ архитектуры данных
- Анализ аналитических сценариев
- Оценка объёмов данных
- Анализ нагрузки пользователей
- моделирование производительности
- подготовка рекомендаций по инфраструктуре
Типичные ошибки при сайзинге
На практике часто встречаются ошибки при проектировании инфраструктуры.
Недостаток памяти
Trino активно использует память для выполнения join-операций.
Слабая сеть
Медленная сеть приводит к значительным задержкам выполнения запросов.
Неправильное распределение ресурсов
Недостаточное количество worker-узлов ограничивает масштабируемость.
Практические примеры
Кейс 1 - ритейл
Объём данных: 120 ТБ
Пользователи: 250 аналитиков
Конфигурация:
- Coordinator: 16 CPU / 64 GB RAM
- Workers: 24 узла по 64 CPU / 256 GB RAM
Результат:
- ускорение аналитических запросов в 6 раз
Кейс 2 - телеком
Объём данных: 800 ТБ
Пользователи: 500+
Конфигурация:
- Coordinator: 32 CPU / 128 GB RAM
- Workers: 60 узлов по 96 CPU / 512 GB RAM
Результат:
- поддержка тысяч аналитических запросов в день
Итоговая ценность правильного сайзинга
Правильно спроектированная инфраструктура Trino обеспечивает:
- высокую производительность аналитических запросов
- стабильную работу BI-систем
- масштабируемость платформы данных
- снижение затрат на инфраструктуру
Грамотный сайзинг позволяет создать надёжную аналитическую платформу, способную поддерживать рост бизнеса и развитие корпоративной аналитики.
Наша компания предоставляет полный спектр услуг по:
- проектированию инфраструктуры Trino
- расчёту серверных мощностей
- внедрению аналитической платформы
- сопровождению и оптимизации производительности
Это позволяет организациям получить устойчивую, масштабируемую и высокопроизводительную платформу данных, готовую к росту объёмов информации и увеличению аналитической нагрузки.


