

AI Maturity: оценка зрелости организации и интеграция риск-менеджмента
Современная организация, работающая с искусственным интеллектом, сталкивается не только с вопросами качества моделей, но и с управлением рисками на протяжении всего жизненного цикла проекта. Зрелость организации в области ИИ (AI Maturity) — это совокупность процессов, технологий и культурных практик, которые позволяют принимать управляемые, прозрачные и комплаендные решения, эффективно интегрировать риск-менеджмент в стратегию развития и эксплуатацию моделей. Эта глава даст подробное руководство по тому, как оценивать зрелость, какие элементы риска учитывать и как внедрять современные подходы к управлению и контролю моделей, включая этику, Explainable AI (XAI) и регуляторные требования.
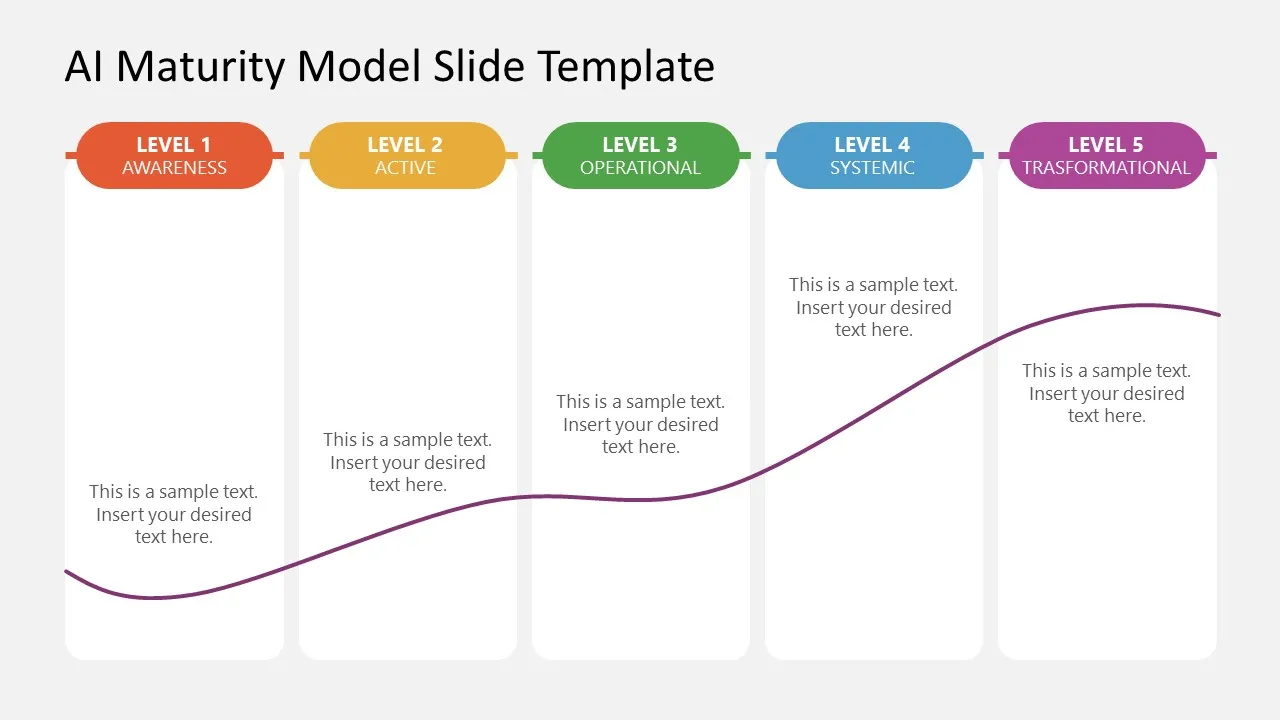
Что такое AI Maturity?
- AI Maturity можно рассматривать как сочетание зрелости процессов (проекта, разработки, эксплуатации), людей (навыков и ролей), инструментов (платформ и методологий) и управленческих практик (политик, рисков, аудита). Модель зрелости позволяет перейти от произвольных, одноразовых внедрений к повторяемым, управляемым и улучшаемым практикам.
Модели зрелости
- Общий подход к моделям зрелости повторяется в разных областях: уровень 1 — Начальный (Initial/Ad hoc), уровень 2 — Повторяемый (Repeatable), уровень 3 — Определённый (Defined), уровень 4 — Управляемый (Managed), уровень 5 — Оптимизируемый (Optimizing).
- В контексте ИИ мы добавляем специфичные аспекты: управление данными, управление моделями, этика и прозрачность, мониторинг и аудит, регуляторная комплаенс и управление рисками.
Риск-менеджмент в AI: что включать
Таксономия рисков:
- Данные и приватность: утечки, сбор и использование персональных данных, соответствие GDPR/53 ФЗ и локальным законам.
- Проблемы качества данных: неполные наборы, смещения, несогласованность метаданных.
- Риск модели: ошибка прогнозирования, ложные срабатывания, эксплуатационные сбои.
- Этический риск: несправедливость, дискриминация, вред клиента.
- Прозрачность и объяснимость: прозрачность решений, возможность аудита.
- Регуляторный риск: соответствие законам и требованиям регуляторов.
- Безопасность и цепочка поставок: безопасность источников данных, поставщиков компонентов, зависимостей.
- Операционные риски и устойчивость: устойчивость к сбоям, восстановление после инцидентов.
Методы управления рисками: риск-регистры, чек-листы аудита, метрики соответствия, регуляторные проверки, независимая валидация.
Основные принципы и стандарты
- ISO 31000 и ISO/IEC 38507 как ориентиры по управлению рисками.
- RA/RM подходы: риск-реестр, вероятность-воздействие, уровни критичности.
- NIST RMF и FAIR (Factor Analysis of Information Risk) как инструменты количественной оценки риска.
- Этические принципы: справедливость, объяснимость, ответственность, учет последствий.
Архитектура управления моделями
- Governance-подход: роли и ответственности (AI Owner, ML Engineer, Data Steward, Model Validator, Ethics/Audit Committee).
- Model Lifecycle Management: сбор, подготовка данных, разработка, валидация, деплой, мониторинг, обновления, утилизация.
- Подход к объяснимости: XAI-метрики, локальные и глобальные объяснения, аудит решений.
- Контроль версий: данные, модель, гиперпараметры, окружение, зависимые библиотеки.
Методы оценки зрелости
- Оценочные вопросы по пяти уровням.
- Наборы индикаторов: политики и процессы, инфраструктура, навыки, культуру, регуляторика, риски.
- Инструменты самооценки и независимого аудита.
Практические примеры
Пример 1: кредитный скоринг в банковской среде
Что оценивается: качество данных, юридическое согласование использования данных, риск дискриминации, объяснимость решения, регуляторные требования к хранению документов.
Как интегрировать риск-менеджмент:
- Разработать риск-регистр для проекта: данные, модель, эксплуатация, мониторинг.
- Встроить проверку прозрачности: вычислять SHAP-значения для каждого решения и хранить их вместе с выводами.
- Установить политики тестирования на справедливость: NNE-индексы, тесты на равнуюTrue/False вероятность для разных групп.
Ожидаемые результаты: увеличение прозрачности, снижение регуляторной неопределенности, ускорение аудита и подготовка к регуляторным инспекциям.
Пример 2: чат-бот на службе поддержки (NLP)
Что оценивается: качество обработки естественного языка, риск неверного ответа, данные о пользовательском взаимодействии, защита данных.
Решения:
- Использование DeepPavlov для локализации и подготовки русскоязычных моделей.
- Добавление модулей объяснимости для ключевых агентов беседы, чтобы оператор мог понять логику ответа.
- Введение мониторинга: drift по частоте обращения, качество ответов и удовлетворенность пользователей.
Интеграция риск-менеджмента:
- Включение этических ограничителей и политики around sensitive topics.
- Регулярные аудиты и тесты на безопасность.
Результаты: снижение количества инцидентов, улучшение регуляторного комплаенса.
Пример 3: обработка документов и регуляторная аналитика (NLP/Document AI)
- Инструменты: Russia-friendly стек на базе DeepPavlov и CatBoost для классификации документов.
- Метрики: точность классификации, F1, точность по чувствительным данным, latency.
- Риск-менеджмент: контроль доступа к документам, журнал аудита, хранение версий документов.
Пример 4: ML-платформа с открытым кодом и российскими решениями
- Архитектура: сбор данных — Data Lake, моделирование — Jupyter/VDI, управление версиями данных и моделей — DVC + MLflow либо альтернативы, оркестрация — Kubeflow, мониторинг — Prometheus/Grafana.
- Российские решения: CatBoost (Яндекс) для эффективной работы с категориальными признаками; DeepPavlov для NLP; использование открытого стека для MLOps с адаптацией под требования российского регуляторного поля.
- Риски: совместимость зависимостей, лицензирование, безопасность передачи данных.
- Выгоды: устойчивое и прозрачное управление жизненным циклом моделей с локализацией данных и соблюдением норм.
Таблица: уровни зрелости и критерии для AI-моделей
| Уровень | Основные характеристики | Как измерять | Пример показателя |
|---|---|---|---|
| 1. Начальный | Нет формального управления моделями; проекты работают стихийно | Наличие единой политики разработки и документации | % проектов с документированной цели |
| 2. Повторяемый | Повторяемые процессы разработки | Наличие базовых методик тестирования и контроля качества | Частота регрессионных тестов |
| 3. Определённый | Определенные процессы в организации | Стандарты разработки, аудит кода, валидации | Наличие модели-реестра |
| 4. Управляемый | Мониторинг и управляемость в реальном времени | Метрики мониторинга, регистр рисков | SLA по времени реагирования на инциденты |
| 5. Оптимизируемый | Улучшение процессов на основе данных | Непрерывная оптимизация, A/B-тесты, обратная связь | Коэффициент ускорения цикла улучшения |
Архитектура и пайплайны
Этапы: сбор данных, хранение/лаги, подготовка данных, валидация данных, обучение, валидация модели, деплой, мониторинг, версионирование.
Инструменты:
- Data/Feature Stores: с поддержкой версионирования, lineage.
- Модели: реестр версий моделей, чекпойнты.
- Мониторинг: drift detection (data drift, concept drift) и мониторинг производительности.
- Безопасность: контроль доступа, данные в безопасном окружении, анонимизация (Privacy-Preserving).
Открытые решения: MLflow, DVC, Kedro, Airflow, Kubeflow, ML.NET; для русскоязычного стека — CatBoost и DeepPavlov для специфических задач NLP.
Примеры кода (для иллюстрации)
Пример 1: обучение CatBoostClassifier с учётом категориальных признаков
from catboost import CatBoostClassifier
# X_train — DataFrame, y_train — целевая переменная
categorical_features = [i for i, col in enumerate(X_train.columns) if X_train[col].dtype == 'object']
model = CatBoostClassifier(iterations=800, learning_rate=0.05, depth=8, loss_function='Logloss', verbose=200)
model.fit(X_train, y_train, cat_features=categorical_features, eval_set=(X_val, y_val), verbose=False)
Пример 2: объяснимость с SHAP (для деревьев CatBoost совместимо)
import shap
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_sample)
shap.summary_plot(shap_values, X_sample)
Пример 3: управление версиями и мониторинг через MLflow
import mlflow
mlflow.start_run()
mlflow.log_param("model_type", "CatBoost")
mlflow.log_metric("val_auc", val_auc)
mlflow.log_artifact("model.pkl")
mlflow.end_run()
Пример 4: регистр рисков (пример YAML-модели риска)
risk_register:
- id: RSK-001
 name: data_privacy_risk
 description: Риск утечки персональных данных
 likelihood: High
 impact: Critical
 mitigations:
- "Удаление PII из обучающих наборов"
- "Анонимизация и псевдонимизация"
- "Шифрование данных в движении/в покое"
Практические советы по имплементации
- Включайте риск-менеджмент на ранних стадиях проекта: формируйте риск-регистр еще до начала обучения модели.
- Ведите детальный аудит данных: источники, качество, преобразования, согласие на использование.
- Внедряйте «золотой треугольник»: данные, модель, процессы. Все три элемента должны быть доступами, документированы и под контролем.
- Используйте XAI как стандарт: регулярно предоставляйте объяснения для ключевых решений и храните логи объяснений.
- Привлекайте независимую валидацию и регуляторный аудит по мере необходимости, особенно для критически важных бизнес-процессов.
Риски и ограничения внедрения
Технические риски
- Неполнота данных, несоответствие форматов, проблемы с качеством данных.
- Непредвиденные смещения в данных и концептуальные сдвиги.
- Уязвимости к кибератакам и несанкционированному доступу.
- Сложности в интерпретации и объяснении сложных моделей (черные ящики).
Регуляторные и этические риски
- Несоблюдение локального законодательства о персональных данных (8-ФЗ, GDPR и т. п.).
- Риск дискриминации и несправедливости в принятии решений.
- Ограничения на использование определённых категорий данных и целей анализа.
- Требования по документированию и аудиту, необходимость независимой валидации.
Организационные риски
- Недостаток навыков и опыта сотрудников в области MLOps, XAI и регуляторной работы.
- Высокие затраты на внедрение инфраструктуры и процессов.
- Сопротивление изменениям и разрыв между бизнес-целями и технической командой.
Ограничения
- Многоуровневые требования к согласованию политик доступа и соблюдения регуляторики могут увеличивать время вывода решений.
- Обновление и обслуживание моделей требуют постоянных инвестиций в инфраструктуру и персонал.
- Ряд решений может быть ограничен локальными условиями: хранение данных на территории РФ, локализация сервисов и т. п.
Чек-листы для снижения рисков
- Данные: классификация чувствительности, маскирование персональных данных, журналирование доступа.
- Модели: тестирование на справедливость, проверка устойчивости к манипуляциям, аудит гиперпараметров.
- Эксплуатация: мониторинг drift, SLA по времени реакции на инциденты, регресс-тесты на критичных сценариях.
- Регуляторика: подготовка документации и експертная валидация, аудиты по требованию регуляторов.
- Этика и прозрачность: документация по принятым мерах и причинно-следственным связям, возможность аудита.
Технические детали, интеграционные аспекты
Как связать AI-м maturity с общими CM/IT-процессами
- Встроенный риск-регистр в процессе жизненного цикла модели.
- Гранулированное управление версиями: данные, признаки, модель, окружение.
- Нормы для данных и моделирования, которые поддерживаются в рамках политики безопасности и конфиденциальности.
Метрики зрелости и контроля
- Уровень соответствия политикам и процессам: насколько политики доведены до метрик.
- Метрики качества данных и модели: AUC, F1, calibration, fairness metrics (demographic parity, equalized odds).
- Метрики объяснимости: способность генерировать объяснения и их корректность.
- Метрики мониторинга: частота обнаружения дрифта, скорость реагирования на инциденты.
Примеры конфигураций и практик
- Обеспечение прозрачности через XAI-объяснения на уровне решений и логов.
- Регулярная валидация и повторная оценка моделей в живой системе.
- Использование российского стека и инструментов: DeepPavlov, CatBoost, локальные решения для безопасной работы с данными и регуляторными требованиями.
Выводы
- AI Maturity — не только технологический проект, но и культурное и управленческое изменение.
- Интеграция риск-менеджмента в AI-проекты помогает снижать регуляторные, этические и операционные риски, увеличивает доверие к системам и ускоряет внедрение.
- Использование открытых и российских инструментов позволяет строить гибкие, прозрачные и соответствующие требованиям решения, сохраняя при этом контроль над данными и безопасностью.
FAQ — Вопросы и ответы
1) Что такое AI Maturity и зачем она нужна в организации?
- AI Maturity — это уровень зрелости управления данными, моделями и процессами вокруг ИИ в организации. Она нужна для системной интеграции риска, соблюдения регуляторных требований, повышения прозрачности и устойчивости решений. Без зрелости риск ошибок, регуляторные проблемы и незапланированные расходы возрастут.
2) Какие уровни зрелости и как их оценивать?
- Обычно выделяют пять уровней: Начальный, Повторяемый, Определённый, Управляемый, Оптимизируемый. Оценка проводится по критериям политики, инфраструктуры, навыков, процессов аудита и регуляторной готовности. Визуализация может быть выполнена через риск-регистр и чек-листы.
3) Какие риски являются самыми важными в рамках интеграции риск-менеджмента в AI?
- Данные и приватность, дискриминация, непрозрачность моделей, регуляторные требования, безопасность и управление цепочкой поставок, операционные сбои и зависимость от сторонних компонентов.
4) Какие open-source инструменты следует использовать для XAI и мониторинга?
- XAI: SHAP, LIME, Alibi, ELI5. Мониторинг и управление моделями: MLflow, DVC, Kubeflow, а для данных и инфраструктуры — Prometheus, Grafana, Airflow.
5) Какие российские решения можно применить в инфраструктуре AI?
- CatBoost (Яндекс) — для эффективной работы с категориальными признаками и обучением модулей на российском ПО. DeepPavlov — для NLP и чат-ботов на русском языке. Эти инструменты хорошо интегрируются в локальные инфраструктуры и соответствуют локальным требованиям к данным.
6) Как обеспечить регуляторную совместимость при внедрении AI?
- Включайте в проект регуляторный аудит, формируйте регистр рисков, ведите документацию по данным и моделям, используйте объяснимость и аудит решений. Поддерживайте процесс соответствия ISO 31000, NIST RMF и локальным требованиям 8-ФЗ/GDPR, а при необходимости — подготавливайте материалы для независимого аудита.
7) Какие шаги полезно предпринять на старте проекта AI?
- Определение целей и удовлетворение регуляторных требований, создание риск-реестра, выбор архитектуры и инструментов, внедрение governance-процессов, настройка мониторинга и политики доступа, подготовка обучающих материалов.
8) Что включает в себя «регистрация риска» в контексте AI?
- Риск-регистр включает идентификацию риска, вероятность и влияние, источники риска, ответные меры и ответственный за устранение. Регистр должен обновляться по мере изменений в проекте и подвергаться регулярной проверке.
9) Какие важные технические детали стоит учесть в архитектуре AI-проекта?
- Детальная регистрация данных ( lineage ), версии моделей и признаков, мониторинг drift, аудиты и логирование, безопасность доступа, аудит и объяснимость, устойчивость к сбоям и восстановление.
10) Как обеспечить прозрачность решений и объяснимость?
- Используйте XAI-метрики, предоставляйте локальные и глобальные объяснения, храните логи об объяснениях, внедряйте аудит решений и документацию к модели, встроенную в процесс принятия решений.
Дополнительная информация: примеры кода и конфигураций
Пример ML-пайплайна со структурой проекта
- Данные → обработка → обучение → валидация → деплой → мониторинг
- Инструменты: DVC, MLflow, Kubeflow, CatBoost, DeepPavlov, SHAP.
- Пример структуры файла YAML для регистри––
project:
name: CreditScoringAI
version: 1.0
owners:
 - AI Governance Team
 - Data Steward
risk_register:
 - id: RSK-001
name: data_privacy_risk
description: Риск утечки персональных данных
likelihood: High
impact: Critical
mitigations:
 - "Удаление PII"
 - "Анонимизация"
 - "Шифрование"
Пример аудита данных и тестов модели (Python)
from sklearn.metrics import roc_auc_score
import pandas as pd

# Предположим, у нас есть тестовый набор данных X_test и y_test
y_pred = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred)
print("AUC:", auc)

# Пример теста на fairness
from aif360.metrics import BinaryLabelDatasetMetric
dataset = BinaryLabelDataset(...) # данные с признаками и целевой переменной
metric = BinaryLabelDatasetMetric(dataset, unprivileged_groups=[{'Race': 0}], privileged_groups=[{'Race': 1}])
print("Disparate Impact:", metric.disparate_impact())
Пример использования SHAP для объяснения локального объяснения решения
import shap
explainer = shap.Explainer(model)
shap_values = explainer(X_instance)
shap.plots.bar(shap_values)
Пример конфигурации мониторинга дрифта
# pseudo-скрипт
drift_detector = DataDriftDetector(threshold=0.1)
drift = drift_detector.detect(X_current, X_reference)
if drift:
 trigger_alert()
 deploy_update_pipeline()
Выводы по главе
- Зрелость организации в области ИИ требует комплексного подхода: от политики безопасности и этики до технологических инструментов и регуляторной готовности.
- Интеграция риск-менеджмента в жизненный цикл моделей позволяет повысить доверие к ИИ, снизить регуляторные риски и добиться устойчивости бизнес-процессов.
- Открытые и российские решения в сочетании с грамотной архитектурой MLOps дают возможность строить эффективные и безопасные системы, соответствующие требованиям локального рынка и глобальным стандартам.
Вопрос–Ответ (FAQ) ч.2
Вопрос 1: Что включает в себя понятие «регуляторная готовность» в AI-проектах?
- Ответ: Это способность организации соблюдать требования законодательства и регуляторов, включая обработку персональных данных, сохранность данных, прозрачность принятия решений и наличие аудируемой документации по целям, методам и рискам.
Вопрос 2: Какой подход лучше использовать для оценки риска в проекте AI?
- Ответ: Риск-реестр с системной оценкой вероятности и воздействия; классификационные и количественные методы (например, FAIR/RA). Важно сочетать независимый аудит и внутреннюю валидацию с регулярной проверкой соответствия.
Вопрос 3: Какие инструменты XAI рекомендуются для русскоязычных данных?
- Ответ: SHAP и LIME остаются универсальными; Alibi и ELI5 дают дополнительные подходы. Для NLP — DeepPavlov и локальные адаптации русскоязычных моделей.
Вопрос 4: Какой набор практических действий поможет снизить риски в начале проекта?
- Ответ: Привязать целевые бизнес-метрики к рискам, сформировать риск-регистр, выбрать стек инструментов с акцентом на прозрачность и аудит, внедрить мониторинг данных и моделей, определить ответственных за эти процессы.
Вопрос 5: Какие примеры российских решений можно использовать в инфраструктуре MLOps?
- Ответ: CatBoost (Яндекс) для эффективной работы с категориальными признаками; DeepPavlov для NLP-задач; локальные сборки инфраструктуры для безопасного хранения данных.
Вопрос 6: Какие ключевые метрики стоит отслеживать в мониторинге моделей?
- Ответ: Производительность (AUC, F1), калибровка, drift (data/concept drift), fairness-метрики, частота ошибок и задержки в ответе, регламентированные пороги и SLA.
Вопрос 7: Что делать, если регулятор запрашивает аудит модели?
- Ответ: Важно иметь детализированную документацию по данным, моделям, промежуточным промежуточным файлам, объяснениям и аудируемым процессам. Подготовьте материалы по политикам доступа, историческим версиям и записям об аудитах.
Вопрос 8: Какие практические шаги для внедрения XAI в продукт?
- Ответ: Определите критические сценарии решений, внедрите объяснимость в каждом таком сценарии (локальные объяснения для пользователей, глобальные объяснения для аудиторов), храните логи и подготовьте набор тестов на объяснимость.
Вопрос 9: Какой блок кода лучше использовать для демонстрации объяснений модели?
- Ответ: Пример использования SHAP адаптирован под конкретную модель и данные; можно показать графики важности признаков и локальные объяснения для реальных примеров.
Вопрос 10: Какие шаги для построения устойчивой организации AI Maturity в регуляторной среде?
- Ответ: Реализация риск-регистра, внедрение политики конфиденциальности и объяснимости, независимая валидация, аудиты, обучение сотрудников, поддержка документации и культуры соблюдения норм.
Если вы рассматриваете внедрение AI в своей компании, мы поможем оценить перспективные сценарии, подготовить архитектуру решения и рассчитать экономический эффект. Работаем с корпоративными системами и закрытыми контурами. Свяжитесь с нами, чтобы обсудить ваш кейс.


