
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс по MLOps и Data Science (ML, AI) » Алгоритм полиномиальной регрессии

Алгоритм полиномиальной регрессии

Что вы будете делать, если ваши данные немного сложнее, чем просто прямая линия? Хорошей альтернативой для вас является то, что вы можете использовать линейную модель для соответствия нелинейным данным. Вы можете использовать функцию добавления возможностей в качестве новых функций, а затем вы можете использовать новый набор функций для обучения линейной модели. В машинном обучении этот метод известен как полиномиальная регрессия.

Давайте разберемся с полиномиальной регрессией на примере. Сначала я создам нелинейные данные, основанные на квадратном уравнении. Квадратное уравнение имеет вид ax2+bx+c; Сначала я импортирую все необходимые библиотеки, а затем создам квадратное уравнение:


# Python ≥3.5 is required
import sys
assert sys.version_info >= (3, 5)

# Scikit-Learn ≥0.20 is required
import sklearn
assert sklearn.__version__ >= "0.20"

# Common imports
import numpy as np
import os

# to make this notebook's output stable across runs
np.random.seed(42)

# To plot pretty figures
%matplotlib inline
import matplotlib as mpl
import matplotlib.pyplot as plt
mpl.rc('axes', labelsize=14)
mpl.rc('xtick', labelsize=12)
mpl.rc('ytick', labelsize=12)
import numpy as np
import numpy.random as rnd
np.random.seed(42)


А теперь составим квадратное уравнение:


m = 100
X = 6 * np.random.rand(m, 1) - 3
y = 0.5 * X**2 + X + 2 + np.random.randn(m, 1)
plt.plot(X, y, "b.")
plt.xlabel("$x_1$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.axis([-3, 3, 0, 10])
save_fig("quadratic_data_plot")
plt.show()
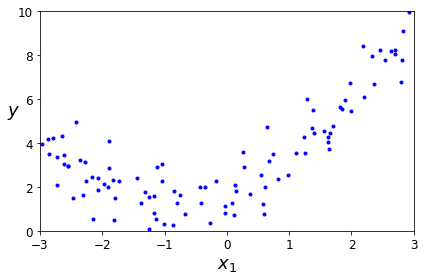


Полиномиальная регрессия

Прямая линия никогда не поместится на таких нелинейных данных. Теперь я буду использовать алгоритм «Polynomial Features», предоставляемый Scikit-Learn, для передачи вышеуказанных обучающих данных, добавляя квадрат всех функций, присутствующих в наших обучающих данных, в качестве новых функций для нашей модели:


from sklearn.preprocessing import PolynomialFeatures
poly_features = PolynomialFeatures(degree=2, include_bias=False)
X_poly = poly_features.fit_transform(X)
X[0]


Результат:

array([-0.75275929])


X_poly[0]


Результат:

array([-0.75275929, 0.56664654])


Сейчас X_poly содержит исходные характеристики X плюс квадрат функций. Теперь мы можем использовать алгоритм линейной регрессии, чтобы соответствовать нашим новым обучающим данным:


from sklearn.linear_model import LinearRegression
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y)
lin_reg.intercept_, lin_reg.coef_


Результат:

 (array([1.78134581]), array([[0.93366893, 0.56456263]]))


X_new=np.linspace(-3, 3, 100).reshape(100, 1)
X_new_poly = poly_features.transform(X_new)
y_new = lin_reg.predict(X_new_poly)
plt.plot(X, y, "b.")
plt.plot(X_new, y_new, "r-", linewidth=2, label="Predictions")
plt.xlabel("$x_1$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.legend(loc="upper left", fontsize=14)
plt.axis([-3, 3, 0, 10])
save_fig("quadratic_predictions_plot")
plt.show()
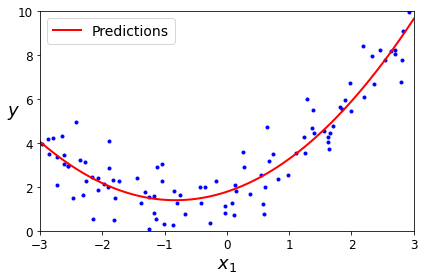


Вы должны знать, что когда у нас есть несколько функций, полиномиальная регрессия способна найти отношения между всеми функциями в данных. Это возможно, потому что полиномиальные функции добавляют все комбинации функций в определенной степени.


Кривые обучения в полиномиальной регрессии

Если вы используете полиномиальную регрессию высокой степени, вы в конечном итоге подберете обучающие данные гораздо быстрее, чем при линейной регрессии. Давайте разберемся с этим на примере:


from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

for style, width, degree in (("g-", 1, 300), ("b--", 2, 2), ("r-+", 2, 1)):
    polybig_features = PolynomialFeatures(degree=degree, include_bias=False)
    std_scaler = StandardScaler()
    lin_reg = LinearRegression()
    polynomial_regression = Pipeline([
            ("poly_features", polybig_features),
            ("std_scaler", std_scaler),
            ("lin_reg", lin_reg),
        ])
    polynomial_regression.fit(X, y)
    y_newbig = polynomial_regression.predict(X_new)
    plt.plot(X_new, y_newbig, style, label=str(degree), linewidth=width)

plt.plot(X, y, "b.", linewidth=3)
plt.legend(loc="upper left")
plt.xlabel("$x_1$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.axis([-3, 3, 0, 10])
save_fig("high_degree_polynomials_plot")
plt.show()
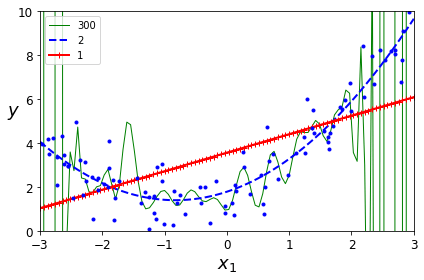


Модель полиномиальной регрессии высокой степени переоснащается обучающими данными, тогда как линейная модель ей не подходит. Таким образом, модель, которая будет работать лучше всего, в этом случае – квадратичная, потому что данные генерируются с использованием квадратного уравнения.

Но никогда не знаешь, какая функция используется при создании данных. Итак, вы решаете, насколько сложной должна быть ваша модель. Как проанализировать, соответствует ли ваша модель данным?

Также прочтите: Алгоритм градиентного спуска в машинном обучении.

Правильный способ обобщить эффективность нашей модели – взглянуть на кривые обучения. Кривые обучения – это графики производительности модели на обучающем наборе и проверочном наборе в зависимости от размера обучающего набора.

Чтобы сгенерировать кривые обучения, обучите модель несколько раз на подмножествах обучающих данных разного размера. Теперь давайте разберемся с этим на примере. В приведенном ниже коде определяется функция, которая может построить кривые обучения модели с использованием данных обучения:


from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split

def plot_learning_curves(model, X, y):
    X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=10)
    train_errors, val_errors = [], []
    for m in range(1, len(X_train)):
        model.fit(X_train[:m], y_train[:m])
        y_train_predict = model.predict(X_train[:m])
        y_val_predict = model.predict(X_val)
        train_errors.append(mean_squared_error(y_train[:m], y_train_predict))
        val_errors.append(mean_squared_error(y_val, y_val_predict))

    plt.plot(np.sqrt(train_errors), "r-+", linewidth=2, label="train")
    plt.plot(np.sqrt(val_errors), "b-", linewidth=3, label="val")
    plt.legend(loc="upper right", fontsize=14)
    plt.xlabel("Training set size", fontsize=14)
    plt.ylabel("RMSE", fontsize=14)             


Теперь давайте посмотрим на кривые обучения нашей модели, используя функцию, которую я создал выше:


lin_reg = LinearRegression()
plot_learning_curves(lin_reg, X, y)
plt.axis([0, 80, 0, 3])                        
save_fig("underfitting_learning_curves_plot")  
plt.show()                                     
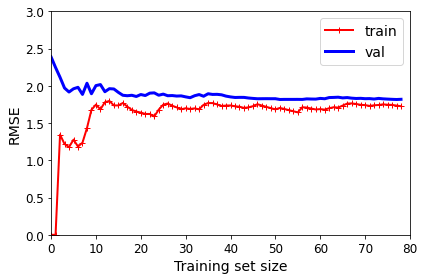


Таким образом, результат не соответствовал данным. Если ваши данные не соответствуют обучающим данным, добавление дополнительных экземпляров не поможет. Вам нужно использовать более сложную модель машинного обучения или придумать более совершенные функции. Теперь давайте посмотрим на кривые обучения модели полиномиальной регрессии 10-й степени на тех же данных:


from sklearn.pipeline import Pipeline

polynomial_regression = Pipeline([
        ("poly_features", PolynomialFeatures(degree=10, include_bias=False)),
        ("lin_reg", LinearRegression()),
    ])

plot_learning_curves(polynomial_regression, X, y)
plt.axis([0, 80, 0, 3])          
save_fig("learning_curves_plot") 
plt.show()                       
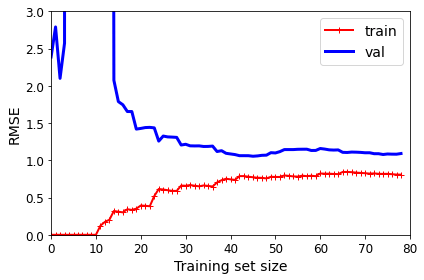


Скорость обучения немного выше, чем у предыдущих, но здесь есть несколько существенных отличий:

  • Ошибка данных обучения намного ниже, чем у предыдущих кривых обучения, которые мы исследовали с помощью модели линейной регрессии.
  • Между кривыми есть промежуток, что означает, что производительность модели намного выше на обучающих данных, чем на данных для проверки.


Надеюсь, вам понравилась эта статья о полиномиальной регрессии и кривых обучения в машинном обучении.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Автоматизация машинного обучения с помощью H2O AutoML
Следующая статья →
Алгоритм градиентного спуска в машинном обучении


Внедряем AI в бизнес-процессы крупных компаний
От стратегии и инфраструктуры до AI-агентов, интеграций и промышленной эксплуатации.

Подробнее об AI-решениях


Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • СберКорус (Группа компаний Сбербанка) – это ИТ‑компания, ИТ‑интегратор, SaaS-провайдер. Является разработчиком цифровых сервисов и услуг для автоматизации широкого диапазона бизнес-процессов юридических лиц. В 2004 году компания стала первым в России оператором электронного документооборота, а в 2012 году вошла в экосистему Сбера. 

  • Novikov group – первый российский ресторанный холдинг, основанный в 1991 году. Это команда профессионалов под управлением Аркадия Новикова, реализующая широкий спектр услуг в сфере гостеприимства: от проведения event-мероприятия до управления рестораном, от установления стандартов сервиса до контроля качества готовой продукции, от построения бизнес-плана проекта до реализации франшизы.

  • MoneyCare — кредитная платформа и сервис для ПОС-кредитования в магазинах, установленная в более чем 18 тысячах трейдинговых точек и сотрудничающая с 11 главными банками России.

  • ГК «Акрон Холдинг», одно из крупнейших в России промышленно-металлургических предприятий, запустил проект по модернизации управления данными. В качестве целевого решения для анализа ключевых данных компания выбрала систему PIX BI. В компании уже более 100 пользователей PIX BI, и в этом году в планах увеличить их число в два раза.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.