

Анализ Big Data с помощью SQL и Python
Эта статья - самая первая из серии статей, посвященных использованию Greenplum для Data Science и ML. В ней мы поговорим о том, как использовать все возможности Greenplum в области анализа Big Data и Data Science - от экспериментальных проектов до крупномасшабных программ.
Развитие, проблемы и возможности данных
Мы живем в эпоху цифровых технологий, и все, что мы делаем с помощью наших смартфонов, планшетов, компьютеров и даже бытовой техники, генерирует огромное количество самых разнообразных данных. Это, конечно, интересно, но сбор данных только ради того, чтобы их было больше – совершенно непродуктивное и даже бессмысленное занятие. Необходимо определиться с тем, для чего нам нужны эти данные, каковы наши цели, каких результатов в сфере бизнеса мы хотим достичь. Здесь - то на помощь приходят специалисты, гордо носящие звание Data Scientist.

В чем именно состоит заслуга Data Scientist?
Data Science - это область исследований, которая использует данные и количественное моделирование для получения ценных инсайтов, имеющих особое значение для пользователей. В этом контексте Data Scientist отвечает за широкий спектр обязанностей, таких как:
Исходя из этого, обязанности Data Scientist заключаются в следующем:
- Сотрудничество с проектировщиками для изучения потребностей покупателей и определения способов использования данных и алгоритмов, способных удовлетворить эти потребности;
- Определение приоритетов разработки продуктов совместно с менеджерами по продуктам;
- Сотрудничество с инженерами по обработке данных для выявления и подготовки данных для последующего анализа;
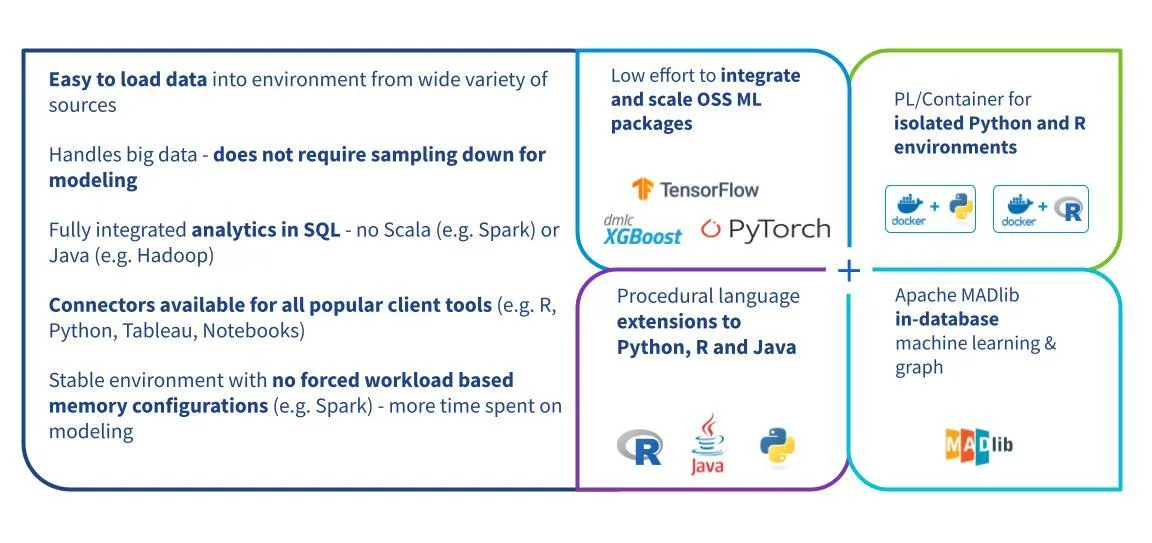
- Разработка ML-моделей для решения задач бизнеса — кодирование с помощью Python, R или SQL;
- Сотрудничество с инженерами-программистами для развертывания моделей в виде сервисов, используемых приложениями или непосредственно конечными пользователями;
- Итеративное повторение процессов (1)-(5) в целях непрерывного развития бизнеса.
Технические подходы и инструменты для извлечения полезных инсайтов из Big Data
Перечисленные выше виды деятельности включают в себя аспекты, связанные с тем, как работает Data Scientist (например, ориентированный на пользователя, бережливый, гибкий), а также какие инструменты и технологии он использует для повышения продуктивности своей работы. В этой статье мы сосредоточимся на инструментальной составляющей, в первую очередь связанной с направлением деятельности под номером 4 (смотрите список обязанностей Data Scientist, приведенный выше).
В частности, мы рассмотрим случаи, когда Data Scientist исследует данные и строит модели ML на основе Big Data. В этом контексте данный специалист может столкнуться со следующими техническими проблемами:
- Медленный конвейер обработки Big Data;
- Лимит памяти и вычислений в традиционных средах выполнения Python/R;
- Ограниченные аналитические функции платформ, связанных с обработкой Big Data.
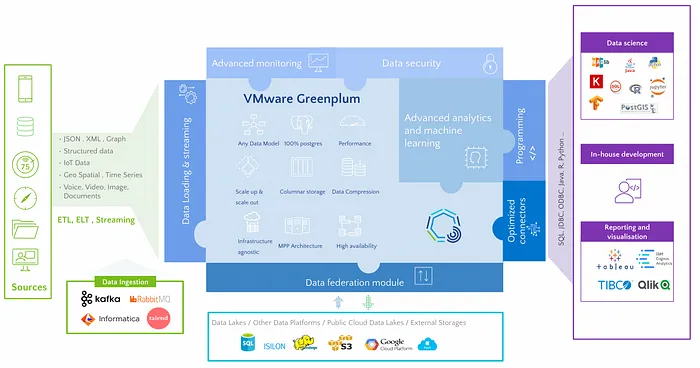
В этой статье мы подробнее остановимся на VMware Greenplum как на основной технологии, позволяющей справиться с трудностями, описанными выше.
Почему именно Greenplum?
Экспорт данных из БД и их импорт в серверную среду с помощью популярных инструментов для работы с данными не панацея для анализа Big Data. Как описано выше, Data Scientist нуждается в помощи в решении проблем, связанных с ограничениями памяти и масштабируемости этих инструментов, а также с узкими местами, связанными с трансфером Big Data из одной платформы данных в другую.
В данном случае идеальным решением становится использование мощнейшего инструмента под названием Greenplum, open-source продукта, массивно-параллельной реляционной СУБД для хранилища данных с гибкой горизонтальной масштабируемостью и столбцовым хранением данных на основе PostgreSQL. Для расширения функционала данной СУБД доступны следующие расширения:
- Apache MADlib для ML;
- Расширения процедурных языков для распараллеливания Python и RR;
- PostGIS для геопространственной аналитики и GPText для поиска и обработки текста;
- Взаимодействие с инструментами для создания дашбордов Tableau, PowerBI и т.д.)
В этой статье мы расскажем о том, как начать работу с Greenplum, и приведем примеры того, в каких случаях Data Scientist может воспользоваться данным инструментом.
Шаг 1: Установка и подключение
- Установите пакеты:
!pip install ipython-sql pandas numpy sqlalchemy plotly-express sql_magic pgspecial
- Импортируйте пакеты:
import pandas as pd
import numpy as np
import os
import sys
import plotly_express as px
# For DB Connection
from sqlalchemy import create_engine
import psycopg2
import pandas.io.sql as psql
import sql_magic
3. Подключение Greenplum :
Существует несколько способов установить соединение с Greenplum. В Jupyter-блокноте можно использовать «магическую» SQL команду, позволяющую писать SQL‑код прямо в ячейках блокнота.
Установка:
!pip install ipython-sql
Для использования блокнота необходимо установить подключение:
% load_ext _ sql
% sql postgresql://<user>:<password>@<IP_address>:<port>/<database_name>
Затем выполните следующие команды SQL в ячейке:
%% sql
SELECT version ();
Вы также можете использовать коннектор psycopg2 или pyodbc (существуют и другие варианты, например, JDBC)
Шаг 2: Обзор набора данных
В этой статье в качестве примера мы выбрали набор данных Daily Financial News for stocks от Kaggle, лицензия CC0: Public Domain. Для изучения цикла Data Science (Data Exploration - Data Preparation - Data Modelling - Model Evaluation - Model Deployment) для обучения NLP-модели мы будем использовать Greenplum.
Набор данных содержит заголовки с сайта Benzinga.com. Его объем составляет около четырех миллионов строк. Таблица содержит 7 столбцов:
- docid — целое число: уникальный индекс
- title — текст: заголовок статьи
- content — текст: эквивалентен заголовку
- url — текст: ссылка на статью
- publisher — текст: издательство новостей
- date — дата: дата публикации
- stock — текст: биржевой символ, относящийся к новостям
Для начала работы с этим набором данных мы выполним разведочный анализ данных (EDA) с помощью определенной команды SQL, задействуя основной функционал Greenplum без каких-либо дополнительных расширений.
Шаг 3: Подготовка данных
Набор данных хранится в таблице source_financial_news. Предлагаю обратить внимание на одну строку этой таблицы:
%%sql
SELECT * FROM source_financial_news LIMIT 1;
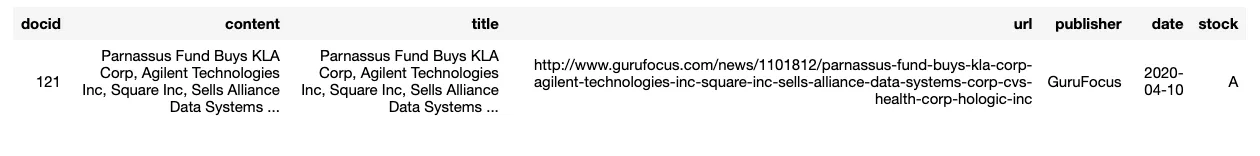
Сколько именно строк содержит данная таблица:
%%sql
SELECT count(*) FROM source_financial_news;

Разбитие таблицы на части для более эффективной аналитики данных
Поскольку старые новости будут использоваться не часто, создадим отдельную таблицу ds_demo.financial_news, в которой нас интересуют новости, опубликованные после 2010 года.
Присвоение в качестве распределенного ключа уникального индекса docid позволит нам равномерно распределить данные между различными сегментами.
Кроме того, установка хранилища на столбцовое хранение и его оптимизация для использования приложений на True также будет способствовать повышению эффективности анализа данных.
%%sql
DROP TABLE IF EXISTS ds_demo.financial_news;
CREATE TABLE ds_demo.financial_news
(
    LIKE source_financial_news
)
WITH (appendoptimized=true, orientation=column)
DISTRIBUTED BY(docid)
PARTITION BY RANGE (date)
(
    START (date '2010-01-01') INCLUSIVE
    END (date '2024-01-01') EXCLUSIVE
    EVERY (INTERVAL '1 month'),
    DEFAULT PARTITION old_news
);

-- Insert data from the source table into a newly created partitioned table
INSERT INTO ds_demo.financial_news SELECT * FROM source_financial_news;
После выполнения команды \d+ мы получим новую аналитическую таблицу:
%sql \d+ ds_demo.financial_news
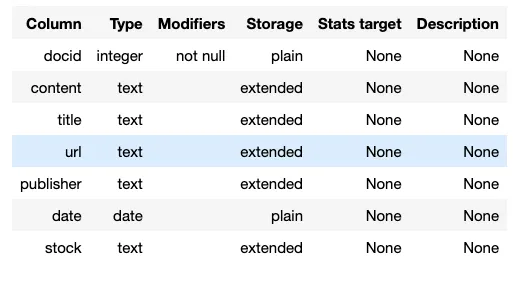
NB: Пользователи Greenplum 7 могут подстраивать партиционирование под свои нужды гораздо быстрее и легче.
Теперь, когда наша новая таблица создана, проверим ее партиционирование, вычислив стандартное отклонение количества строк на сегменты.
%%sql
-- Standard deviation to check table distribution
SELECT STDDEV(count)
FROM (
    SELECT gp_segment_id, COUNT(*)
    FROM ds_demo.financial_news
    GROUP BY 1
) table_distribution ;
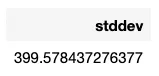
Стандартное отклонение достаточно небольшое (399,5784) по сравнению со средним значением 163383,333. Таким образом, наша таблица разделена равномерно!
Разделы, позволяющие сканировать только нужные данные
Чтобы ответить на приведенный ниже запрос, благодаря партиционированию больше нет необходимости в сканировании старых разделов.
%%sql
-- Show the execution plan "EXPLAIN" and check scanned partitions
EXPLAIN SELECT COUNT(*)
        FROM ds_demo.financial_news
          WHERE date >= '2020-01-01'::date
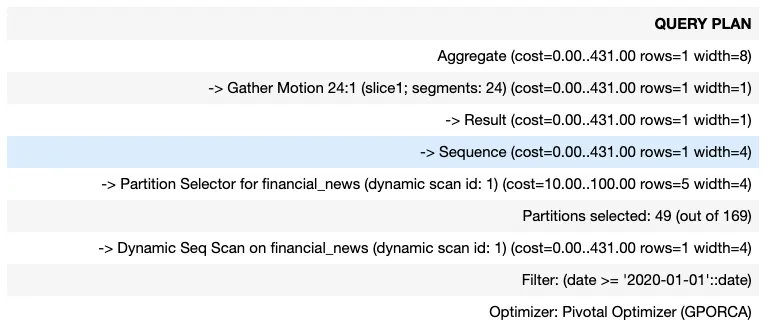
Более того, если мы добавим к дате условие sup_date, в сканировании разделов с датой, превосходящей sup_date, не будет никакого смысла.
Шаг 4: Исследовательский анализ данных с помощью SQL и MADlib
После подготовки таблицы ds_demo.financial_news для аналитики данных, содержащихся в БД, мы будем использовать SQL (sqlmagic) и MADlib, библиотеку с открытым исходным кодом на основе SQL.
Он обеспечивает параллельную реализацию математических, статистических, графовых методов, а ML методов для работы со структурированными и неструктурированными данными.
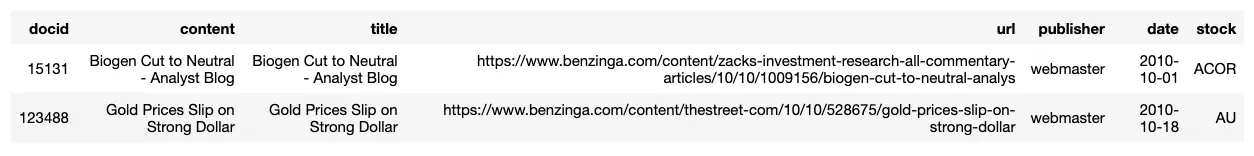
- Еще один обзор первых двух строк таблицы
%%sql
SELECT * FROM ds_demo.financial_news LIMIT 2 ;
2. Apache MADlib для получения статистики с помощью SQL
- Убедитесь в том, что расширение MADlib установлено!
%sql SELECT madlib.version();

2.1. Статистическое описание таблицы — MADlib
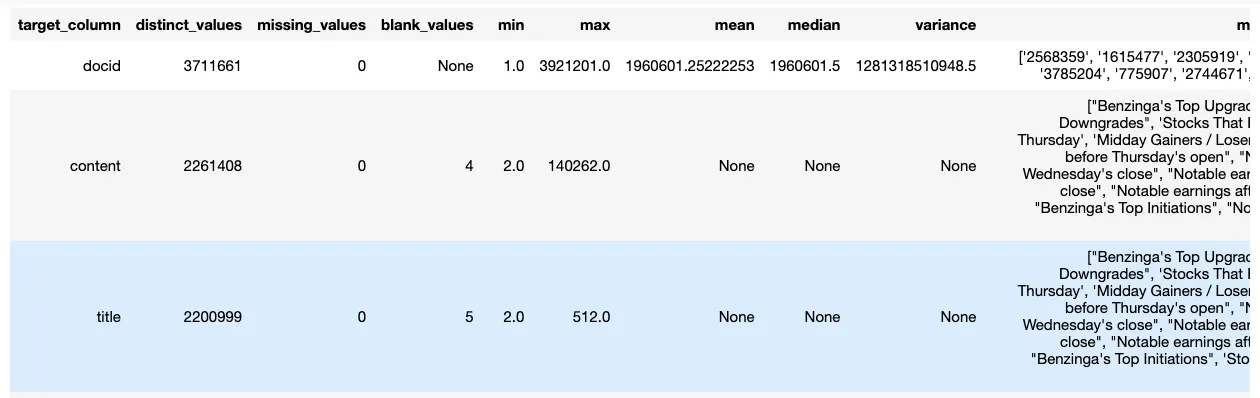
Функция MADlib summary() выводит сводную статистику для любой таблицы данных.
%%sql
DROP TABLE IF EXISTS ds_demo.financial_news_summary;
SELECT * FROM madlib.summary(
        'ds_demo.financial_news', 'ds_demo.financial_news_summary'
);
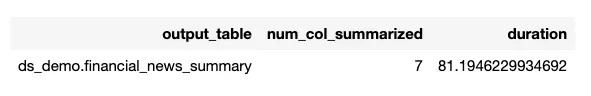
Результат выполнения функции summary() сохраняется в таблице ds_demo.financial_news_summary.
%%sql
SELECT
    target_column, distinct_values, missing_values, blank_values,
    min, max, mean, median, variance, most_frequent_values
FROM ds_demo.financial_news_summary;
3. Количество новостей на определенную дату
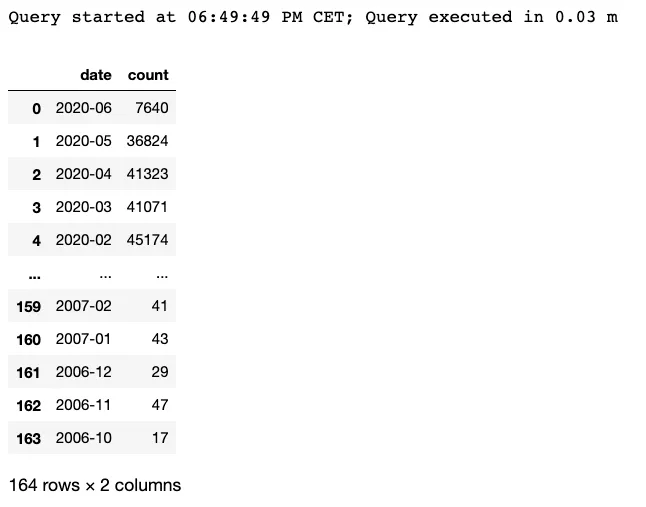
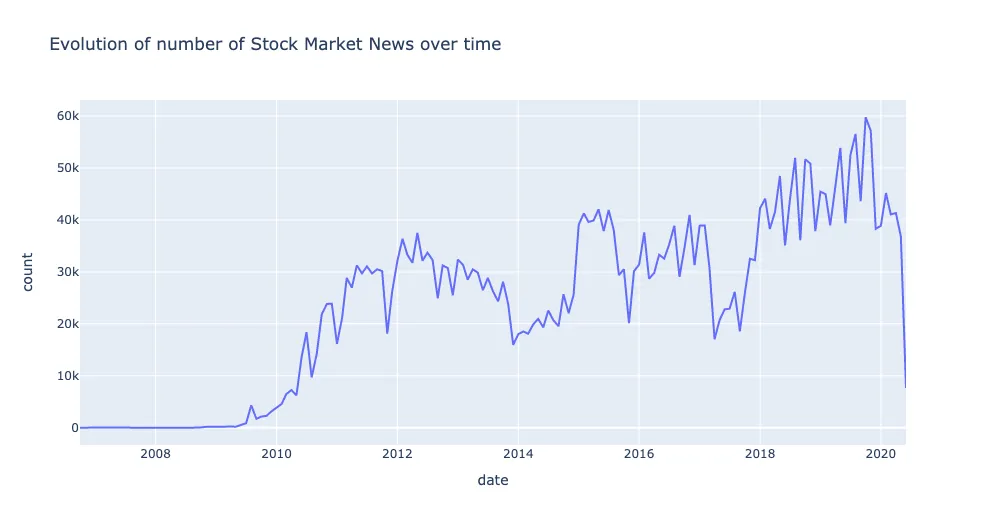
Для того чтобы увидеть динамику количества новостей за несколько месяцев, необходимо:
- C помощью SQL-функции to_char изменить формат столбца data на Год-Месяц;
- Сгруппировать данные по отформатированной дате и вычислить периодичность с помощью COUNT(*);
- Получить финальные результаты по дате.
%%read_sql df_news_per_date
SELECT
    to_char(date,'YYYY-MM') as date,
    COUNT(*)
FROM ds_demo.financial_news
    WHERE date IS NOT NULL
GROUP BY 1
ORDER BY 1
DESC;
Теперь давайте визуализируем агрегированные результаты с помощью Plotly:
px.line(df_news_per_date,
        x = 'date',
        y = 'count',
        title='Evolution of number of Stock Market News over time')
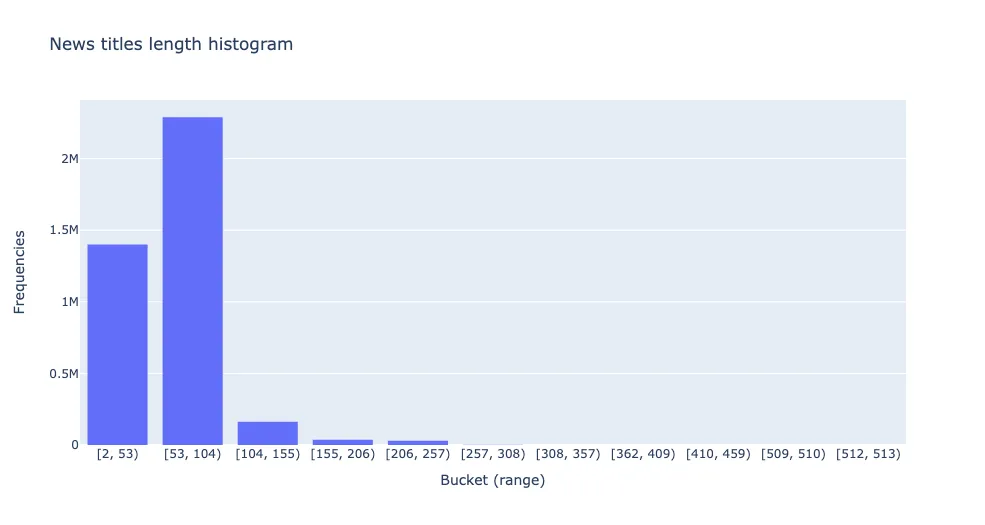
- Гистограмма размера финансовых новостей
Визуализируем распределение размера новостей фондового рынка:
%%read_sql df_histogram
WITH drb_stats AS (
    SELECT min(length(title)) AS min,
           max(length(title)) AS max
      FROM ds_demo.financial_news
),
     histogram AS (
   SELECT width_bucket(length(title), min, max, 10) AS bucket,
          int4range(MIN(length(title)), MAX(length(title)), '[]') AS range,
          COUNT(*) AS freq
     FROM ds_demo.financial_news, drb_stats
     GROUP BY bucket
     ORDER BY bucket
)

SELECT bucket, range, freq,
        repeat('■',
               (   freq::FLOAT
                 / MAX(freq) OVER()
                 * 30
               )::INT
        ) AS bar
FROM histogram
ORDER BY bucket ASC
;
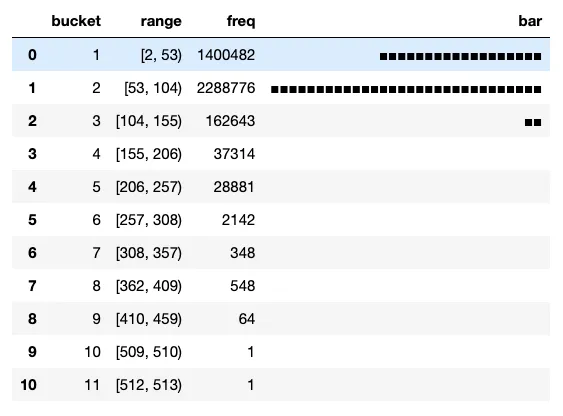
fig = px.histogram(y = df_histogram.freq,
                   x = df_histogram.range.astype(str),
                   nbins=10,
                   title = 'News titles length histogram')
fig.update_layout(yaxis_title="Frequencies", xaxis_title = 'Bucket (range)')
fig.show()
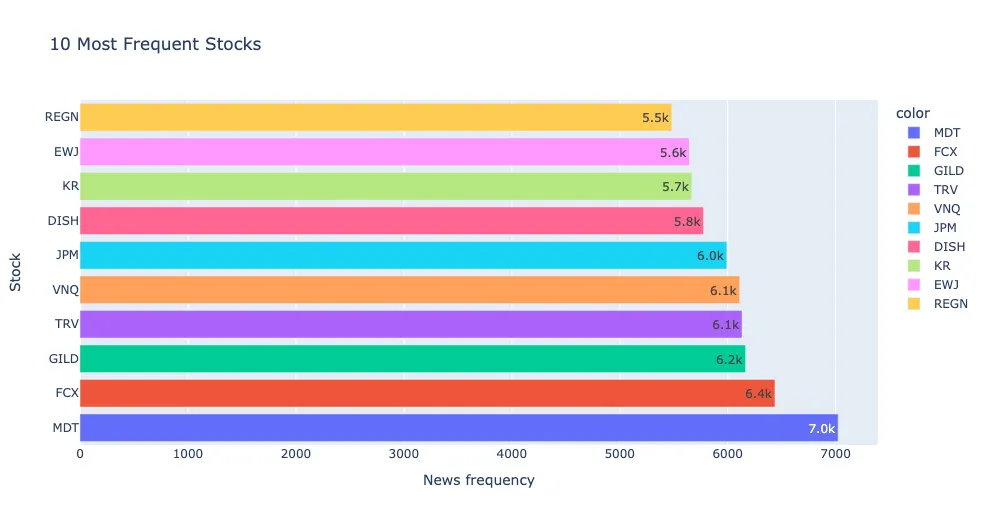
5. Количество новостей, относящихся к определенному биржевому символу
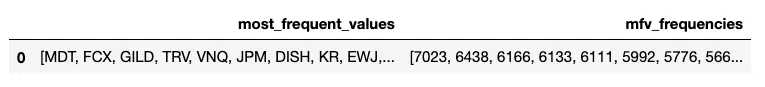
Для визуализации наиболее часто встречающихся биржевых символов используйте MADlib summary .
%%read_sql df_stock_frequencies
SELECT most_frequent_values, mfv_frequencies
FROM ds_demo.financial_news_summary
  WHERE target_column = 'stock';
px.bar(y = df_stock_frequencies.most_frequent_values.values[0],
       x = df_stock_frequencies.mfv_frequencies.values[0],
       color = df_stock_frequencies.most_frequent_values.values[0],
       labels={'x':'News frequency', 'y': 'Stock'},text_auto='.2s',
       title="10 Most Frequent Stocks")
6. Количество новостей, приходящееся на того или иного издателя (источник)
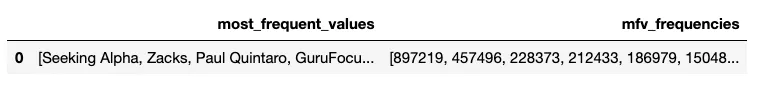
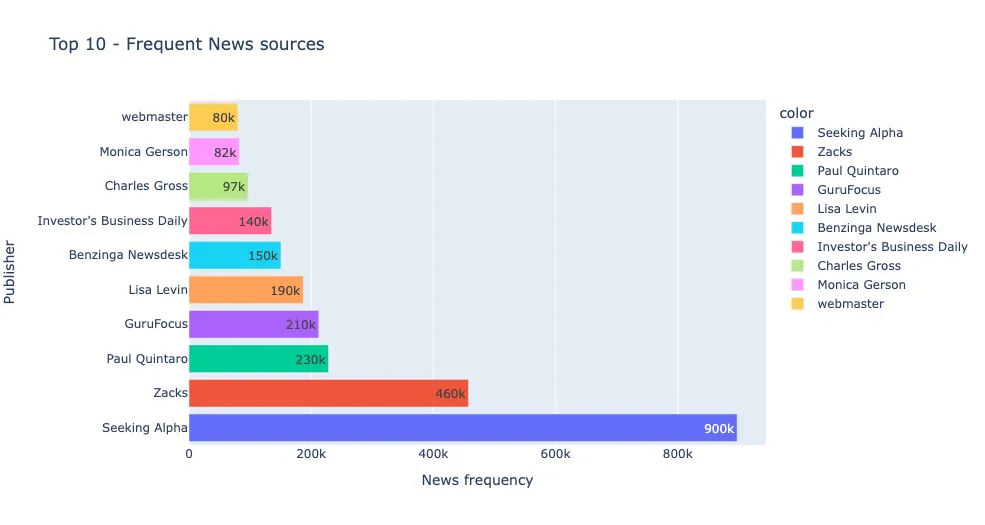
Давайте вычислим наиболее популярных издателей в нашем наборе данных:
%%read_sql df_publisher_frequencies
SELECT most_frequent_values, mfv_frequencies
FROM ds_demo.financial_news_summary
  WHERE target_column = 'publisher';
px.bar(y = df_publisher_frequencies.most_frequent_values.values[0],
       x = df_publisher_frequencies.mfv_frequencies.values[0],
       color = df_publisher_frequencies.most_frequent_values.values[0],
       labels={'x':'News frequency', 'y': 'Publisher'},text_auto='.2s',
       title="Top 10 - Frequent News sources")
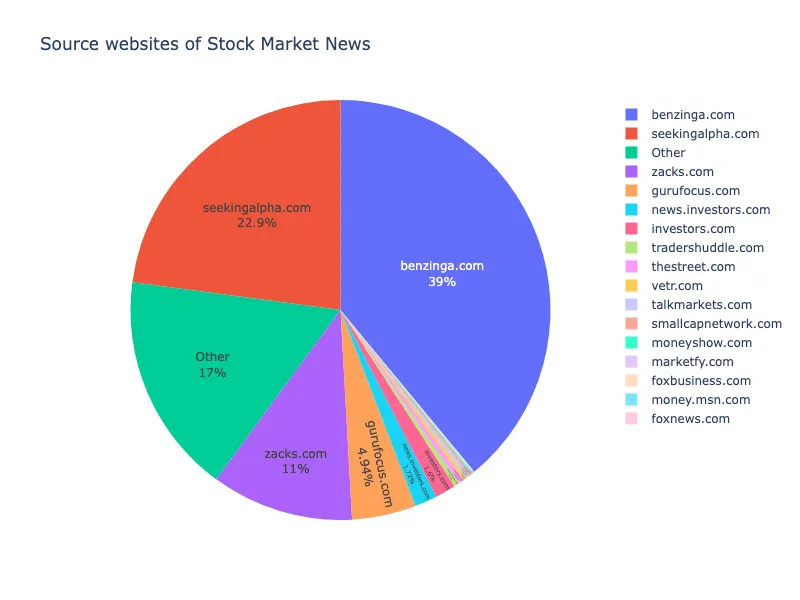
- Какой вэб-сайт наиболее популярен в нашем наборе данных?
%%read_sql df_url_domain
SELECT
        split_part(REGEXP_REPLACE(url, '^(https?://)?(www\.)?', ''), '/', 1) AS source_url,
        count(*) as frequency
FROM (SELECT
        CASE WHEN url IS NOT NULL THEN url ELSE 'Other' END
        AS url
      FROM ds_demo.financial_news
      ) t
GROUP BY 1
ORDER BY 2 ASC;
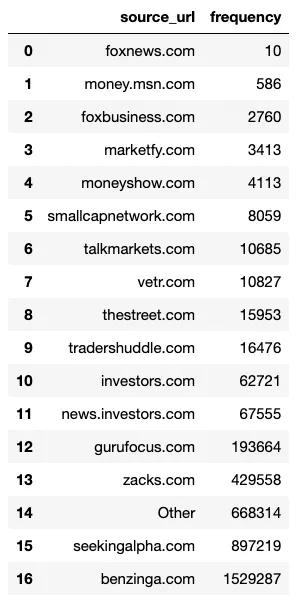
fig = px.pie(df_url_domain,
             names = 'source_url', values = 'frequency',
             width=800, height=600,
             title='Source websites of Stock Market News')

fig.update_traces(textposition='inside', textinfo='percent+label')
fig.show()
Заключение
В заключение следует отметить, что аналитики и Data Scientist вполне могут использовать Greenplum и возможности массивно-параллельной обработки данных для работы с большими массивами данных с помощью встроенных аналитических функций, комбинируя их с SQL и Apache MADlib.
В одной из следующих статей мы расскажем Вам о том, как Greenplum обеспечивает расширенную текстовую аналитику и текстовый поиск путем обработки большого количества текстовых данных с помощью GPText (Greenplum Text).


