

Создание эффективного поиска на основе ИИ в Greenplum с помощью pgvector и OpenAI
Растущая популярность моделей ИИ, например ChatGPT, вдохновила многие организации на раскрытие всего потенциала неструктурированных данных, от текстов до изображений и видео, путем использования генеративного ИИ и больших языковых моделей (LLM).
В этой статье мы поговорим о том, как использовать расширение pgvector, которое позволяет работать с многомерными векторными данными непосредственно в Greenplum, и «поженить» его с моделями OpenAI для того, чтобы извлекать ценные сведения из текстовых данных в крупных масштабах и использовать все преимущества архитектуры Greenplum.
Введение
Компании начали искать технологии и способы дополнить свои платформы данных ИИ. Они также заинтересованы во внедрении больших языковых моделей для развитя своих чат-ботов, систем рекомендаций и поисковых систем.
Одной из специфических задач в рамках данного процесса является управление и развертывание этих моделей ИИ, а также хранение и запрос генерируемых с помощью ML эмбеддингов.

Что такое эмбеддинги?
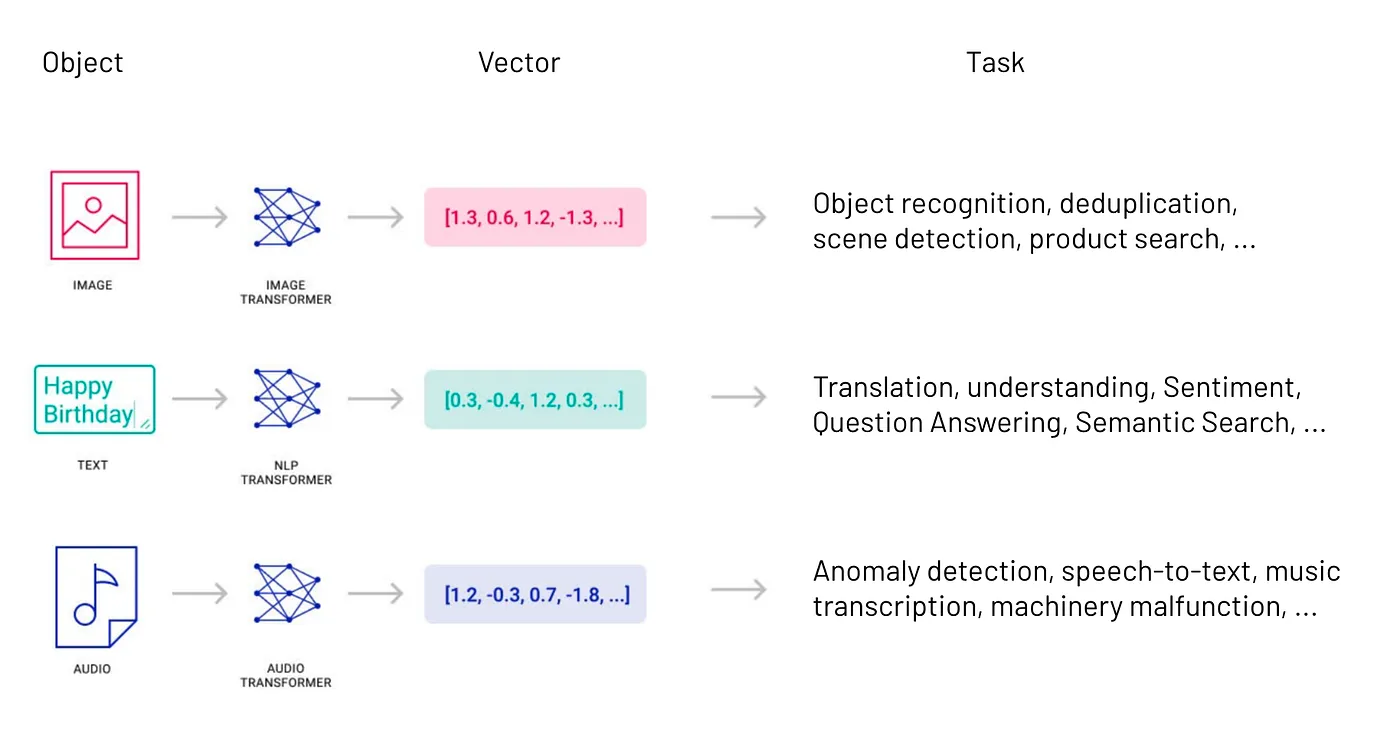
Эмбеддинги - это преобразование данных или сложных объектов, таких как тексты, изображения или аудио, в список чисел в высокоразмерном пространстве.

Эта техника используется в каждом алгоритме машинного обучения (ML) или глубокого обучения (DL), который позволяет улавливать/понимать смысл и контекст данных (семантические связи) , а также сложные взаимосвязи и закономерности внутри данных (синтаксические связи).
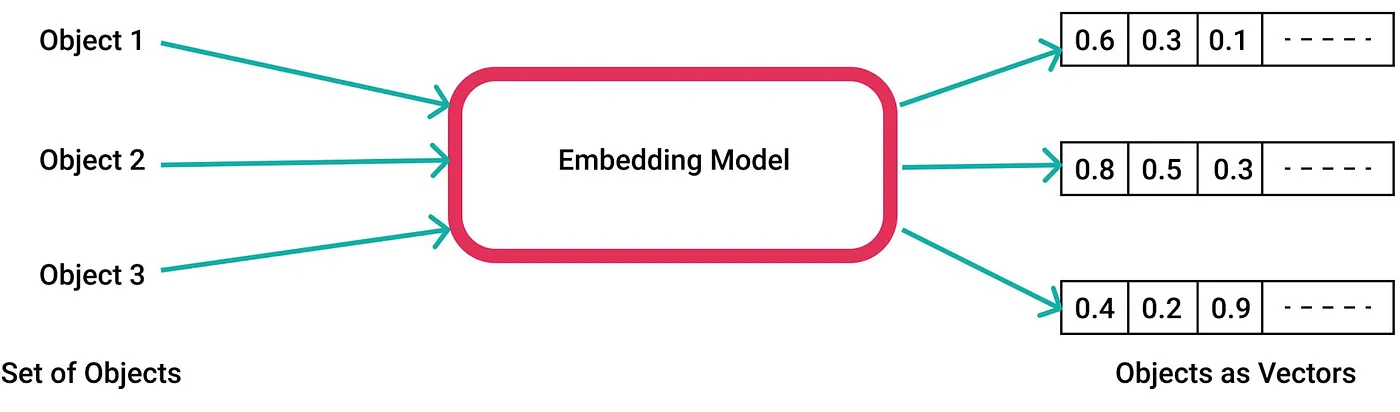
Полученные векторные представления можно использовать в различных приложениях, таких как поиск информации, классификация изображений, обработка естественного языка и т.д.
Следующая диаграмма иллюстрирует эмбеддинги в двумерном пространстве.
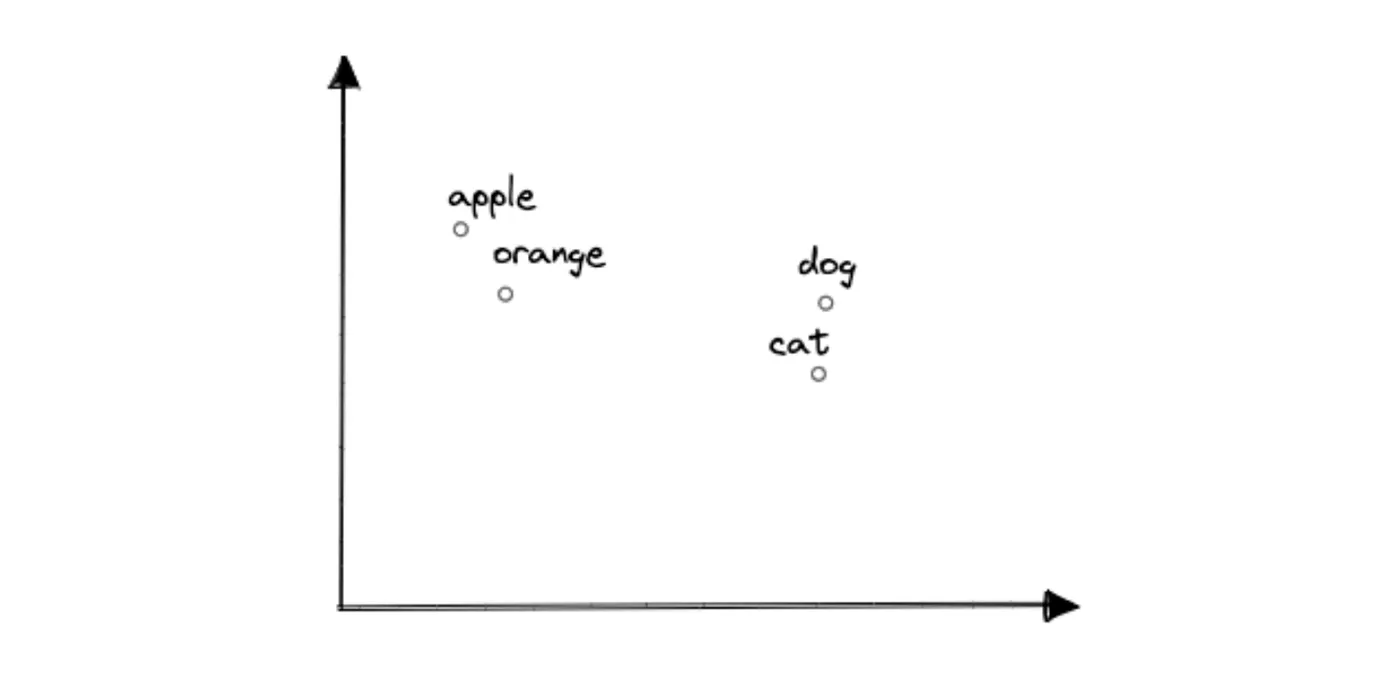
Как Вы можете заметить, семантически схожие слова расположены достаточно близко друг к другу. Например, слово «яблоко» ближе к слову «апельсин», чем «собака» или «кошка».
После генерации эмбеддингов компании могут выполнять поиск сходства в векторном пространстве и создавать приложения ИИ, такие как системы рекомендаций товаров.
Хранение эмбеддингов в Greenplum с помощью pgvector
Greenplum может хранить и запрашивать эмбеддинги благодаря расширению pgvector. Благодаря нему в Greenplum появилась возможность использовать все преимущества векторных баз данных.
Благодаря этому в хранилище данных Greenplum появились возможности векторной базы данных, что позволяет пользователям выполнять более быстрый и эффективный поиск по сходству.
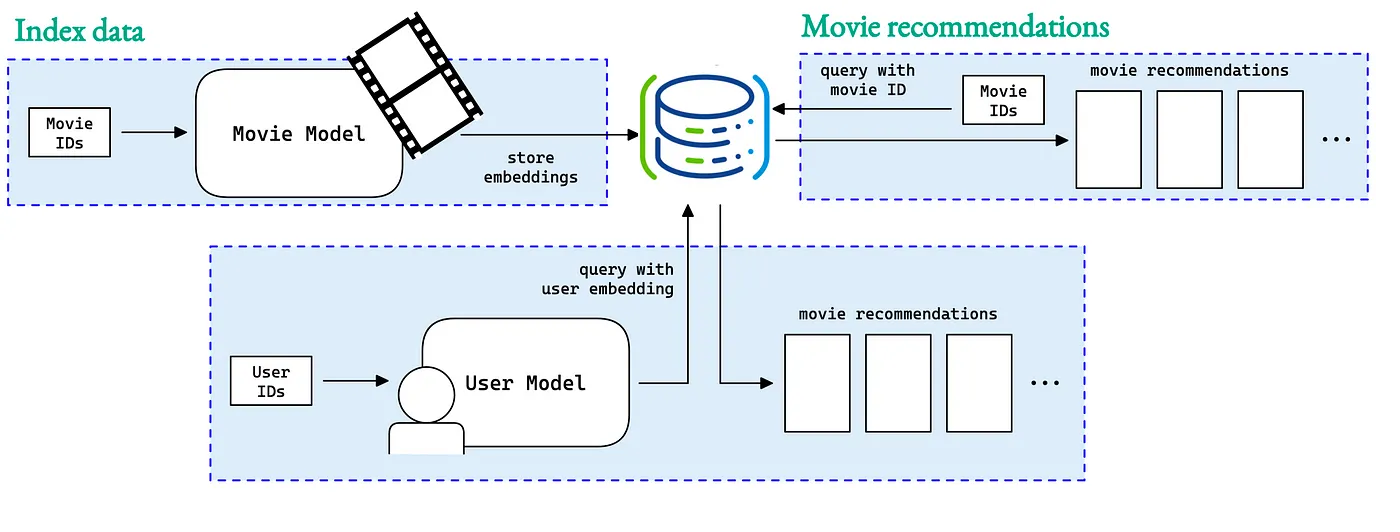
Почему Greenplum использует pgvector?
Многие компании хотели бы хранить, запрашивать и выполнять векторный семантический поиск в своем КХД, не управляя при этом другой векторной базой данных.
К счастью, сочетание Greenplum и pgvector позволяет организациям создавать быстрые и масштабируемые приложения с использованием эмбеддингов из моделей ИИ, что положительно сказывается на результатах их финансовой деятельности.
Создайте своего ИИ-ассистента для Вашего продукта в рамках Greenplum с помощью pgvector и OpenAI
Контекст
Мы все пользовались такими чатботами, как ChatGPT, и убедились в том, что они отлично подходят для ответов на самые распространенные вопросы. Однако Вы могли заметить, что ChatGPT не справляется, когда речь идет о глубоких и специфических познаниях. Кроме того, иногда он «придумывает» ответы для того, чтобы замаскировать свои пробелы в знаниях, и никогда не ссылается на используемые источники.
Как мы можем исправить это? Как создать ChatGPT, который будет давать адекватные и релевантные ответы абсолютно на все вопросы?
Чтобы решить эту задачу, мы можем составить документацию по темам, открытую для поиска, и снабдить OpenAI подсказками, специфичными для каждой конкретной задачи. Такое решение вполне может привести нас к более надежным результатам. Другими словами, мы попросим pgvector найти подходящий набор данных из таблиц Greenplum и предоставим его OpenAI в качестве справочного документа для ответа на запросы пользователей.
Эмбеддинги на практике
В этом разделе предлагаю рассмотреть эмбеддинги на практике и научить использовать расширение pgvector для Greenplum, которое облегчает хранение эмбеддингов.
Продемонстрируем данный функционал за счет создания интеллектуального чатбота с помощью OpenAI , который наделим функцией семантического поиска текста для получения ответов на вопросы, касающиеся VMware, Greenplum, RabbitMQ, Gemfire, VMware SQL и VMware Data Service Manager.
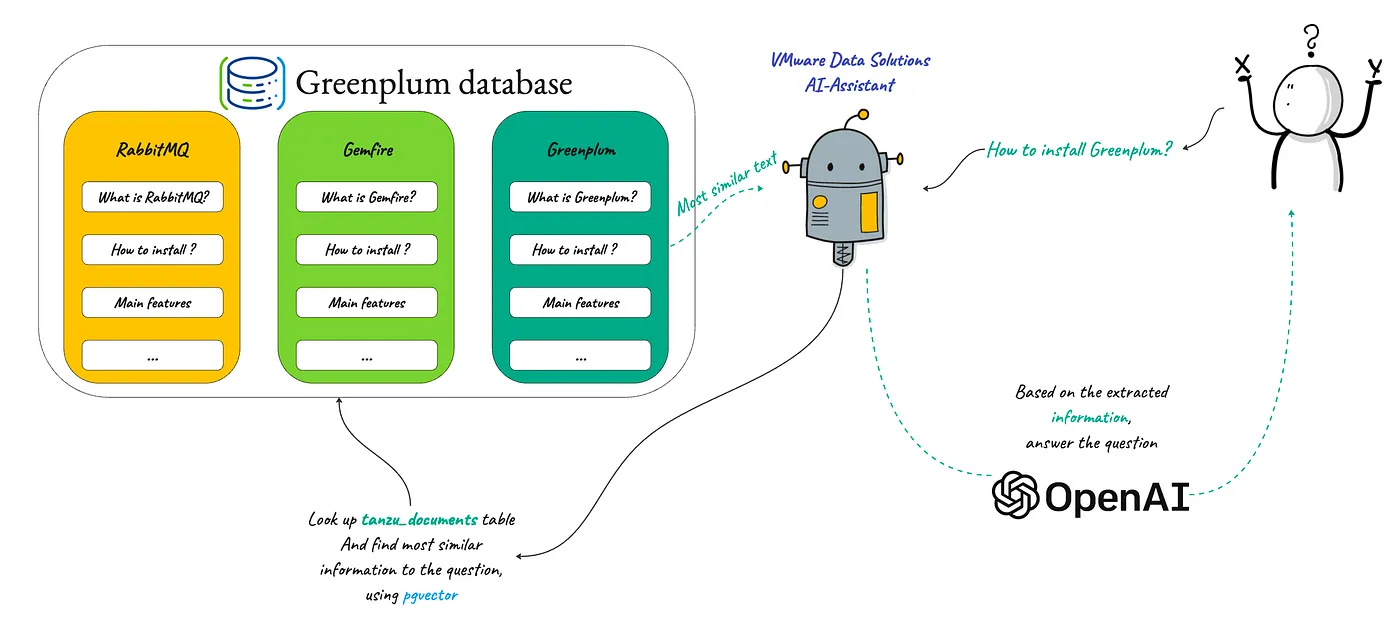
Порядок действий:
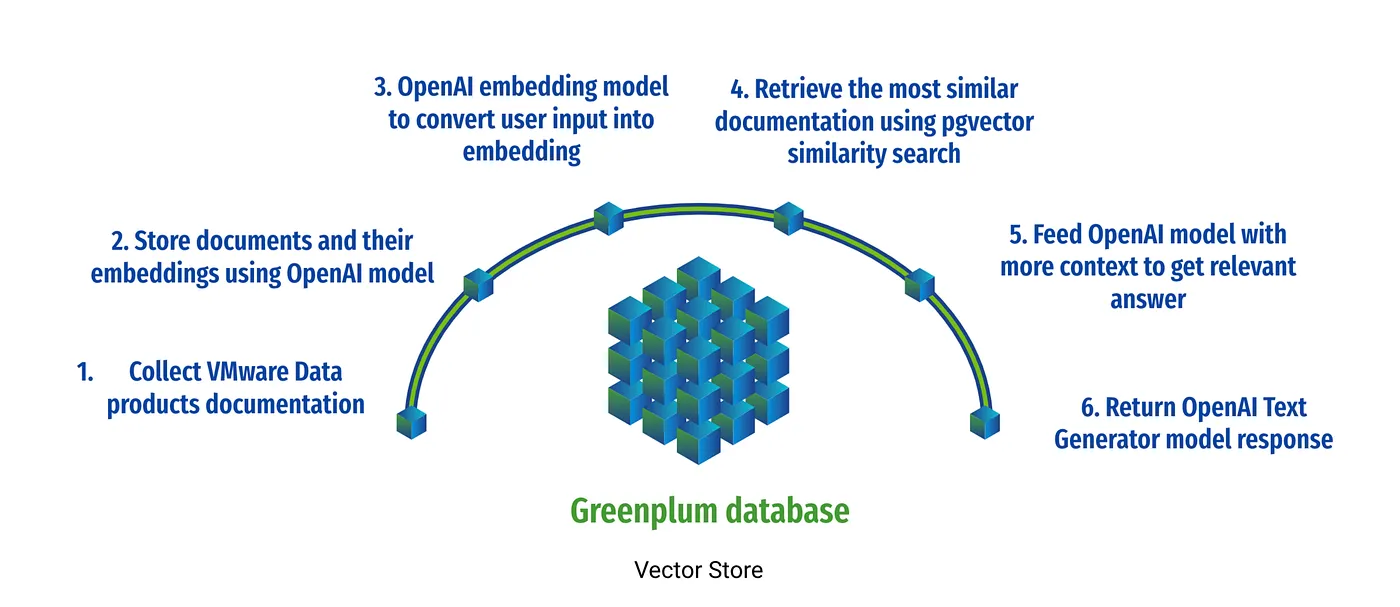
- Установите и запустите расширение pgvector
После успешной установки Вы можете запустить хранение векторных эмбеддингов в Greenplum и выполнить семантический поиск, включив функцию pgvectorrunning:
CREATE EXTENSION vector;
- Создайте таблицу «Документация по продукту», содержащую векторные данные
Теперь создадим таблицу для хранения документации по продуктам и их эмбеддингов:
CREATE TABLE tanzu_documents (
  id bigserial primary key,
  content text,
  embedding vector(1536)
)
DISTRIBUTED BY (id)
;
pgvector вводит новый тип данных, называемый вектором. В приведенном выше коде мы создаем столбец эмбеддинга с векторными данными. Размер вектора определяет, сколько измерений в нем содержится. Модель OpenAI text-embedding-ada-002 выводит 1536 измерений, поэтому мы будем использовать именно это значение для определения размера вектора.
Поскольку в этой статье мы используем API OpenAI, установим пакет openai на каждый запущенный хост Greenplum:
gpssh -f gphostsfile -e 'pip3 install -y openai'
Мы также создаем текстовый столбец с именем content для хранения оригинального текста документации по продукту.
NB: В таблице выше данные распределены по столбцу «id» между сегментами Greenplum, расширение pgvectorextension отлично сочетается с функциями Greenplum. Таким образом, добавление pgvector в управление и поиск нужной информации среди больших объемов данных позволяет пользователям Greenplum создавать масштабируемые ИИ-приложения.
- Greenplum PL/Python для получения доступа к эмбеддингам OpenAI
Теперь необходимо сгенерировать эмбеддинги для наших документов; в данном случае для генерации эмбеддингов из текста мы будем использовать API модели OpenAI text-embedding-ada-002.
Лучший способ сделать это - создать функцию Python внутри базы данных Greenplum, используя процедурный языкPL/Python3u.
CREATE OR REPLACE FUNCTION get_embeddings(content text)
RETURNS VECTOR
AS
$$

  import openai
  import os
  text = content
  openai.api_key = os.getenv("OPENAI_API_KEY")
  response = openai.Embedding.create(
         model="text-embedding-ada-002",
         input = text.replace("\n"," ")
     )

  embedding = response['data'][0]['embedding']
  return embedding

$$ LANGUAGE PLPYTHON3U;
4. Загрузите данные в таблицу Greenplum
Загрузите оригинальные тексты в таблицу tanzu_documents, в частности в столбец tocontent, затем обновите столбец embedding и сгенерируйте эмбеддинги OpenAI с помощью ранее созданной Python-функции get_embeddings:
UPDATE tanzu_documents SET embedding = get_embeddings(content);
5. Первый запрос на семантический поиск
Давайте составим наш первый семантический поисковый запрос, используя косинусное расстояние pgvector (с помощью оператора <=>), и найдем наиболее текст, наиболее подходящий для ответа наш вопрос (т.е. текст с минимальным расстоянием): Как установить Greenplum?
WITH cte_question_embedding AS
   ( SELECT get_embeddings('How to create an external table in Greenplum using PXF to read from an Oracle database ?')
         AS question_embeddings
 )  SELECT id, content, embedding <=> cte_question_embedding.question_embeddings AS distance
   FROM tanzu_documents, cte_question_embedding
     ORDER BY embedding <=> cte_question_embedding.question_embeddings
  ASC LIMIT 1 ;
pgvector вводит три новых оператора, которые можно использовать для вычисления сходства: Евклидово расстояние (расстояние L2) <->, отрицательное внутреннее произведение <#> и косинусное расстояние <=>.
Оператор SELECT должен вернуть следующий результат:
id       | 640
 content  | title: Accessing External Data with PXF --- Data managed by your organisation may already reside in external sources such as Hadoop, object stores, and other SQL databases. The Greenplum Platform Extension Framework \(PXF\) provides access to this external data via built-in connectors that map an external data source to a Greenplum Database table definition. PXF is installed with Hadoop and Object Storage connectors. These connectors enable you to read external data stored in text, Avro, JSON, RCFile, Parquet, SequenceFile, and ORC formats. You can use the JDBC connector to access an external SQL database. > **Note** In previous versions of the Greenplum Database, you may have used the `gphdfs` external table protocol to access data stored in Hadoop. Greenplum Database version 6.0.0 removes the `gphdfs` protocol. Use PXF and the `pxf` external table protocol to access Hadoop in Greenplum Database version 6.x. The Greenplum Platform Extension Framework includes a C-language extension and a Java service. After configuring and initialising PXF, you start a single PXF JVM process on each Greenplum Database segment host. This long-running process concurrently serves multiple query requests. For detailed information about the architecture of and using PXF, refer to the [Greenplum Platform Extension Framework \(PXF\)](https://docs.vmware.com/en/VMware-Greenplum-Platform-Extension-Framework/6.6/greenplum-platform-extension-framework/overview_pxf.html) documentation. **Parent topic:** [Working with External Data](../external/g-working-with-file-based-ext-tables.html) **Parent topic:** [Loading and Unloading Data](../load/topics/g-loading-and-unloading-data.html)
 distance | 0.12006528354516588
6. SQL-функция поиска по сходству
Итак, мы собираемся выполнить поиск сходства по многим эмбеддингам. Давайте создадим соответствующую SQL-функцию:
CREATE OR REPLACE FUNCTION match_documents (
   query_embedding VECTOR(1536),
   match_threshold FLOAT,
   match_count INT
 ) RETURNS TABLE (
   id BIGINT,
   content TEXT,   similarity FLOAT
 ) AS $$
   SELECT
     documents.id,     documents.content,     1 - (documents.embedding <=> query_embedding) AS similarity
   FROM tanzu_documents documents
   WHERE 1 - (documents.embedding <=> query_embedding) > match_threshold
   ORDER BY similarity DESC
   LIMIT match_count; $$ LANGUAGE SQL STABLE;
Мы будем использовать функцию match_documents и предоставим текст, наиболее похожий на модель OpenAI, в следующем виде:
SELECT t.id, t.content, t.similarity
   FROM match_documents(           (select get_embeddings('How to create an external table in Greenplum using PXF to read from an Oracle database ?'))             , 0.8            , 1) t ;
id | 640 content | title: Accessing External Data with PXF --- Data managed by your organisation may already reside in external sources such as Hadoop, object stores, and other SQL databases. The Greenplum Platform Extension Framework \(PXF\) provides access to this external data via built-in connectors that map an external data source to a Greenplum Database table definition. PXF is installed with Hadoop and Object Storage connectors. These connectors enable you to read external data stored in text, Avro, JSON, RCFile, Parquet, SequenceFile, and ORC formats. You can use the JDBC connector to access an external SQL database. > **Note** In previous versions of the Greenplum Database, you may have used the `gphdfs` external table protocol to access data stored in Hadoop. Greenplum Database version 6.0.0 removes the `gphdfs` protocol. Use PXF and the `pxf` external table protocol to access Hadoop in Greenplum Database version 6.x. The Greenplum Platform Extension Framework includes a C-language extension and a Java service. After configuring and initialising PXF, you start a single PXF JVM process on each Greenplum Database segment host. This long-running process concurrently serves multiple query requests. For detailed information about the architecture of and using PXF, refer to the [Greenplum Platform Extension Framework \(PXF\)](https://docs.vmware.com/en/VMware-Greenplum-Platform-Extension-Framework/6.6/greenplum-platform-extension-framework/overview_pxf.html) documentation. **Parent topic:** [Working with External Data](../external/g-working-with-file-based-ext-tables.html) **Parent topic:** [Loading and Unloading Data](../load/topics/g-loading-and-unloading-data.html) similarity | 0.8775289173395486
7. Векторное индексирование
Наша таблица со временем может расшириться за счет эмбеддингов, и мы, вероятно, захотим выполнить семантический поиск по миллиардам векторов.
Здесь нам на помощь придет pgvector, так он может индексировать вектора, которые ускоряют выполнение запросов и обеспечивают более быстрый поиск.
Векторные индексы выполняют точный поиск ближайшего соседа (ANN/KNN), кроме того, они важны для ускорения упорядочивания (ORDER BY). Поскольку векторы не группируются по сходству, поиск ближайшего соответствия путем последовательного сканирования является медленной операцией.
Для каждого оператора расстояния требуется свой тип индекса. Наиболее подходящим начальным числом для списков является rows / 1000 для строк до 1M и sqrt (rows) для более 1M. Поскольку мы упорядочиваем данные по косинусному расстоянию, будем использовать индекс vector_cosine_ops.
-- Create a Vector Index
CREATE INDEX ON tanzu_documents
USING ivfflat (embedding vector_cosine_ops)
WITH
  (lists = 300);

-- Analyze table
ANALYZE tanzu_documents;
Подробнее о векторном индексировании Вы можете узнать здесь.
8. Предоставьте модели OpenAI необходимый набор данных для получения релевантного ответа
Создайте функцию PL/Python, которая принимает текст пользователя и подбирает наиболее похожий на него текст, а затем просит модель OpenAI дать ответ:
CREATE FUNCTION ask_openai(user_input text, document text)
RETURNS TEXT
AS
$$

   import openai
   import os

   openai.api_key = os.getenv("OPENAI_API_KEY")
   search_string = user_input
   docs_text = document

   messages = [{"role": "system",
                "content": "You concisely answer questions based on text provided to you."}]

   prompt = """Answer the user's prompt or question:

   {search_string}

   by summarising the following text:

   {docs_text}

   Keep your answer direct and concise. Provide code snippets where applicable.
   The question is about a Greenplum / PostgreSQL database. You can enrich the answer with other
   Greenplum or PostgreSQL-relevant details if applicable.""".format(search_string=search_string, docs_text=docs_text)

   messages.append({"role": "user", "content": prompt})

   response = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=messages)
   return response.choices[0]["message"]["content"]

$$ LANGUAGE PLPYTHON3U;
9. Создание интеллектуальной функции поиска
Как мы уже говорили ранее, ChatGPT не просто возвращает содержимое документов. Он способен ассимилировать различную информацию в единый, целостный ответ. Для этого нам нужно предоставить GPT несколько релевантных документов и подсказку, которую он может использовать для формулирования ответа.
Теперь мы должны объединить предыдущие функции в один процесс для обслуживания нашего ИИ – ассистента.
Созданные нами функции и эмбеддинги могут помочь нам решить эту задачу:
- Запросите нашу базу данных найти наиболее релевантные документы, относящиеся к заданному вопросу.
- Добавьте эти документы в качестве контекста, на который модель OpenAI будет ссылаться при генерации ответа.
CREATE OR REPLACE FUNCTION intelligent_ai_assistant(
  user_input TEXT
)

RETURNS TABLE (
  content TEXT
)
LANGUAGE SQL STABLE
AS $$

  SELECT
    ask_openai(user_input,
              (SELECT t.content
                FROM match_documents(
                      (SELECT get_embeddings(user_input)) ,
                        0.8,
                        1) t
                )
    );

$$;
Упомянутая выше SQL-функция принимает запрос, преобразует его в эмбеддинги, выполняет семантический поиск текста по таблице pgvectoron tanzu_documents и находит наиболее релевантную документацию. Далее она передает эту документацию в качестве справочного текста API OpenAI, который возвращает окончательный ответ.
10. Создайте свой собственный чатбот с возможностью семантического поиска с помощью OpenAI и Streamlit.
Таким образом, мы разработали чатбот Streamlit, который понимает наши документы и использует в своей работе хранилище данных Greenplum с расширением pgvector
Исходный код доступен по ссылке.
Заключение
В заключение можно сказать, что компании, стремящиеся создать масштабируемые приложения ИИ, вполне могут использовать Greenplum, а также возможности массивно-параллельной обработки данных и объединить ее с расширением pgvectort, позволяющим выполнять быстрый поиск, находить сходство и осуществлять семантический поиск по огромным объемам векторных эмбеддингов и неструктурированных данных.


