

Архитектура данных и метаданных: базовые принципы
В контексте OpenMetadata архитектура данных и сопутствующих метаданных выступает ядром цифровой трансформации данных в организации. Эффективная архитектура обеспечивает согласованность между источниками данных, процессами обработки, хранилищем метаданных, инструментами поиска и управления качеством данных, а также надежной политикой доступа. В этой главе рассмотрены базовые принципы построения такой архитектуры: слоность, модели данных, принципы ингерирования и интеграции, механизмы линейности данных, а также аспекты безопасности и эксплуатации. Цель — сформировать прочную концептуальную базу, на которой можно строить конкретные решения на базе OpenMetadata и эффективные сценарии внедрения в крупной корпоративной среде.
OpenMetadata выступает как координационный центр data-каталога: он объединяет метаданные технического уровня, бизнес-словарь, данные о владельцах и ответственности за активы, данные о происхождении и путях преобразования, а также сигналы качества и политики доступа. Архитектура должна поддерживать модульность и заменяемость компонентов, обеспечивать идемпотентность операций обновления метаданных и обеспечивать своевременное распространение изменений в рамках всей экосистемы.
Ключевые принципы, которым следует следовать при формировании архитектуры OpenMetadata:
- разделение слоев: источники данных, инжестор-пайплайны, хранилище метаданных и сервисы доступа, пользовательские интерфейсы и интеграции;
- модель данных с графовой связностью: линейность и зависимые связи между активами, их схемами, столбцами и бизнес-терминами;
- событийность и обновления в режиме реального времени: события изменения метаданных должны инициировать обновления в индексах и аналитических дашбордах;
- прозрачность и управляемость: политика доступа и аудит должны быть встроены на уровне архитектуры;
- масштабируемость и устойчивость: возможность горизонтального масштабирования сервисов и обработки больших объемов метаданных без потери согласованности;
- совместимость и стандарты: поддержка открытых протоколов, форматов и интеграций.
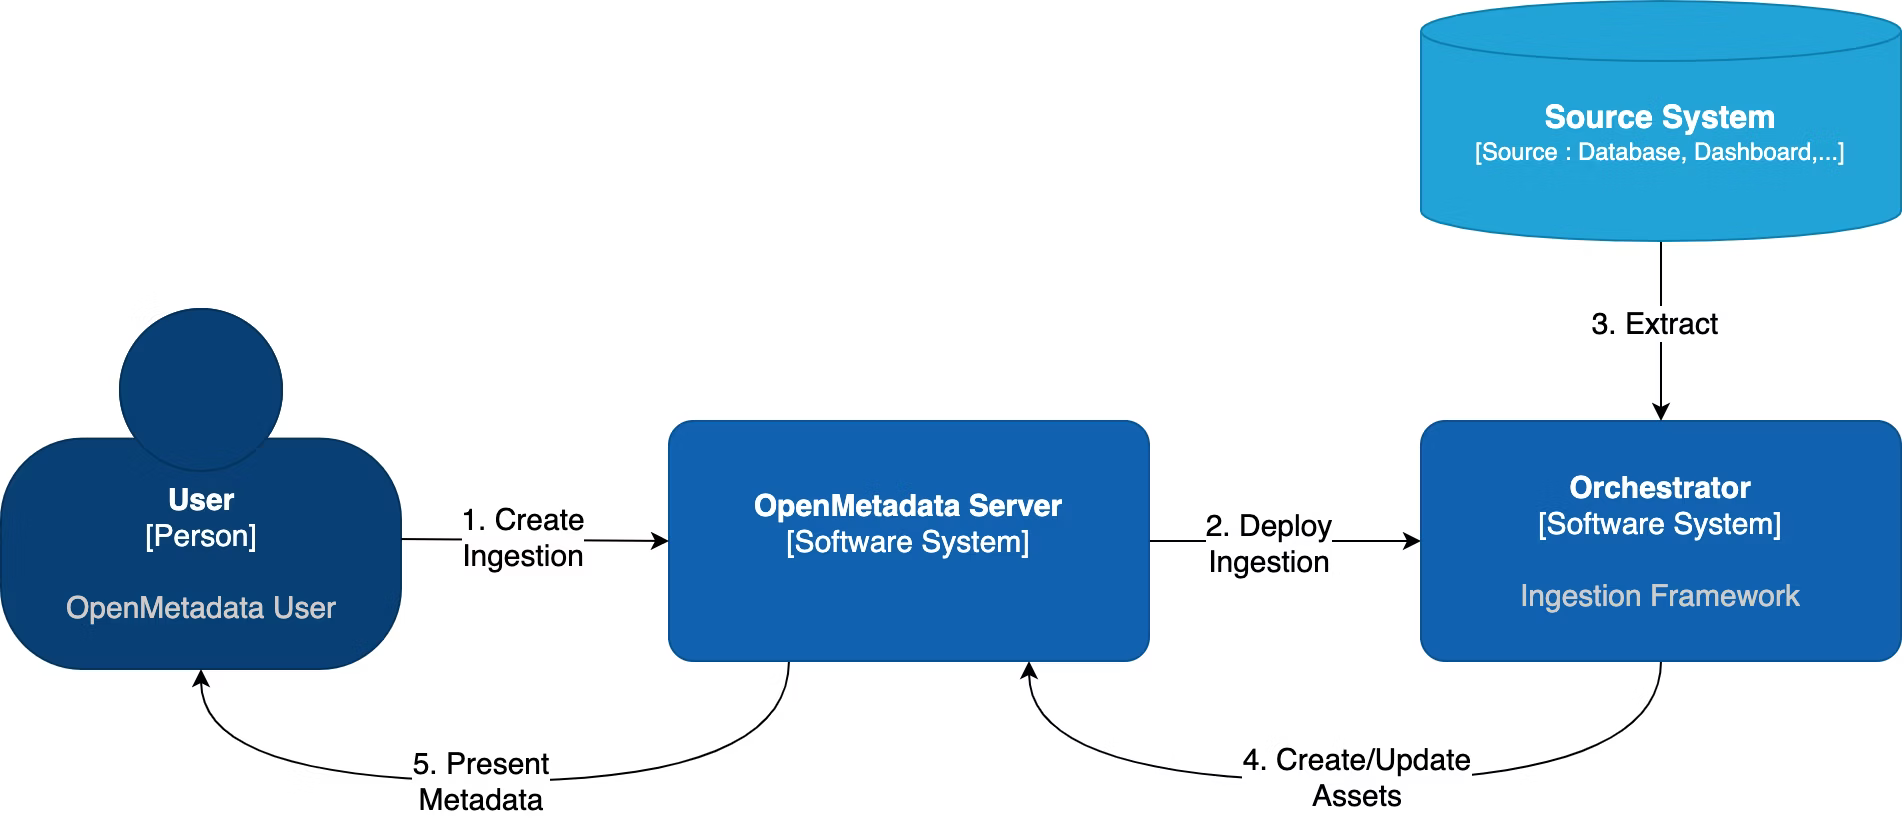
Архитектура: уровни и принципы
Разделение архитектуры на уровни обеспечивает изоляцию изменений, облегчает развитие и снижает риски. Рассмотрим условную схему уровней и их роли.
Уровень источников данных
- сюда включаются базы данных (реляционные, колоночные), хранилища данных, файловые системы и внешние сервисы, такие как BI-инструменты или marts.
- задача этого уровня — обеспечить достоверное подключение и корректный захват изменений для последующей обработки.
Уровень инГестии и обработки метаданных
- здесь реализуется сбор и нормализация метаданных, их обогащение и первичное сопоставление с бизнес-терминами.
- роль пайплайнов — детектирование схем, обнаружение изменений в таблицах и колонках, поддержка версионности.
Уровень хранилища метаданных и индексации
- основной репозиторий метаданных, где сохраняются активы, их свойства, линейные связи, владение, теги и бизнес-термины.
- обеспечивает быстрый поиск, гидридную навигацию по графу зависимостей и эффективное формирование линейной иерархии.
Уровень API, UI и интеграций
- предоставляет REST/GraphQL-подобные интерфейсы для потребителей: исследователям, аналитикам, дата-аналитикам и администраторам.
- обеспечивает совместное использование метаданных через инструменты данных и внешние сервисы через вебхуки и события.
Уровень политики, безопасности и аудита
- реализует доступ и контроль над использованием активов, хранение аудита изменений, соответствие требованиям по приватности и данным.
Уровень инфраструктуры и операционного мониторинга
- охватывает вопросы производительности, резервного копирования, восстановления, мониторинга, журналирования и устойчивости к сбоям.
Эти уровни взаимодействуют через четко определенные API и коннекторы. Архитектура должна обеспечивать: идемпотентность инцидентов обновления, консистентность между источниками и хранилищем, а также возможность восстановления после сбоев без потери целостности графа активов.
Модели данных и метаданных OpenMetadata
Эта часть посвящена тому, какие сущности лежат в основе архитектуры каталога и как они связаны между собой. В OpenMetadata принципы моделирования опираются на графовую модель: активы, их свойства и связи образуют граф, который поддерживает как точную структурированную информацию, так и семантику бизнеса.
Основные сущности
- DataAsset или Dataset — любой набор данных, который может быть источником, результатом трансформации или целевой строкой для аналитики.
- Table, Schema, Column — базовые элементы структуры данных, позволяющие восстанавливать схемы и поддерживать их эволюцию.
- Service или Connection — конфигурация доступа к источнику данных: тип источника, параметры подключения, версия сервиса.
- Owner и Team — ответственные лица и коллективы, которые управляют активами.
- Tag и GlossaryTerm — контекстная семантика, бизнес-словарь; позволяют объединять техничекские и бизнес-термины.
- Lineage — графовые связи, показывающие, как данные проходят от источников через трансформации к целевым активам.
- Data Quality Rule и Data Quality Result — механизмы проверки качества и мониторинга соответствия требованиям к данным.
Взаимосвязи и графовая модель
- Связи между Table и Column, между DataAsset и его источник, между DataAsset и Lineage позволяют строить ориентированные графы, облегчающие поиск зависимостей, влияние изменений и аудит.
- Линейность не ограничивается табличной структурой. Графовая модель охватывает сущности бизнес-словаря и термины, связывая техническую реализацию с бизнес-контекстом.
Модель бизнес-словаря и семантика
- Грамотно выстроенный словарь терминов и соответствие им к техническим активам обеспечивает единое понимание данных в организации и снижает риск некорректного толкования.
Метрики качества и мониторинг
- Метаданные о качестве данных интегрируются в граф и становятся частью политик доступа: качество может стать критерием для публикации активов или требовать дополнительных проверок.
Эволюция модели
- Модель должна поддерживать версионирование активов, прозрачную миграцию схем и безопасное внедрение изменений, чтобы не нарушать зависимые пайплайны и анализы.
Принципы, заложенные в модель данных OpenMetadata, позволяют:
- обеспечить единое семейство метаданных, синхронизированное с реальными источниками;
- отслеживать происхождение и траекторию данных через линейки линейности и трансформаций;
- связывать технические активы с бизнес-контекстом и правилами эксплуатации;
- поддерживать аудит и соответствие требованиям к данным.
Интеграции, источники данных и пайплайны
Современная архитектура data-каталога не существует без надежных интеграций и коннекторов к разнообразным источникам. В OpenMetadata интеграции реализуются через метаданные-источники и пайплайны обработки.
Источники данных и коннекторы
- Ключевые коннекторы обеспечивают подключение к реляционным базам данных, облачным хранилищам, файловым системам и бизнес-инструментам. Выбор источника зависит от типа данных и требований к задержке обновления.
- Важный аспект — поддержка режимов инкрементного обновления и детекции изменений. Это позволяет не загружать повторно весь набор метаданных, а фиксировать только обновления.
Ингесторы и пайплайны
- Пайплайны развертываются для непрерывного извлечения метаданных, обогащения и согласования с бизнес-терминологией. В современных реализациях они работают в рамках orchestration-систем и поддерживают повторяемость операций.
- Важное требование — идемпотентность пайплайнов: повторная обработка не должна приводить к противоречиям в графе активов и должен быть сохранён корректный статус обновления.
Принципы обработки и обогащения
- Обогащение метаданными включает уточнение схем, сопоставление столбцов с бизнес-терминами, добавление владельцев и контекста использования.
- В зачатке архитектуры следует заложить правила агрегации: как разные источники представляют одну и ту же сущность, как обновлять дубликаты и как разрешать конфликты версий.
Событийность и обмен сигналами
- Архитектура должна поддерживать передачу событий об изменениях через механизм уведомлений или событийно-ориентированную модель (например, через шину событий).
- Это обеспечивает оперативное обновление индексов поиска, уведомления потребителей и актуализацию линейности при изменении источника.
Практическая рекомендация: планируйте конструктор пайплайнов в виде модульной конфигурации, где каждый коннектор — автономный модуль, а обработка метаданных — композиция из нескольких этапов: сбор, нормализация, связь, обогащение, аудит. Такой подход упрощает расширение системы новыми источниками и минимизирует влияние изменений на существующую инфраструктуру.
Хранилище, поиск и производительность
Хранилище метаданных и поддерживаемые механизмы поиска являются критическими для быстрого доступа к информации и ее актуальности. Архитектура должна обеспечивать баланс между целостностью графа активов и скоростью доступа к ним.
Хранилище метаданных
- Главный репозиторий хранит сущности и их свойства, историю изменений и связи между активами. База данных хранилища должна обеспечивать согласованность и возможность отката, особенно при массовых обновлениях.
- Версионность и история изменений позволяют восстанавливать состояние графа на конкретный момент времени и анализировать эволюцию активов.
Поиск и индексация
- Для эффективного поиска критически важен полнотекстовый индекс по названиям активов, их описаниям и бизнес-терминам. Индексация ускоряет навигацию и поддерживает функциональные фильтры.
- Поддержка фильтров по владению, тегам, галочкам качества, источникам и другим метаданным облегчает операционную работу и аудит.
Кэширование и масштабирование
- Частые запросы к метаданным могут обойтись дешевле через кэш-слой, особенно для часто просматриваемых активов или для повторяющихся сценариев анализа.
- Масштабирование достигается за счет горизонтального масштабирования сервисов и разделения данных по функциональным областям, что позволяет обрабатывать рост объемов метаданных без потери производительности.
Надежность и консистентность
- Важно обеспечить устойчивость к сбоям: репликация хранилища, резервное копирование, мониторинг integrity-constraints и автоматическое повторное выполнение неудавшихся операций обновления.
Безопасность, управление доступом и соответствие
Управление доступом к метаданным и обеспечение соответствия требованиям к данным — критически важные аспекты архитектуры. Метаданные часто содержат как техническую, так и бизнес-информацию, и баланс между доступностью и защитой должен быть четко прописан.
Модели доступа
- RBAC обеспечивает базовую грануляцию прав по ролям: администратор, аналитик, бизнес-пользователь и т. п. Это позволяет ограничивать доступ к определенным активам и функциям системы.
- ABAC или политика на основе атрибутов позволяют устанавливать более гибкие правила доступа, например, по месту работы, проекту, уровню конфиденциальности данных.
- Политика доступа должна быть кодируемой и проверяемой на этапе развёртывания: подход "Policy as Code" повышает повторяемость и аудит.
Аудит и соответствие
- Включение детального аудита изменений метаданных (кто и когда обновлял актив, какие операции выполнены) обеспечивает прозрачность и traceability для регуляторных требований.
Защита и приватность
- В случае критичных данных следует применять практики минимизации доступа, маскирование или псевдонимизацию для бизнес-данных, а также шифрование на уровне хранения и передачи.
Институциональные процессы
- Встроенные процессы одобрения изменений в конфигурациях и политике доступов снижают риск непреднамеренной утечки или изменения ключевых метаданных.
Общий дух безопасности
- Архитектура должна поддерживать принцип "не доверяй по умолчанию" и требовать явной аутентификации и авторизации для любых операций над метаданными.
Эволюция архитектуры и эксплуатационная практика
Завершая обзор базовых принципов, следует подчеркнуть, что архитектура данных и метаданных в OpenMetadata — это живой организм. Она должна адаптироваться к росту данных, появлению новых источников и меняющимся требованиям бизнеса. На практике это означает:
- Плавную миграцию между версиями моделей данных и пайплайнов. При этом важно сохранять совместимость и обеспечивать миграционные сценарии без простоя.
- Внедрение этапов мониторинга: качество данных, своевременность обновления метаданных, корректность линейности и полнота индексов поиска.
- Управление изменениями на уровне проектирования: документирование изменений, регламент выпуска новых версий и тестирования совместимости с существующими активами.
- Рационализацию и оптимизацию интеграций: выбор наиболее устойчивых коннекторов, сокращение количества повторяющихся источников и унификация форматов.
-
Построение организационных процессов
- создание ответственных за данные ролей и процессов, регламентов по публикации активов и обновлению бизнес-терминологии;
- выстраивание практик обучения и поддержки для пользователей интерфейса поиска и анализа.
-
Учет зарубежной и локальной специфики
- при работе с российскими или локальными системами следует учитывать требования к региональным данным, конфиденциальности и локализации интерфейсов и документации.
Key takeaways
- Архитектура OpenMetadata строится вокруг слоев: источники данных, инжестия и обработка метаданных, хранилище и API/интерфейсы, безопасность и аудит, эксплуатация.
- Графовая модель данных в OpenMetadata обеспечивает гибкое описание линейности, зависимостей и семантики через DataAsset, Table, Column, Lineage, GlossaryTerm и связанные сущности.
- Интеграции и пайплайны должны быть модульными, идемпотентными и поддерживать инкрементальное обновление, чтобы минимизировать простои и конфликты версий.
- Поиск и индексирование — быстрый доступ к активам через полнотекстовый поиск и фильтры по владению, тегам, источникам и качеству данных.
- Безопасность и соответствие должны быть встроены на уровне архитектуры: RBAC/ABAC, аудит изменений, политика доступа как код и защита приватности.
- Эволюционная эксплуатация требует управляемых процессов миграций, мониторинга, поддержки бизнес-терминологии и обучения пользователей.
- При внедрении в реальных условиях разумно ограничиваться 1–2 ключевыми open-source или локальными примерами интеграций, чтобы держать фокус на реальных задачах и архитектурных принципах.
FAQ
1) Что является основой архитектуры OpenMetadata?
- Основой служит модульная, слоистая архитектура, где источники данных соединяются через инжесторы, метаданные сохраняются в централизованном хранилище, а доступ к ним предоставляется через API и UI. Важна графовая модель активов и линейности, которая позволяет прослеживать происхождение и зависимые трансформации.
2) Какие сущности являются фундаментальными в модели OpenMetadata?
- Основные сущности включают DataAsset (или Dataset), Table, Schema, Column, Service/Connection, Owner, Team, Tag, GlossaryTerm и Lineage. Эти сущности связываются через графовые связи, образуя карту данных и их контекста в организации.
3) Как обеспечивается актуальность метаданных при подключении новых источников?
- При добавлении источника конфигурация коннектора задаёт тип источника и параметры доступа; инжесторы запускаются по расписанию или в режиме событий, детектируют изменения в схемах, обновляют метаданные и публикуют события для дальнейшей обработки и индексации.
4) Как OpenMetadata обеспечивает соответствие требованиям к данным?
- В архитектуре заложены механизмы аудита изменений, политики доступа (RBAC/ABAC), защита приватности и возможности маскирования данных там, где это требуется. Политики доступа могут быть реализованы как код и применяться к конкретным активам или группам пользователей.
5) Какие подходы к интеграции источников данных считаться лучшими?
- Предпочтение следует отдавать модульным коннекторам с поддержкой инкрементальных обновлений и идемпотентных пайплайнов. Важно обеспечить единый подход к нормализации схем и сопоставлению с бизнес-терминами, чтобы активы из разных источников можно одинаково интерпретировать.
6) Как решается вопрос производительности в больших средах?
- Решается за счет индексирования и кэширования, горизонтального масштабирования сервисов, разделения данных по функциональным областям и эффективной архитектуры пайплайнов. Важно обеспечить устойчивость к сбоям и возможность быстрого восстановления индексов и графа активов.
7) Какие примеры интеграций особенно полезны на старте внедрения?
- 1–2 примера: интеграция с популярными базами данных и облачными хранилищами (например, PostgreSQL или Snowflake) и подключение к BI-инструменту для синхронизации бизнес-терминологии и линейности. В рамках российского или локального контекста можно рассмотреть открытые решения с поддержкой локализации и соответствия нормативам.
8) Какие риски часто возникают на начальном этапе архитектурной реализации?
- Риски связаны с избыточной сложностью коннекторов, неправильной конфигурацией политик доступа, непоследовательной семантикой бизнес-терминов и несогласованностью версий активов. Их можно снизить через модульность, структурированные пайплайны, аудит и обучение пользователей.
9) Как связаны архитектура и эксплуатация в OpenMetadata?
- Архитектура задаёт основу для устойчивой эксплуатации: четко определённые слои облегчают мониторинг, обновления и масштабирование. Регулярные проверки качества данных, валидация изменений и аудит позволяют поддерживать надежность на протяжении жизненного цикла системы.
10) Какие направления изменений можно рассмотреть в ближайшей перспективе?
- Улучшение поддержки новых источников, усиление событийности, расширение возможностей бизнес-словаря и семантического связывания, повышение эффективности запросов к метаданным и более гибких политик доступа. Также полезно внедрять практики DevOps для управления инфраструктурой метаданных и процессов миграции.


