

Архитектура конвейеров данных: полное руководство по выбору и реализации
В современном мире данные являются кровеносной системой любого цифрового предприятия, основой для принятия стратегических решений, развития продуктов и создания интеллектуальных систем на базе искусственного интеллекта. Однако сами по себе сырые данные малоценны. Их истинная мощь раскрывается только тогда, когда они своевременно, точно и эффективно доставляются туда, где в них нуждаются — в системы аналитики, бизнес-приложения или модели машинного обучения. Ключевым элементом этой доставки является грамотно спроектированный и реализованный конвейер данных.
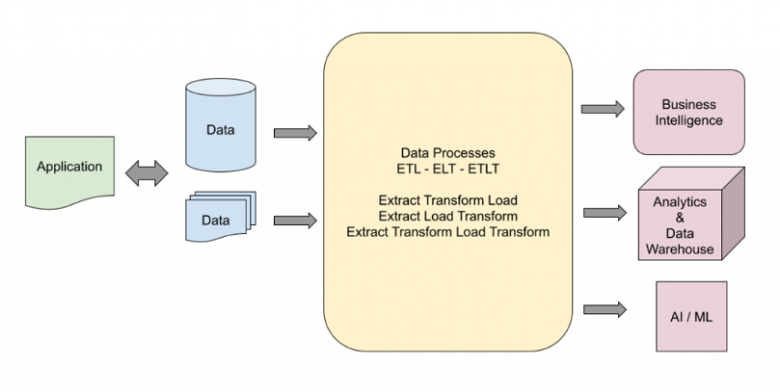
Конвейер данных — это комплекс процессов, которые автоматизируют перемещение и преобразование информации от источника к месту потребления. Его можно представить как сложносочиненный логистический маршрут для ваших данных, включающий этапы извлечения, очистки, обогащения, трансформации и загрузки.
Простой конвейер может быть элементарным, например, регулярное копирование данных из базы данных приложения в хранилище для отчетности. Сложный конвейер может обрабатывать миллионы событий в реальном времени, объединять информацию из десятков разнородных источников, вычислять ключевые метрики и доставлять результаты как в системы визуализации, так и в AI-модели для мгновенного прогнозирования.
Правильный выбор архитектуры конвейера — это не техническая формальность, а стратегическое решение, которое определяет масштабируемость (сможет ли система расти вместе с вашими данными и бизнесом?); надежность (гарантирована ли бесперебойная доставка данных без потерь?); производительность (соответствует ли скорость обработки бизнес-требованиям (реальное время, near-real-time, пакетная обработка)?); стоимость владения (насколько экономичным будет решение в долгосрочной перспективе?) и гибкость (можно ли легко адаптировать конвейер к новым источникам данных и изменяющимся запросам бизнеса?)
Ошибка на этапе проектирования может привести к созданию хрупкой, слишком дорогой и неэффективной системы, которая будет тормозить развитие компании, а не способствовать ему.
Фундаментальные компоненты любого конвейера данных
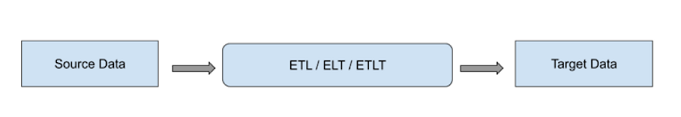
Любой конвейер, от простого до самого сложного, состоит из трех ключевых компонентов:
- Источник данных: точка происхождения информации. Это могут быть реляционные базы данных (PostgreSQL, MySQL), системы NoSQL (MongoDB, Cassandra), корпоративные приложения (ERP, CRM), потоки данных с веб-сайтов и мобильных приложений (Kafka, Kinesis), файлы в облачных хранилищах (CSV, JSON, Parquet) и даже неструктурированные документы (PDF, изображения).
- Процесс обработки и преобразования: "мозг" конвейера. На этом этапе данные очищаются от ошибок, стандартизируются, обогащаются информацией из других источников, агрегируются и трансформируются в формат, пригодный для анализа. Сложность может варьироваться от одного шага до многоступенчатого оркестрированного workflow.
- Целевое хранилище или приложение: конечная точка назначения. Обработанные данные загружаются в хранилища данных (Data Warehouse), такие как Google BigQuery, Amazon Redshift или Snowflake, для сложной аналитики; в озера данных (Data Lake), такие как Amazon S3 или Google Cloud Storage, для хранения сырых данных; или напрямую в бизнес-приложения и API для оперативного использования.
Выбор архитектуры — это всегда компромисс. Наши эксперты рекомендуют принимать решение на основе глубокого анализа следующих факторов.
Во-первых, необходимо учитывать характер данных (пакетные, потоковые или гибрид).
При пакетной обработке (batch processing) данные накапливаются в течение определенного периода (час, день), а затем обрабатываются крупными партиями. Например, ежедневный расчет итоговых продаж за прошедший день для формирования утреннего отчета для руководства. Плюс данного вида обработки данных состоит в высокой эффективности обработки больших объемов, простоты с точки зрения реализации, а также отладки, которая, как правило, сравнительно недорогая. Минусы: высокая задержка и тот факт, что данные не доступны для анализа сразу.
При потоковой обработке (stream processing) данные обрабатываются непрерывно, по мере их поступления, практически в реальном времени. Например, мониторинг мошеннических транзакций в платежной системе, где каждая операция проверяется за миллисекунды. Плюсы: минимальная задержка и возможность мгновенного реагирования, а минусы - сложность проектирования и поддержки, высокая стоимость эксплуатации.
Лямбда-архитектура (Lambda Architecture) - гибридный подход, сочетающий все преимущества обоих методов. Входящий поток данных разделяется на "скоростной слой", который обрабатывает данные в реальном времени для получения актуальных, но неполных результатов, а также на "пакетный слой", который обрабатывает те же данные с опозданием, но обеспечивая точность и полноту. Результаты затем объединяются. Пример: система рекомендаций, где в реальном времени учитываются последние действия пользователя (потоковый слой), а полная история его предпочтений пересчитывается раз в день (пакетный слой).
Во-вторых, необходимо учитывать паттерн загрузки данных: ETL, ELT или ETLT.
ETL (Extract, Transform, Load) - классический подход, при котором данные извлекаются из источника, а затем преобразуются в специальном обработочном кластере (например, с помощью Apache Spark или Google Dataflow) и загружаются в целевую систему в уже готовом для анализа виде. Идеально подходит для сценариев, где целевое хранилище имеет ограниченную вычислительную мощность или где требования к безопасности данных требуют их очистки до загрузки.
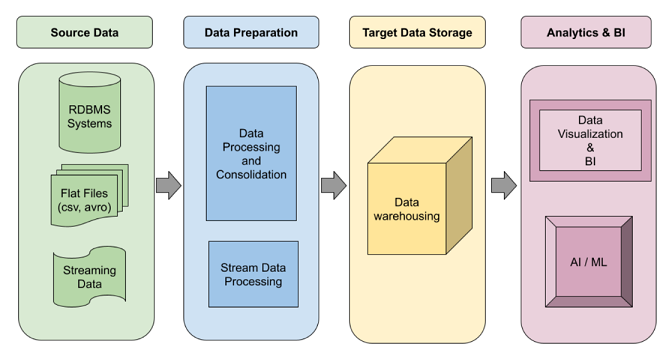
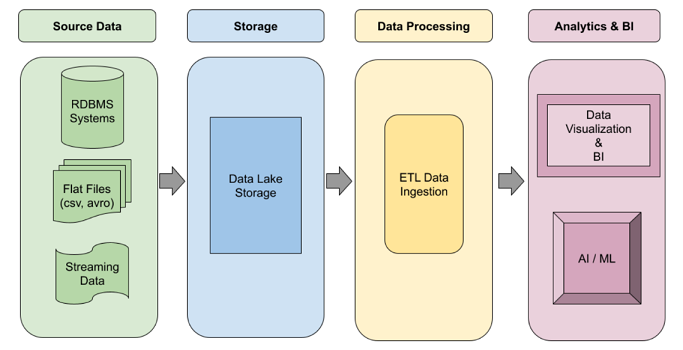
ELT (Extract, Load, Transform) – более современный подход. Данные в этом случае извлекаются и практически без изменений загружаются в мощное целевое хранилище (например, BigQuery или Snowflake), где и происходят все преобразования средствами самого хранилища. Идеально подходит для проектов с Data Lake, где важно сохранить сырые данные, и для сценариев, требующих высокой гибкости, так как бизнес-логику преобразований можно менять, не перестраивая весь конвейер.
В зависимости от требований, типовые архитектурные проекты могут быть реализованы с большей степенью детализации для решения самых различных задач:
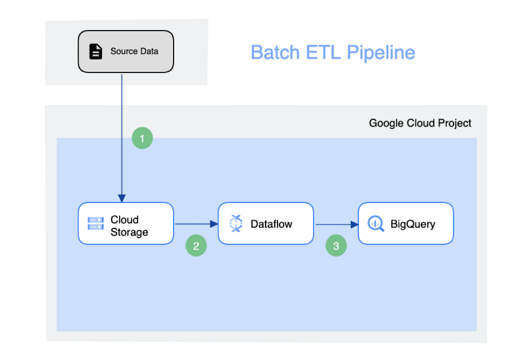
- Пакетный ETL-конвейер в GCP. Источником могут быть файлы, которые должны быть загружены в аналитический механизм BI. Облачное хранилище является средой передачи данных внутри GCP, затем для загрузки данных в целевое хранилище BigQuery используется Dataflow. Простота данного подхода обеспечивает многократное использование этого паттерна и обеспечивает его эффективность при простых преобразованиях.
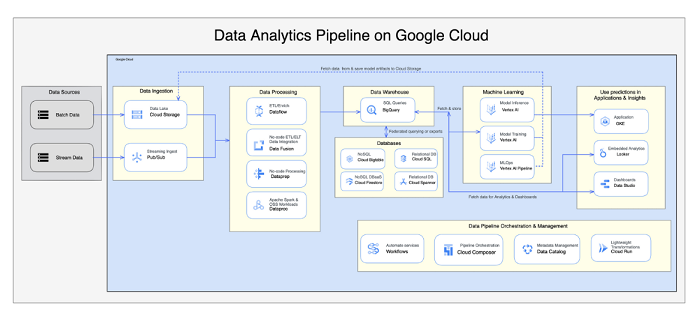
- Конвейер анализа данных — более сложная цепочка, которая включает в себя конвейеры как для пакетного, так и для потокового ввода данных. Обработка достаточно сложна, для преобразования данных в хранилище и точку доступа AL/ML используется множество различных инструментов и сервисов.
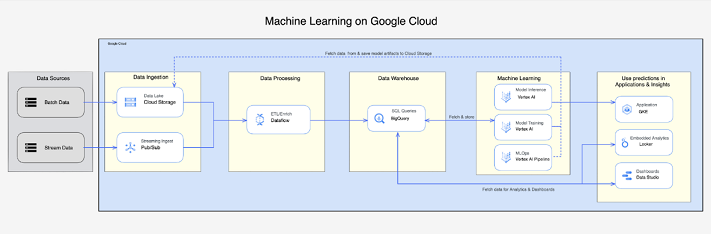
- Конвейер данных машинного обучения в GCP — это комплексный проект, позволяющий клиентам использовать собственные службы GCP для построения и обработки процессов ML.
В – третьих, это масштаб и объем данных.
Объем данных, которые необходимо обрабатывать ежедневно, — критически важный фактор. Архитектура, идеально работающая с гигабайтами данных, может полностью отказать при переходе на терабайты. Необходимо выбирать технологии, которые могут горизонтально масштабироваться. Например, управляемые сервисы вроде Google Dataflow или Amazon Kinesis автоматически масштабируются под нагрузку, в то время как самописные решения на базе виртуальных машин потребуют ручного вмешательства и могут стать узким местом.
В – четвертых, это бюджет и стоимость владения (TCO).
Стоимость — это не только первоначальные инвестиции в разработку. Важно оценить долгосрочные расходы на эксплуатацию, включая затраты на хранение, вычислительные ресурсы и поддержку. Потоковые конвейеры, как правило, значительно дороже пакетных. Использование облачных serverless-сервисов (например, Cloud Functions, BigQuery) может снизить затраты за счет оплаты только за фактическое использование, в отличие от содержания постоянно работающих виртуальных машин.
Рассмотрим несколько типовых архитектур, которые мы успешно реализуем для наших клиентов.
Пример 1: Пакетный ETL/ELT-конвейер для бизнес-аналитики
Его основная задача состоит в ежедневной загрузке данных о продажах из операционной базы данных PostgreSQL и из CSV-файлов из FTP-сервера в хранилище данных для построения отчетов в Tableau.
Логическая архитектура может быть представлена следующим образом:
- Источники: PostgreSQL, FTP-сервер;
- Оркестратор: расписание и управление конвейером осуществляется с помощью Cloud Composer (управляемый Apache Airflow);
- Извлечение и загрузка: скрипт в Airflow DAG извлекает данные из PostgreSQL (через соединение) и из FTP, загружая сырые данные в бакет Google Cloud Storage (GCS) в формате Parquet. Это этап Extract & Load;
- Преобразование: запускается задача в Google Dataflow или, что чаще и эффективнее, SQL-скрипт в BigQuery, который преобразует сырые данные из GCS, объединяет их и формирует готовые аналитические таблицы. Это этап Transform (по модели ELT);
- Цель: обработанные данные доступны в BigQuery для BI-инструментов.
Если рассматривать риски, то здесь в первую очередь стоит упомянуть про возможную потерю данных при сбое во время загрузки. Что не допустить чего-то подобного,лучше хранить сырые данные в GCS до успешной обработки.
Еще один возможный риск - рост объема данных и увеличение времени обработки. В качестве решения мы можем предложить использование партиционирования и кластеризации таблиц в BigQuery для ускорения запросов и снижения стоимости.
Примечание:
Cloud Platform (GCP). Если проводить аналогию, это как огромный, невероятно надежный и безграничный "жесткий диск" в облаке, доступный из любой точки мира через интернет.
В этом случае данные хранятся как объекты. Каждый объект — это собственно данные (файл), его метаданные (информация о файле) и уникальный идентификатор (ключ). В отличие от блочных хранилищ (как на вашем жестком диске) или иерархических файловых систем, здесь используется плоская структура с "корзинами" (buckets), внутри которых находятся объекты.
Такой формат идеально подходит для хранения любых типов данных практически любого объема — от маленьких лог-файлов до многопетабайтных архивов научных данных, видеофайлов, образов дисков и резервных копий.
GCS обеспечивает невероятно высокий уровень отказоустойчивости и доступности за счет нескольких технологий. Когда вы загружаете объект в GCS, он не просто записывается на один диск в одном дата-центре. GCS автоматически реплицирует (копирует) ваши данные сразу несколькими способами.
Кроме того, Google использует технологии автоматического обнаружения и исправления повреждений данных на дисках. Если сектор диска начинает "портиться", система обнаруживает это по контрольным суммам и автоматически восстанавливает данные из другой реплики на новом исправном диске. Этот процесс непрерывен и не требует вашего участия.
Вероятность безвозвратной потери объекта в GCS чрезвычайно мала. Google заявляет о достижении 99.999999999% (11 девяток) долговечности в год. Это означает, что если вы храните 10 миллионов объектов, в среднем можно ожидать потерю одного объекта раз в 10 000 лет (!)
GCS предлагает разные классы хранения, оптимизированные под частоту доступа к данным, что позволяет значительно снизить затраты, правильно подобрав класс под задачу.
В целом, GCS — идеальная "среда передачи" в конвейере, поскольку она обеспечивает решает следующие задачи:
- Обеспечивает надежность приема данных. Вы загружаете сырые данные из источника (например, из PostgreSQL дамп) в GCS. Даже если следующий шаг конвейера (например, Dataflow) временно недоступен, ваши данные уже в безопасности. Они не потеряются, так как надежно сохранены в GCS.
- Гарантирует разделение ответственности. GCS в данном случае выступает как буфер и надежное исходное хранилище. Обработочные системы (Dataflow, Dataproc) могут падать и перезапускаться, но они всегда будут "тянуть" данные из неизменного и доступного источника — GCS.
- Позволяет экономить на хранении больших объемов информации. Сырые данные, которые нужны не каждый день, можно автоматически перевести в более дешевые классы хранения, освобождая бюджет для "горячих" данных в BigQuery.
Таким образом, Google Cloud Storage — это не просто "облачный диск". Это высокотехнологичная, отказоустойчивая и экономически эффективная платформа для хранения данных, которая является фундаментом для построения любых надежных конвейеров в Google Cloud. Отказоустойчивость на уровне 11 девяток обеспечивается за счет автоматической репликации между дата-центрами и регионами.
Долговременность достигается за счет гибких классов хранения и автоматизации управления жизненным циклом, что позволяет хранить данные десятилетиями с минимальными затратами.
Использование GCS на первом этапе вашего конвейера данных — это лучшая страховка от потери данных и залог стабильности всей вашей аналитической системы.
Пример 2: Гибридный конвейер для анализа поведения пользователей в реальном времени
Его основная задача состоит в обработке потоков кликов и действий пользователей на веб-сайте для расчета актуальных метрик (онлайн-пользователи, популярные товары) и одновременного накопления данных для глубокого исторического анализа.
Логическая архитектура (Лямбда-архитектуру) можно в целом описать следующим образом:
- Источник: веб-приложение отправляет события в Apache Kafka (или Pub/Sub);
- Потоковый слой (Speed Layer): Данные из Kafka потребляются Apache Spark Streaming или Dataflow Streaming. Происходит агрегация данных за короткие окна (например, 1 минута). Результаты (актуальные метрики) записываются в быструю БД, такую как Redis, для отображения на дашбордах реального времени.
- Пакетный слой (Batch Layer): Те же данные из Kafka одновременно сохраняются в GCS. Раз в час запускается пакетная задача (Dataflow или Spark на Dataproc), которая пересчитывает метрики с учетом всех данных, обеспечивая 100% точность. Результаты загружаются в BigQuery.
- Сервисный слой (Serving Layer): Приложение-дашборд может запрашивать данные как из Redis (для актуальных данных), так и из BigQuery (для точных исторических данных), либо они объединяются в едином запросе.
Что касается потенциальных рисков и возможных ошибок, то здесь в первую очередь стоит упомянуть попытку обеспечить 100% точность в потоковом слое, что приводит к чрезвычайной сложности и дороговизне. Решением в данном случае является принятие того, что потоковый слой дает только приблизительные, но достаточно быстрые результаты, а точность обеспечивает пакетный слой. Это и есть философия Лямбда-архитектуры.
Еще один важный потенциальный риск – это рассогласование данных между слоями. На наш взгляд, оптимальным решением в данном случае может стать тщательное проектирование логики объединения результатов и использование единых идентификаторов событий.
Пример 3: Конвейер для машинного обучения (ML Pipeline)
Его первостепенная задача состоит в создании системы для регулярного обновления и переобучения прогнозной модели, предсказывающей отток клиентов.
Логическую архитектуру в данном случае можно представить следующим образом:
- Сбор признаков (Feature Engineering): Данные из различных источников (CRM, база заказов, логи веб-сайта) поступают в конвейер. Происходит их очистка, агрегация и преобразование в "признаки" (features) — параметры, на которых будет обучаться модель. Этот процесс может быть как пакетным, так и потоковым.
- Хранилище признаков (Feature Store): Подготовленные признаки сохраняются в специальном хранилище (например, Feast). Это централизованное место, обеспечивающее согласованность признаков при обучении модели и при выполнении прогноза.
- Обучение модели (Model Training): Оркестратор (например, Vertex AI Pipelines) запускает процесс обучения: забирает признаки из Feature Store, запускает тренировочный скрипт на мощном кластере, валидирует модель и, если ее качество удовлетворительно, помещает ее в реестр моделей (Model Registry).
- Сервинг модели (Model Serving): Обученная модель развертывается как API-эндпоинт (например, на Vertex AI Endpoints) для прогнозирования в реальном времени или используется для пакетных предсказаний.
Среди критически важных моментов в первую очередь стоит рассмотреть контроль версий - необходимо версионировать не только код модели, но и данные, на которых она обучалась, и сами признаки. Без этого невозможно воспроизвести результаты. Также мы рекомендуем обратить внимание на мониторинг дрейфа данных (Data Drift). Со временем распределение входящих данных может измениться, и точность модели упадет. Конвейер должен включать мониторинг этого дрейфа и автоматизацию переобучения.
В целом, на основе нашего опыта, мы хотели бы выделить топ-5 ошибок, которых следует избегать:
Во-первых, это преждевременная оптимизация и излишняя сложность. Начинать строительство гибридной Лямбда-архитектуры, когда бизнесу достаточно ежедневного пакетного отчета. Начинайте с максимально простого решения, удовлетворяющего текущие потребности, и усложняйте его по мере роста требований.
Во-вторых, это игнорирование качества данных на входе. "Мусор на входе — мусор на выходе". Конвейер должен включать этапы валидации, проверки на полноту и согласованность данных. Отсутствие этих этапов приводит к принятию решений на основе некорректной информации.
В – третьих, это недооценка мониторинга и обработки сбоев. Конвейер не должен быть "черным ящиком". Необходимо настроить алертирование на все ключевые этапы: недоступность источника, сбои в преобразованиях, пустые результативные наборы данных. В противном случае вы можете неделями не знать, что отчеты устарели.
В – четвертых, это пренебрежение безопасностью и соответствием требованиям (Compliance). Данные — это актив, который нужно защищать. Необходимо с самого начала закладывать принципы минимальных привилегий, шифровать данные на отдыхе и при передаче, обеспечивать маскирование конфиденциальных данных в тестовых средах. Особенно важно для работы с персональными данными (GDPR, CCPA).
И, наконец, в- пятых, это создание монолитного, негибкого конвейера. Жесткая сцепленность компонентов приводит к тому, что любое изменение в одном источнике или требовании вызывает лавину правок во всей системе. Используйте модульный подход, разделяя логику извлечения, трансформации и загрузки.
Как видите, выбор и построение архитектуры конвейера данных — это сложная, но абсолютно необходимая инвестиция в цифровое будущее вашей компании. Не существует универсального решения, подходящего всем. Идеальная архитектура рождается в результате тщательного анализа бизнес-задач, существующей ИТ-инфраструктуры, бюджета и долгосрочной стратегии.


